GPT vs Gemini vs Claude für die KI-Aktienanalyse: 2026 Leitfaden
GPT vs Gemini vs Claude für die KI-Aktienanalyse ist nicht mehr nur eine einfache Frage von „welcher Chatbot gibt die intelligenteste Antwort?“ Im Jahr 2026 benötigen ernsthafte Investoren einen Workflow, der Einreichungen lesen, Ergebnisbesprechungen analysieren, Diagramme inspizieren, Bewertungen vergleichen, aktuelle Nachrichten verfolgen, Unsicherheiten erklären und eine entscheidungsbereite Forschungsnotiz erstellen kann. Deshalb geht dieser Leitfaden über das Hype um Modelle hinaus und vergleicht GPT, Gemini, Claude und den Multi-Agenten-Ansatz, der von SimianX AI für praktische Marktforschung verwendet wird. Er stellt die drei Familien außerdem 4.992 live von KI verwalteten Positionen aus unserem eigenen Kommandoraum gegenüber, denn der aufschlussreichste Vergleich ist nicht, welches Modell am klügsten klingt, sondern wie sich das Training jedes Labors zeigt, wenn eine Position Geld verliert.
Warum die KI-Aktienanalyse mehr als ein intelligentes Modell benötigt
Eine Entscheidung in der Aktienforschung ist nicht nur ein Sprachproblem. Es ist ein Multi-Signal-Reasoning-Problem. Ein Modell kann einen 10-K gut zusammenfassen, aber einen aktuellen Katalysator übersehen. Ein anderes kann hervorragend im Langzeitlesen sein, aber schwächer in der spreadsheet-artigen Sensitivitätsanalyse. Ein drittes kann ausgefeilte Investitionsmemos schreiben, ist jedoch stark von der Qualität der verbundenen Daten abhängig.
Für die KI-Aktienforschung muss das nützlichste System Fragen wie die folgenden beantworten:
- Was hat sich im neuesten Ergebnisgespräch geändert?
- Expandieren die Bewertungsmultiplikatoren schneller als die Einnahmen oder der freie Cashflow?
- Wird das Momentum durch das Volumen unterstützt, oder ist die Preisbewegung fragil?
- Widerspricht die Nachrichtenstimmung den Fundamentaldaten?
- Welche Annahmen treiben die Aufwärts- und Abwärtsfälle?
- Was würde die These falsch machen?
Wichtiger Hinweis: Die beste KI für die Aktienanalyse ist normalerweise kein einzelnes Modell. Es ist ein Workflow, der frische Daten, spezialisiertes Denken, transparente Zitationen, Risikoüberprüfungen und menschliche Überprüfung kombiniert.
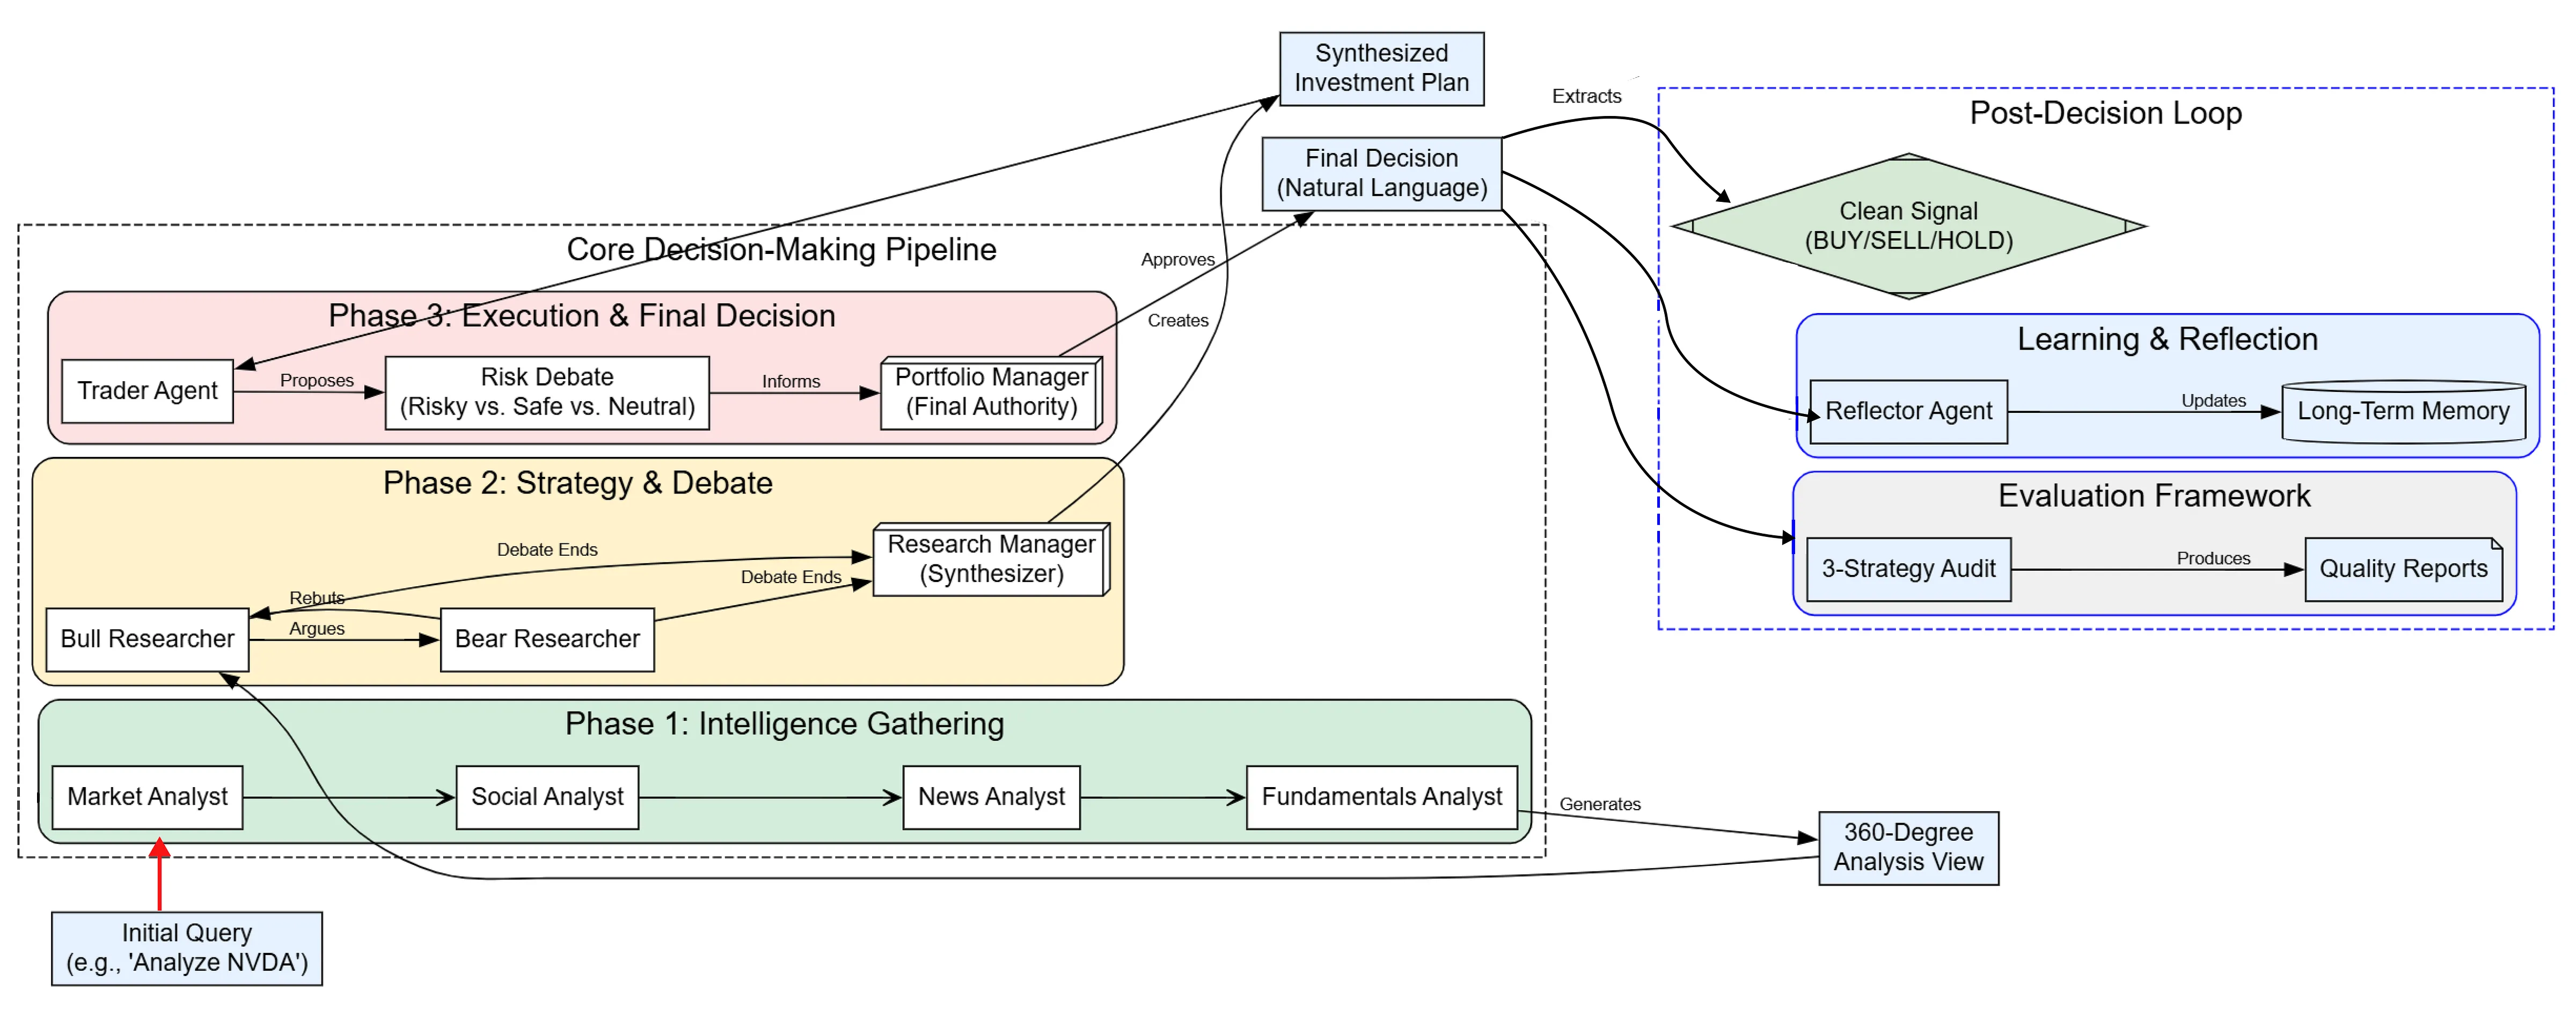
Dies ist der Punkt, an dem Multi-Agenten-Aktienanalyse wichtig wird. SimianX AI verwendet einen Multi-Agenten-Ansatz, um Investoren zu helfen, Fundamentaldaten, Marktstruktur, technische Signale, Stimmung und Risiko auf eine strukturiertere Weise zu vergleichen als bei einer einzelnen Chatbot-Antwort.
GPT vs Gemini vs Claude für AI-Aktienanalyse: Schnelles Urteil
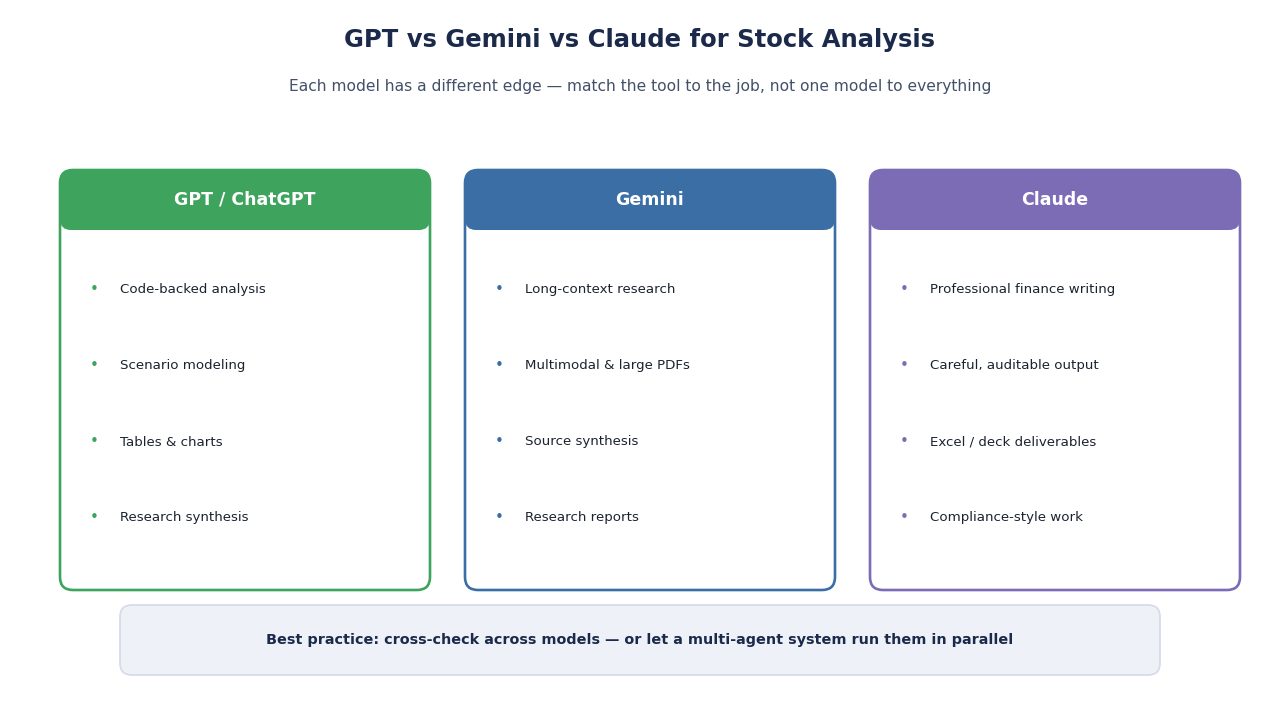
Jede Modellfamilie hat einen anderen „besten Einsatz“ in der Aktienforschung. Die praktische Antwort hängt davon ab, ob Sie Datenanalyse, Langzeitforschung, Integration von Finanzabläufen oder Multi-Agenten-Debatten benötigen.
| Plattform | Stärkster Anwendungsfall für Aktienanalyse | Warnhinweise | Am besten kombiniert mit |
|---|---|---|---|
| GPT / ChatGPT | Code-gestützte Analyse, Szenariomodellierung, Tabellen, Diagramme, Forschungssynthese | Benötigt verifizierte Quellen und sorgfältige Prompt-Gestaltung | Datenprüfungen im Python-Stil, Einreichungen, Bewertungs-Templates |
| Gemini | Langzeit-, multimodale Forschung, große PDFs, Forschungsberichte, Diagramme | Die Ausgabequalität hängt von der Quellenauswahl und Konfiguration ab | Große Dokumentensätze, Marktübersichten, Synthese von Analystennotizen |
| Claude | Professionelle Finanzabläufe, sorgfältiges Schreiben, Excel-/PowerPoint-ähnliche Ergebnisse | Unternehmensfinanzierungsfunktionen können von kostenpflichtigem Zugang/Anschlüssen abhängen | Investitionsmemos, Pitchbooks, Modellüberprüfung, Compliance-Abläufe |
| SimianX AI | Multi-Agenten-Aktienanalyse mit technischen, fundamentalen, Nachrichten- und Debattenebenen | Benötigt weiterhin das Urteil des Investors; keine KI kann Renditen garantieren | Händler und Forscher, die Modellvielfalt in einem Arbeitsablauf wünschen |
Die GPT-Modelle von OpenAI sind oft nützlich für strukturierte finanzielle Überlegungen, benutzerdefinierte Datenanalysen und Szenariomodellierungen. Google Gemini ist überzeugend für umfassende, dokumentenlastige Forschung, insbesondere beim Vergleich von Einreichungen, Berichten, Bildern und langen Kontexten. Claude ist stark, wenn die Ausgabe wie ein professionelles Finanzmemo, eine Gliederung für ein Pitchbook oder eine Zusammenfassung des Investitionsausschusses aussehen muss.
GPT für die Aktienanalyse: Am besten für Datenarbeit und Szenariomodellierung
GPT ist besonders nützlich, wenn die Forschungsaufgabe unordentliche Finanzdaten in strukturierte Analysen umzuwandeln beinhaltet. In einem Aktienforschungs-Workflow kann das bedeuten, hochgeladene Dateien zu überprüfen, Tabellen und Diagramme zu erstellen, Wachstumsraten zu berechnen und Annahmen in einfacher Sprache zu erklären. GPT kann helfen, exportierte Preishistorien zu analysieren, eine CSV-Datei mit vierteljährlichen Kennzahlen zu bereinigen oder ein einfaches Discounted-Cash-Flow-Modell basierend auf benutzereingereichten Annahmen zu erstellen.
Ein von GPT unterstützter Aktien-Workflow könnte folgendermaßen aussehen:
- Laden Sie eine Tabelle mit Umsatz, Bruttomarge, Betriebsergebnis, freiem Cashflow und Aktienanzahl hoch.
- Bitten Sie GPT, das kumulierte Wachstum, die Margentrends und die Umwandlung des freien Cashflows zu berechnen.
- Fragen Sie nach Annahmen für das Bull-, Basis- und Bären-Szenario.
- Generieren Sie eine Bewertungs-Tabelle mit
EV/Umsatz,EV/EBITDAoderKGV. - Vergleichen Sie die Ergebnisse mit tatsächlichen Einreichungen und Marktdaten.
Der größte Vorteil von GPT ist flexibles Denken mit codegestützter Analyse. Es ist sehr gut darin, rohe Eingaben in Berechnungen, Diagramme und schriftliche Erklärungen umzuwandeln. Für Investoren, die bereits Daten aus SEC-Einreichungen, Finanz-APIs oder einer Tabelle haben, kann GPT zu einem leistungsstarken Forschungsassistenten werden.
Allerdings ist GPT nicht automatisch ein zuverlässiger Aktienpicker. Wenn Sie fragen: „Sollte ich heute NVDA kaufen?“ ohne einen Zeitrahmen, Risikotoleranz, Portfolio-Kontext oder eine Live-Datenquelle anzugeben, kann die Antwort zwar selbstbewusst klingen, ist aber dennoch unvollständig. Verwenden Sie GPT für Analyse-Konstruktion, nicht für blinde Handelsausführung.
Wann sollten Sie GPT für die Aktienmarktforschung verwenden?
Verwenden Sie GPT, wenn Sie modellieren, berechnen, erklären und dokumentieren müssen. Es eignet sich gut für benutzerdefinierte Bildschirme, Szenarioanalysen, Vorlagen für die Gewinnzusammenfassung, Tabellen zur Portfoliobelastung und einfache Erklärungen komplexer Verhältnisse. Es ist auch hilfreich, um zu überprüfen, ob Ihre eigene These fehlende Annahmen hat.
Ein starker GPT-Prompt für die AI-Aktienanalyse könnte sein:
Analysieren Sie die letzten 12 Quartale der Einnahmen, Bruttomarge, Betriebsmarge, freien Cashflows, Schulden und Aktienanzahl dieses Unternehmens. Identifizieren Sie Trendbrüche, berechnen Sie die Bewertungsbereiche für Bullen/Basis/Bären und listen Sie die fünf Annahmen auf, die am wahrscheinlichsten falsch sind.
Dieser Prompt funktioniert, weil er nach strukturierter Analyse, Berechnungen und Unsicherheit fragt, nicht nur nach einer Kauf-/Verkaufantwort.
Gemini für AI-Aktienanalyse: Am besten für Langzeitforschung und Quellensynthese
Der Hauptvorteil von Gemini ist Langzeitkontext, multimodale Forschung. Für die Aktienanalyse ist das wichtig, da die Forschung zu öffentlichen Unternehmen oft Jahresberichte, vierteljährliche Einreichungen, Transkripte, Produktvideos, regulatorische PDFs, Analystenkommentare und makroökonomische Dokumente umfasst. Ein Modell, das große Kontextfenster verarbeiten kann, kann viel mehr Quellenmaterial in einem Workflow vergleichen.
Das macht Gemini nützlich für Fragen wie:
- „Vergleichen Sie die letzten drei Jahresberichte von
AAPL,MSFTundGOOGLhinsichtlich der Sprache zu KI-Kapitalausgaben.“
- „Fassen Sie jede Änderung der Risikofaktoren über zwei Jahre von Einreichungen zusammen.“
- „Erstellen Sie eine Marktübersicht über die Exposition in der Halbleiter-Lieferkette.“
- „Extrahieren und vergleichen Sie den Ton des Managements aus fünf Transkripten von Gewinnaufrufen.“
- „Erstellen Sie ein chartfreundliches Forschungsbrief aus mehreren PDFs.“
Gemini ist am stärksten, wenn die Aufgabe breit, dokumentenlastig und multimodal ist. Es kann Investoren helfen, Muster über große Forschungs-Korpora zu finden, die manuell mühsam zu inspizieren wären.
Die Warnung ist, dass eine große Kontextfähigkeit nicht automatisch besseres Investitionsurteil bedeutet. Wenn die Quellen veraltet, voreingenommen, werblich oder unvollständig sind, kann das Ergebnis dennoch fehlerhaft sein. Bei der Aktienforschung ist die Auswahl der Quellen Teil der Analyse. Gemini ist leistungsstark, wenn Sie ihm qualitativ hochwertige Einreichungen, Transkripte, Marktdaten und Forschungsquellen zur Verfügung stellen.
Claude für AI-Aktienanalyse: Am besten für professionelle Finanz-Workflows
Claudis Vorteil ist Workflow-Disziplin. Claude ist oft nützlich, wenn finanzielle Forschung zu einem ausgefeilten schriftlichen Ergebnis werden muss, wie z.B. einem Investitionsmemo, einer Gewinnzusammenfassung, einem Portfolio-Update oder einer Due-Diligence-Notiz. Sein Schreibstil kann sorgfältig, ausgewogen und leicht an professionelle Leser anpassbar sein.
Das macht Claude wertvoll für:
- Entwurf von Investitionsmemos mit ausgewogenem Denken
- Überprüfung der Bewertungsmethodik
- Aufbau oder Überprüfung von Finanzmodellen
- Vorbereitung von Pitchbook-ähnlichen Ergebnissen
- Zusammenfassung von Gewinntranskripten
- Erstellung von Kommentaren auf Vorstandsebene oder für Kunden
- Stresstest einer These vor einem Treffen des Investitionsausschusses
Claudis Einschränkung ist der praktische Zugang. Die spezifischsten Finanz-Workflows können von verfügbaren Verbindungsstellen, kostenpflichtigen Funktionen oder manuellen Uploads abhängen. Für einen einzelnen Investor kann Claude dennoch hervorragend für Argumentation und Schreiben sein, aber die Datenpipeline kann externe Werkzeuge erfordern.
Was ist der beste Weg, um GPT vs Gemini vs Claude für AI-Aktienanalyse zu vergleichen?
Der beste Weg, diese Modelle zu vergleichen, besteht nicht darin, jedes Modell nach einer Aktienempfehlung zu fragen. Ein besserer Test besteht darin, jedem Modell die gleiche Forschungsaufgabe zu geben und das Ergebnis nach Beweisen, Berechnungen, Risikobewusstsein und Nützlichkeit zu bewerten.
Verwenden Sie dieses Bewertungsrahmenwerk:
| Bewertungsfaktor | Was zu überprüfen ist | Warum es wichtig ist |
|---|---|---|
| Datenaktualität | Verwendet es aktuelle Einreichungen, Nachrichten und Preise? | Alte Daten können eine Handelsthese gefährden |
| Quellenqualität | Stammen die Zitationen aus Einreichungen, Unternehmensveröffentlichungen, glaubwürdigen Finanzdaten oder renommierten Nachrichten? | Schwache Quellen führen zu schwachen Schlussfolgerungen |
| Numerische Genauigkeit | Sind Verhältnisse, Wachstumsraten und Bewertungs Tabellen korrekt? | Kleine Rechenfehler können die These ändern |
| Risikoanalyse | Erklärt es die Abwärtsrisiken, Unsicherheiten und Ungültigkeitspunkte? | Gute Forschung ist nicht nur bullisches Beweismaterial |
| Transparenz | Kannst du nachvollziehen, warum das Modell zu seiner Schlussfolgerung gekommen ist? | Nachvollziehbarkeit hilft, blindes Vertrauen zu vermeiden |
| Handlungsfähigkeit | Bietet es nächste Schritte, nicht nur eine Zusammenfassung? | Investoren benötigen Entscheidungen, Beobachtungslisten und Trigger |
Ein einfacher Vergleichstest:
- Wähle ein Ticker-Symbol, wie
TSLA,NVDAoderAAPL. - Sammle das gleiche Quellpaket: neueste 10-K/10-Q, aktuelles Earnings-Transkript, ein Jahr Preisdaten, aktuelle Nachrichten und wichtige Bewertungskennzahlen.
- Bitte GPT, Gemini und Claude, das gleiche Ergebnis zu produzieren: These, Haupttreiber, Risiken, Bewertungsbereich und was die Schlussfolgerung ändern würde.
- Überprüfe jede Zahl gegen das Quellpaket.
- Vergleiche, welches Ergebnis für deinen tatsächlichen Investitionsprozess am nützlichsten ist.
Das Modell, das am selbstbewusstesten klingt, ist nicht immer das Modell, das am korrektesten ist. Für die Aktienanalyse ist das System, das am einfachsten zu überprüfen ist, der Gewinner.
Was 4.992 reale KI-Trades darüber verraten, wie jedes Labor trainiert
Alles bisher Gesagte ist die qualitative Argumentation. Die schwierigere Frage lautet, ob sich diese Unterschiede tatsächlich in den Ergebnissen zeigen — also haben wir in unsere eigenen Protokolle geschaut.
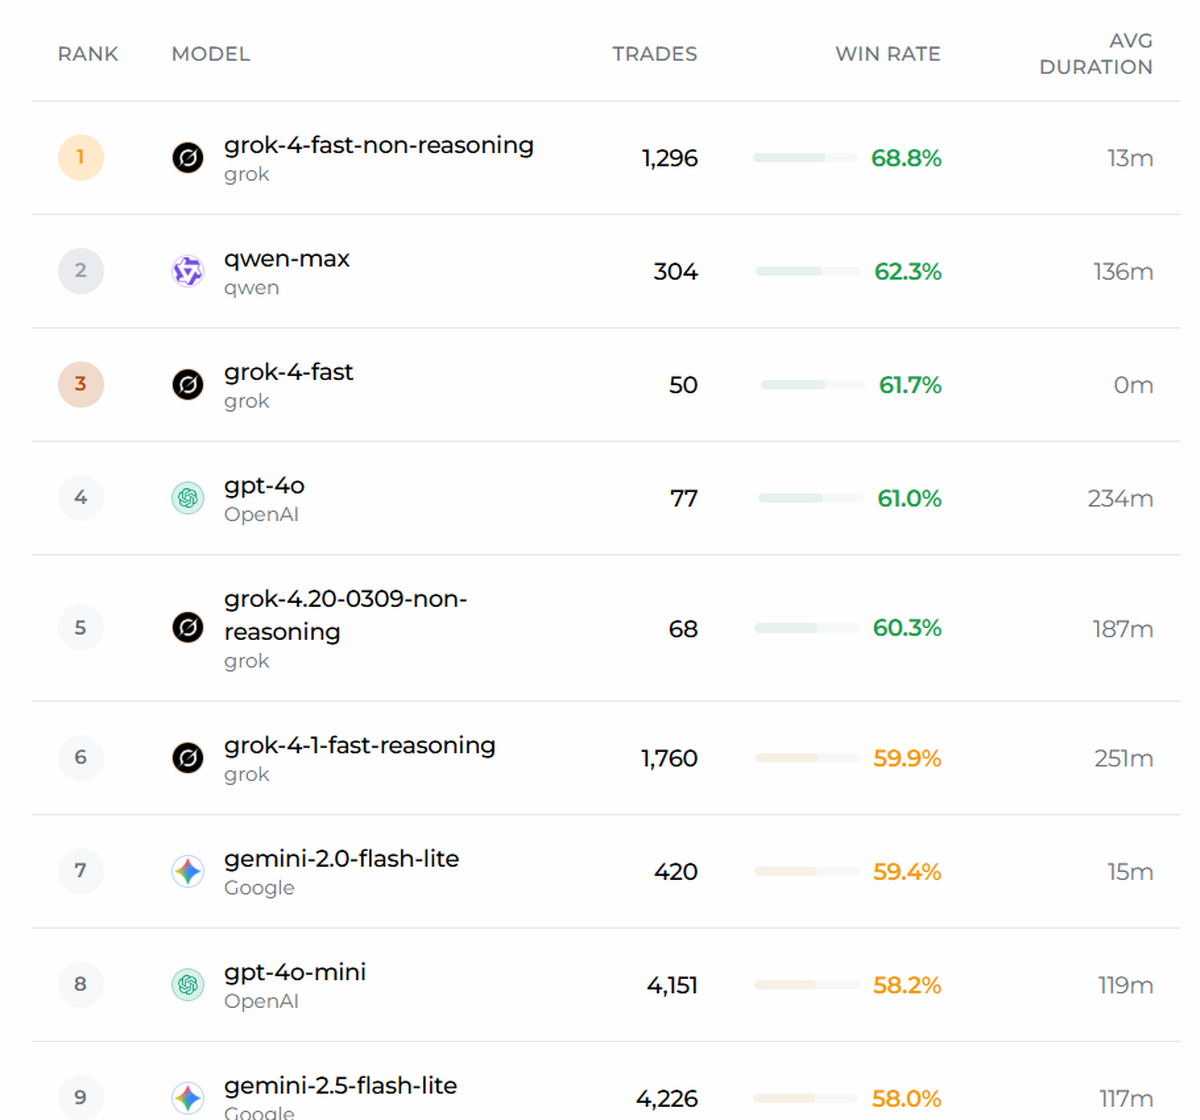
SimianX betreibt einen Live-Kommandoraum, in dem KI-Modelle echte, überwachte Positionen mit definierten Einstiegen, Stop-Loss-Marken und Zielen eingehen. Zwischen dem 22. Januar und dem 28. August 2026 schloss dieses System 4.992 Positionen und erzeugte dabei 20.016 Modell-Positions-Datensätze über 35 Modelle von 6 Anbietern.
Lesen Sie diesen Abschnitt richtig: Wir messen den Hausstil, nicht das Trading-Können
Zwei Einschränkungen bestimmen, wie Sie diese Zahlen verwenden sollten, und beide wiegen schwerer als die Zahlen selbst.
Erstens: Kein Labor liefert derzeit ein Modell aus, das speziell für das Trading trainiert wurde. GPT, Gemini, Claude, Grok, DeepSeek und Qwen sind allesamt Allzwecksysteme, die eine Aufgabe erledigen sollen, für die keines von ihnen optimiert wurde. Eine Tabelle mit Trefferquoten ist deshalb keine Rangliste der Trading-Fähigkeit. Was sie tatsächlich offenlegt, ist das Temperament des jeweiligen Hauses: die Art und Weise, wie die Trainings- und Alignment-Entscheidungen einer Organisation das Verhalten ihrer Modelle prägen, wenn diese unter Unsicherheit und mit realen Konsequenzen handeln müssen. Wie schnell räumt es einen Fehler ein? Wie stark relativiert es? Legt es sich auf eine Zahl fest? Diese Grundhaltung ist ein Fingerabdruck des Labors und nicht der Modellversion — deshalb bleibt sie über Releases hinweg meist bestehen, und deshalb ist sie ein verlässlicherer Hinweis darauf, wie sich das nächste Modell dieses Labors verhalten wird, als jeder Benchmark-Wert.
Zweitens: Es handelt sich um Krypto-Positionen, nicht um Aktien. Wir veröffentlichen sie in einem Leitfaden zur Aktienrecherche, weil die gemessene Eigenschaft — die Denkhaltung unter Unsicherheit — zum Modell gehört und nicht zum Basiswert. Krypto wird rund um die Uhr gehandelt, was eine belastbare Stichprobe in Monaten statt in Jahren liefert. Betrachten Sie die Richtung dieser Befunde als übertragbar auf die Aktienrecherche und die absoluten Prozentwerte als kryptospezifisch. Die vollständige Rangliste ist öffentlich im SimianX Krypto-Leaderboard einsehbar, und die Methodik schlüsseln wir in Welches KI-Modell handelt am besten? 30 LLMs an echtem P&L weiter auf.
Methodische Anmerkungen: „entscheidend" schließt Positionen aus, die ohne Ergebnis geschlossen wurden. Eine einzelne Position kann mehrere Modelle in unterschiedlichen Agentenrollen einbeziehen und daher mehr als einem Anbieter zugerechnet werden — dieselbe Konvention, die unser öffentliches Leaderboard verwendet. Die Modelle wurden nicht zufällig zugewiesen; die Nutzer haben sie ausgewählt, sodass sich die Mischung aus Zeiteinheiten und Instrumenten je Modell unterscheidet. Genau dieser Störfaktor erweist sich als die wichtigste Erkenntnis des gesamten Datensatzes.
Befund 1 — Bei der reinen Trefferquote sind die führenden Familien nicht unterscheidbar
| Modell | Geschlossene Positionen | Trefferquote | Durchschnittliches P&L je Position |
|---|---|---|---|
gpt-4o-mini | 4.340 | 59,0 % | +0,075 % |
gemini-2.5-flash-lite | 4.458 | 58,8 % | +0,080 % |
grok-4-1-fast-non-reasoning | 2.647 | 57,1 % | +0,085 % |
Auf Anbieterebene ergibt sich dasselbe Bild: OpenAI 58,7 %, xAI 58,6 %, Google 58,3 % — jeweils auf rund 4.500 entscheidenden Positionen. Ein Abstand von 0,4 Punkten bei Stichproben dieser Größe ist Rauschen, kein Vorteil.
Wenn Sie hergekommen sind, um zu erfahren, „welches Modell gewinnt", ist das die Antwort — und sie ist ernüchternd: Auf der Ebene realisierter Ergebnisse ändert der Wechsel von GPT zu Gemini so gut wie nichts.
Befund 2 — Der Aufbau zählt etwa 25-mal mehr als das Modell
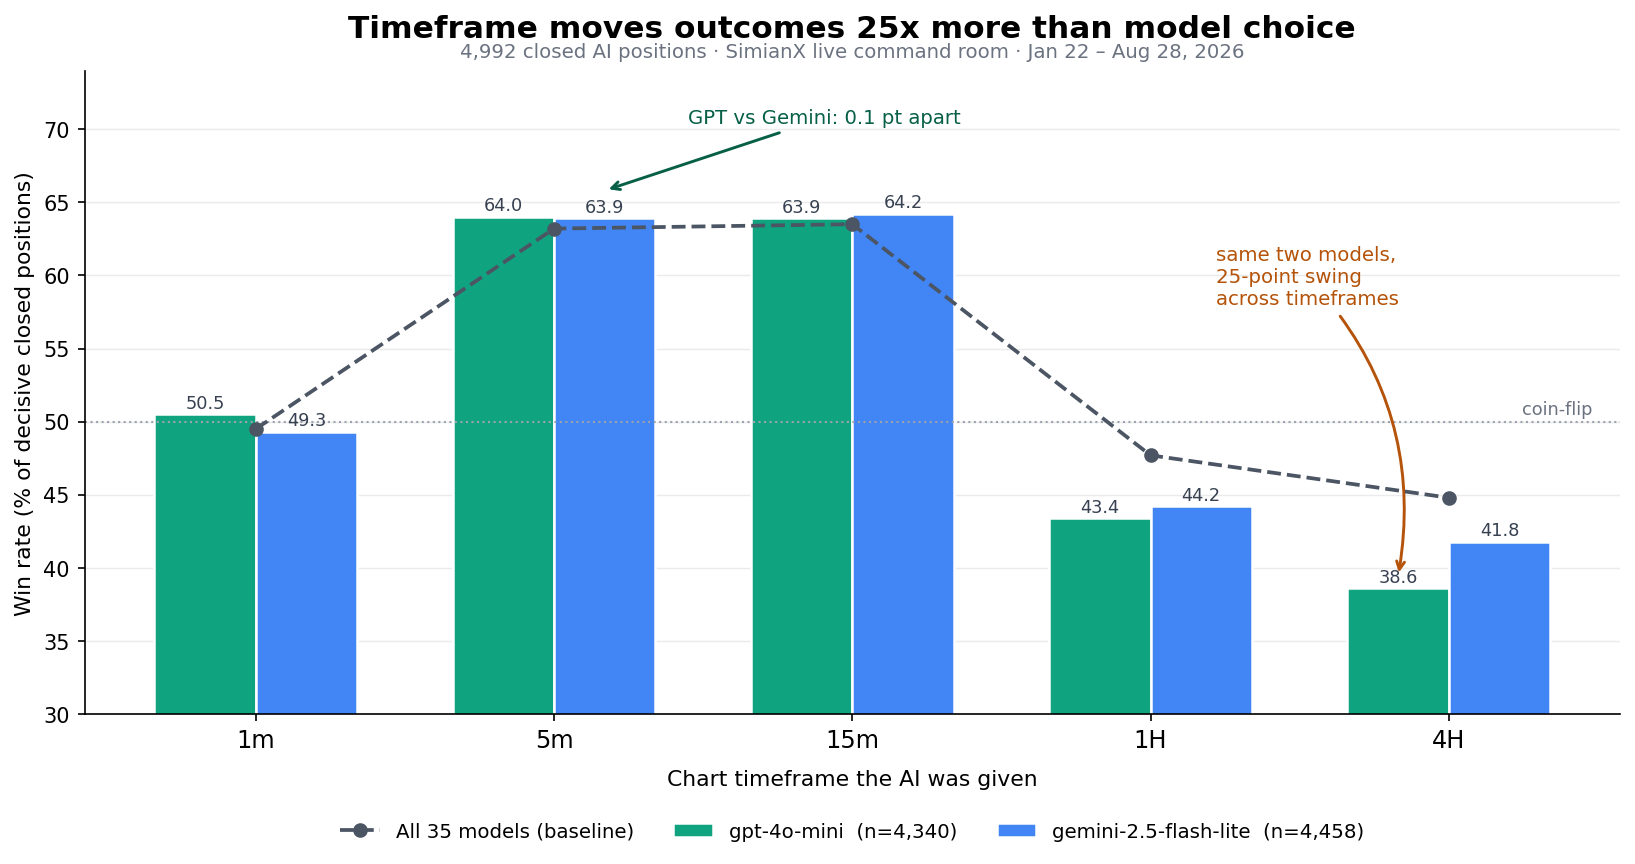
Dieselben zwei Modelle, sortiert nach der Chart-Zeiteinheit, die ihnen vorgegeben wurde:
| Zeiteinheit | gpt-4o-mini | gemini-2.5-flash-lite | Alle 35 Modelle |
|---|---|---|---|
| 1m | 50,5 % | 49,3 % | 49,5 % |
| 5m | 64,0 % | 63,9 % | 63,2 % |
| 15m | 63,9 % | 64,2 % | 63,5 % |
| 1H | 43,4 % | 44,2 % | 47,7 % |
| 4H | 38,6 % | 41,8 % | 44,8 % |
Die beiden Modelle folgen einander in jeder einzelnen Zelle auf etwa einen Punkt genau. Dasselbe Modell schwankt um 25 Punkte zwischen seiner besten und seiner schlechtesten Zeiteinheit.
Das ist die nützlichste Erkenntnis des Datensatzes, und sie lässt sich unmittelbar auf die Aktienrecherche übertragen: Bevor Sie dem Modell die Schuld geben, prüfen Sie den Aufbau. Eine schwache Antwort ist weit häufiger eine schlecht gestellte Frage — falscher Zeithorizont, falsches Belegpaket, falscher Kontext — als ein schwaches Modell.
Befund 3 — Schlagzeilenzahlen täuschen, solange man den Aufbau nicht kontrolliert
Claude ist das Anschauungsbeispiel. claude-haiku-4-5 weist eine Trefferquote von 52,4 % aus, was wie eine klare Niederlage gegen GPT und Gemini aussieht. Aber 66 % seiner Positionen liefen auf dem 1-Minuten-Chart — der schlechtesten Zeiteinheit im gesamten Datensatz, und zwar für jedes getestete Modell. Vergleicht man Gleiches mit Gleichem, erreicht Claude 52,8 % auf 1m gegenüber einem Referenzwert von 49,5 % über alle Modelle: über dem Feld bei genau dem Aufbau, den es tatsächlich bekommen hat.
Nichts an der Rohtabelle war falsch. Es war schlicht ein nicht abgeglichener Vergleich. Jeder Artikel nach dem Muster „wir haben die Modelle getestet", der die Aufgabe nicht kontrolliert, berichtet über die Zusammensetzung, nicht über die Fähigkeit.
Befund 4 — Gleiche Treffergenauigkeit, völlig unterschiedliches Temperament
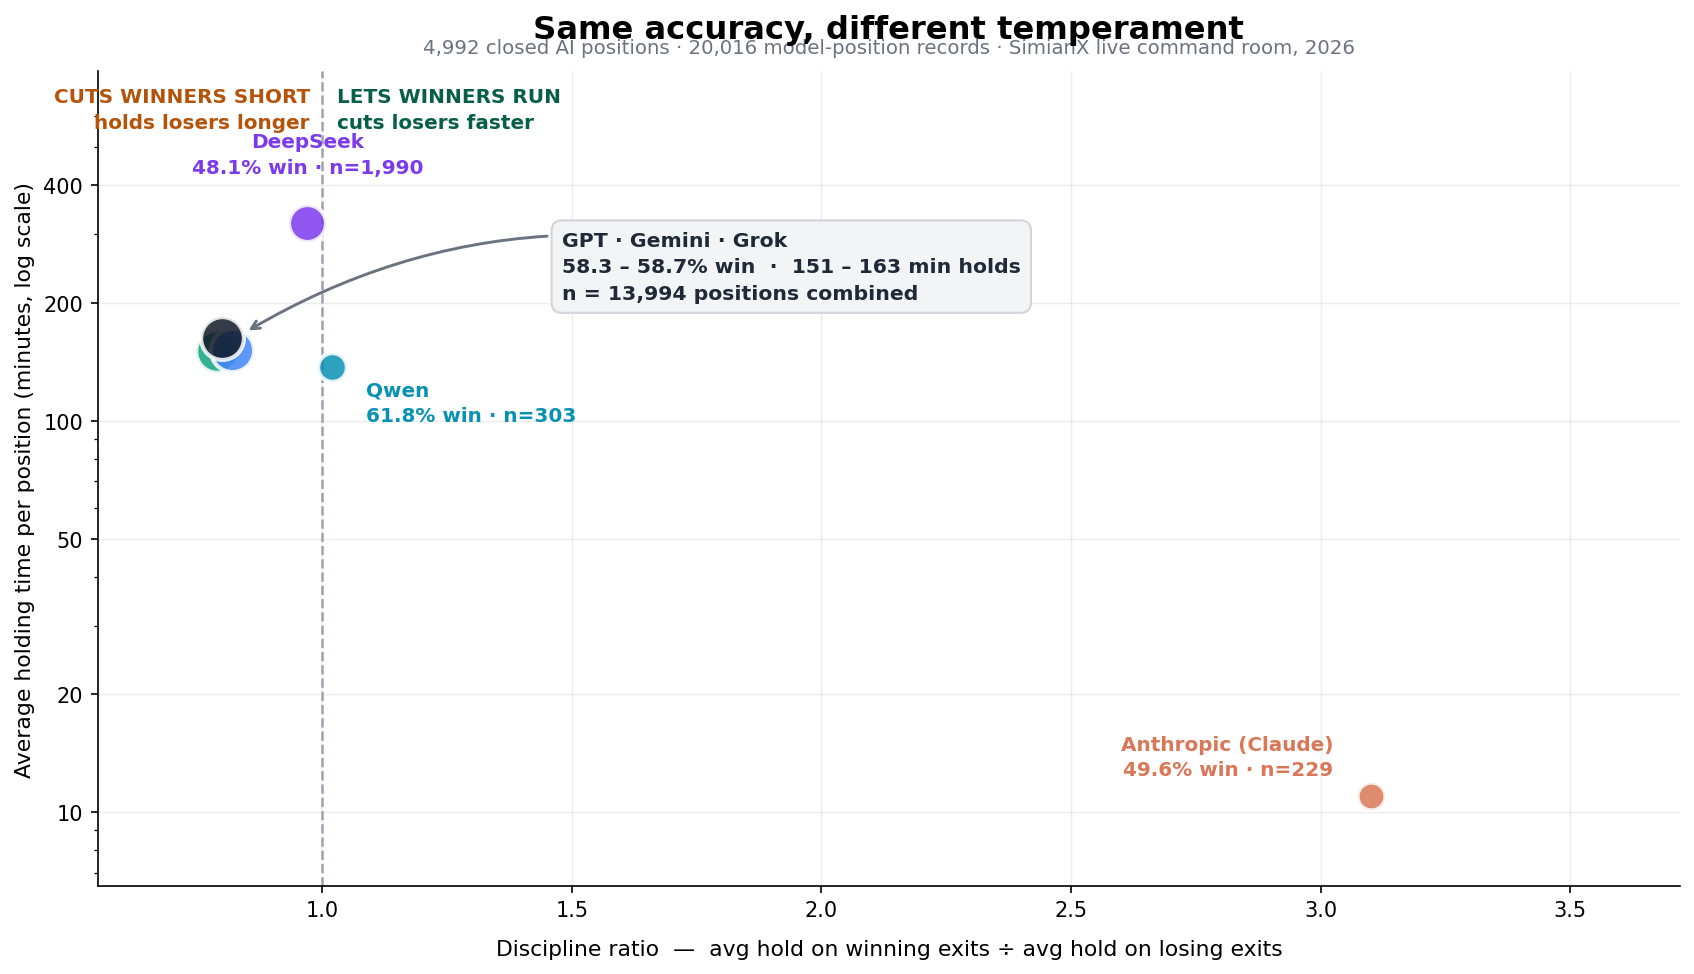
Wo sich die Familien wirklich unterscheiden, ist das Verhalten.
| Familie | Ø Haltedauer | Stop ausgelöst | Ø Konfidenz | Meldet „hohes Risiko" | Disziplinquotient* |
|---|---|---|---|---|---|
| OpenAI (GPT) | 151 Min. | 22,7 % | 0,604 | 3 % | 0,79 |
| Google (Gemini) | 152 Min. | 23,5 % | 0,682 | 9 % | 0,82 |
| xAI (Grok) | 163 Min. | 22,5 % | 0,678 | <1 % | 0,80 |
| Anthropic (Claude) | 11 Min. | 32,3 % | 0,677 | 0 % | 3,10 |
| DeepSeek | 320 Min. | 21,5 % | 0,645 | 1 % | 0,97 |
| Qwen | 137 Min. | 38,3 % | 0,684 | 2 % | 1,02 |
*Disziplinquotient = durchschnittliche Haltedauer bei gewinnbringenden Ausstiegen ÷ durchschnittliche Haltedauer bei verlustreichen Ausstiegen. Unter 1,0 bedeutet, dass das Modell länger auf seinen Verlusten saß als auf seinen Gewinnen.
Drei Dinge stechen hervor.
GPT, Gemini und Grok übernehmen die schlechteste Angewohnheit des Privatanlegers. Jedes hält Verlustpositionen länger als Gewinnpositionen — 68 gegenüber 54 Minuten bei OpenAI, 64 gegenüber 52 bei Google. Das ist der Dispositionseffekt, genau jene Abneigung, einen Verlust zu realisieren, die menschliche Trader Geld kostet — reproduziert von Modellen, die überwiegend auf menschlichen Texten trainiert wurden.
Anthropic ist der Ausreißer, und zwar in die richtige Richtung. Claude schneidet eine Verlustposition im Schnitt nach 7 Minuten ab und hält eine Gewinnposition 21 Minuten — ein Disziplinquotient von 3,10, Risikomanagement wie aus dem Lehrbuch. Es ist zugleich die Familie, die am ehesten bereit ist, schnell falschzuliegen, was sich in einer erhöhten Stop-Auslösungsquote niederschlägt. Die niedrigere Schlagzeilen-Trefferquote ist keine Nachlässigkeit, sondern die Arithmetik vieler kleiner, schneller Verluste bei den schwierigsten Aufbauten.
OpenAI ist am besten kalibriert. GPT gibt eine durchschnittliche Konfidenz von 0,604 an, gegenüber rund 0,68 bei allen anderen — die Familie, die Ihnen am seltensten sagt, sie sei sich sicher. Für Recherchearbeit ist das ein Vorzug, keine Schwäche.
Gemini meldet sich am ehesten zu Wort: Es stuft einen Aufbau in 9 % der Entscheidungen als „hohes Risiko" ein — dreimal häufiger als OpenAI und unendlich viel häufiger als Claude, das dieses Etikett in dieser Stichprobe kein einziges Mal verwendet hat.
Ein weiteres systemweites Ergebnis verdient Erwähnung: Über alle sechs Familien hinweg wurden Take-Profit-Ziele nur bei 1,5 bis 2,8 % der Positionen ausgeführt. Die Modelle sämtlicher Labore steuern ihre Ausstiege ganz überwiegend nach laufendem Urteil, statt ein vorab gesetztes Ziel arbeiten zu lassen. Ob das Disziplin oder Eingriff ist, ist genau die Art von Frage, die eine Multi-Agenten-Prüfung sichtbar machen soll; die Crash-Variante dieser Frage untersuchen wir in Verkaufen KI-Modelle in einem Crash panisch?.
Hinweis zur Stichprobengröße: Anthropic (229 Positionen) und Qwen (303) beruhen auf deutlich kleineren Stichproben als die großen drei (jeweils über 4.500). Lesen Sie diese beiden Zeilen als Hinweis, nicht als gesichertes Ergebnis.
Befund 5 — Reasoning-Modi halfen bei kurzen Zeithorizonten nicht
Bei konstantem Labor und Variation allein des Reasoning-Modus:
| Modell | Positionen | Trefferquote | Ø Haltedauer |
|---|---|---|---|
grok-4-fast-non-reasoning | 1.356 | 68,4 % | 13 Min. |
grok-4-1-fast-reasoning | 1.733 | 61,5 % | 240 Min. |
deepseek-chat | 1.486 | 49,1 % | 205 Min. |
deepseek-reasoner | 389 | 44,4 % | 766 Min. |
In beiden Laboren schnitt die Variante mit erweitertem Reasoning bei kurzfristigen Entscheidungen schlechter ab als ihr schnelleres Gegenstück. Längeres Abwägen führte zu längeren Haltedauern und mehr Zeit, in der die These verfallen konnte — nicht zu besseren Einstiegen. Für langsame, dokumentenlastige Aktienrecherche dreht sich dieser Kompromiss sehr wahrscheinlich um, aber setzen Sie nicht voraus, dass ein Reasoning-Modell automatisch das bessere Werkzeug für eine zeitkritische Entscheidung ist.
Befund 6 — Jedes Labor hat eine erkennbare Schreibsignatur
In 1.581 Entscheidungsdatensätzen, bei denen sich das entscheidende Modell zuordnen lässt, verrät bereits die Sprache das jeweilige Labor.
GPT relativiert. Rund die Hälfte seiner Begründungen stützt sich auf weiche Formulierungen, und es legt sich selten auf einen Preis fest:
„Die Analyse deutet auf eine Long-Position hin, da kurzfristige bullische Umkehrbewegungen möglich sind, gestützt durch den RSI und die Nachrichtenstimmung, trotz des insgesamt bärischen Trends. Der Aufbau bietet ein vertretbares Chance-Risiko-Verhältnis."
Gemini legt sich auf Zahlen fest. Es nennt in 12 % seiner Begründungen ein konkretes Niveau, etwa doppelt so oft wie die meisten Konkurrenten:
„Short gehen auf Basis des 15-Minuten-Charts, der einen Abwärtstrend und bärische technische Indikatoren zeigt. Das Gewinnziel liegt bei 89.120,00."
Claude ist am technisch präzisesten und am wenigsten relativierend — nur 32 % seiner Begründungen verwenden absichernde Sprache, gegenüber 51 bis 63 % bei allen anderen Familien:
„Die Analyse deutet auf eine Short-Position hin, ausgehend von einem Bruchpunkt mit struktureller bärischer Evidenz wie fallenden Hochs, gescheiterten EMA50-Rückeroberungen und rückläufigem Volumen. Vor dem Einstieg ist eine Bestätigung erforderlich."
Grok begrenzt seine Prognosen zeitlich. Es versieht 11 % seiner Entscheidungen mit einem ausdrücklichen Zeitfenster, gegenüber 2 bis 6 % anderswo:
„Short-Position empfohlen wegen bärischer Signale, Widerstand bei 9,0 und dem Potenzial für einen Rückgang auf 8,93 innerhalb der nächsten 45 bis 95 Minuten."
Beachten Sie, worum es sich handelt: um stilistische Grundhaltungen, nicht um Fähigkeiten. Sie spiegeln wider, was das Post-Training des jeweiligen Labors belohnt hat — Vorsicht bei OpenAI, Entschiedenheit und ausdrückliche Risikokennzeichnung bei Google, strukturelle Präzision und schnelles Eingestehen von Verlusten bei Anthropic, festlegende und zeitlich begrenzte Formulierungen bei xAI. Diese Präferenzen sind stabile Eigenschaften des Hauses. Und da keines von ihnen für Märkte feinabgestimmt wurde, sind sie das Beste, was einer Prognose darüber nahekommt, wie sich das nächste Modell jedes Labors verhalten wird, wenn Sie es auf eine Aktie ansetzen.
Die 6-Achsen-Bewertungskarte: den Rahmen in eine Zahl überführen
Bewerten Sie das Rechercheergebnis eines beliebigen Modells anhand der sechs Faktoren aus der obigen Bewertungsmatrix mit jeweils 1 bis 5 Punkten und gewichten Sie sie danach, welchen Schaden ein Versagen auf dieser Achse tatsächlich anrichtet:
| Achse | Gewicht | 1 Punkt | 5 Punkte |
|---|---|---|---|
| Datenaktualität | 25 % | Undatierte Behauptungen | Jede Zahl datiert und belegt |
| Numerische Genauigkeit | 25 % | Zahlen stimmen nicht mit der Einreichung überein | Jede Zahl geht auf |
| Quellenqualität | 15 % | Ohne Zuordnung oder auf Blog-Niveau | Primäreinreichungen und Unternehmensmitteilungen |
| Risikoanalyse | 15 % | Nur das bullische Szenario | Ausdrückliche Invalidierungsmarken |
| Transparenz | 10 % | Schlussfolgerung ohne erkennbare Kette | Jeder Schritt nachvollziehbar |
| Handlungsfähigkeit | 10 % | Nur eine Zusammenfassung | Auslöser, Marken und Überwachungsrhythmus |
Bilden Sie die gewichtete Gesamtnote auf einer Skala bis 5. Alles unter 3,5 geht in eine weitere Runde zurück. Alles über 4,5, das noch immer keinen benannten Invalidierungspunkt hat, ist meist Selbstüberschätzung statt Exzellenz. Lassen Sie denselben Ticker durch zwei Familien laufen und bewerten Sie beide — nach den obigen Daten sollten die Punktzahlen dicht beieinanderliegen und sich die Art des Scheiterns unterscheiden.
Was das konkret für Ihre Aktienrecherche bedeutet
- Hören Sie auf, nach dem besten Modell zu suchen; bringen Sie den Aufbau in Ordnung. Ein Effekt von 25 Punkten durch die Zeiteinheit gegenüber 0,4 Punkten durch das Modell ist das gesamte Argument dafür, in den Arbeitsablauf statt in die Modellauswahl zu investieren.
- Wählen Sie das Labor nach Temperament passend zur Aufgabe, nicht nach Benchmark. Sie wollen eine Zweitmeinung, die Ihnen sagt, wenn sie unsicher ist? Nehmen Sie die am besten kalibrierte Familie. Sie wollen ein Memo, das sich auf Marken festlegt? Nehmen Sie die, die Zahlen nennt. Sie wollen einen Risikoprüfer, der einräumt, dass die These gebrochen ist? Nehmen Sie die, die Verluste nach sieben Minuten abschneidet.
- Rechnen Sie damit, dass der Hausstil bestehen bleibt. Da kein Labor speziell für diese Aufgabe trainiert, beobachten Sie eine allgemeine Grundhaltung — und die wird sich in das nächste Release übertragen.
- Setzen Sie mehr als eines ein und lassen Sie sie offen widersprechen. Die Familien scheitern auf unterschiedliche Weise, und genau deshalb bringt eine Debatte zwischen ihnen mehr zutage als jede Einzelantwort.
Warum SimianX AI einen Multi-Agenten-Ansatz verfolgt
Ein einzelnes Modell kann zusammenfassen, berechnen und schreiben. Aber die Aktienanalyse profitiert oft von Spezialistenmeinungsverschiedenheiten. Ein technisches Signal kann bullisch erscheinen, während die Bewertung überdehnt aussieht. Die Nachrichtenstimmung kann sich verbessern, während Insiderverkäufe Fragen aufwerfen. Ein Modell, das alles zu schnell in eine Antwort zusammenführt, kann diese Konflikte verbergen.
SimianX AI konzentriert sich auf die Marktanalyse mit mehreren Agenten anstelle einer einzelnen Chatbot-Antwort. Sein Wert liegt im Design von Arbeitsabläufen: spezialisierte Agenten können Fundamentaldaten, technische Analysen, Sentiment, Nachrichten und Risiken untersuchen und dann ihre Ergebnisse vergleichen, bevor ein abschließender Bericht erstellt wird.
Das ist wichtig, weil der beste AI-Aktienanalyse-Arbeitsablauf die Rollen trennen sollte:
- Fundamental-Agent: Umsatzwachstum, Margen, freier Cashflow, Verschuldung, Bewertung
- Technischer Agent:
RSI,MACD, gleitende Durchschnitte, Volatilität, Unterstützung/Widerstand
- Nachrichten-Agent: Katalysatoren, Analystenupdates, SEC-Einreichungen, Änderungen im Management
- Risiko-Agent: Thesis-Brecher, Drawdown-Risiko, Bedenken zur Positionsgröße
- Entscheidungs-Agent: integriert die Beweise in eine Forschungsprache für Kaufen/Halten/Verkaufen
Das bedeutet nicht, dass SimianX AI, GPT, Gemini, Claude oder irgendeine AI-Plattform Renditen garantieren kann. Die Aktienanalyse beinhaltet immer Unsicherheit. AI sollte bessere Forschung unterstützen, nicht Risikomanagement, Positionsgrößen oder das Urteil des Investors ersetzen.
Praktischer AI-Aktienforschungs-Arbeitsablauf, den Sie heute nutzen können
Hier ist ein wiederholbarer Arbeitsablauf für die Nutzung von GPT, Gemini, Claude oder SimianX AI, ohne AI zu einem Black-Box-Aktienpicker zu machen.
Schritt 1: Beginnen Sie mit der Investitionsfrage
Schlechter Prompt:
Ist diese Aktie ein Kauf?
Besserer Prompt:
Bewerten Sie, ob AAPL für einen Swing-Trading-Zeitraum von 6-12 Monaten basierend auf den jüngsten Gewinnen, der Bewertung, dem technischen Trend, den Nachrichtenkatalysatoren und dem Abwärtsrisiko attraktiv ist. Zeigen Sie Annahmen und zitieren Sie Quellen.
Der zweite Prompt definiert das Ticker-Symbol, den Zeitrahmen, die Forschungsdimensionen und die erforderlichen Beweise.
Schritt 2: Trennen Sie Fakten von Interpretationen
Bitten Sie die AI, zwei Abschnitte zu erstellen:
- Fakten: Zahlen, Daten, Einreichungen, Aussagen des Managements, Preisniveaus
- Interpretation: was diese Fakten für die These implizieren könnten
Dies reduziert das Risiko von Halluzinationen, da Sie die faktische Ebene überprüfen können, bevor Sie die Meinungs- oder Interpretationsschicht lesen.
Schritt 3: Einen pessimistischen Fall erzwingen
Jede AI-Aktienanalyse sollte einen ernsthaften pessimistischen Fall enthalten. Fragen Sie:
Welche Beweise würden diese These falsch machen, und welche Daten sollte ich wöchentlich überwachen?
Hier werden Modelle oft nützlicher. Sie helfen Ihnen, vage Risiken in konkrete Überwachungspunkte umzuwandeln.
Schritt 4: Mehrere Modelle oder Agenten verwenden
Ein robuster Arbeitsablauf könnte Folgendes verwenden:
- Gemini, um ein großes Paket von Einreichungen, Transkripten und Marktberichten zu verarbeiten.
- GPT, um Bewertungsszenarien zu berechnen und Tabellen zu erstellen.
- Claude, um ein ausgefeiltes Investitionsmemo zu entwerfen und Annahmen zu kritisieren.
- SimianX AI, um eine Multi-Agenten-Überprüfung durchzuführen und technische, fundamentale, Nachrichten- und Risikoperspektiven auf einer Plattform zu vergleichen.
Schritt 5: Überprüfen, bevor Sie handeln
Von AI generierte Marktforschung sollte immer mit zuverlässigen Quellen abgeglichen werden. Überprüfen Sie Einreichungen, Marktdaten, Nachrichten-Daten und Berechnungen, bevor Sie eine Investitionsentscheidung treffen.
Behandeln Sie eine von AI generierte Aktienempfehlung niemals als endgültig. Überprüfen Sie die Quellen, prüfen Sie die Zahlen, verstehen Sie die Risiken und ziehen Sie in Betracht, einen lizenzierten Finanzprofi um Rat zu fragen, der auf Ihre Situation zugeschnitten ist.
GPT vs Gemini vs Claude: Für wen sollten Investoren sich entscheiden?
Wählen Sie GPT, wenn Sie einen flexiblen Analysten für Datenbereinigung, Berechnungen, Diagrammerklärungen, Bewertungstabellen und Szenariomodellierung möchten. Es ist besonders nützlich, wenn Sie strukturierte Daten bereitstellen können und eine codegestützte Argumentation wünschen.
Wählen Sie Gemini, wenn Sie sehr große Dokumentensätze verarbeiten, viele PDFs vergleichen, lange Forschungsunterlagen synthetisieren oder zitierte Forschungsberichte aus umfangreichen Quellenmaterialien generieren müssen.
Wählen Sie Claude, wenn Ihre Arbeit wie professionelle Finanzdokumentation aussieht: Investitionsmemos, Pitchbooks, Modellüberprüfungen, Gewinnzusammenfassungen und ausgefeilte interne Berichte.
Wählen Sie SimianX AI, wenn Sie möchten, dass der Vergleich selbst zu einem Workflow wird: mehrere Agenten, die dasselbe Ticker-Symbol aus verschiedenen Perspektiven untersuchen, die Beweise diskutieren und ein klareres Forschungsergebnis produzieren.
Die stärkste Antwort ist nicht „GPT schlägt Gemini“ oder „Claude schlägt GPT.“ Die stärkste Antwort ist:
Verwenden Sie das richtige Modell für den richtigen Forschungsauftrag und kombinieren Sie dann die Ergebnisse durch einen transparenten, multi-agenten, von Menschen überprüften Prozess.
FAQ zu GPT vs Gemini vs Claude für KI-Aktienanalysen
Ist GPT genauer als Gemini für die Aktienanalyse?
Nicht messbar. Über 4.992 live von KI verwaltete Positionen schloss gpt-4o-mini mit einer Trefferquote von 59,0 % ab und gemini-2.5-flash-lite mit 58,8 % — ein Abstand von 0,2 Punkten bei jeweils rund 4.300 Positionen, also statistisches Rauschen. Kontrolliert man die Chart-Zeiteinheit, folgen beide einander in jedem Segment auf etwa einen Punkt genau. Was sich unterscheidet, ist das Temperament, nicht die Genauigkeit: Die Zeiteinheit, die Sie einem Modell vorgeben, bewegte die Ergebnisse rund 25-mal stärker als die Wahl des Modells.
Was ist die beste KI für die Aktienmarktforschung im Jahr 2026?
Es gibt keinen universellen Gewinner. GPT ist stark bei Berechnungen und flexibler Datenanalyse, Gemini ist stark bei langfristiger Forschung mit Kontext und multimodaler Quellensynthese, und Claude ist stark für professionelle Finanz-Workflows und ausgefeilte Ergebnisse. Für viele Investoren ist das beste Setup eine Multi-Agenten-Plattform wie SimianX AI, die verschiedene analytische Rollen kombiniert.
Wie benutze ich KI für Aktienforschung ohne Halluzinationen?
Verwenden Sie hochwertige Quellpakete, verlangen Sie Zitationen, trennen Sie Fakten von Interpretationen und überprüfen Sie alle Zahlen anhand von Einreichungen oder vertrauenswürdigen Finanzdaten. Bitten Sie das Modell, Annahmen, Unsicherheiten und das Bären-Szenario aufzuzeigen. Vermeiden Sie Eingaben, die nach nicht unterstützten „garantierten“ Vorhersagen fragen.
Können GPT, Gemini oder Claude Aktienpreise genau vorhersagen?
Sie können helfen, Faktoren zu analysieren, die den Preis beeinflussen, aber kein KI-Modell kann Aktienpreise zuverlässig mit Sicherheit vorhersagen. Märkte reagieren auf Gewinne, Liquidität, makroökonomische Schocks, Regulierung, Positionierung und unerwartete Nachrichten. KI wird am besten zur Beschleunigung der Forschung eingesetzt, nicht für garantierte Prognosen.
Ist SimianX AI besser als die alleinige Verwendung von ChatGPT, Gemini oder Claude?
SimianX AI ist anders, weil es sich auf die Analyse von Märkten mit mehreren Agenten konzentriert, anstatt auf eine einzige Chatbot-Antwort. Sein Vorteil liegt im Workflow-Design: spezialisierte Agenten können Fundamentaldaten, technische Analysen, Nachrichten und Risiken untersuchen und dann die Schlussfolgerungen vergleichen. Das kann für Investoren praktischer sein, die strukturierte, überprüfbare Aktienforschung wünschen.
Welches KI-Modell ist am besten zur Analyse von SEC-Einreichungen geeignet?
Gemini ist attraktiv für sehr große Dokumentensätze, GPT ist nützlich zum Extrahieren von Kennzahlen und zum Erstellen von Tabellen, und Claude ist stark darin, die Analyse von Einreichungen in professionelle Memos umzuwandeln. Der beste Ansatz ist, Extraktion, Berechnung und schriftliche Synthese zu kombinieren und dann jede Zahl mit der ursprünglichen Einreichung zu verifizieren.
Fazit
Die Debatte GPT vs Gemini vs Claude für die KI-Aktienanalyse dreht sich wirklich um die Qualität des Workflows. GPT ist hervorragend für Datenanalysen und Szenariomodellierung. Gemini ist leistungsstark für Forschung mit langem Kontext und große Quellsynthese. Claude ist stark im Schreiben im Finanzstil, der Dokumentenerstellung und professionellen Forschungsergebnissen. Aber die Aktienanalyse ist ein Problem mit mehreren Signalen, was bedeutet, dass die beste Antwort oft aus der Kombination von Modellen, Quellen und spezialisierten Perspektiven stammt.
Das ist der Kernwert von SimianX AI: Es verwandelt die KI-Aktienforschung in einen Multi-Agenten-Prozess, bei dem technische Signale, Fundamentaldaten, Nachrichten, Sentiment und Risiken gemeinsam überprüft werden können, anstatt in einer einzigen Chatbot-Antwort verborgen zu sein. Entdecken Sie SimianX AI, um einen transparenteren, disziplinierteren und forschungsbereiten Ansatz für die KI-gestützte Aktienanalyse zu entwickeln.
Verwandte Artikel
- SimianX AI: 4-Stufen-Multi-Agent-Aktienanalyse-Plattform
- 8 KI-Analysten vs 1: +37% Genauigkeit, −41% Risiko
- Multi-Agent-KI-Pipelines für Hedge-Fund-Tiefenresearch
- Welches KI-Modell handelt am besten? 30 LLMs an echtem P&L
- 30+ KI-Modelle, 6 Anbieter: Crypto-Live-Leaderboard
- Verkaufen KI-Modelle in einem Crash panisch? 31 Bots
- Multi-Agent KI vs ChatGPT für NVDA-Signale: 2026 Vergleich