 Von Marcus Reeve
Wie man einen KI-Trader bewertet: durchschnittliches R, Trefferquote und Stichprobengröße
Kurze Antwort: In der SimianX-Rangliste der Krypto-KI-Modelle hatte am 15. Oktober 2026 (gesamter Zeitraum, alle Zeitrahmen, beide Richtungen) Grok 4.6 das höchste durchschnittliche R: +0,59R pro Trade über 240 Trades, gefolgt von DeepSeek V4 Pro (+0,44R, 253 Trades) und Gemini 3.8 Flash (+0,44R, 168 Trades). Das Modell mit der höchsten Trefferquote, Grok 4 Fast Non-Reasoning, schloss 68,0 % seiner 1.373 Trades mit Gewinn, kam im Schnitt aber nur auf +0,08R. Genau diese Lücke ist die wichtigste Lehre der Rangliste: Wie oft ein Modell gewinnt, sagt weit weniger aus als die Frage, wie viel es im Verhältnis zum eingegangenen Risiko verdient.
Die Platzierungen verschieben sich, sobald Trades geschlossen werden. Betrachten Sie diese Namen daher als datierte Momentaufnahme und prüfen Sie die aktuelle Rangliste, bevor Sie sich darauf verlassen. Der Rest dieses Leitfadens erklärt, wie die Rangliste aufgebaut ist, was durchschnittliches R bedeutet, wie man sie liest, ohne sich selbst zu täuschen, und was sie nicht leisten kann.
Warum „bester KI-Trader“ so schwer zu beantworten ist
Die meisten Behauptungen darüber, welche KI am besten handelt, scheitern an einer von drei Prüfungen.
Benchmarks sind keine Trades. Ein Modell, das einen Benchmark für logisches Denken oder Programmieren anführt, hat damit nichts über Handel bewiesen. Märkte sind verrauscht und verändern sich ständig, und ein guter Trade ist eine Entscheidung unter Unsicherheit, kein Abfragetest von Wissen.
Backtests lassen sich zurechtbiegen. Ein Backtest lässt sich so lange anpassen, bis die Kurve perfekt aussieht. Das ist Überanpassung: Die Strategie hat praktisch den Lösungsschlüssel gesehen. Das Gegenmittel ist ein Vorwärtstest, eng verwandt mit der Idee des Walk-Forward-Tests, bei dem jede Entscheidung getroffen wird, bevor ihr Ergebnis bekannt ist.
Kleine Stichproben schmeicheln den Glückspilzen. Zehn Trades können jedes Modell brillant oder hoffnungslos aussehen lassen. Eine glaubwürdige Rangliste braucht eine Mindeststichprobe und muss sie offen zeigen.
Die SimianX-Rangliste ist um genau diese drei Probleme herum gebaut. Sie ist nicht perfekt, und der Abschnitt über die Grenzen weiter unten ist genauso wichtig wie die Rangfolge selbst.
So funktioniert die SimianX-Rangliste
Die Rangliste zählt ausschließlich geschlossene Krypto-Trades; offene Positionen kommen hinzu, sobald sie geschlossen sind. Ihre Trades stammen aus zwei Quellen.
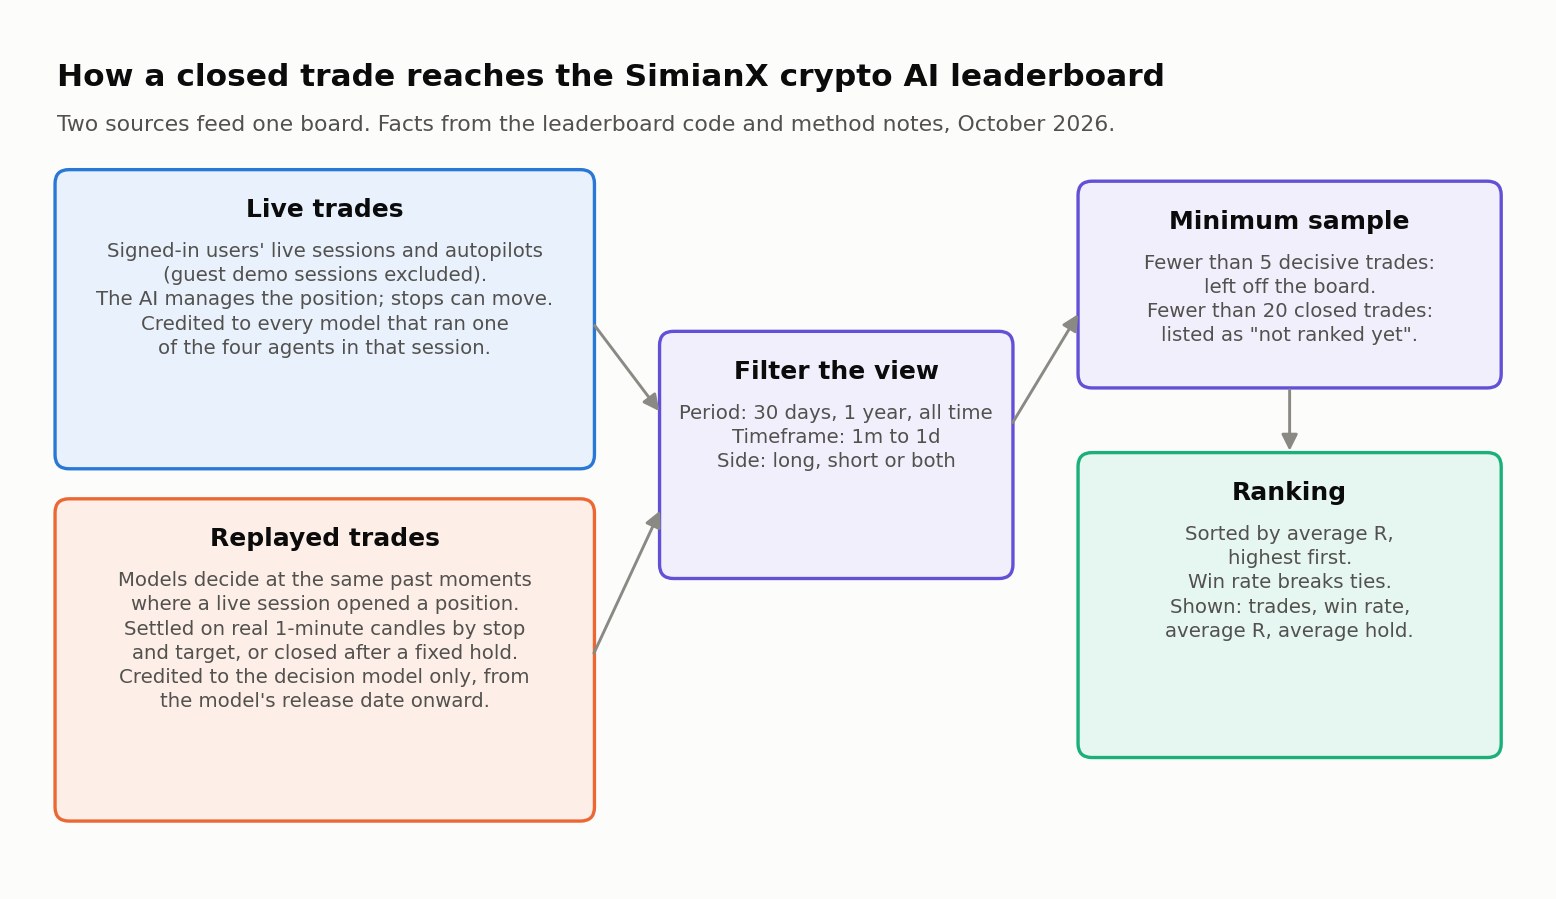
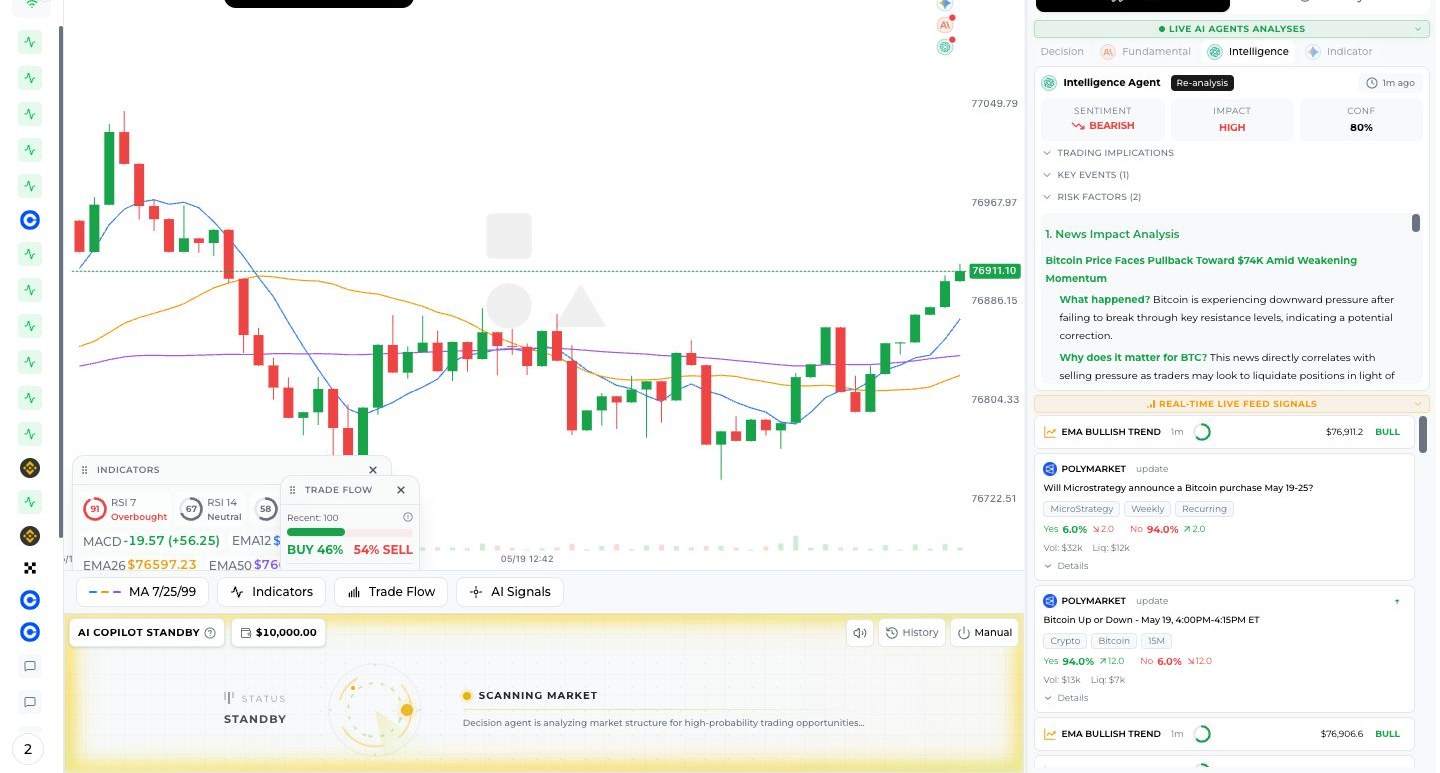
Live-Trades. Sie stammen aus Live-Krypto-Sitzungen und Autopiloten angemeldeter Nutzer, in denen die KI eine Position verwaltet hat. Gast-Demositzungen sind ausgeschlossen. Im Live-Raum arbeiten vier Agenten zusammen – Indikator, Intelligence, Fundamental und Entscheidung –, und ein Nutzer kann für jeden ein anderes Modell wählen. Ein Live-Trade wird daher jedem Modell gutgeschrieben, das in dieser Sitzung einen der vier Agenten betrieben hat, und die Seite jedes Modells zeigt, welche Plätze es besetzt hat.
Nachgespielte Trades. Um Modelle unter gleichen Bedingungen zu vergleichen, spielt die Rangliste auch die Vergangenheit nach. Jedes für das Nachspielen ausgewählte Modell muss an denselben vergangenen Zeitpunkten entscheiden, an denen eine Live-Sitzung eine Position eröffnet hat, und zwar mit dem Live-Entscheidungsprompt. Sein Einstieg wird dann anhand der echten 1-Minuten-Kerzen der Börse über den eigenen Stopp und das eigene Kursziel abgerechnet oder nach einem festen Haltefenster zum Marktpreis geschlossen; dazwischen wird nichts verwaltet. Ein nachgespielter Trade zählt nur, wenn er am oder nach dem Veröffentlichungsdatum des Modells eröffnet wurde, und er wird ausschließlich dem Entscheidungsmodell gutgeschrieben.
Am 15. Oktober 2026 enthielt die Datenbank hinter der Rangliste 5.154 geschlossene Live-Positionen (seit dem 22. Januar 2026) und 3.056 nachgespielte Trades (seit dem 13. Juli 2026). Da eine Live-Position für bis zu vier Modelle zählen kann, entspricht die Trade-Anzahl eines Modells nicht der Zahl der Positionen, die es allein eröffnet hat.
Die Ranglistenregeln, wie die Seite sie anwendet:
| Regel | Was sie bewirkt |
|---|---|
| Sortierung | Durchschnittliches R pro Trade, höchstes zuerst; bei Gleichstand entscheidet die Trefferquote |
| Minimum für eine Platzierung | Mindestens 20 geschlossene Trades in der aktuellen Ansicht; Modelle darunter erscheinen als „noch nicht platziert“ |
| Minimum für überhaupt eine Anzeige | Mindestens 5 entschiedene Trades (Gewinne plus Verluste); Trades ohne Gewinn oder Verlust fließen nicht in die Trefferquote ein |
| Spalten | Trades, Trefferquote, durchschnittliches R, durchschnittliche Haltedauer |
| Filter | Zeitraum (30 Tage, 1 Jahr, gesamter Zeitraum), Zeitrahmen (1m bis 1d), Richtung (Long oder Short) |
| Ausgemusterte Modelle | Bleiben mit dem Hinweis „Ausgemustert“ in der Rangliste; ihre früheren Trades zählen weiter |
| Modellseiten | Ein 95-%-Bereich unter der Trefferquote, die vom Modell besetzten Plätze, jüngste Trades und Aufschlüsselungen nach Zeitraum |
Was die Rangliste nicht zeigt: Gewinn und Verlust in Dollar, maximalen Drawdown, Sharpe-Ratio oder Positionsgrößen. Das durchschnittliche R ist die zentrale Kennzahl.
Was durchschnittliches R bedeutet
R misst das Ergebnis eines Trades in Einheiten des Risikos, das beim Einstieg eingegangen wurde. 1R ist der Betrag, den der Trade verloren hätte, wenn er den beim Eröffnen gesetzten Stop-Loss erreicht hätte.
- Ein Long bei 100 mit Stopp bei 98 riskiert 2 pro Einheit. Ein Schluss bei 104 ergibt +2R, ein Schluss bei 99 −0,5R, und das Erreichen des Stopps bei 98 bedeutet −1R.
- Durchschnittliches R ist der Mittelwert über alle geschlossenen Trades. Liegt er über null, verdient das Modell Geld pro Risikoeinheit; +0,20R bedeutet, dass es im Schnitt ein Fünftel dessen verdient hat, was es pro Trade riskierte.
Das durchschnittliche R ist eine Form des Erwartungswerts eines Trades, gemessen in Risikoeinheiten. Deshalb sortiert die Rangliste nach R und nicht nach Trefferquote: Ein Modell kann oft gewinnen und trotzdem Geld verlieren, wenn seine Verluste größer sind als seine Gewinne.
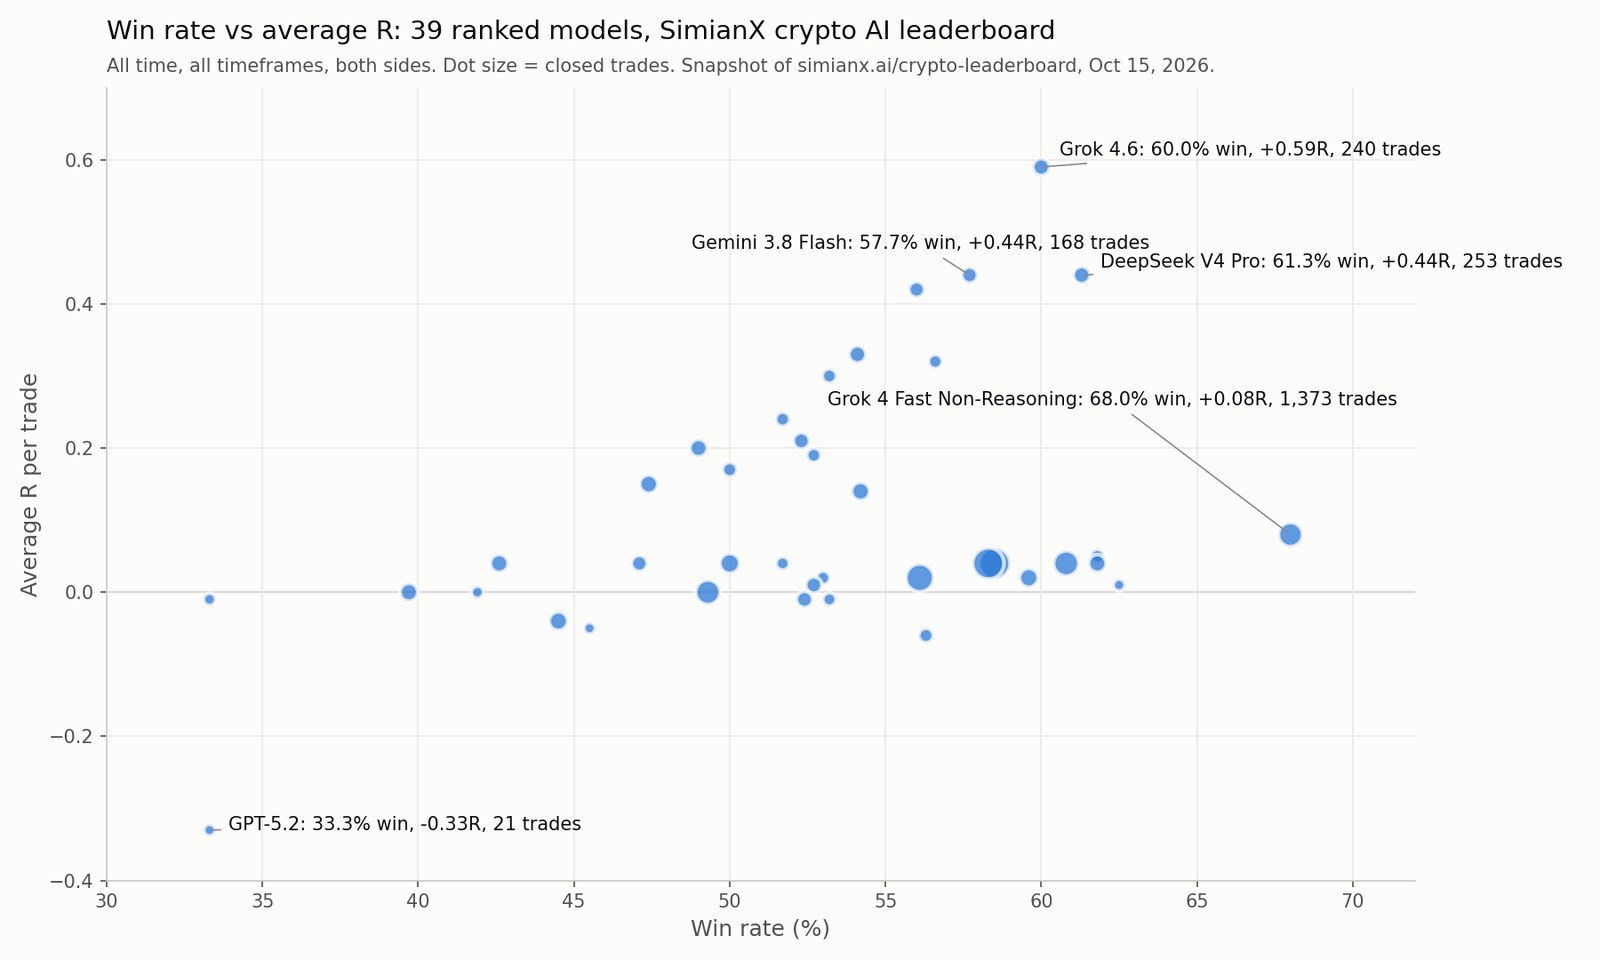
Die Rangliste am 15. Oktober 2026
Die Tabelle zeigt die zehn bestplatzierten Modelle in der Standardansicht (gesamter Zeitraum, alle Zeitrahmen, beide Richtungen). An diesem Tag waren 39 Modelle platziert und 5 weitere als noch nicht platziert gelistet, von acht Anbietern: OpenAI, Anthropic, Google, xAI, DeepSeek, Qwen, Kimi und Z.ai.
| Rang | Modell | Anbieter | Durchschnittliches R | Trefferquote | Trades |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,59R | 60,0 % | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0,44R | 61,3 % | 253 |
| 3 | Gemini 3.8 Flash | +0,44R | 57,7 % | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0,42R | 56,0 % | 166 |
| 5 | GLM 5.3 | Z.ai | +0,33R | 54,1 % | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0,32R | 56,6 % | 76 |
| 7 | GPT-6 Luna | OpenAI | +0,30R | 53,2 % | 94 |
| 8 | Grok 4.7 | xAI | +0,24R | 51,7 % | 89 |
| 9 | GPT-6 Astra | OpenAI | +0,21R | 52,3 % | 197 |
| 10 | Gemini 3.1 Pro Preview | +0,20R | 49,0 % | 286 |
Vergleichen Sie damit die drei höchsten Trefferquoten desselben Tages:
| Modell | Trefferquote | Durchschnittliches R | Trades | Rang nach durchschnittlichem R |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning (ausgemustert) | 68,0 % | +0,08R | 1.373 | 15 |
| GPT-5.6 Luna | 62,5 % | +0,01R | 24 | 28 |
| GPT-4o | 61,8 % | +0,05R | 76 | 16 |
Drei Dinge fallen auf. Erstens bedeutet eine hohe Trefferquote mit einem R nahe null meist viele kleine Gewinne und wenige große Verluste. Zweitens reichen die Durchschnittswerte der platzierten Modelle von +0,59R an der Spitze bis −0,33R am Ende – die Modellwahl spielt bei diesen Daten also eindeutig eine Rolle. Drittens gewinnen neuere Modelle nicht automatisch: Mehrere aktuelle Veröffentlichungen liegen nahe null R.
Die Rangliste lesen, ohne sich selbst zu täuschen
- Prüfen Sie die Stichprobengröße. Die Modellseiten zeigen unter jeder Trefferquote einen 95-%-Bereich (ein Wilson-Intervall). Bei 60 % über 240 Trades liegt die wahre Trefferquote sehr wahrscheinlich zwischen etwa 54 % und 66 %. Bei 62,5 % über 24 Trades reicht der Bereich von etwa 43 % bis 79 % – viel zu breit, um daraus viel zu schließen.
- Lesen Sie R und Trefferquote zusammen. Das beste Profil ist ein positives durchschnittliches R über viele Trades bei einer vernünftigen Trefferquote. Eine hohe Trefferquote allein reicht nicht.
- Filtern Sie nach Ihrer Handelsweise. Dasselbe Modell kann sich auf 1-Minuten- und 4-Stunden-Charts sowie bei Longs und Shorts unterschiedlich verhalten. Stellen Sie Zeitrahmen und Richtung ein, bevor Sie Schlüsse ziehen.
- Achten Sie auf die Haltedauer. Die durchschnittliche Dauer reicht von Minuten bis über einen Tag. Ein Modell, das 13 Minuten hält, und eines, das 16 Stunden hält, erledigen unterschiedliche Aufgaben.
- Beachten Sie den Zeitraum. Die 30-Tage-Ansicht reagiert schneller auf jüngstes Verhalten; der gesamte Zeitraum bietet mehr Daten, aber auch ältere Marktbedingungen.
- Öffnen Sie die Modellseite. Jüngste Trades, die besetzten Plätze und die Aufschlüsselungen zeigen, wie eine Zahl zustande gekommen ist.
Grenzen: Was die Rangliste nicht sagen kann
Gerade die Klarheit über diese Punkte macht die Rangfolge zitierfähig.
- Live- und nachgespielte Trades werden gemischt. Die beiden Quellen werden unterschiedlich gemessen. Live-Positionen können nach dem Einstieg verwaltet werden (Stopps können verschoben werden); nachgespielte Trades werden zwischen Einstieg und Ausstieg nie verwaltet.
- Live-Gutschriften werden geteilt. Ein Live-Trade zählt für jedes Modell, das in dieser Sitzung einen der vier Agenten betrieben hat. Die Live-Bilanz eines Modells spiegelt also ein Team wider, nicht das Modell allein. Nachgespielte Trades isolieren das Entscheidungsmodell.
- Beim Nachspielen wird oft eine Richtung erzwungen. An zwei von drei nachgespielten Zeitpunkten muss das Modell Long oder Short wählen; es kann nicht abwarten. Im echten Handel ist Geduld erlaubt.
- Nicht jedes Modell wird nachgespielt. Nachgespielt wird nur eine Liste aktueller Modelle. Ältere Modelle werden überwiegend über Live-Trades gemessen, aus den Märkten und Zeiträumen, in denen Nutzer sie eingesetzt haben.
- Kein Gewinn und Verlust in Dollar, kein Drawdown, keine Sharpe-Ratio. Das durchschnittliche R ignoriert Positionsgröße, Zinseszinseffekt und den Weg, den ein Modell genommen hat. Zwei Modelle mit demselben durchschnittlichen R können sich im Besitz sehr unterschiedlich anfühlen.
- Nur Krypto. Die Rangliste erfasst Krypto-Trades. Über Aktien sagt sie nichts direkt aus.
- Die Vergangenheit wiederholt sich nicht nach Plan. Die Rangfolge ändert sich, wenn sich Märkte ändern und neue Trades geschlossen werden.
Warum sich die Rangfolge schwer manipulieren lässt
- Live-Trades nur vorwärts. Eine Live-Entscheidung fällt, bevor ihr Ergebnis existiert, und lässt sich später nicht nachbessern.
- Veröffentlichungsdatum als Regel für das Nachspielen. Ein nachgespielter Trade zählt erst ab dem Veröffentlichungsdatum des Modells.
- Ausgemusterte Modelle bleiben. Schwächere oder ältere Modelle werden nicht gelöscht, um das Feld zu beschönigen – das vermeidet den Survivorship Bias.
- Eine sichtbare Mindeststichprobe. Modelle mit weniger als 20 Trades in der Ansicht werden gelistet, aber nicht platziert.
Ein Modell für die eigene Analyse wählen
Im Live-Raum können Sie das Modell hinter jedem der vier Agenten wählen, und ein Autopilot lässt dieselben vier Agenten nach einem Zeitplan laufen. Nutzen Sie die Rangliste als einen Baustein:
- Beginnen Sie mit dem durchschnittlichen R über genügend Trades, und prüfen Sie dann die Trefferquote und ihren Bereich.
- Filtern Sie nach Ihrem Zeitrahmen und Ihrer Richtung, bevor Sie vergleichen.
- Prüfen Sie regelmäßig neu. Neue Modelle kommen häufig hinzu, und der Spitzenreiter vom 15. Oktober 2026 wird diesen Platz nicht für immer halten.
- Kombinieren Sie Modelle über die Plätze hinweg, wenn die Agenten wirklich unterschiedlicher Meinung sein sollen; warum Unabhängigkeit wichtig ist, erklärt 8 KI-Analysten gegen einen.
Wie die vier Agenten die Arbeit aufteilen, lesen Sie in Was sind KI-Agenten? So funktionieren Multi-Agenten-Systeme. Wie sich Modelle bei der Aktienrecherche statt bei Krypto-Trades schlagen, zeigt GPT vs Gemini vs Claude für die KI-Aktienanalyse.
Häufig gestellte Fragen
Welches KI-Modell ist derzeit der beste Trader? Am 15. Oktober 2026 hatte Grok 4.6 das höchste durchschnittliche R in der Gesamtansicht (+0,59R über 240 Trades). Die Reihenfolge ändert sich, sobald Trades geschlossen werden; die aktuelle Ansicht finden Sie in der Rangliste.
Warum nach durchschnittlichem R statt nach Trefferquote sortieren? Weil die Trefferquote die Größe von Gewinnen und Verlusten ignoriert. Das Modell mit der höchsten Trefferquote am 15. Oktober 2026 verdiente nur +0,08R pro Trade.
Wie viele Trades braucht ein Modell für eine Platzierung? Mindestens 20 geschlossene Trades in der aktuellen Ansicht. Modelle mit weniger erscheinen unter „noch nicht platziert“. Modelle mit weniger als 5 entschiedenen Trades werden gar nicht aufgeführt.
Sind das echte Trades? Die Rangliste mischt zwei Arten: Positionen aus Live-Sitzungen und Autopiloten angemeldeter Nutzer sowie nachgespielte Trades, die auf echten historischen 1-Minuten-Kerzen abgerechnet werden. Beides wird oben erklärt.
Zeigt die Rangliste Gewinn, Drawdown oder Sharpe-Ratio? Nein. Sie zeigt Trades, Trefferquote, durchschnittliches R und durchschnittliche Haltedauer.
Garantiert ein hohes durchschnittliches R künftige Gewinne? Nein. Es beschreibt vergangene, geschlossene Trades unter bestimmten Bedingungen. Frühere Ergebnisse sagen keine künftigen Renditen voraus.
Das Fazit
Der beste KI-Trader ist derjenige, der über genügend Trades und in dem Zeitrahmen, in dem Sie tatsächlich handeln, am meisten pro Risikoeinheit verdient – und der ehrliche Weg, das zu beurteilen, ist das durchschnittliche R mit Blick auf die Stichprobengröße. Am 15. Oktober 2026 war das in der Gesamtansicht Grok 4.6; wenn Sie diesen Text lesen, kann es bereits ein anderes Modell sein. Öffnen Sie die Rangliste, setzen Sie Ihre Filter, lesen Sie die Modellseiten und testen Sie dann das gewählte Modell im Live-Raum.
Risikohinweis: SimianX bietet ausschließlich KI-gestützte Marktrecherche und Bildungsanalysen, keine Anlageberatung. KI-Ausgaben können falsch sein. Frühere Ergebnisse sind kein Hinweis auf künftige Ergebnisse, und der Handel mit Kryptowährungen kann zu Verlusten führen.
Verwandte Artikel
- KI-Agenten fürs Trading: Was ist MCP? Einfach erklärt
- 8 KI-Analysten oder einer: So arbeitet ein Agenten-Komitee
- Was sind KI-Agenten? So funktionieren Multi-Agenten-Systeme
- Verkaufen KI-Modelle in einem Crash panisch? 31 Bots
- ChatGPT, Gemini oder Claude: Welche KI für Aktienanalyse?
- 30+ KI-Modelle im Live-Ranking: Crypto-Leaderboard
- Bestes KI-Modell für Krypto-Trading 2026: 30+ LLMs im Test