GPT vs Gemini vs ClaudeによるAI株式分析:2026年ガイド
GPT vs Gemini vs ClaudeによるAI株式分析はもはや「どのチャットボットが最も賢い答えを出すか?」という単純な質問ではありません。2026年には、真剣な投資家は、提出書類を読み、決算発表を解析し、チャートを検査し、評価を比較し、ライブニュースを追い、不確実性を説明し、意思決定可能なリサーチノートを作成できるワークフローを必要としています。だからこそ、このガイドではモデルの誇大広告を超えて、実用的な市場調査のためにGPT、Gemini、Claude、そしてSimianX AIが使用するマルチエージェントアプローチを比較します。 さらに本ガイドでは、自社のコマンドルームで動く4,992件のライブAI運用ポジションに3つのファミリーをぶつけています。最も多くを明かす比較は、どのモデルが賢そうに聞こえるかではなく、ポジションが含み損を抱えたときに各ラボの訓練がどう表に出るかだからです。
AI株式分析が複数のスマートモデルを必要とする理由
株式研究の決定は単なる言語の問題ではありません。それはマルチシグナル推論の問題です。あるモデルは10-Kをうまく要約できるかもしれませんが、ライブのカタリストを見逃すかもしれません。別のモデルは長いコンテキストの読み取りに優れているかもしれませんが、スプレッドシートスタイルの感度分析には弱いかもしれません。三つ目のモデルは洗練された投資メモを書くことができるかもしれませんが、接続されたデータの質に大きく依存するかもしれません。
AI株式研究にとって、最も有用なシステムは次のような質問に答える必要があります:
- 最新の決算発表で何が変わったのか?
- 評価倍率は収益やフリーキャッシュフローよりも速く拡大しているのか?
- モメンタムはボリュームによって支持されているのか、それとも価格の動きは脆弱なのか?
- ニュースのセンチメントはファンダメンタルズと矛盾しているのか?
- 上昇ケースと下降ケースを駆動する仮定は何か?
- 何がこの仮説を間違ったものにするのか?
重要なポイント: 株式分析に最適なAIは通常、単一のモデルではありません。それは新鮮なデータ、専門的な推論、透明な引用、リスクチェック、そして人間のレビューを組み合わせたワークフローです。
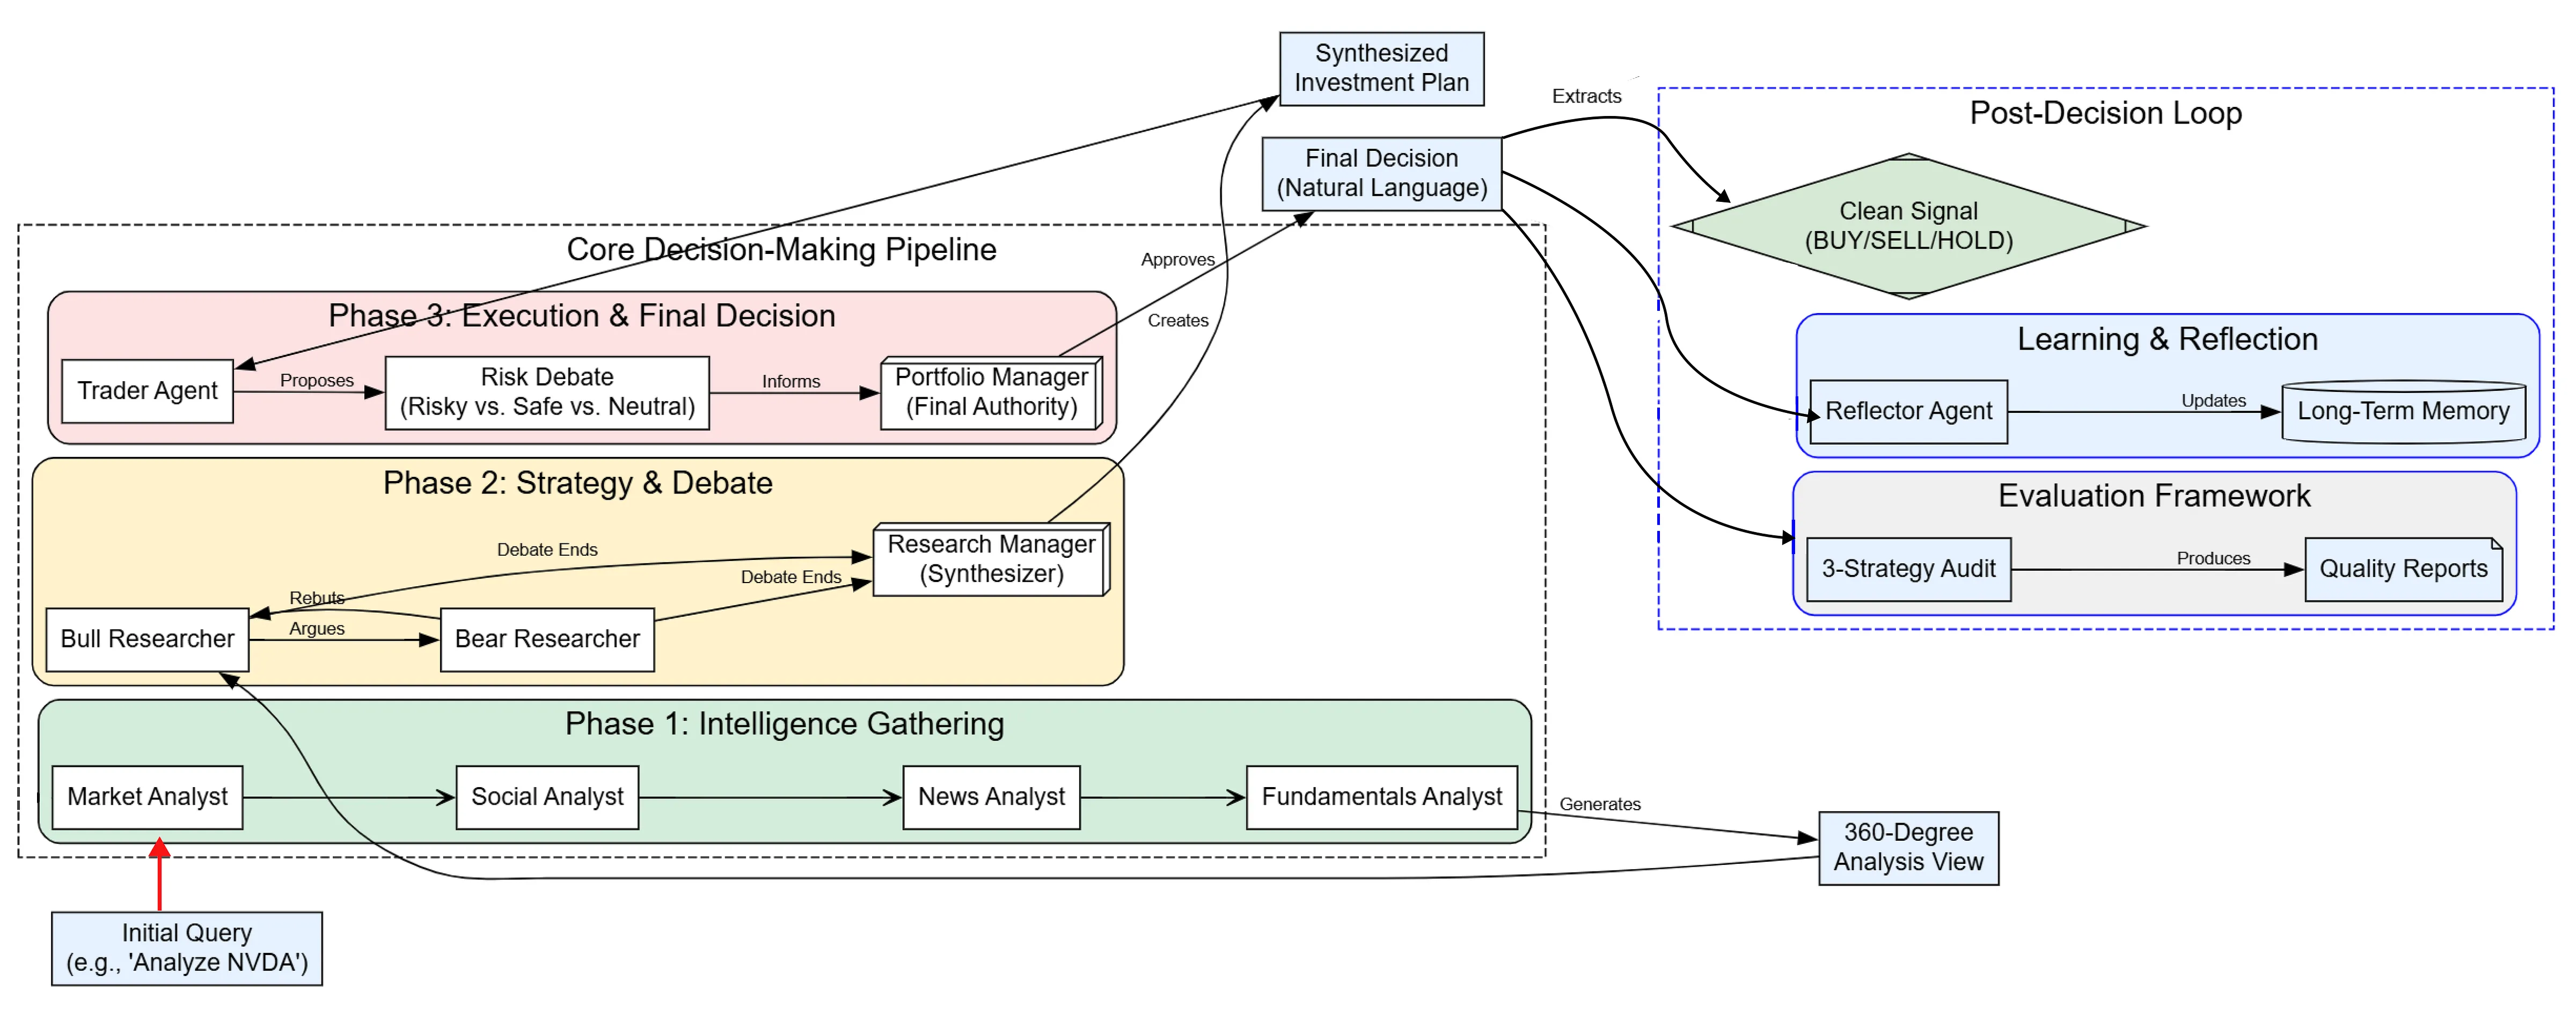
ここでマルチエージェント株分析が重要になります。SimianX AIは、投資家がファンダメンタル、マーケット構造、テクニカルシグナル、センチメント、リスクを、単一のチャットボットの応答よりも構造的に比較できるようにするために、マルチエージェントアプローチを使用しています。
GPT vs Gemini vs ClaudeによるAI株分析:簡潔な結論
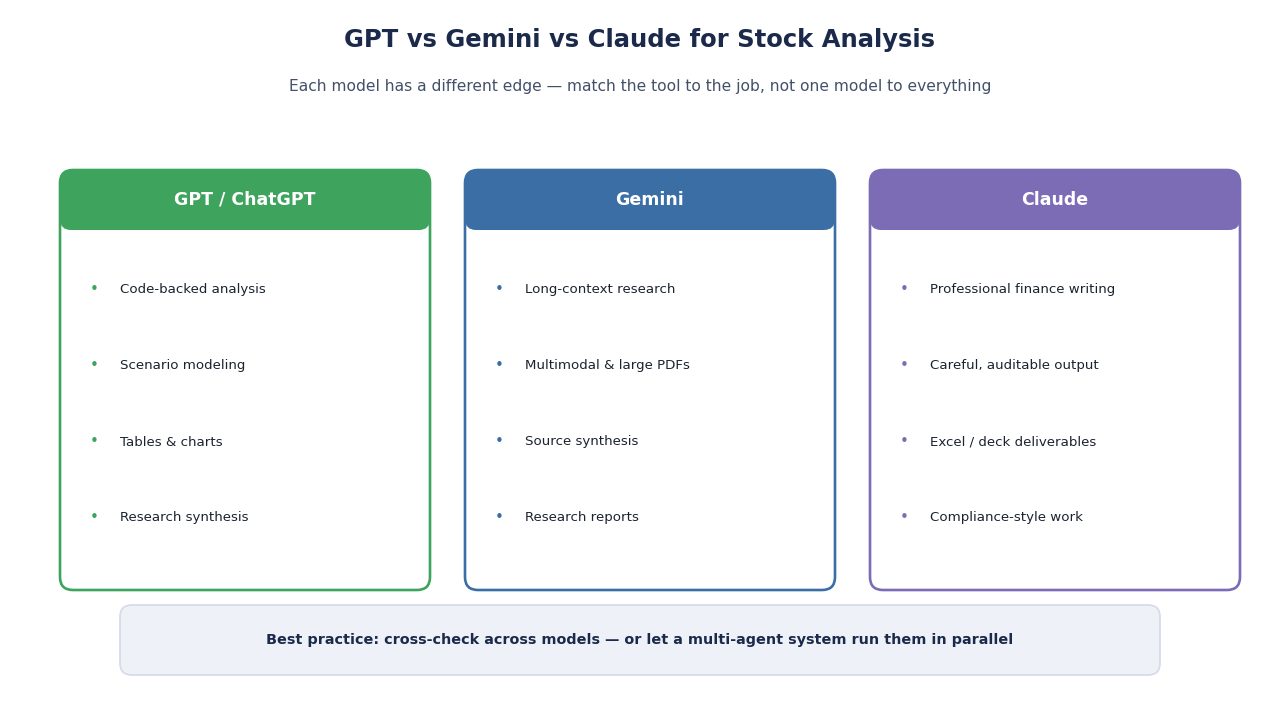
各モデルファミリーは、株式研究において異なる「最適な使用法」を持っています。実用的な答えは、データ分析、長文研究、金融ワークフロー統合、またはマルチエージェントディベートのいずれが必要かによって異なります。
| プラットフォーム | 最も強力な株式分析の使用ケース | 注意点 | 最適な組み合わせ |
|---|---|---|---|
| GPT / ChatGPT | コードに基づく分析、シナリオモデリング、テーブル、チャート、研究の統合 | 検証されたソースと慎重なプロンプト設計が必要 | Pythonスタイルのデータチェック、提出書類、評価テンプレート |
| Gemini | 長文、マルチモーダル研究、大きなPDF、研究報告書、チャート | 出力の質はソースの選択と設定に依存 | 大規模な文書セット、マーケットマップ、アナリストノートの統合 |
| Claude | プロフェッショナルな金融ワークフロー、慎重な執筆、Excel/PowerPointスタイルの成果物 | エンタープライズ金融機能は有料アクセス/コネクタに依存する場合があります | 投資メモ、ピッチブック、モデルレビュー、コンプライアンスワークフロー |
| SimianX AI | テクニカル、ファンダメンタル、ニュース、ディベートレイヤーを持つマルチエージェント株分析 | 依然として投資家の判断が必要; AIがリターンを保証することはできません | 一つのワークフローでモデルの多様性を求めるトレーダーと研究者 |
OpenAIのGPTモデルは、構造化された金融推論、カスタムデータ分析、シナリオモデリングにしばしば役立ちます。Google Geminiは、特に提出書類、報告書、画像、長文を比較する際に、広範な文書重視の研究に魅力的です。Claudeは、出力がプロフェッショナルな金融メモ、ピッチブックのアウトライン、または投資委員会のブリーフのように見える必要があるときに強力です。
AI株式分析のためのGPT:データ作業とシナリオモデリングに最適
GPTは、研究タスクが混乱した財務データを構造化された分析に変換することを含む場合に特に役立ちます。株式研究のワークフローでは、アップロードされたファイルを検査し、テーブルやチャートを作成し、成長率を計算し、前提条件を平易な英語で説明することを意味することがあります。GPTは、エクスポートされた価格履歴を分析したり、四半期の指標のCSVをクリーンアップしたり、ユーザー提供の前提からシンプルな割引キャッシュフローモデルを構築したりするのに役立ちます。
例えば、GPTを活用した株式ワークフローは次のようになります:
- 収益、粗利益、営業利益、フリーキャッシュフロー、株式数のスプレッドシートをアップロードします。
- GPTに複利成長、マージントレンド、フリーキャッシュフローの変換を計算するように依頼します。
- 強気、ベース、弱気のケースの前提を求めます。
EV/Sales、EV/EBITDA、またはP/Eを使用して評価テーブルを生成します。- 出力を実際の提出書類や市場データと比較します。
GPTの最大の利点は、コードに裏打ちされた分析による柔軟な推論です。 生の入力を計算、チャート、書面による説明に変換するのが非常に得意です。SECの提出書類、財務API、またはスプレッドシートからデータを既に持っている投資家にとって、GPTは強力な研究アシスタントとなることができます。
ただし、GPTは自動的に信頼できる株式選定者ではありません。「今日NVDAを買うべきですか?」と尋ねても、時間の範囲、リスク許容度、ポートフォリオの文脈、またはライブデータソースを提供しない場合、答えは自信に満ちて聞こえるかもしれませんが、依然として不完全です。GPTは分析構築に使用し、盲目的な取引実行には使用しないでください。
株式市場の研究にGPTを使用すべき時はいつですか?
GPTが必要なときは、モデル化、計算、説明、文書化を行ってください。カスタム画面、シナリオ分析、収益概要テンプレート、ポートフォリオエクスポージャーテーブル、複雑な比率の平易な説明にうまく機能します。また、自分の仮説に欠けている前提がないかを確認するのにも役立ちます。
AI株式分析のための強力なGPTプロンプトは次のようになります:
この会社の過去12四半期の収益、粗利益率、営業利益率、フリーキャッシュフロー、負債、株式数を分析してください。トレンドの変化を特定し、強気/中立/弱気の評価範囲を計算し、最も間違っている可能性の高い5つの前提をリストアップしてください。
このプロンプトは、単なる売買の回答ではなく、構造化された分析、計算、不確実性を求めているため機能します。
AI株式分析のためのGemini:長文コンテキスト研究と情報統合に最適
Geminiの主な利点は、長文コンテキストのマルチモーダル研究です。株式分析において、これは重要です。なぜなら、公開企業の研究はしばしば年次報告書、四半期報告、議事録、製品ビデオ、規制PDF、アナリストのコメント、マクロ文書にわたるからです。大きなコンテキストウィンドウを処理できるモデルは、1つのワークフローではるかに多くのソース資料を比較できます。
これにより、Geminiは次のような質問に役立ちます:
- “
AAPL、MSFT、GOOGLの過去3年間の年次報告書をAIキャピタルエクスペンディチャーの言語で比較してください。”
- “2年間の提出書類にわたるリスク要因の変更を要約してください。”
- “半導体サプライチェーンのエクスポージャーの市場マップを作成してください。”
- “5つの決算発表の議事録から経営陣のトーンを抽出し比較してください。”
- “複数のPDFからチャートに適した研究概要を作成してください。”
Geminiは、タスクが広範で文書が多く、マルチモーダルなときに最も強力です。 投資家が手動で検査するには煩雑な大規模な研究コーパス全体でパターンを見つけるのを助けることができます。
注意すべき点は、大規模なコンテキスト能力が自動的により良い投資判断を意味するわけではないということです。情報源が古く、偏っていたり、宣伝的であったり、不完全であったりすると、出力は依然として欠陥があるかもしれません。株式研究において、情報源の選択は分析の一部です。ジェミニは、高品質の提出書類、トランスクリプト、市場データ、研究ソースを提供するときに強力です。
AI株式分析のためのクロード:プロフェッショナルなファイナンスワークフローに最適
クロードの利点はワークフローディシプリンです。クロードは、財務研究が投資メモ、収益要約、ポートフォリオ更新、またはデューデリジェンスノートなどの洗練された文書にする必要があるときにしばしば役立ちます。その文体は慎重でバランスが取れており、プロの読者に適応しやすいです。
これにより、クロードは以下の点で価値があります:
- バランスの取れた理由付けで投資メモを作成する
- 評価手法をレビューする
- 財務モデルを構築またはチェックする
- ピッチブックスタイルの出力を準備する
- 収益トランスクリプトを要約する
- ボードレベルまたはクライアント向けのコメントを作成する
- 投資委員会の会議前に仮説をストレステストする
クロードの制限は実用的なアクセスです。最もファイナンス特化型のワークフローは、利用可能なコネクタ、有料機能、または手動アップロードに依存する場合があります。個人投資家にとって、クロードは推論と執筆において依然として優れていますが、データパイプラインには外部ツールが必要になるかもしれません。
AI株式分析のためのGPT、ジェミニ、クロードを比較する最良の方法は?
これらのモデルを比較する最良の方法は、それぞれに株の選択を求めることではありません。より良いテストは、各モデルに同じ研究タスクを与え、証拠、計算、リスク認識、役立ち度に基づいて出力を評価することです。
この評価フレームワークを使用してください:
| 評価要因 | 確認すべきこと | なぜ重要か |
|---|---|---|
| データの新鮮さ | 現在の申告、ニュース、価格を使用していますか? | 古いデータは取引の仮説を破る可能性があります |
| ソースの質 | 引用は申告、企業のリリース、信頼できる財務データ、または評判の良いニュースからですか? | 弱いソースは弱い結論を生み出します |
| 数値の正確性 | 比率、成長率、評価テーブルは正しいですか? | 小さな計算ミスが仮説を変えることがあります |
| リスク分析 | 下振れ、不確実性、無効化ポイントを説明していますか? | 良い研究は単に強気の証拠ではありません |
| 透明性 | モデルがどのように結論に達したかを追跡できますか? | 監査可能性は盲目的な信頼を防ぐのに役立ちます |
| 実行可能性 | 概要だけでなく、次のステップを提供していますか? | 投資家は決定、ウォッチリスト、トリガーが必要です |
簡単な比較テスト:
TSLA、NVDA、またはAAPLなどのティッカーを選択します。- 同じソースパケットを収集します:最新の10-K/10-Q、最近の収益トランスクリプト、1年間の価格データ、最近のニュース、主要な評価指標。
- GPT、Gemini、Claudeに同じ出力を生成するように依頼します:仮説、主要なドライバー、リスク、評価範囲、結論を変える要因。
- すべての数字をソースパケットと照合します。
- 実際の投資プロセスに最も役立つ出力を比較します。
最も自信を持って聞こえるモデルが、必ずしも最も正しいモデルとは限りません。 株式分析において、勝者は最も検証しやすいシステムです。
4,992件の実取引が明かす、各ラボの訓練スタイル
ここまではすべて定性的な議論です。より難しい問いは、その違いが実際の結果に現れるのかどうか。そこで私たちは自社のログを開きました。
SimianXは、AIモデルが明確なエントリー、ストップロス、目標値を設定したうえで、実際に監視付きのポジションを取るライブ・コマンドルームを運営しています。2026年1月22日から8月28日までの期間に、このシステムは4,992件のポジションを決済し、6プロバイダー・35モデルにわたる20,016件のモデル-ポジション記録を生み出しました。
この節の正しい読み方:測っているのは「流派の作法」であり、売買の腕前ではない
これらの数字をどう使うべきかを決める前提が二つあり、どちらも数字そのものより重要です。
第一に、現時点で売買専用に訓練されたモデルを出しているラボは一つもありません。 GPT、Gemini、Claude、Grok、DeepSeek、Qwenはいずれも汎用システムであり、どれ一つとして最適化されていない仕事をやらされています。したがって勝率の表は、売買能力のランキングではありません。それが実際に暴き出しているのは各流派の気質です。つまり、ある組織の訓練とアラインメントの選択が、モデルが現実の結果を伴う不確実性のなかで行動を迫られたときの振る舞いをどう形づくっているか、ということです。間違いをどれだけ早く認めるか。どれだけ言葉を濁すか。具体的な数字にコミットするか。この傾向はモデルのバージョンではなくラボの指紋であり、だからこそ世代を越えて持続しやすく、どんなベンチマークのスコアよりも、そのラボの次のモデルがどう振る舞うかを見通す手がかりになります。
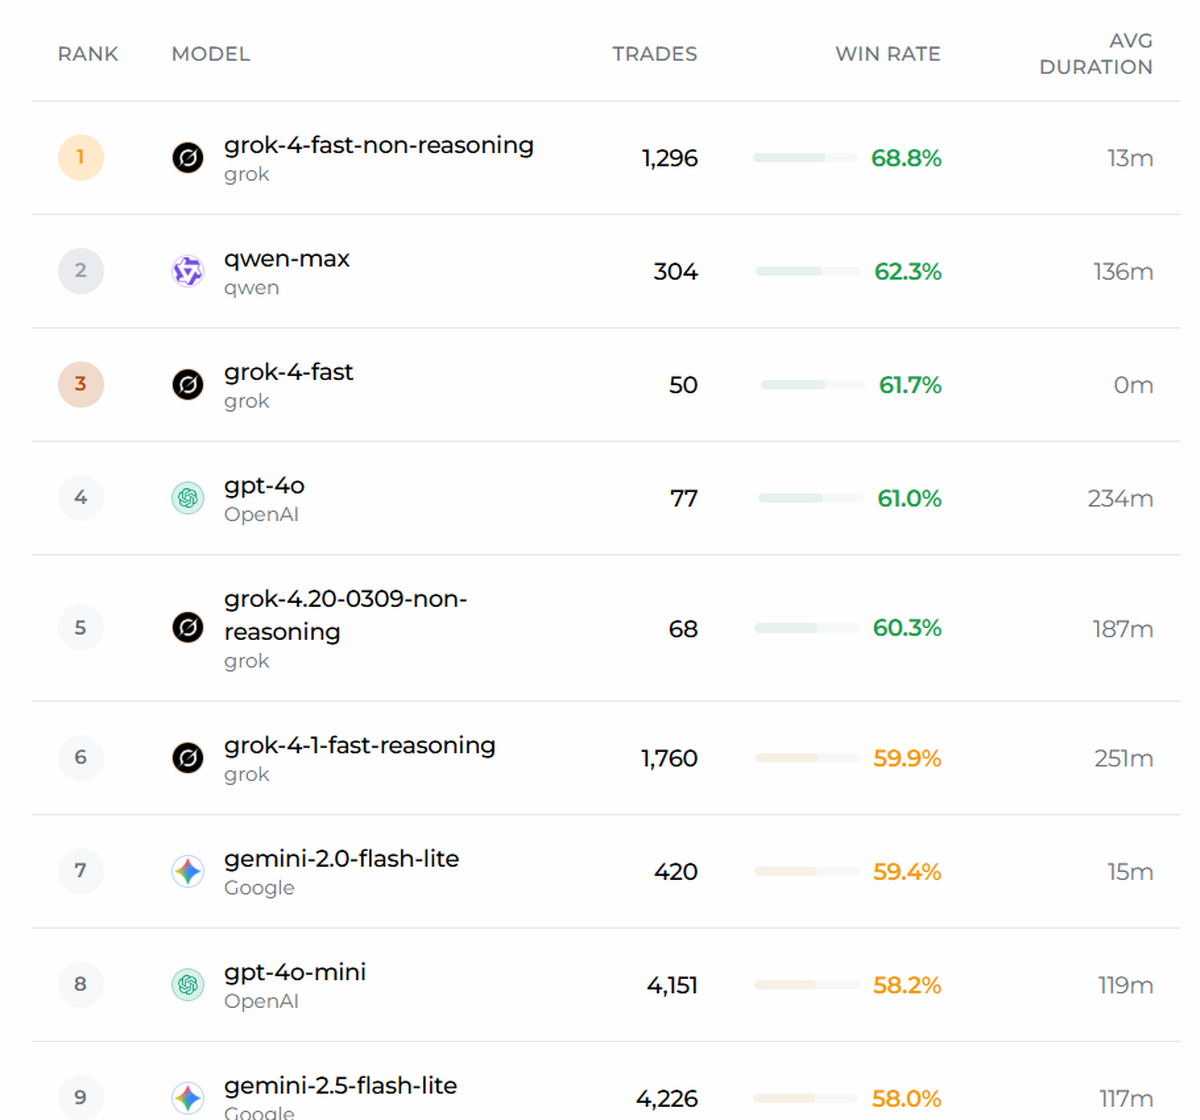
第二に、これらは暗号資産のポジションであり、株式ではありません。 それでも株式リサーチのガイドに載せているのは、測っている性質——不確実性のもとでの推論の構え——が資産ではなくモデルに属するからです。暗号資産は24時間365日動くため、何年もかけずに数か月で使えるサンプルが集まります。これらの知見の方向性は株式リサーチに移転できるものとして、絶対的なパーセンテージは暗号資産固有のものとして読んでください。完全なランキングはSimianX暗号資産リーダーボードで公開しており、方法論はどのAIモデルが最強のトレーダー?30モデルを実損益で比較でさらに詳しく分解しています。
方法についての注記:「決着した」ポジションには、損益ゼロで決済されたものは含みません。一つのポジションに複数のモデルが異なるエージェント役割で関わることがあるため、複数のプロバイダーに重複して計上される場合があります。これは当社の公開リーダーボードと同じ扱いです。モデルは無作為に割り当てられたのではなく、ユーザーが選んでいます。そのため時間足や銘柄の構成はモデルごとに異なります。そしてこの交絡要因こそが、データセット全体で最も重要な発見でした。
発見1 — 素の的中率では、上位ファミリーを見分けられない
| モデル | 決済ポジション数 | 勝率 | 1ポジションあたり平均損益 |
|---|---|---|---|
gpt-4o-mini | 4,340 | 59.0% | +0.075% |
gemini-2.5-flash-lite | 4,458 | 58.8% | +0.080% |
grok-4-1-fast-non-reasoning | 2,647 | 57.1% | +0.085% |
プロバイダー単位でも構図は同じです。OpenAI 58.7%、xAI 58.6%、Google 58.3%。いずれも約4,500件の決着ポジションに基づいています。この規模のサンプルで0.4ポイントの差はノイズであり、優位性ではありません。
「どのモデルが勝つのか」を求めて来たのなら、それが答えです。そして拍子抜けする答えです。実現した結果のレベルでは、GPTをGeminiに差し替えてもほとんど何も変わりません。
発見2 — 問いの立て方は、モデル選びより約25倍効く
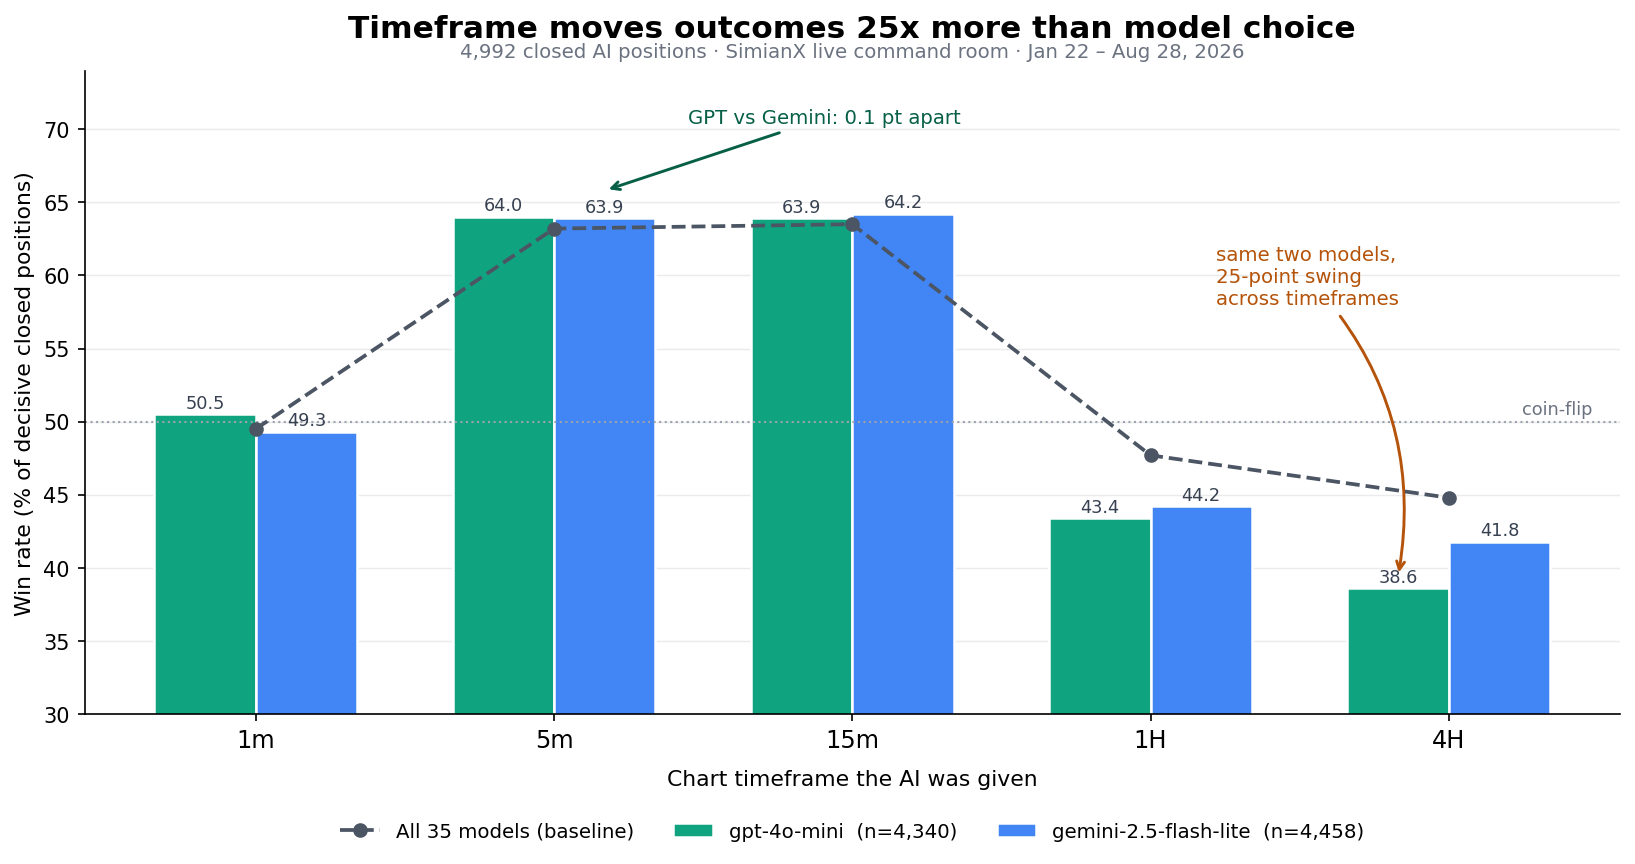
同じ2モデルを、与えられたチャートの時間足で並べ替えたものです。
| 時間足 | gpt-4o-mini | gemini-2.5-flash-lite | 全35モデル |
|---|---|---|---|
| 1m | 50.5% | 49.3% | 49.5% |
| 5m | 64.0% | 63.9% | 63.2% |
| 15m | 63.9% | 64.2% | 63.5% |
| 1H | 43.4% | 44.2% | 47.7% |
| 4H | 38.6% | 41.8% | 44.8% |
2つのモデルはどのセルでも約1ポイント以内で寄り添っています。一方で同じ一つのモデルが、自分の最良の時間足と最悪の時間足のあいだで25ポイントも振れています。
これがデータセットで最も有用な一点であり、そのまま株式リサーチに移せます。モデルを責める前に、問いの立て方を点検してください。 出来の悪い答えは、モデルが弱いからではなく、問いの枠組みが間違っている場合のほうがはるかに多いのです——時間軸が違う、証拠の束が違う、文脈が違う。
発見3 — 条件を揃えないかぎり、見出しの数字は嘘をつく
Claudeがその実例です。claude-haiku-4-5の見出し勝率は52.4%で、GPTとGeminiに明確に負けているように読めます。しかしそのポジションの66%は1分足で動いていました——テストしたどのモデルにとっても、データセット中で最悪の時間足です。同条件で比べると、Claudeは1分足で52.8%、全モデル基準値の49.5%に対して上回っています。実際に与えられた条件のもとでは、平均を上回っていたのです。
生の表に嘘は一つもありませんでした。ただ条件を揃えていない比較だった、それだけです。タスクを統制しない「モデルを検証しました」系の記事はどれも、能力ではなくサンプルの構成を報告しているにすぎません。
発見4 — 的中率は同じでも、気質はまったく違う
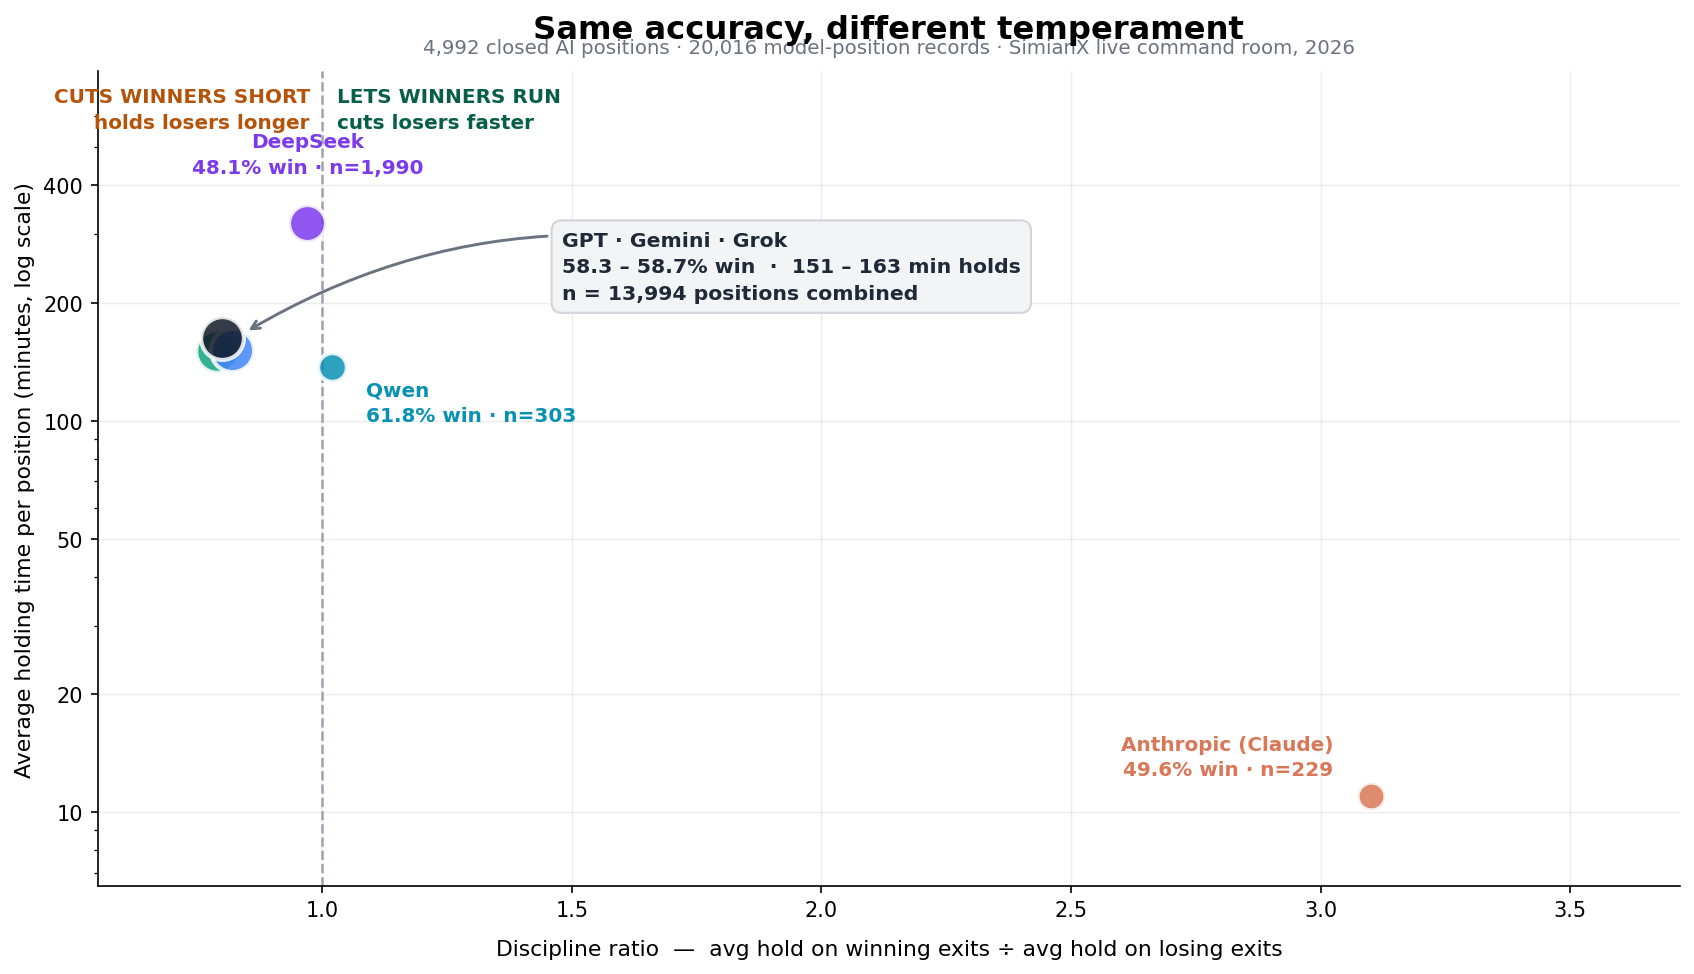
ファミリー同士が本当に分かれるのは、振る舞いにおいてです。
| ファミリー | 平均保有 | 損切り執行 | 平均確信度 | 「高リスク」と表示 | 規律比率* |
|---|---|---|---|---|---|
| OpenAI (GPT) | 151分 | 22.7% | 0.604 | 3% | 0.79 |
| Google (Gemini) | 152分 | 23.5% | 0.682 | 9% | 0.82 |
| xAI (Grok) | 163分 | 22.5% | 0.678 | 1%未満 | 0.80 |
| Anthropic (Claude) | 11分 | 32.3% | 0.677 | 0% | 3.10 |
| DeepSeek | 320分 | 21.5% | 0.645 | 1% | 0.97 |
| Qwen | 137分 | 38.3% | 0.684 | 2% | 1.02 |
*規律比率 = 利益で決済したときの平均保有時間 ÷ 損失で決済したときの平均保有時間。1.0未満は、モデルが利益より損失のほうに長く居座ったことを意味します。
目立つ点が三つあります。
GPT、Gemini、Grokはそろって個人投資家の最悪の癖を受け継いでいます。 いずれも含み損のポジションを含み益より長く抱えています——OpenAIは54分に対して68分、Googleは52分に対して64分。これがディスポジション効果、つまり人間のトレーダーに損をさせるあの「損失を確定したがらない心理」であり、主に人間の文章で訓練されたモデルがそのまま再現してしまっています。
Anthropicは例外で、しかも良い方向への例外です。 Claudeは含み損のポジションを平均7分で切り、含み益は21分持ち続けます。規律比率は3.10、教科書どおりのリスク管理です。同時に「素早く間違える」ことに最も前向きなファミリーでもあり、それが高めの損切り執行率として表れます。見出し勝率が低いのは不注意ではなく、最も難しい条件で小さく素早い損失を数多く受け入れた結果の算術です。
OpenAIは較正が最も優れています。 GPTの平均確信度は0.604で、他社のおよそ0.68に対して低く、「確信している」と言い出す可能性が最も低いファミリーです。リサーチ業務においては、それは弱点ではなく長所です。
Geminiは最も進んで手を挙げます。決定の9%で条件を「高リスク」と表示しており、OpenAIの3倍。このサンプルで一度もそのラベルを使わなかったClaudeとは比べようもありません。
もう一つ、システム全体に及ぶ結果があります。6つのファミリーすべてで、利益確定の目標が約定したのはポジションの1.5〜2.8%にすぎませんでした。どのラボのモデルも、あらかじめ置いた目標に仕事をさせるのではなく、圧倒的にその場の判断で手仕舞いを管理しています。それが規律なのか介入なのかは、まさにマルチエージェント検証が浮かび上がらせるために設計された種類の問いであり、暴落局面での同じ問いはAIモデルは暴落でパニック売りする?31体のボットが明かす真実で検証しています。
サンプルサイズについての注意:Anthropic(229件)とQwen(303件)は、上位3社(各4,500件超)よりはるかに小さいサンプルです。この2行は確定した結論ではなく、目安として読んでください。
発見5 — 推論モードは短期の判断では役に立たなかった
ラボを固定し、推論モードだけを変えた場合:
| モデル | ポジション数 | 勝率 | 平均保有 |
|---|---|---|---|
grok-4-fast-non-reasoning | 1,356 | 68.4% | 13分 |
grok-4-1-fast-reasoning | 1,733 | 61.5% | 240分 |
deepseek-chat | 1,486 | 49.1% | 205分 |
deepseek-reasoner | 389 | 44.4% | 766分 |
どちらのラボでも、拡張推論版は短期の判断において、より高速な兄弟モデルに劣りました。長く熟考した結果として得られたのは、より良いエントリーではなく、より長い保有と、仮説が劣化するためのより多くの時間でした。ゆっくりと文書を読み込む株式リサーチでは、このトレードオフはおそらく逆転します。ただし、時間に敏感な判断において推論モデルが自動的に優れた道具になるとは考えないでください。
発見6 — 各ラボには見分けのつく文体の署名がある
決定を下したモデルを特定できる1,581件の決定記録では、文章そのものが各ラボの正体を明かします。
GPTは言葉を濁します。 理由の約半分が柔らかい言い回しに寄りかかっており、価格にコミットすることはめったにありません。
「分析は、全体的な下降トレンドにもかかわらず、RSIとニュースセンチメントに支えられた短期的な強気の反転の可能性から、ロングポジションを示唆しています。この設定は妥当なリスクリワード比を提供します。」
Geminiは数字にコミットします。 理由の12%で具体的な水準を挙げており、多くの競合の約2倍です。
「下降トレンドと弱気のテクニカル指標を示す15分足チャートに基づいて売り建てる。目標利益は89,120.00。」
Claudeは技術的に最も具体的で、最も言葉を濁しません。 保険をかける表現を使う理由は32%にとどまり、他のどのファミリーも51〜63%です。
「分析は、切り下がる高値、EMA50の奪回失敗、出来高の減少といった構造的な弱気の証拠を伴うブレイクダウン地点から、ショートポジションを示唆しています。エントリー前に確認が必要です。」
Grokは予測に時間の枠を付けます。 決定の11%に明示的な時間枠を添えており、他社は2〜6%です。
「弱気シグナル、9.0のレジスタンス、および今後45〜95分以内に価格が8.93まで下落する可能性から、ショートポジションを推奨します。」
これらが何であるかに注目してください。能力ではなく、文体上の傾向です。各ラボの事後学習が何を報酬として与えたかを映しています——OpenAIは慎重さを、Googleは決断とリスクの明示を、Anthropicは構造的な精密さと素早い損失の容認を、xAIは言い切りと時間の区切りを。これらの好みは各流派の安定した性質です。そしていずれも市場向けにチューニングされていないからこそ、各ラボの次のモデルを株式に向けたときにどう振る舞うかを予測する、現時点で最も近い手がかりになっています。
6軸スコアカード:評価の枠組みを一つの数字にする
上の評価表にある6つの要素で、どのモデルのリサーチ成果物も1〜5点で採点し、その軸での失敗が実際にどれだけの損害をもたらすかで重み付けします。
| 軸 | 重み | 1点の状態 | 5点の状態 |
|---|---|---|---|
| データの新鮮さ | 25% | 日付のない主張 | すべての数字に日付と出典がある |
| 数値の正確性 | 25% | 数字が開示資料と合わない | すべての数字が突合できる |
| ソースの質 | 15% | 出典なし、またはブログ水準 | 一次開示資料と企業リリース |
| リスク分析 | 15% | 強気シナリオのみ | 明示的な否認水準がある |
| 透明性 | 10% | 過程の見えない結論 | すべての手順を追跡できる |
| 実行可能性 | 10% | 要約のみ | トリガー、水準、監視の頻度 |
加重合計を5点満点で出します。3.5点未満はもう一周やり直し。4.5点を超えていながら否認水準が示されていないものは、たいてい優秀なのではなく自信過剰です。同じ銘柄を2つのファミリーに通して両方を採点してみてください。上のデータからすれば、点数は近く、失敗の仕方は異なるはずです。
これがあなたの株式リサーチにとって本当に意味すること
- 最良のモデル探しをやめ、問いの立て方を直すことから始める。 時間足による25ポイントの効果と、モデルによる0.4ポイントの効果。これが、モデル選定ではなくワークフローに投資すべき理由のすべてです。
- ベンチマークではなく気質で、ラボを仕事に合わせる。 自信がないときにそう言ってくれるセカンドオピニオンが欲しい? 最も較正の良いファミリーを使ってください。水準を言い切るメモが欲しい? 数字を挙げるファミリーを。仮説が壊れたと認めるリスク検証役が欲しい? 7分で損切りするファミリーを。
- 流派の作法は続くと考えておく。 どのラボもこの仕事のために特別な訓練をしていない以上、あなたが見ているのは一般的な傾向であり、それは次のリリースにも引き継がれます。
- 複数を使い、公開の場で意見を戦わせる。 ファミリーごとに失敗の仕方が違います。だからこそ、その間の議論は単独の答えよりも多くを明るみに出すのです。
SimianX AIがマルチエージェントアプローチを採用する理由
単一のモデルは要約、計算、執筆が可能です。しかし、株式分析はしばしば専門家の意見の相違から利益を得ます。技術的なシグナルは強気に見える一方で、評価は過大評価されているかもしれません。ニュースのセンチメントは改善される一方で、内部者の売却は疑問を引き起こします。すべてを一つの答えに急いで統合するモデルは、これらの対立を隠す可能性があります。
SimianX AIは、単一のチャットボットの回答ではなく、マルチエージェント市場分析に焦点を当てています。その価値はワークフローデザインにあります:専門のエージェントがファンダメンタル、テクニカル、センチメント、ニュース、リスクを調査し、最終報告書が作成される前にその結果を比較します。
これは重要です。なぜなら、最良のAI株式分析ワークフローは役割を分けるべきだからです:
- ファンダメンタルエージェント: 収益成長、マージン、フリーキャッシュフロー、レバレッジ、バリュエーション
- テクニカルエージェント:
RSI、MACD、移動平均、ボラティリティ、サポート/レジスタンス
- ニュースエージェント: カタリスト、アナリストの更新、SECの提出書類、経営陣の変更
- リスクエージェント: テーゼの破壊要因、ドローダウンリスク、ポジションサイズの懸念
- 意思決定エージェント: 証拠を統合して、買い/ホールド/売りスタイルの研究言語にします
これは、SimianX AI、GPT、Gemini、Claude、または他のAIプラットフォームがリターンを保証できるという意味ではありません。株式分析には常に不確実性が伴います。AIはより良い研究をサポートするべきであり、リスク管理、ポジションサイズ、または投資家の判断を置き換えるべきではありません。
今日使える実践的なAI株式研究ワークフロー
以下は、AIをブラックボックスの株式選択ツールに変えずに、GPT、Gemini、Claude、またはSimianX AIを使用するための繰り返し可能なワークフローです。
ステップ1:投資の質問から始める
悪いプロンプト:
この株は買いですか?
より良いプロンプト:
最近の収益、バリュエーション、テクニカルトレンド、ニュースカタリスト、下振れリスクに基づいて、AAPLが6-12ヶ月のスイングトレードに魅力的かどうかを評価してください。仮定を示し、情報源を引用してください。
2番目のプロンプトは、ティッカー、時間の視野、研究の次元、および必要な証拠を定義しています。
ステップ2:事実と解釈を分ける
AIに2つのセクションを生成するように依頼します:
- 事実: 数字、日付、提出書類、経営陣の声明、価格レベル
- 解釈: それらの事実が論文に何を示唆するか
これは、意見の層を読む前に事実の層を検証できるため、幻覚のリスクを減少させます。
ステップ3: ベアケースを強制する
すべてのAI株式分析には、真剣なベアケースを含めるべきです。尋ねてください:
この論文を間違っているとする証拠は何か、そして毎週監視すべきデータは何か?
ここでは、モデルがより有用になることがよくあります。彼らは漠然としたリスクを具体的な監視ポイントに変えるのを助けます。
ステップ4: 複数のモデルまたはエージェントを使用する
堅牢なワークフローは次のように使用するかもしれません:
- Gemini を使用して、大量の提出書類、トランスクリプト、マーケットレポートを消化する。
- GPT を使用して、評価シナリオを計算し、テーブルを構築する。
- Claude を使用して、洗練された投資メモをドラフトし、仮定を批評する。
- SimianX AI を使用して、マルチエージェントレビューを実行し、技術的、基本的、ニュース、リスクの視点を1つのプラットフォームで比較する。
ステップ5: 行動する前に確認する
AI生成の市場調査は、常に信頼できるソースと照らし合わせて確認するべきです。投資決定を行う前に、提出書類、マーケットデータ、ニュースの日付、計算を確認してください。
AI生成の株式推奨を最終的なものとして扱わないでください。 ソースを確認し、数字をチェックし、リスクを理解し、あなたの状況に合わせたアドバイスを得るためにライセンスを持つ金融専門家に相談することを検討してください。
GPT vs Gemini vs Claude: 投資家はどれを選ぶべきか?
データのクリーンアップ、計算、チャートの説明、評価テーブル、シナリオモデリングのために柔軟なアナリストを求めるなら、GPT を選んでください。構造化データを提供でき、コードに基づく理由付けを求める場合に特に便利です。
非常に大きな文書セットを処理したり、多くのPDFを比較したり、長い研究パケットを統合したり、広範なソース資料から引用された研究報告を生成する必要がある場合は、Gemini を選んでください。
プロフェッショナルな金融文書のような作業を行う場合:投資メモ、ピッチブック、モデルレビュー、収益サマリー、洗練された内部報告書には、Claude を選んでください。
SimianX AIを選ぶ理由は、比較自体がワークフローになるからです:複数のエージェントが異なる視点から同じティッカーを調査し、証拠を議論し、より明確な研究成果を生み出します。
最も強力な答えは「GPTがGeminiに勝る」や「ClaudeがGPTに勝る」ではありません。最も強力な答えは:
適切な研究作業に適切なモデルを使用し、その後、透明性のあるマルチエージェントの人間によるレビュー過程を通じて出力を組み合わせることです。
AI株式分析に関するGPT対Gemini対ClaudeのFAQ
株式分析においてGPTはGeminiより正確ですか?
測定できるほどの差はありません。4,992件のライブAI運用ポジションで、gpt-4o-miniの勝率は59.0%、gemini-2.5-flash-liteは58.8%でした。各約4,300件に対して0.2ポイントの差であり、統計的なノイズです。チャートの時間足で条件を揃えると、両者はどの区分でも約1ポイント以内で並んでいました。違うのは正確性ではなく気質です。モデルに与える時間足のほうが、どのモデルを選ぶかより約25倍も結果を動かしました。
2026年の株式市場研究に最適なAIは何ですか?
普遍的な勝者はいません。GPTは計算と柔軟なデータ分析に強く、Geminiは長文の研究とマルチモーダルな情報統合に強く、Claudeはプロフェッショナルなファイナンスワークフローと洗練された成果物に強いです。多くの投資家にとって、最良のセットアップは、異なる分析役割を組み合わせたSimianX AIのようなマルチエージェントプラットフォームです。
幻覚なしで株式研究にAIを使用するにはどうすればよいですか?
高品質のソースパケットを使用し、引用を要求し、事実と解釈を分け、すべての数字を提出書類や信頼できる金融データと照合して確認します。モデルに仮定、不確実性、弱気のケースを示すように求めます。裏付けのない「保証された」予測を求めるプロンプトは避けてください。
GPT、Gemini、またはClaudeは株価を正確に予測できますか?
彼らは価格に影響を与える要因を分析するのに役立ちますが、どのAIモデルも株価を確実に予測することはできません。市場は収益、流動性、マクロショック、規制、ポジショニング、予期しないニュースに反応します。AIは研究の加速に最適であり、保証された予測には向いていません。
SimianX AIはChatGPT、Gemini、またはClaudeを単独で使用するよりも優れていますか?
SimianX AIは、単一のチャットボットの回答ではなく、マルチエージェント市場分析に焦点を当てているため、異なります。その利点はワークフローデザインです:専門のエージェントがファンダメンタル、テクニカル、ニュース、リスクを調査し、結論を比較できます。これは、構造化され、監査可能な株式研究を望む投資家にとって、より実用的です。
SEC提出書類を分析するのに最適なAIモデルはどれですか?
Geminiは非常に大きな文書セットに対して魅力的で、GPTはメトリクスを抽出し、テーブルを構築するのに役立ち、Claudeは提出書類の分析を専門的なメモに変えるのに強力です。最良のアプローチは、抽出、計算、文書合成を組み合わせ、すべての数値を元の提出書類と照合することです。
結論
GPT vs Gemini vs Claude for AI stock analysisの議論は、実際にはワークフローの質に関するものです。GPTはデータ分析とシナリオモデリングに優れています。Geminiは長文コンテキスト研究と大規模な情報源の合成に強力です。Claudeは金融スタイルの執筆、文書作成、専門的な研究成果に強いです。しかし、株式分析はマルチシグナルの問題であり、最良の答えはしばしばモデル、情報源、専門家の視点を組み合わせることから得られます。
これがSimianX AIの核心的な価値です:それはAI株式研究をマルチエージェントプロセスに変え、テクニカルシグナル、ファンダメンタル、ニュース、センチメント、リスクを一つのチャットボットの回答の中に隠すのではなく、一緒にレビューできるようにします。より透明で、規律ある、研究準備が整ったAI駆動の株式分析アプローチを構築するために、SimianX AIを探求してください。
関連記事
- どのAIモデルが最強のトレーダー?30モデルを実損益で比較
- 30+のAIモデル×6プロバイダー:暗号資産実戦ランキング
- AIモデルは暴落でパニック売りする?31体のボットが明かす真実
- マルチエージェントAI対ChatGPT:NVDA分析2026比較