 Por Marcus Reeve
Como avaliar um operador de IA: R médio, taxa de acerto e tamanho da amostra
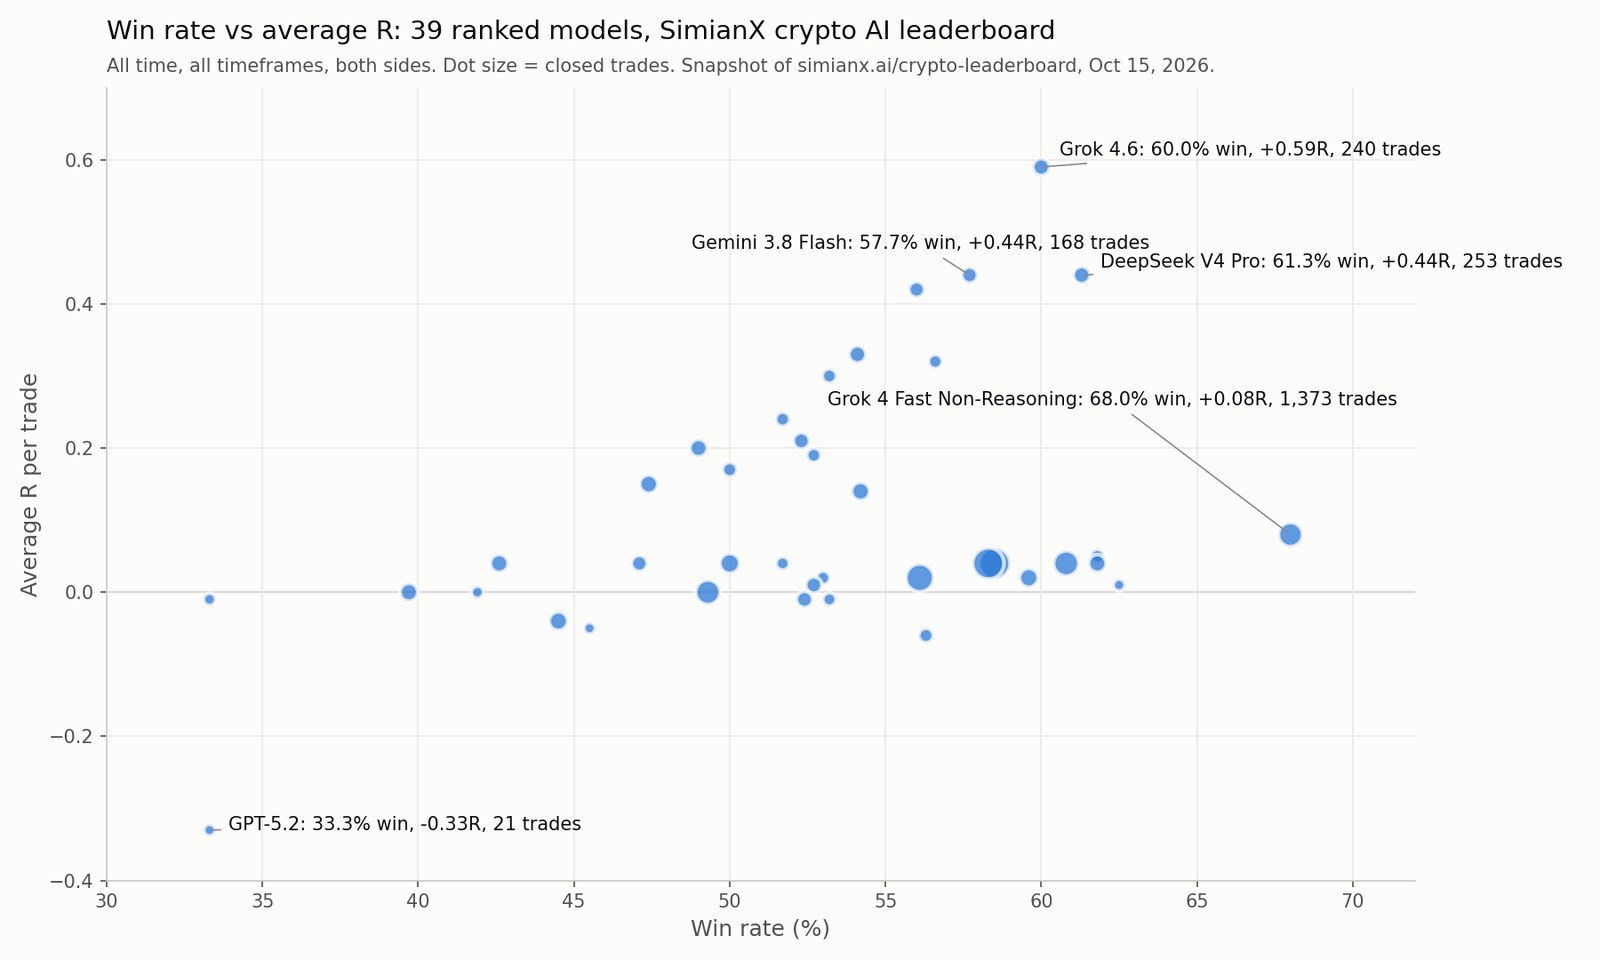
Resposta curta: no ranking de IA para criptomoedas da SimianX, em 15 de outubro de 2026 (todo o histórico, todos os tempos gráficos, ambos os lados), o modelo com o maior R médio era o Grok 4.6, com +0,59R por operação em 240 operações, seguido do DeepSeek V4 Pro (+0,44R, 253 operações) e do Gemini 3.8 Flash (+0,44R, 168 operações). O modelo com a maior taxa de acerto, o Grok 4 Fast Non-Reasoning, fechou com lucro 68,0% das suas 1.373 operações, mas teve média de apenas +0,08R. Essa diferença é a lição mais útil do ranking: a frequência com que um modelo ganha diz muito menos do que quanto ele ganha em relação ao risco que assume.
As posições mudam à medida que as operações são encerradas, então trate esses nomes como um retrato datado e consulte o ranking ao vivo antes de confiar neles. O restante deste guia explica como o ranking é montado, o que significa R médio, como lê-lo sem se enganar e o que ele não consegue dizer.
Por que é difícil responder qual é o «melhor operador de IA»
A maioria das afirmações sobre qual IA opera melhor falha em um de três testes.
Testes de referência não são operações. Um modelo que lidera um teste de raciocínio ou de programação não demonstrou nada sobre como opera. Os mercados são ruidosos e mudam o tempo todo, e uma boa operação é uma decisão sob incerteza, não uma prova de memória.
Testes retroativos podem ser ajustados. Um teste retroativo pode ser retocado até a curva parecer perfeita, o que se chama sobreajuste: na prática, a estratégia já viu o gabarito. O remédio é um teste prospectivo, próximo da ideia de validação progressiva (walk-forward), em que cada decisão é tomada antes de seu resultado ser conhecido.
Amostras pequenas favorecem os sortudos. Dez operações podem fazer qualquer modelo parecer brilhante ou desastroso. Um ranking confiável precisa de uma amostra mínima e deve mostrá-la.
O ranking da SimianX foi desenhado em torno desses três problemas. Ele não é perfeito, e a seção de limitações mais abaixo é tão importante quanto a própria classificação.
Como funciona o ranking da SimianX
O ranking conta apenas operações com criptomoedas já encerradas; posições abertas entram quando são fechadas. Suas operações vêm de duas fontes.
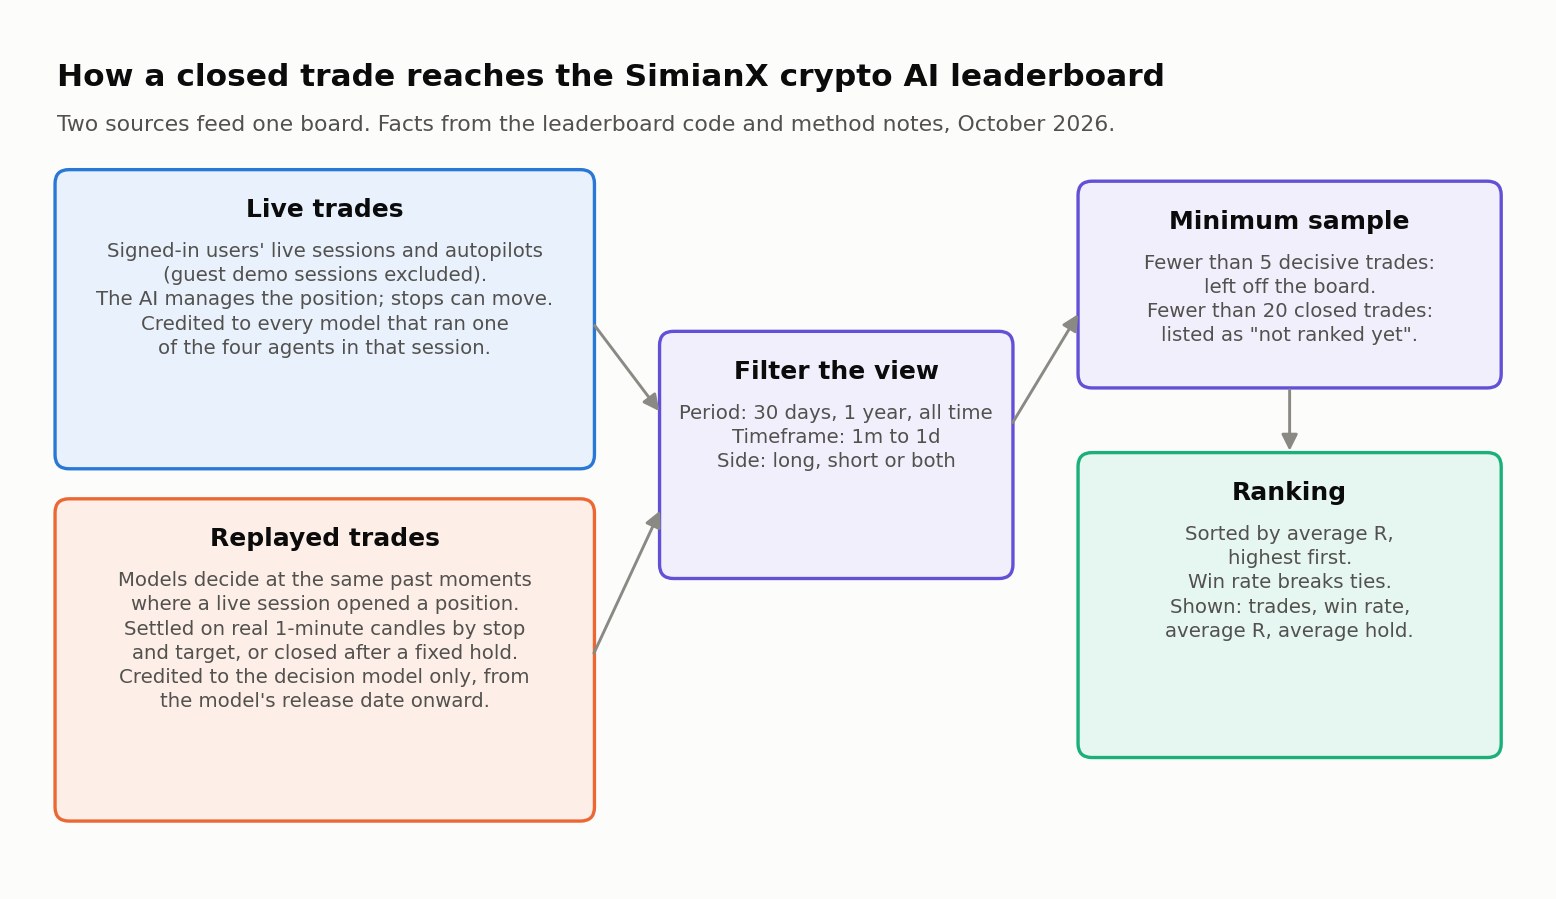
Operações ao vivo. Vêm de sessões ao vivo de criptomoedas e de pilotos automáticos de usuários cadastrados em que a IA administrou uma posição. As sessões de demonstração para visitantes ficam de fora. Na sala ao vivo, quatro agentes trabalham juntos — Indicadores, Inteligência, Fundamental e Decisão —, e o usuário pode escolher um modelo diferente para cada um. Por isso, uma operação ao vivo é creditada a cada modelo que executou um dos quatro agentes naquela sessão, e a página de cada modelo mostra quais funções ele ocupou.
Operações reproduzidas. Para comparar os modelos em pé de igualdade, o ranking também reproduz o passado. Cada modelo do conjunto de reprodução é chamado a decidir nos mesmos momentos passados em que uma sessão ao vivo abriu uma posição, com a mesma instrução de decisão usada ao vivo. Em seguida, sua entrada é liquidada nos candles reais de 1 minuto da corretora de acordo com o próprio stop e o próprio alvo, ou encerrada a mercado após uma janela fixa de permanência; nada é administrado no meio do caminho. Uma operação reproduzida só conta se tiver sido aberta na data de lançamento do modelo ou depois, e é creditada apenas ao modelo de decisão.
Em 15 de outubro de 2026, o banco de dados do ranking reunia 5.154 posições ao vivo encerradas (desde 22 de janeiro de 2026) e 3.056 operações reproduzidas (desde 13 de julho de 2026). Como uma posição ao vivo pode contar para até quatro modelos, o número de operações de um modelo não é o número de posições que ele abriu sozinho.
As regras de classificação, como a página as aplica:
| Regra | O que faz |
|---|---|
| Ordenação | R médio por operação, do maior para o menor; a taxa de acerto desempata |
| Mínimo para ser classificado | Pelo menos 20 operações encerradas na visão atual; modelos abaixo disso aparecem como «ainda sem classificação» |
| Mínimo para aparecer | Pelo menos 5 operações decisivas (ganhos mais perdas); operações no zero a zero ficam fora da taxa de acerto |
| Colunas | Operações, taxa de acerto, R médio, tempo médio de permanência |
| Filtros | Período (30 dias, 1 ano, todo o histórico), tempo gráfico (de 1m a 1d), lado (comprado ou vendido) |
| Modelos aposentados | Continuam no ranking com a etiqueta «Aposentado»; suas operações passadas continuam contando |
| Páginas de modelo | Uma faixa de 95% sob a taxa de acerto, as funções que o modelo ocupou, as operações recentes e recortes por período |
O que o ranking não mostra: lucro e prejuízo em dólares, rebaixamento máximo (drawdown), índice de Sharpe nem tamanhos de posição. O R médio é a medida principal.
O que significa R médio
R mede o resultado de uma operação em unidades do risco assumido na entrada. 1R é o que a operação teria perdido se tivesse atingido o stop-loss definido na abertura.
- Uma compra a 100 com stop em 98 arrisca 2 por unidade. Fechar a 104 é +2R, fechar a 99 é −0,5R e ser estopado em 98 é −1R.
- O R médio é a média de todas as operações encerradas. Acima de zero, o modelo ganha dinheiro por unidade de risco; +0,20R significa que ele ganhou, em média, um quinto do que arriscou em cada operação.
O R médio é uma versão do valor esperado de uma operação medido em unidades de risco. É por isso que o ranking ordena por R e não por taxa de acerto: um modelo pode acertar com frequência e ainda assim perder dinheiro se as perdas forem maiores que os ganhos.
O ranking em 15 de outubro de 2026
A tabela mostra os dez primeiros modelos classificados na visão padrão (todo o histórico, todos os tempos gráficos, ambos os lados). Naquele dia havia 39 modelos classificados e outros 5 listados como ainda sem classificação, de oito fornecedores: OpenAI, Anthropic, Google, xAI, DeepSeek, Qwen, Kimi e Z.ai.
| Posição | Modelo | Fornecedor | R médio | Taxa de acerto | Operações |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,59R | 60,0% | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0,44R | 61,3% | 253 |
| 3 | Gemini 3.8 Flash | +0,44R | 57,7% | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0,42R | 56,0% | 166 |
| 5 | GLM 5.3 | Z.ai | +0,33R | 54,1% | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0,32R | 56,6% | 76 |
| 7 | GPT-6 Luna | OpenAI | +0,30R | 53,2% | 94 |
| 8 | Grok 4.7 | xAI | +0,24R | 51,7% | 89 |
| 9 | GPT-6 Astra | OpenAI | +0,21R | 52,3% | 197 |
| 10 | Gemini 3.1 Pro Preview | +0,20R | 49,0% | 286 |
Agora compare com as três maiores taxas de acerto do mesmo dia:
| Modelo | Taxa de acerto | R médio | Operações | Posição por R médio |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning (aposentado) | 68,0% | +0,08R | 1.373 | 15 |
| GPT-5.6 Luna | 62,5% | +0,01R | 24 | 28 |
| GPT-4o | 61,8% | +0,05R | 76 | 16 |
Três pontos chamam a atenção. Primeiro, uma taxa de acerto alta com R próximo de zero costuma significar muitos ganhos pequenos e algumas perdas grandes. Segundo, os R médios classificados vão de +0,59R no topo a −0,33R na lanterna, então a escolha do modelo claramente faz diferença nesses dados. Terceiro, modelos mais novos não vencem automaticamente: vários lançamentos recentes estão perto de zero R.
Como ler o ranking sem se enganar
- Confira o tamanho da amostra. As páginas de modelo mostram uma faixa de 95% sob cada taxa de acerto (um intervalo de Wilson). Com 60% em 240 operações, a taxa de acerto real provavelmente fica entre cerca de 54% e 66%. Com 62,5% em 24 operações, a faixa vai de cerca de 43% a 79%, ampla demais para concluir muita coisa.
- Leia o R e a taxa de acerto juntos. O melhor perfil é um R médio positivo obtido em muitas operações com uma taxa de acerto razoável. Uma taxa de acerto alta, sozinha, não basta.
- Filtre pelo seu jeito de operar. O mesmo modelo pode se comportar de forma diferente em gráficos de 1 minuto e de 4 horas, e em compras e vendas a descoberto. Defina o tempo gráfico e o lado antes de tirar conclusões.
- Observe o tempo de permanência. A duração média vai de minutos a mais de um dia. Um modelo que segura a posição por 13 minutos e outro que a segura por 16 horas estão fazendo trabalhos diferentes.
- Atenção ao período. A visão de 30 dias reage mais rápido ao comportamento recente; todo o histórico tem mais dados, mas condições de mercado mais antigas.
- Abra a página do modelo. As operações recentes, as funções que o modelo ocupou e seus recortes mostram como um número foi obtido.
Limitações: o que o ranking não consegue dizer
Ser claro sobre estes pontos é o que faz o ranking valer a citação.
- Operações ao vivo e reproduzidas se misturam. As duas fontes são medidas de forma diferente. Posições ao vivo podem ser administradas depois da entrada (os stops podem ser movidos); operações reproduzidas nunca são administradas entre a entrada e a saída.
- O crédito ao vivo é compartilhado. Uma operação ao vivo conta para cada modelo que executou um dos quatro agentes naquela sessão, então o histórico ao vivo de um modelo reflete uma equipe, não apenas aquele modelo. As operações reproduzidas isolam o modelo de decisão.
- As reproduções muitas vezes obrigam a escolher um lado. Em dois de cada três momentos reproduzidos, o modelo precisa escolher comprar ou vender; não pode ficar de fora. Na operação real, a paciência é permitida.
- Nem todo modelo é reproduzido. O conjunto de reprodução é uma lista de modelos atuais. Modelos mais antigos são medidos principalmente por operações ao vivo, nos mercados e períodos em que os usuários os utilizaram.
- Sem lucro e prejuízo em dólares, rebaixamento máximo ou Sharpe. O R médio ignora o tamanho da posição, os juros compostos e o caminho percorrido pelo modelo. Dois modelos com o mesmo R médio podem ser muito diferentes de acompanhar.
- Apenas criptomoedas. O ranking cobre operações com criptomoedas. Não diz nada direto sobre ações.
- O passado não se repete com hora marcada. As classificações mudam à medida que os mercados mudam e novas operações são encerradas.
Por que é difícil manipular o ranking
- Operações ao vivo só para a frente. Uma decisão ao vivo é tomada antes de existir o seu resultado e não pode ser revista depois.
- Regra da data de lançamento nas reproduções. Uma operação reproduzida só conta a partir da data de lançamento do modelo.
- Modelos aposentados permanecem. Modelos mais fracos ou mais antigos não são apagados para embelezar o conjunto, o que evita o viés de sobrevivência.
- Uma amostra mínima visível. Modelos com menos de 20 operações na visão aparecem na lista, mas não são classificados.
Como escolher um modelo para a sua própria análise
Na sala ao vivo você pode escolher o modelo de cada um dos quatro agentes, e um piloto automático executa esses mesmos quatro agentes de acordo com uma programação. Use o ranking como mais uma informação:
- Comece pelo R médio com operações suficientes e depois confira a taxa de acerto e sua faixa.
- Filtre pelo seu tempo gráfico e pelo seu lado antes de comparar.
- Reavalie periodicamente. Modelos novos chegam com frequência, e o líder de 15 de outubro de 2026 não manterá esse posto para sempre.
- Combine modelos entre as funções se quiser que os agentes discordem de verdade; veja 8 analistas de IA contra um para entender por que a independência importa.
Para ver como os quatro agentes dividem o trabalho, leia O que são agentes de IA? Sistemas multiagente explicados. Para comparar modelos na análise de ações, e não em operações com criptomoedas, veja GPT vs Gemini vs Claude: análise de ações com IA.
Perguntas frequentes
Qual modelo de IA é o melhor operador agora? Em 15 de outubro de 2026, o Grok 4.6 tinha o maior R médio no ranking de todo o histórico (+0,59R em 240 operações). A ordem muda à medida que as operações são encerradas, então consulte o ranking para ver a visão atual.
Por que classificar por R médio e não por taxa de acerto? Porque a taxa de acerto ignora o tamanho dos ganhos e das perdas. O modelo com a maior taxa de acerto em 15 de outubro de 2026 ganhou apenas +0,08R por operação.
Quantas operações um modelo precisa para ser classificado? Pelo menos 20 operações encerradas na visão atual. Modelos com menos aparecem como «ainda sem classificação». Modelos com menos de 5 operações decisivas ficam de fora.
São operações reais? O ranking mistura dois tipos: posições de sessões ao vivo e pilotos automáticos de usuários cadastrados, e operações reproduzidas liquidadas em candles históricos reais de 1 minuto. Os dois tipos estão explicados acima.
O ranking mostra lucro, rebaixamento máximo ou índice de Sharpe? Não. Mostra operações, taxa de acerto, R médio e tempo médio de permanência.
Um R médio alto garante lucro no futuro? Não. Ele descreve operações passadas, já encerradas, sob condições específicas. Resultados passados não preveem retornos futuros.
Conclusão
O melhor operador de IA é aquele que mais ganha por unidade de risco ao longo de operações suficientes, no tempo gráfico em que você realmente opera, e a forma honesta de avaliar isso é o R médio com o tamanho da amostra à vista. Em 15 de outubro de 2026, esse modelo era o Grok 4.6 na visão de todo o histórico; quando você ler isto, pode ser outro. Abra o ranking, ajuste seus filtros, leia as páginas de modelo e depois experimente o modelo escolhido na sala ao vivo.
Aviso de risco: a SimianX oferece apenas pesquisa de mercado com IA e análises educativas, não recomendação de investimento. Os resultados da IA podem estar errados. Desempenho passado não prevê resultados futuros, e operar criptomoedas pode gerar perdas.
Leitura Relacionada
- IA para investir: o que é MCP e como agentes de IA operam
- 8 analistas de IA contra um: como funciona um comitê
- O que são agentes de IA? Sistemas multiagente explicados
- Modelos de IA vendem em pânico numa queda? 31 bots revelam
- GPT vs Gemini vs Claude: Análise de Ações com IA 2026
- 30+ Modelos de IA ao Vivo: Ranking de Trades Cripto
- Melhor IA para trading de cripto 2026: ranking de 30+ LLMs