 作者:Marcus Reeve
如何评判一个 AI 交易员:平均R、胜率与样本量
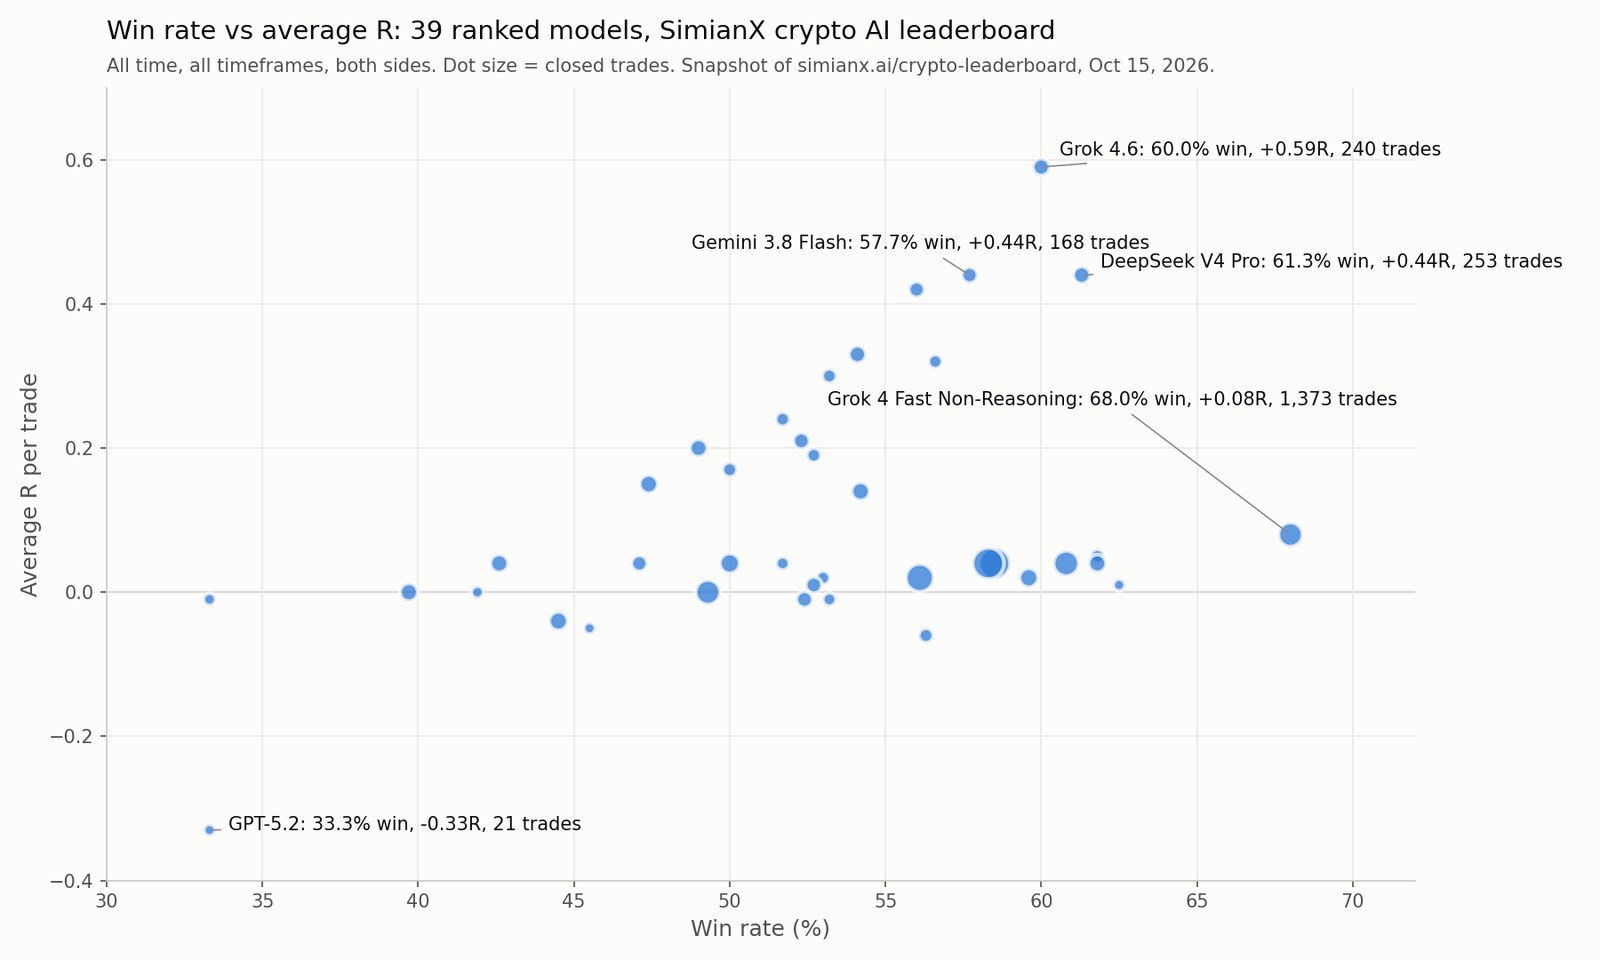
简短回答: 截至 2026 年 10 月 15 日,在 SimianX 加密货币 AI 排行榜(全部时间、全部周期、多空双向)上,平均R 最高的模型是 Grok 4.6,在 240 笔交易中每笔平均 +0.59R;紧随其后的是 DeepSeek V4 Pro(+0.44R,253 笔)和 Gemini 3.8 Flash(+0.44R,168 笔)。胜率最高的模型 Grok 4 Fast Non-Reasoning 在 1,373 笔交易中有 68.0% 以盈利平仓,但平均只有 +0.08R。这一落差正是排行榜上最有用的一课:一个模型赢得有多频繁,远不如它承担每一份风险能赚多少来得重要。
随着交易陆续平仓,排名会不断变化,因此请把这些名字视为带日期的快照,在依赖它们之前先去看看实时排行榜。本文接下来会解释排行榜是如何构建的、平均R 是什么意思、怎样读榜才不会自欺欺人,以及它无法告诉你什么。
为什么“最强 AI 交易员”很难回答
关于哪个 AI 最会交易的说法,大多数都过不了以下三道检验中的某一道。
基准测试不等于交易。 一个在推理或编程基准测试中名列前茅的模型,并没有证明它会交易。市场充满噪声且不断变化,一笔好的交易是在不确定性下做出的决策,而不是一场记忆力测验。
回测可以被调出来。 回测可以一直调整到曲线看起来完美无缺,这就是过度拟合:策略实际上已经偷看了答案。解决办法是做前瞻测试,思路接近滚动前推测试,即每一个决策都在结果揭晓之前做出。
小样本会美化运气好的人。 只要十笔交易,任何模型都可能看起来才华横溢或者一无是处。一个可信的排行榜需要设定最低样本量,并且把它展示出来。
SimianX 排行榜正是围绕这三个问题设计的。它并不完美,下文的局限性部分和排名本身同样重要。
SimianX 排行榜如何运作
排行榜只统计已平仓的加密货币交易;未平仓的持仓要等平仓后才会计入。它的交易来自两个来源。
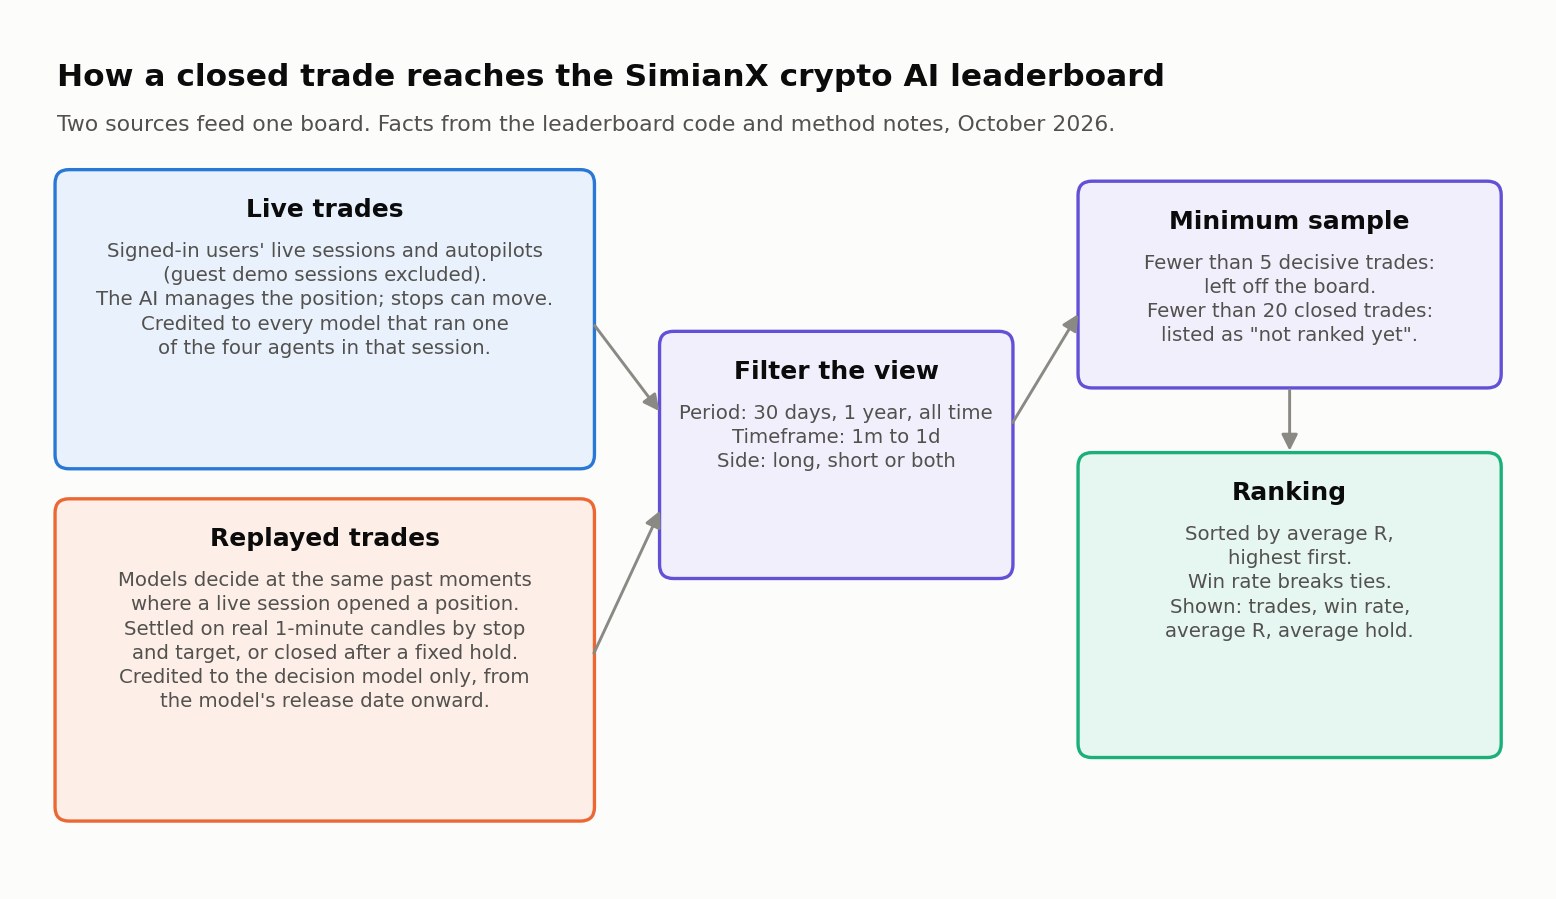
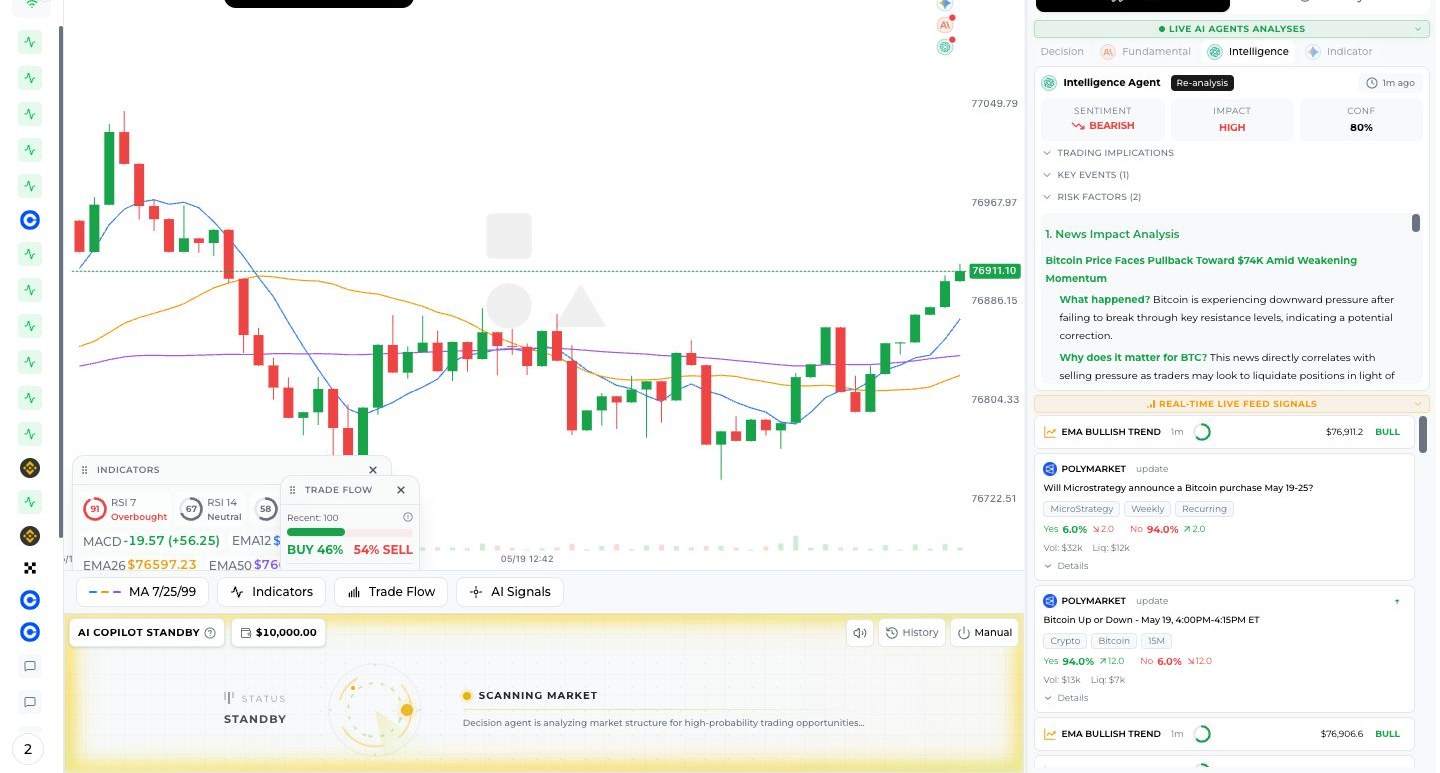
实盘交易。 这些交易来自已登录用户的加密货币实时分析会话和自动驾驶(autopilot),其中由 AI 管理持仓。访客演示会话不计入。在实时分析室里,四个智能体协同工作:指标、情报、基本面和决策,用户可以为每个智能体选择不同的模型。因此,一笔实盘交易会记入该会话中运行四个智能体之一的每一个模型名下,每个模型的页面也会显示它担任过哪些席位。
回放交易。 为了在同等条件下比较模型,排行榜还会回放历史。回放组中的每个模型都会在过去同样的时刻被要求做出决策,这些时刻就是某个实时会话当初开仓的时刻,所用的是实盘决策提示词。随后,它的入场会按交易所真实的 1 分钟 K 线,以它自己设定的止损和目标价来结算,或者在固定持有期结束后按市价平仓;中间不做任何管理。一笔回放交易只有在模型发布日当天或之后开仓才会计入,而且只记入决策模型名下。
截至 2026 年 10 月 15 日,排行榜背后的数据库中有 5,154 笔已平仓的实盘持仓(自 2026 年 1 月 22 日起)和 3,056 笔回放交易(自 2026 年 7 月 13 日起)。由于一笔实盘持仓最多可以计入四个模型,所以一个模型的交易笔数并不等于它独自开出的持仓数量。
页面所执行的排名规则如下:
| 规则 | 作用 |
|---|---|
| 排序方式 | 按每笔交易的平均R 从高到低排序;胜率相同时用来打破平局 |
| 进入排名的门槛 | 在当前视图中至少有 20 笔已平仓交易;低于此数的模型显示为“暂未排名” |
| 出现在榜上的门槛 | 至少 5 笔有胜负的交易(盈利加亏损);保本交易不计入胜率 |
| 列 | 交易笔数、胜率、平均R、平均持仓时间 |
| 筛选 | 时间段(30 天、1 年、全部时间)、周期(1 分钟到 1 天)、方向(做多或做空) |
| 已退役模型 | 保留在榜上并带有“已退役”标签;它们过去的交易仍然计入 |
| 模型页面 | 胜率下方的 95% 区间、该模型担任过的席位、近期交易以及按时间段的细分 |
排行榜不显示的内容:以美元计的盈亏、最大回撤、夏普比率或仓位大小。平均R 是核心指标。
平均R 是什么意思
R 以入场时承担的风险为单位来衡量一笔交易的结果。1R 就是这笔交易如果触及开仓时设定的止损会亏掉的金额。
- 在 100 做多、止损设在 98,每单位承担 2 的风险。在 104 平仓是 +2R,在 99 平仓是 −0.5R,触及 98 的止损则是 −1R。
- 平均R 是所有已平仓交易的平均值。高于零,说明模型每承担一单位风险就能赚钱;+0.20R 意味着它在每笔交易上平均赚到了所承担风险的五分之一。
平均R 是以风险为单位衡量的交易期望值。这也是排行榜按 R 而不是按胜率排序的原因:如果亏损大于盈利,一个模型即使经常赢也照样会亏钱。
2026 年 10 月 15 日的排行榜
下表列出默认视图(全部时间、全部周期、多空双向)中排名前十的模型。当天共有 39 个模型进入排名,另有 5 个被列为暂未排名,来自八家提供商:OpenAI、Anthropic、Google、xAI、DeepSeek、Qwen、Kimi 和 Z.ai。
| 排名 | 模型 | 提供商 | 平均R | 胜率 | 交易笔数 |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.59R | 60.0% | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0.44R | 61.3% | 253 |
| 3 | Gemini 3.8 Flash | +0.44R | 57.7% | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0.42R | 56.0% | 166 |
| 5 | GLM 5.3 | Z.ai | +0.33R | 54.1% | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0.32R | 56.6% | 76 |
| 7 | GPT-6 Luna | OpenAI | +0.30R | 53.2% | 94 |
| 8 | Grok 4.7 | xAI | +0.24R | 51.7% | 89 |
| 9 | GPT-6 Astra | OpenAI | +0.21R | 52.3% | 197 |
| 10 | Gemini 3.1 Pro Preview | +0.20R | 49.0% | 286 |
再对比同一天胜率最高的三个模型:
| 模型 | 胜率 | 平均R | 交易笔数 | 按平均R 的排名 |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning(已退役) | 68.0% | +0.08R | 1,373 | 15 |
| GPT-5.6 Luna | 62.5% | +0.01R | 24 | 28 |
| GPT-4o | 61.8% | +0.05R | 76 | 16 |
有三点值得注意。第一,高胜率配上接近零的 R,通常意味着许多小额盈利加上少数几笔大额亏损。第二,已排名模型的平均值从榜首的 +0.59R 一直分布到榜尾的 −0.33R,因此在这组数据上,选哪个模型显然很重要。第三,新模型并不会自动胜出:好几个最近发布的模型的 R 都接近零。
怎样读榜才不会自欺欺人
- 检查样本量。 模型页面会在每个胜率下方显示一个 95% 区间(Wilson 区间)。240 笔交易、胜率 60% 时,真实胜率最可能落在约 54% 到 66% 之间。24 笔交易、胜率 62.5% 时,区间从约 43% 一直延伸到 79%,宽到几乎得不出什么结论。
- 把 R 和胜率放在一起看。 最理想的表现是在大量交易中取得正的平均R,同时胜率也说得过去。光有高胜率是不够的。
- 按你的交易方式筛选。 同一个模型在 1 分钟图和 4 小时图上、在做多和做空时的表现都可能不同。先设好周期和方向,再下结论。
- 留意持仓时间。 平均持仓时长从几分钟到超过一天不等。一个持仓 13 分钟的模型和一个持仓 16 小时的模型,干的是不同的活。
- 注意时间段。 30 天视图对近期表现反应更快;全部时间的数据更多,但包含较早的市场环境。
- 打开模型页面。 近期交易、模型担任过的席位及其细分数据,能告诉你一个数字是怎么得来的。
局限性:排行榜无法告诉你的事
把这些讲清楚,才让这份排名值得引用。
- 实盘交易和回放交易混在一起。 两个来源的衡量方式不同。实盘持仓在入场后可以被管理(止损可以移动);回放交易在入场和离场之间从不做任何管理。
- 实盘的功劳是共享的。 一笔实盘交易会计入该会话中运行四个智能体之一的每一个模型,所以一个模型的实盘记录反映的是一个团队,而不只是这个模型本身。回放交易则把决策模型单独分离出来。
- 回放常常强制选边。 在每三个回放时刻中有两个,模型必须在做多和做空之间选一个;它不能选择观望。真实交易是允许耐心等待的。
- 并非每个模型都参与回放。 回放组是一份当前模型的名单。较早的模型主要依据实盘交易来衡量,覆盖的是用户运行它们时的市场和时段。
- 没有美元盈亏、回撤或夏普比率。 平均R 忽略了仓位大小、复利以及模型走过的路径。两个平均R 相同的模型,持有起来的感受可能截然不同。
- 只限加密货币。 排行榜覆盖的是加密货币交易,对股票没有直接的参考意义。
- 过去不会按时重演。 随着市场变化和新交易平仓,排名也会改变。
为什么这份排名很难被操纵
- 实盘交易只能向前。 实盘决策在结果出现之前就已做出,事后无法修改。
- 回放的发布日规则。 回放交易只从模型发布日当天起才计入。
- 已退役模型保留在榜。 较弱或较老的模型不会为了美化整体而被删除,从而避免了幸存者偏差。
- 公开可见的最低样本量。 在当前视图中交易少于 20 笔的模型会被列出,但不参与排名。
为你自己的分析挑选模型
在实时分析室里,你可以为四个智能体分别选择背后的模型,而自动驾驶会按计划运行同样的四个智能体。把排行榜当作参考之一:
- 先看足够交易笔数下的平均R,再看胜率及其区间。
- 先按你的周期和方向筛选,再做比较。
- 定期复查。 新模型层出不穷,2026 年 10 月 15 日的榜首不会永远保住这个位置。
- 在不同席位混用模型,如果你希望智能体之间真正产生分歧;关于独立性为何重要,请看8 个 AI 分析师对 1 个模型。
想了解四个智能体如何分工,请阅读什么是 AI 智能体?多智能体 AI 系统如何运作。想了解各模型在股票研究(而非加密货币交易)上的比较,请看GPT、Gemini 与 Claude 的 AI 股票分析对比。
常见问题
目前哪个 AI 模型最会交易? 在 2026 年 10 月 15 日,Grok 4.6 在全部时间榜上的平均R 最高(240 笔交易,+0.59R)。随着交易平仓,排序会发生变化,请到排行榜查看当前视图。
为什么按平均R 而不是胜率排名? 因为胜率忽略了盈利和亏损的大小。2026 年 10 月 15 日胜率最高的模型,每笔交易只赚到 +0.08R。
一个模型需要多少笔交易才能进入排名? 在当前视图中至少 20 笔已平仓交易。少于这个数的模型显示在“暂未排名”之下。有胜负的交易少于 5 笔的模型不会上榜。
这些是真实交易吗? 排行榜混合了两类交易:来自已登录用户实时分析会话和自动驾驶的持仓,以及按真实历史 1 分钟 K 线结算的回放交易。两者在上文都有说明。
排行榜会显示盈亏、回撤或夏普比率吗? 不会。它显示的是交易笔数、胜率、平均R 和平均持仓时间。
高平均R 能保证未来盈利吗? 不能。它描述的是特定条件下过去已平仓的交易。过去的结果不能预测未来的收益。
结论
最好的 AI 交易员,是在你实际交易的周期里、在足够多的交易中每承担一单位风险赚得最多的那个,而诚实的评判方式就是在看得见样本量的前提下看平均R。2026 年 10 月 15 日,在全部时间视图中它是 Grok 4.6;等你读到这篇文章时,可能已经换成了别的模型。打开排行榜,设好筛选条件,读一读模型页面,然后在实时分析室里试试你选中的模型。
风险提示: SimianX 仅提供 AI 市场研究和教育性分析,不构成投资建议。AI 的输出可能出错。过往表现不能预测未来结果,交易加密货币可能造成亏损。
延伸阅读
- MCP是什么?AI智能体炒股与股票数据MCP接入完整指南
- 8位AI分析师对比单一模型:多智能体投资委员会如何分工运作
- 什么是 AI 智能体?一文看懂多智能体系统原理、类型与交易实例
- AI模型会在加密崩盘中恐慌抛售吗?31个交易机器人揭晓真相
- GPT、Gemini与Claude:AI股票分析2026指南
- 30+款主流AI模型同台竞技:加密货币实盘胜率与多空排行榜
- 2026最适合加密货币交易的AI模型:30+大模型实测排名