 作者:Marcus Reeve
如何評判一個 AI 交易員:平均R、勝率與樣本數
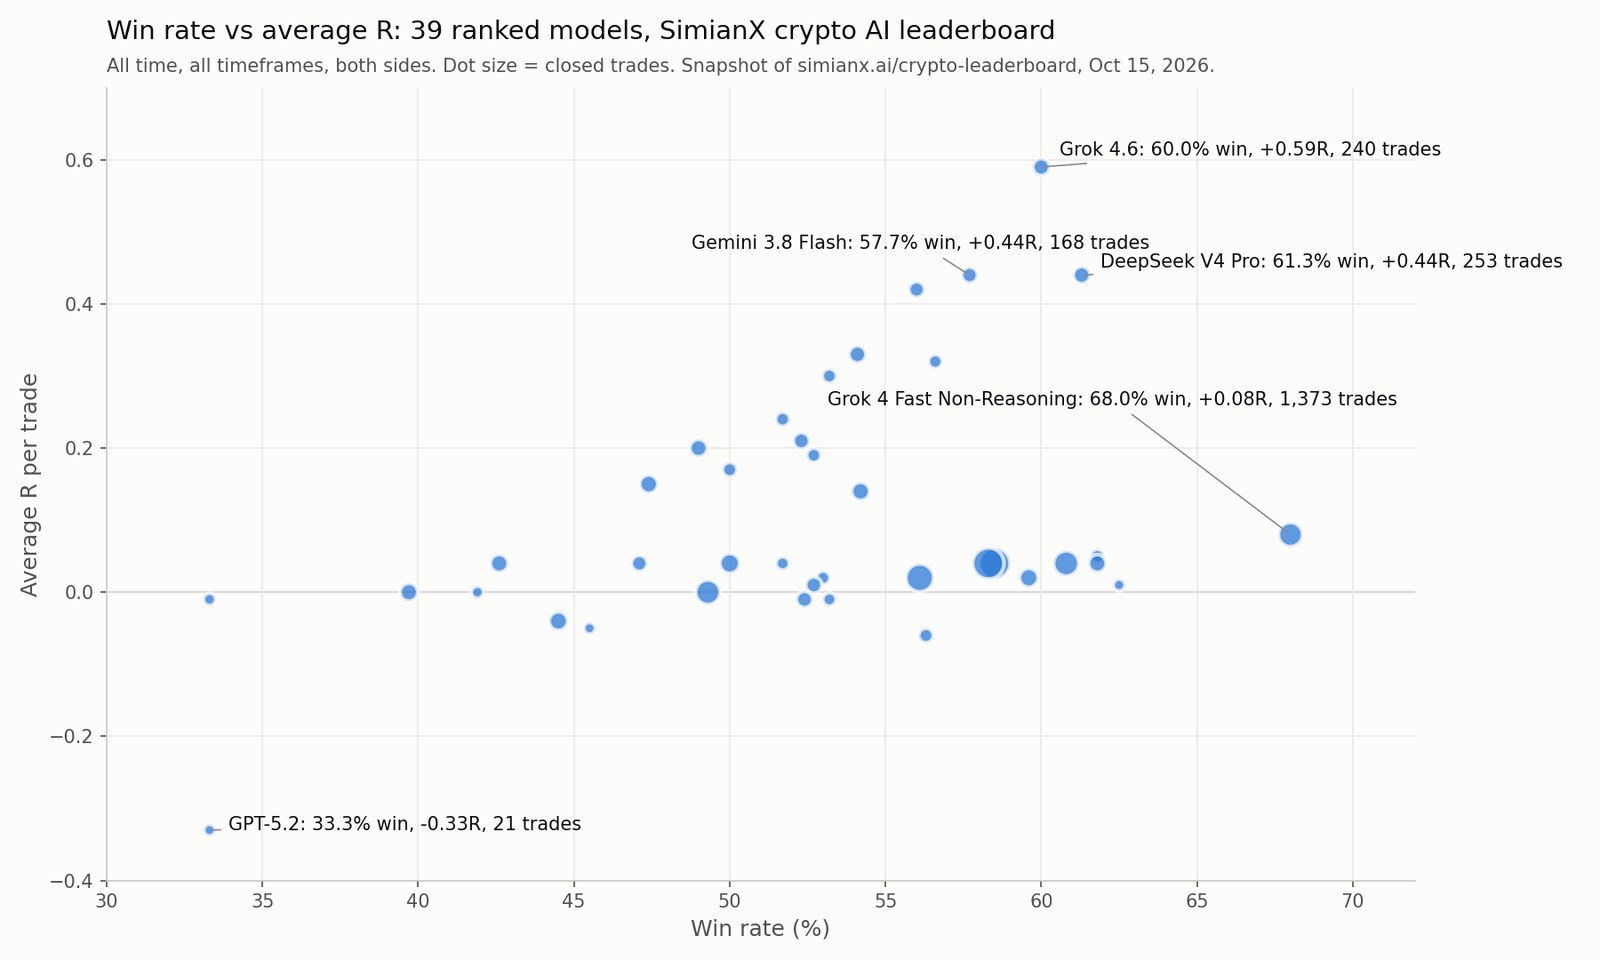
簡短回答: 截至 2026 年 10 月 15 日,在 SimianX 加密貨幣 AI 排行榜(全部時間、全部週期、多空雙向)上,平均R 最高的模型是 Grok 4.6,在 240 筆交易中每筆平均 +0.59R;緊隨其後的是 DeepSeek V4 Pro(+0.44R,253 筆)和 Gemini 3.8 Flash(+0.44R,168 筆)。勝率最高的模型 Grok 4 Fast Non-Reasoning 在 1,373 筆交易中有 68.0% 以獲利平倉,但平均只有 +0.08R。這個落差正是排行榜上最有用的一課:一個模型贏得有多頻繁,遠不如它每承擔一份風險能賺多少來得重要。
隨著交易陸續平倉,排名會不斷變動,因此請把這些名字視為標有日期的快照,在依賴它們之前先去看看即時排行榜。本文接下來會說明排行榜是如何建立的、平均R 是什麼意思、怎樣看榜才不會自欺欺人,以及它無法告訴你什麼。
為什麼「最強 AI 交易員」很難回答
關於哪個 AI 最會交易的說法,大多數都過不了以下三道檢驗中的某一道。
基準測試不等於交易。 一個在推理或程式設計基準測試中名列前茅的模型,並沒有證明它會交易。市場充滿雜訊且不斷變化,一筆好的交易是在不確定性下做出的決策,而不是一場記憶力測驗。
回測可以被調出來。 回測可以一直調整到曲線看起來完美無缺,這就是過度擬合:策略實際上已經偷看了答案。解決辦法是做前瞻測試,思路接近滾動前推測試,也就是每一個決策都在結果揭曉之前做出。
小樣本會美化運氣好的人。 只要十筆交易,任何模型都可能看起來才華洋溢或者一無是處。一個可信的排行榜需要設定最低樣本數,並且把它公開出來。
SimianX 排行榜正是圍繞這三個問題設計的。它並不完美,下文的局限性部分和排名本身同樣重要。
SimianX 排行榜如何運作
排行榜只統計已平倉的加密貨幣交易;未平倉的部位要等平倉後才會計入。它的交易來自兩個來源。
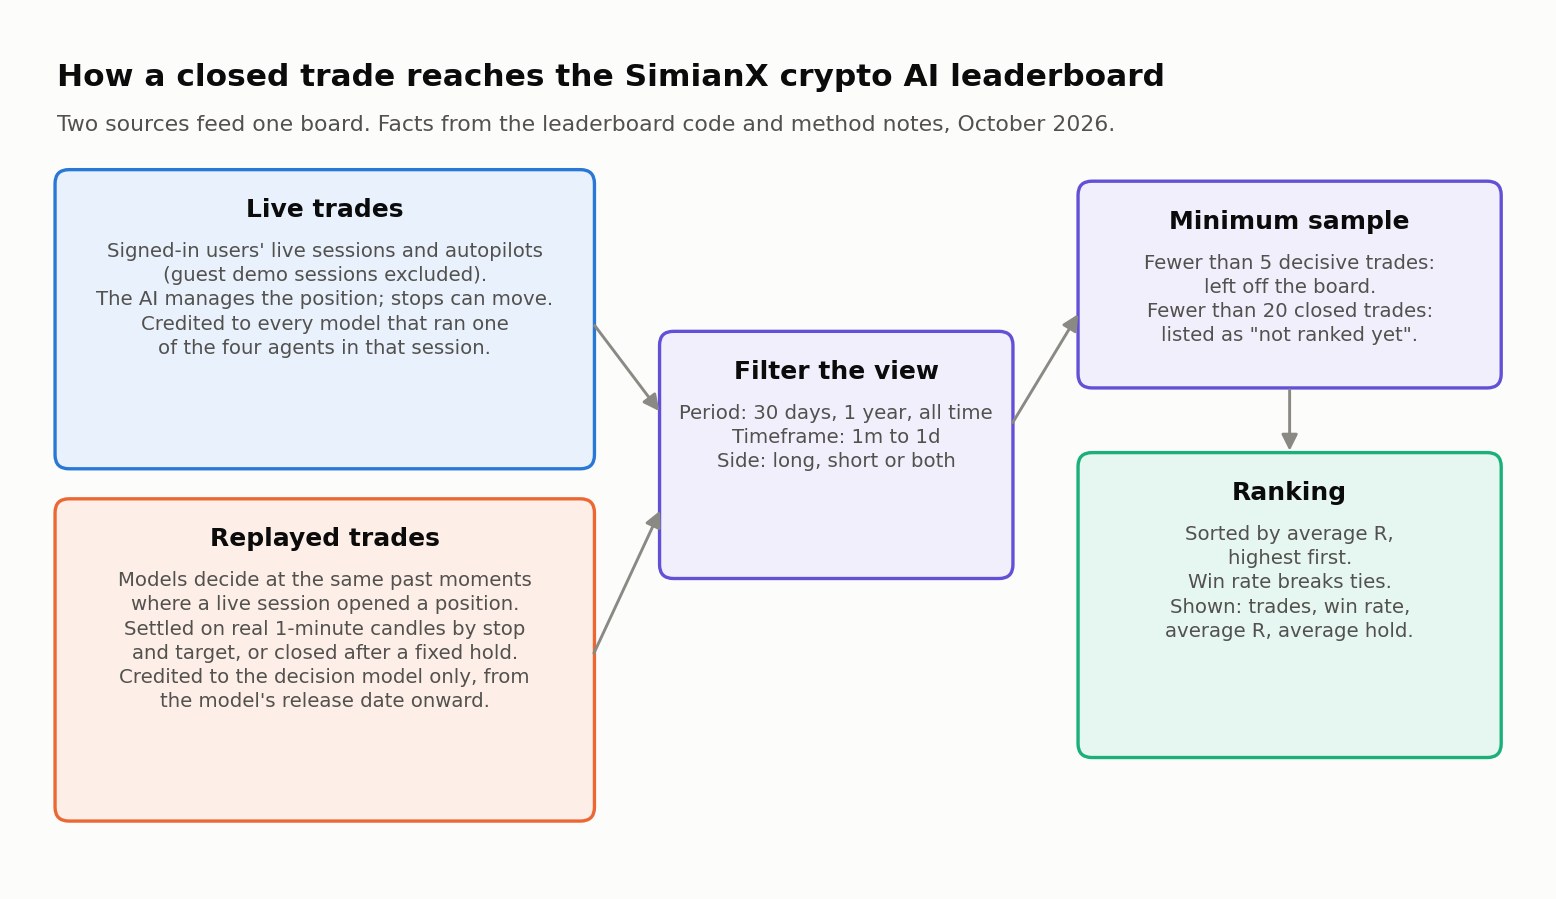
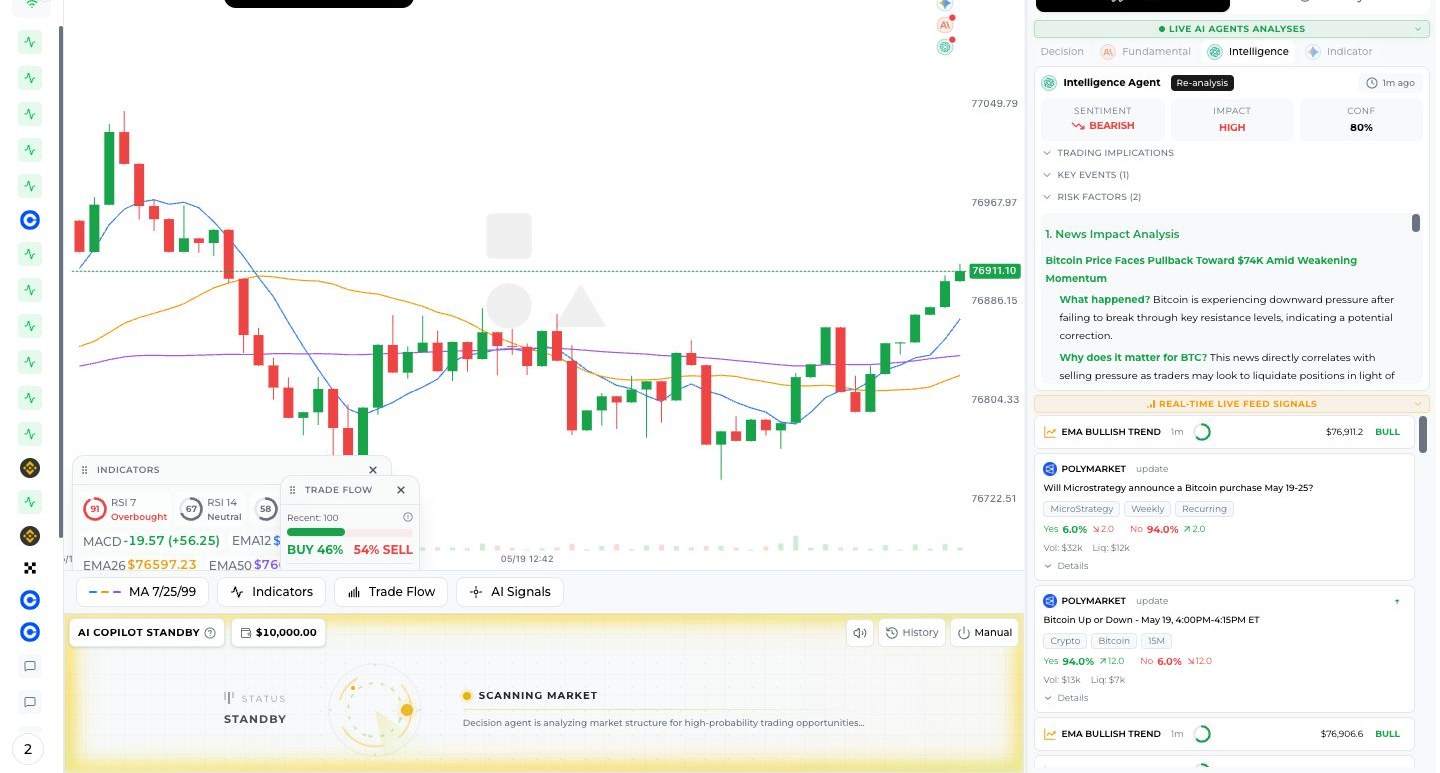
實盤交易。 這些交易來自已登入使用者的加密貨幣即時分析工作階段和自動駕駛(autopilot),其中由 AI 管理部位。訪客示範工作階段不計入。在即時分析室裡,四個智能體協同運作:指標、情報、基本面和決策,使用者可以為每個智能體選擇不同的模型。因此,一筆實盤交易會記到該工作階段中負責四個智能體之一的每一個模型名下,每個模型的頁面也會顯示它擔任過哪些席位。
回放交易。 為了在同等條件下比較模型,排行榜還會回放歷史。回放名單中的每個模型都會在過去同樣的時刻被要求做出決策,這些時刻就是某個即時工作階段當初建倉的時刻,所用的是實盤決策提示詞。接著,它的進場會依交易所真實的 1 分鐘 K 線,以它自己設定的停損和目標價來結算,或者在固定持有期結束後以市價平倉;中間不做任何管理。一筆回放交易只有在模型發布日當天或之後建倉才會計入,而且只記到決策模型名下。
截至 2026 年 10 月 15 日,排行榜背後的資料庫中有 5,154 筆已平倉的實盤部位(自 2026 年 1 月 22 日起)和 3,056 筆回放交易(自 2026 年 7 月 13 日起)。由於一筆實盤部位最多可以計入四個模型,所以一個模型的交易筆數並不等於它獨自建立的部位數量。
頁面所執行的排名規則如下:
| 規則 | 作用 |
|---|---|
| 排序方式 | 依每筆交易的平均R 由高到低排序;勝率用來打破平手 |
| 進入排名的門檻 | 在目前檢視中至少有 20 筆已平倉交易;低於此數的模型顯示為「尚未排名」 |
| 出現在榜上的門檻 | 至少 5 筆分出勝負的交易(獲利加虧損);損益兩平的交易不計入勝率 |
| 欄位 | 交易筆數、勝率、平均R、平均持倉時間 |
| 篩選 | 時間區間(30 天、1 年、全部時間)、週期(1 分鐘到 1 天)、方向(做多或做空) |
| 已退役模型 | 保留在榜上並帶有「已退役」標籤;它們過去的交易仍然計入 |
| 模型頁面 | 勝率下方的 95% 區間、該模型擔任過的席位、近期交易以及依時間區間的細分 |
排行榜不顯示的內容:以美元計的損益、最大回撤、夏普比率或部位大小。平均R 是核心指標。
平均R 是什麼意思
R 以進場時承擔的風險為單位來衡量一筆交易的結果。1R 就是這筆交易如果觸及建倉時設定的停損會虧掉的金額。
- 在 100 做多、停損設在 98,每單位承擔 2 的風險。在 104 平倉是 +2R,在 99 平倉是 −0.5R,觸及 98 的停損則是 −1R。
- 平均R 是所有已平倉交易的平均值。高於零,代表模型每承擔一單位風險就能賺錢;+0.20R 表示它在每筆交易上平均賺到所承擔風險的五分之一。
平均R 是以風險為單位衡量的交易期望值。這也是排行榜依 R 而不是依勝率排序的原因:如果虧損大於獲利,一個模型即使經常贏也照樣會賠錢。
2026 年 10 月 15 日的排行榜
下表列出預設檢視(全部時間、全部週期、多空雙向)中排名前十的模型。當天共有 39 個模型進入排名,另有 5 個被列為尚未排名,來自八家供應商:OpenAI、Anthropic、Google、xAI、DeepSeek、Qwen、Kimi 和 Z.ai。
| 排名 | 模型 | 供應商 | 平均R | 勝率 | 交易筆數 |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.59R | 60.0% | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0.44R | 61.3% | 253 |
| 3 | Gemini 3.8 Flash | +0.44R | 57.7% | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0.42R | 56.0% | 166 |
| 5 | GLM 5.3 | Z.ai | +0.33R | 54.1% | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0.32R | 56.6% | 76 |
| 7 | GPT-6 Luna | OpenAI | +0.30R | 53.2% | 94 |
| 8 | Grok 4.7 | xAI | +0.24R | 51.7% | 89 |
| 9 | GPT-6 Astra | OpenAI | +0.21R | 52.3% | 197 |
| 10 | Gemini 3.1 Pro Preview | +0.20R | 49.0% | 286 |
再對照同一天勝率最高的三個模型:
| 模型 | 勝率 | 平均R | 交易筆數 | 依平均R 的排名 |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning(已退役) | 68.0% | +0.08R | 1,373 | 15 |
| GPT-5.6 Luna | 62.5% | +0.01R | 24 | 28 |
| GPT-4o | 61.8% | +0.05R | 76 | 16 |
有三點值得注意。第一,高勝率搭配接近零的 R,通常代表許多小額獲利加上少數幾筆大額虧損。第二,已排名模型的平均值從榜首的 +0.59R 一路分布到榜尾的 −0.33R,因此在這組資料上,選哪個模型顯然很重要。第三,新模型並不會自動勝出:好幾個最近發布的模型 R 都接近零。
怎樣看榜才不會自欺欺人
- 檢查樣本數。 模型頁面會在每個勝率下方顯示一個 95% 區間(Wilson 區間)。240 筆交易、勝率 60% 時,真實勝率最可能落在約 54% 到 66% 之間。24 筆交易、勝率 62.5% 時,區間從約 43% 一路延伸到 79%,寬到幾乎得不出什麼結論。
- 把 R 和勝率放在一起看。 最理想的表現是在大量交易中取得正的平均R,同時勝率也說得過去。光有高勝率是不夠的。
- 依你的交易方式篩選。 同一個模型在 1 分鐘圖和 4 小時圖上、在做多和做空時的表現都可能不同。先設好週期和方向,再下結論。
- 留意持倉時間。 平均持倉時間從幾分鐘到超過一天都有。一個持倉 13 分鐘的模型和一個持倉 16 小時的模型,做的是不同的工作。
- 注意時間區間。 30 天檢視對近期表現反應更快;全部時間的資料更多,但包含較早的市場環境。
- 打開模型頁面。 近期交易、模型擔任過的席位及其細分資料,能告訴你一個數字是怎麼得來的。
局限性:排行榜無法告訴你的事
把這些講清楚,才讓這份排名值得引用。
- 實盤交易和回放交易混在一起。 兩個來源的衡量方式不同。實盤部位在進場後可以被管理(停損可以移動);回放交易在進場和出場之間從不做任何管理。
- 實盤的功勞是共享的。 一筆實盤交易會計入該工作階段中負責四個智能體之一的每一個模型,所以一個模型的實盤紀錄反映的是一個團隊,而不只是這個模型本身。回放交易則把決策模型單獨分離出來。
- 回放常常強制選邊。 每三個回放時刻中有兩個,模型必須在做多和做空之間擇一;它不能選擇觀望。真實交易是允許耐心等待的。
- 並非每個模型都參與回放。 回放名單是一份現役模型的清單。較早的模型主要依據實盤交易來衡量,涵蓋的是使用者執行它們時的市場和時段。
- 沒有美元損益、回撤或夏普比率。 平均R 忽略了部位大小、複利以及模型走過的路徑。兩個平均R 相同的模型,持有起來的感受可能截然不同。
- 僅限加密貨幣。 排行榜涵蓋的是加密貨幣交易,對股票沒有直接的參考意義。
- 過去不會按時重演。 隨著市場變化和新交易平倉,排名也會改變。
為什麼這份排名很難被操縱
- 實盤交易只能向前。 實盤決策在結果出現之前就已做出,事後無法修改。
- 回放的發布日規則。 回放交易只從模型發布日當天起才計入。
- 已退役模型保留在榜。 較弱或較舊的模型不會為了美化整體而被刪除,從而避免了倖存者偏差。
- 公開可見的最低樣本數。 在目前檢視中交易少於 20 筆的模型會被列出,但不參與排名。
為你自己的分析挑選模型
在即時分析室裡,你可以為四個智能體分別選擇背後的模型,而自動駕駛會依排程執行同樣的四個智能體。把排行榜當作參考之一:
- 先看交易筆數足夠時的平均R,再看勝率及其區間。
- 先依你的週期和方向篩選,再做比較。
- 定期複查。 新模型推陳出新,2026 年 10 月 15 日的榜首不會永遠守住這個位置。
- 在不同席位混用模型,如果你希望智能體之間真正產生分歧;關於獨立性為何重要,請看8 個 AI 分析師對 1 個模型。
想了解四個智能體如何分工,請閱讀什麼是 AI 智能體?多智能體 AI 系統如何運作。想了解各模型在股票研究(而非加密貨幣交易)上的比較,請看GPT、Gemini 與 Claude 的 AI 股票分析比較。
常見問題
目前哪個 AI 模型最會交易? 在 2026 年 10 月 15 日,Grok 4.6 在全部時間榜上的平均R 最高(240 筆交易,+0.59R)。隨著交易平倉,排序會改變,請到排行榜查看目前檢視。
為什麼依平均R 而不是勝率排名? 因為勝率忽略了獲利和虧損的大小。2026 年 10 月 15 日勝率最高的模型,每筆交易只賺到 +0.08R。
一個模型需要多少筆交易才能進入排名? 在目前檢視中至少 20 筆已平倉交易。少於這個數的模型顯示在「尚未排名」之下。分出勝負的交易少於 5 筆的模型不會上榜。
這些是真實交易嗎? 排行榜混合了兩類交易:來自已登入使用者即時分析工作階段和自動駕駛的部位,以及依真實歷史 1 分鐘 K 線結算的回放交易。兩者在上文都有說明。
排行榜會顯示損益、回撤或夏普比率嗎? 不會。它顯示的是交易筆數、勝率、平均R 和平均持倉時間。
高平均R 能保證未來獲利嗎? 不能。它描述的是特定條件下過去已平倉的交易。過去的結果不能預測未來的報酬。
結論
最好的 AI 交易員,是在你實際交易的週期裡、在足夠多的交易中每承擔一單位風險賺得最多的那一個,而誠實的評判方式就是在看得見樣本數的前提下看平均R。2026 年 10 月 15 日,在全部時間檢視中它是 Grok 4.6;等你讀到這篇文章時,可能已經換成別的模型。打開排行榜,設好篩選條件,讀一讀模型頁面,然後在即時分析室裡試試你選中的模型。
風險提示: SimianX 僅提供 AI 市場研究和教育性分析,不構成投資建議。AI 的輸出可能出錯。過往表現不能預測未來結果,交易加密貨幣可能造成虧損。
延伸閱讀
- MCP是什麼?AI agent股票分析與MCP協議投資完整指南
- 8位AI分析師對比單一模型:多智能體投資委員會如何分工運作
- 什麼是 AI 代理?一次看懂多代理系統原理、類型與交易實例
- AI模型會在加密崩盤中恐慌拋售嗎?31個交易機器人揭曉真相
- GPT與Gemini與Claude:AI股票分析2026指南
- 30+款主流AI模型同台競技:加密貨幣真實交易勝率與多空排行榜
- 2026最適合交易加密貨幣的AI模型:30+大型模型實測排名