 Por Marcus Reeve
Cómo evaluar a un operador de IA: R medio, tasa de acierto y tamaño de muestra
Respuesta corta: en la clasificación de IA para criptomonedas de SimianX, a 15 de octubre de 2026 (todo el historial, todos los marcos temporales, ambos lados), el modelo con el R medio más alto era Grok 4.6, con +0,59R por operación en 240 operaciones, seguido de DeepSeek V4 Pro (+0,44R, 253 operaciones) y Gemini 3.8 Flash (+0,44R, 168 operaciones). El modelo con la tasa de acierto más alta, Grok 4 Fast Non-Reasoning, cerró con ganancia el 68,0 % de sus 1.373 operaciones, pero promedió solo +0,08R. Esa brecha es la lección más útil de la clasificación: la frecuencia con la que gana un modelo dice mucho menos que cuánto gana en relación con el riesgo que asume.
Las posiciones cambian a medida que se cierran operaciones, así que tome estos nombres como una instantánea fechada y consulte la clasificación en vivo antes de basarse en ellos. El resto de esta guía explica cómo se construye la clasificación, qué significa el R medio, cómo leerla sin engañarse y qué no puede decirle.
Por qué es difícil responder cuál es «el mejor operador de IA»
La mayoría de las afirmaciones sobre qué IA opera mejor fallan en una de tres pruebas.
Las pruebas de referencia no son operaciones. Un modelo que encabeza una prueba de razonamiento o de programación no ha demostrado nada sobre cómo opera. Los mercados son ruidosos y cambian sin cesar, y una buena operación es una decisión bajo incertidumbre, no un examen de memoria.
Las pruebas retrospectivas se pueden ajustar. Una prueba retrospectiva puede retocarse hasta que la curva parezca perfecta, lo que se conoce como sobreajuste: la estrategia, en la práctica, ya ha visto las respuestas del examen. El remedio es una prueba hacia adelante, cercana a la idea de la validación progresiva (walk-forward), en la que cada decisión se toma antes de conocer su resultado.
Las muestras pequeñas favorecen a los afortunados. Diez operaciones pueden hacer que cualquier modelo parezca brillante o desastroso. Una clasificación creíble necesita una muestra mínima y debe mostrarla.
La clasificación de SimianX está diseñada en torno a esos tres problemas. No es perfecta, y la sección de limitaciones de más abajo es tan importante como la propia clasificación.
Cómo funciona la clasificación de SimianX
La clasificación cuenta solo operaciones de criptomonedas cerradas; las posiciones abiertas se incorporan cuando se cierran. Sus operaciones proceden de dos fuentes.
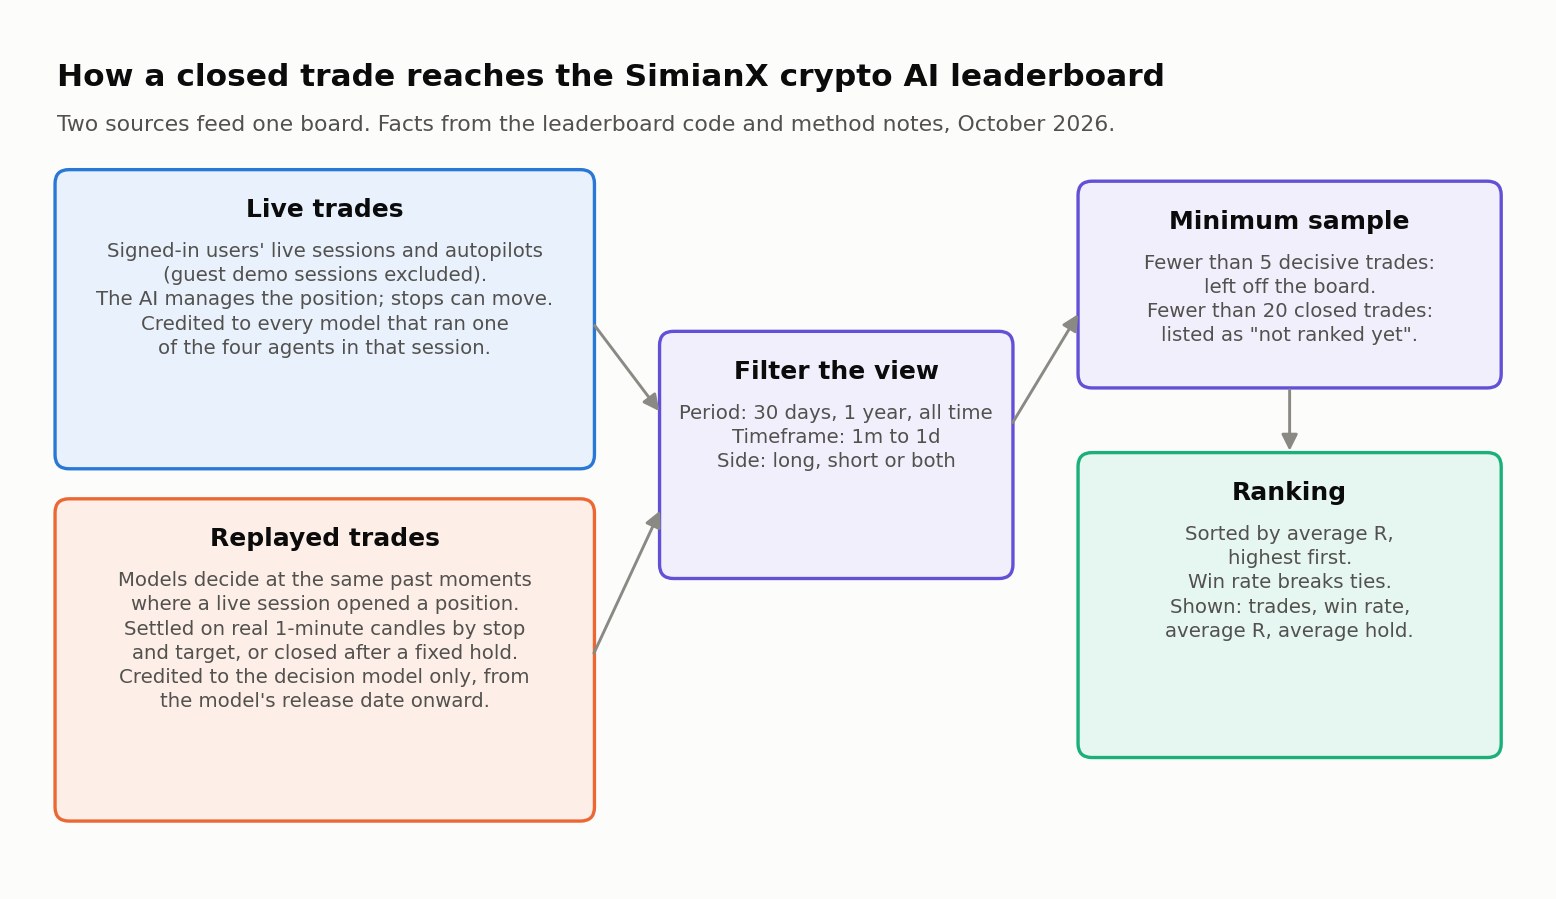
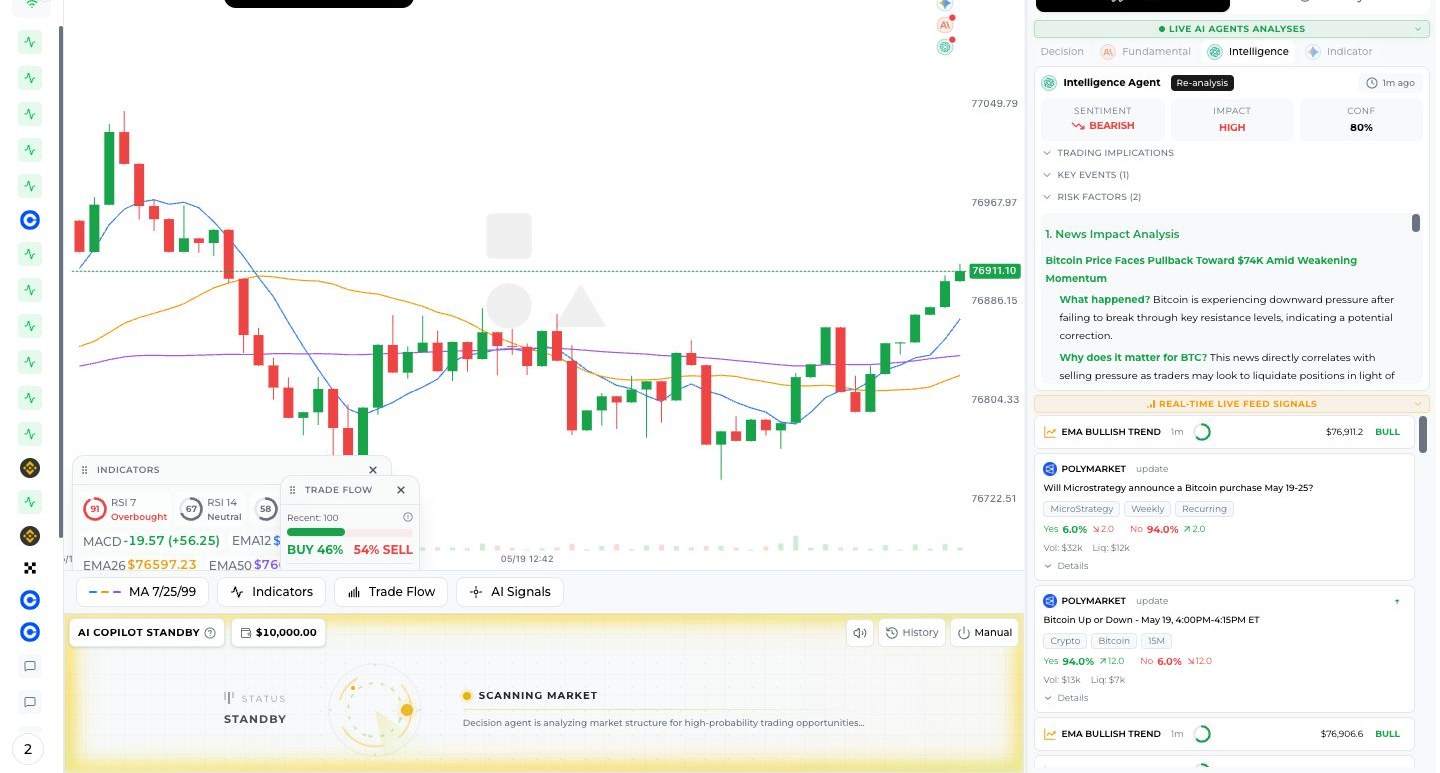
Operaciones en vivo. Proceden de sesiones en vivo de criptomonedas y de pilotos automáticos de usuarios registrados en los que la IA gestionó una posición. Se excluyen las sesiones de demostración de invitados. En la sala en vivo trabajan juntos cuatro agentes —Indicadores, Inteligencia, Fundamental y Decisión—, y el usuario puede elegir un modelo distinto para cada uno. Por eso, una operación en vivo se acredita a cada modelo que ejecutó uno de los cuatro agentes en esa sesión, y la página de cada modelo muestra qué puestos ocupó.
Operaciones reproducidas. Para comparar los modelos en igualdad de condiciones, la clasificación también reproduce el pasado. A cada modelo del conjunto de reproducción se le pide que decida en los mismos momentos pasados en los que una sesión en vivo abrió una posición, con la misma instrucción de decisión que se usa en vivo. Después, su entrada se liquida con las velas reales de 1 minuto del exchange según su propio stop y su propio objetivo, o se cierra a precio de mercado tras una ventana de tenencia fija; entre medias no se gestiona nada. Una operación reproducida solo cuenta si se abrió en la fecha de lanzamiento del modelo o después, y se acredita únicamente al modelo de decisión.
A 15 de octubre de 2026, la base de datos de la clasificación contenía 5.154 posiciones en vivo cerradas (desde el 22 de enero de 2026) y 3.056 operaciones reproducidas (desde el 13 de julio de 2026). Como una posición en vivo puede contar para hasta cuatro modelos, el número de operaciones de un modelo no equivale al número de posiciones que abrió por sí solo.
Las reglas de clasificación, tal como las aplica la página:
| Regla | Qué hace |
|---|---|
| Orden | R medio por operación, de mayor a menor; la tasa de acierto deshace los empates |
| Mínimo para clasificar | Al menos 20 operaciones cerradas en la vista actual; los modelos por debajo aparecen como «aún sin clasificar» |
| Mínimo para aparecer | Al menos 5 operaciones decisivas (ganadoras más perdedoras); las operaciones en punto de equilibrio no cuentan en la tasa de acierto |
| Columnas | Operaciones, tasa de acierto, R medio, tiempo medio de tenencia |
| Filtros | Periodo (30 días, 1 año, todo el historial), marco temporal (de 1m a 1d), lado (largo o corto) |
| Modelos retirados | Siguen en la clasificación con la etiqueta «Retirado»; sus operaciones pasadas siguen contando |
| Páginas de modelo | Un rango del 95 % bajo la tasa de acierto, los puestos que ocupó el modelo, las operaciones recientes y desgloses por periodo |
Lo que la clasificación no muestra: ganancias y pérdidas en dólares, caída máxima (drawdown), ratio de Sharpe ni tamaños de posición. El R medio es la medida principal.
Qué significa el R medio
R mide el resultado de una operación en unidades del riesgo que asumió al entrar. 1R es lo que habría perdido la operación si hubiera tocado el stop-loss fijado al abrirla.
- Un largo en 100 con el stop en 98 arriesga 2 por unidad. Cerrar en 104 es +2R, cerrar en 99 es −0,5R y tocar el stop en 98 es −1R.
- El R medio es la media de todas las operaciones cerradas. Por encima de cero, el modelo gana dinero por unidad de riesgo; +0,20R significa que ganó de media una quinta parte de lo que arriesgó en cada operación.
El R medio es una versión del valor esperado de una operación medido en unidades de riesgo. Por eso la clasificación ordena por R y no por tasa de acierto: un modelo puede ganar a menudo y aun así perder dinero si sus pérdidas son mayores que sus ganancias.
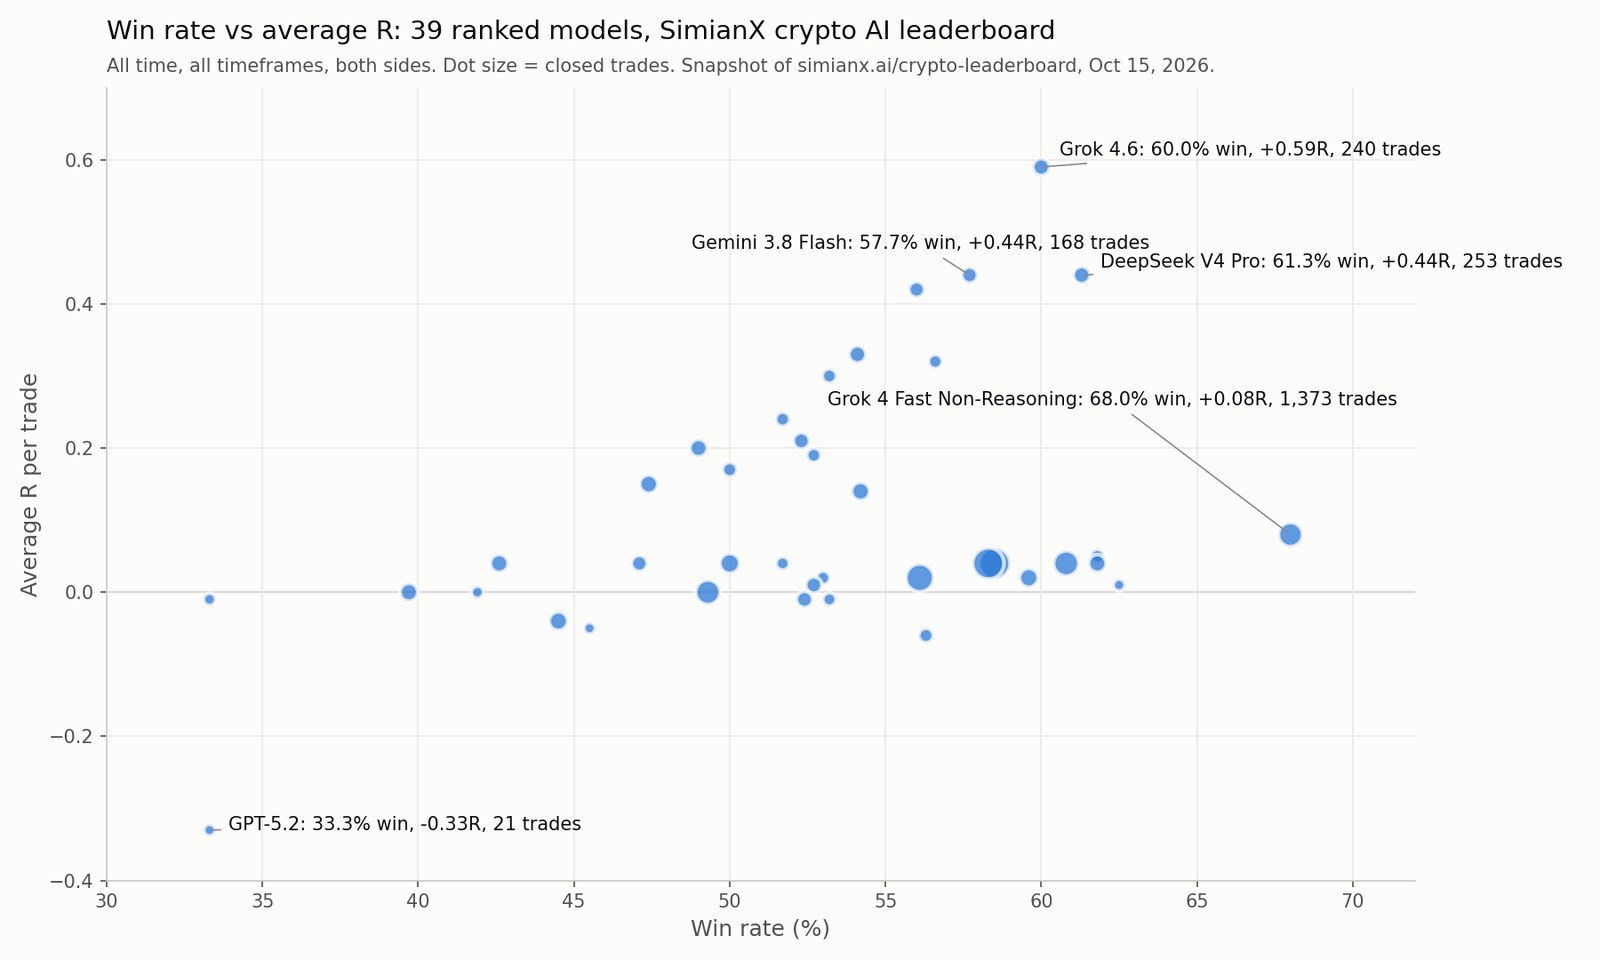
La clasificación el 15 de octubre de 2026
La tabla muestra los diez primeros modelos clasificados en la vista por defecto (todo el historial, todos los marcos temporales, ambos lados). Ese día había 39 modelos clasificados y otros 5 figuraban como aún sin clasificar, de ocho proveedores: OpenAI, Anthropic, Google, xAI, DeepSeek, Qwen, Kimi y Z.ai.
| Puesto | Modelo | Proveedor | R medio | Tasa de acierto | Operaciones |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,59R | 60,0 % | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0,44R | 61,3 % | 253 |
| 3 | Gemini 3.8 Flash | +0,44R | 57,7 % | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0,42R | 56,0 % | 166 |
| 5 | GLM 5.3 | Z.ai | +0,33R | 54,1 % | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0,32R | 56,6 % | 76 |
| 7 | GPT-6 Luna | OpenAI | +0,30R | 53,2 % | 94 |
| 8 | Grok 4.7 | xAI | +0,24R | 51,7 % | 89 |
| 9 | GPT-6 Astra | OpenAI | +0,21R | 52,3 % | 197 |
| 10 | Gemini 3.1 Pro Preview | +0,20R | 49,0 % | 286 |
Compárelo ahora con las tres tasas de acierto más altas del mismo día:
| Modelo | Tasa de acierto | R medio | Operaciones | Puesto por R medio |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning (retirado) | 68,0 % | +0,08R | 1.373 | 15 |
| GPT-5.6 Luna | 62,5 % | +0,01R | 24 | 28 |
| GPT-4o | 61,8 % | +0,05R | 76 | 16 |
Destacan tres cosas. Primero, una tasa de acierto alta con un R cercano a cero suele significar muchas ganancias pequeñas y unas pocas pérdidas grandes. Segundo, los R medios clasificados van de +0,59R en la cima a −0,33R al final, así que la elección del modelo importa claramente en estos datos. Tercero, los modelos más nuevos no ganan automáticamente: varios lanzamientos recientes se sitúan cerca de cero R.
Cómo leer la clasificación sin engañarse
- Revise el tamaño de la muestra. Las páginas de modelo muestran un rango del 95 % bajo cada tasa de acierto (un intervalo de Wilson). Con un 60 % en 240 operaciones, la tasa de acierto real se sitúa muy probablemente entre el 54 % y el 66 %, aproximadamente. Con un 62,5 % en 24 operaciones, el rango va aproximadamente del 43 % al 79 %, demasiado amplio para concluir gran cosa.
- Lea el R y la tasa de acierto juntos. El mejor perfil es un R medio positivo obtenido en muchas operaciones con una tasa de acierto razonable. Una tasa de acierto alta por sí sola no basta.
- Filtre según su forma de operar. Un mismo modelo puede comportarse de forma distinta en gráficos de 1 minuto y de 4 horas, y en largos y cortos. Fije el marco temporal y el lado antes de sacar conclusiones.
- Fíjese en el tiempo de tenencia. La duración media va de minutos a más de un día. Un modelo que mantiene la posición 13 minutos y otro que la mantiene 16 horas hacen trabajos distintos.
- Atienda al periodo. La vista de 30 días reacciona antes al comportamiento reciente; todo el historial tiene más datos, pero condiciones de mercado más antiguas.
- Abra la página del modelo. Las operaciones recientes, los puestos que ocupó un modelo y sus desgloses le dicen cómo se obtuvo una cifra.
Limitaciones: lo que la clasificación no puede decirle
Ser claros sobre esto es lo que hace que merezca la pena citar la clasificación.
- Se mezclan operaciones en vivo y reproducidas. Las dos fuentes se miden de forma distinta. Las posiciones en vivo pueden gestionarse tras la entrada (los stops pueden moverse); las operaciones reproducidas nunca se gestionan entre la entrada y la salida.
- El mérito en vivo es compartido. Una operación en vivo cuenta para cada modelo que ejecutó uno de los cuatro agentes en esa sesión, así que el historial en vivo de un modelo refleja a un equipo, no solo a ese modelo. Las operaciones reproducidas aíslan al modelo de decisión.
- Las reproducciones suelen obligar a elegir lado. En dos de cada tres momentos reproducidos, el modelo debe elegir largo o corto; no puede quedarse fuera. En la operativa real se permite la paciencia.
- No se reproducen todos los modelos. El conjunto de reproducción es una lista de modelos actuales. Los modelos más antiguos se miden sobre todo con operaciones en vivo, en los mercados y periodos en los que los usuarios los utilizaron.
- Sin ganancias y pérdidas en dólares, caída máxima ni Sharpe. El R medio ignora el tamaño de la posición, el interés compuesto y el recorrido que siguió un modelo. Dos modelos con el mismo R medio pueden vivirse de forma muy distinta.
- Solo criptomonedas. La clasificación cubre operaciones con criptomonedas. No dice nada directo sobre acciones.
- El pasado no se repite según un calendario. Las clasificaciones cambian a medida que cambian los mercados y se cierran nuevas operaciones.
Por qué es difícil manipular la clasificación
- Operaciones en vivo solo hacia adelante. Una decisión en vivo se toma antes de que exista su resultado y no puede revisarse después.
- Regla de la fecha de lanzamiento en las reproducciones. Una operación reproducida solo cuenta a partir de la fecha de lanzamiento del modelo.
- Los modelos retirados se quedan. Los modelos más débiles o antiguos no se borran para mejorar la imagen del conjunto, lo que evita el sesgo de supervivencia.
- Una muestra mínima visible. Los modelos con menos de 20 operaciones en la vista aparecen en la lista, pero no se clasifican.
Cómo elegir un modelo para su propio análisis
En la sala en vivo puede elegir el modelo de cada uno de los cuatro agentes, y un piloto automático ejecuta esos mismos cuatro agentes según un calendario. Use la clasificación como un dato más:
- Empiece por el R medio con suficientes operaciones y luego revise la tasa de acierto y su rango.
- Filtre por su marco temporal y su lado antes de comparar.
- Vuelva a revisarla periódicamente. Llegan modelos nuevos con frecuencia, y el líder del 15 de octubre de 2026 no conservará ese puesto para siempre.
- Combine modelos entre los puestos si quiere que los agentes discrepen de verdad; consulte 8 analistas de IA frente a uno para entender por qué importa la independencia.
Para ver cómo se reparten el trabajo los cuatro agentes, lea ¿Qué son los agentes de IA? Sistemas multiagente explicados. Para comparar modelos en el análisis de acciones en lugar de en operaciones con criptomonedas, consulte GPT vs Gemini vs Claude: análisis de acciones con IA.
Preguntas frecuentes
¿Qué modelo de IA es el mejor operador ahora mismo? El 15 de octubre de 2026, Grok 4.6 tenía el R medio más alto en la clasificación de todo el historial (+0,59R en 240 operaciones). El orden cambia a medida que se cierran operaciones, así que consulte la clasificación para ver la vista actual.
¿Por qué clasificar por R medio en lugar de por tasa de acierto? Porque la tasa de acierto ignora el tamaño de las ganancias y las pérdidas. El modelo con la tasa de acierto más alta el 15 de octubre de 2026 ganó solo +0,08R por operación.
¿Cuántas operaciones necesita un modelo para clasificar? Al menos 20 operaciones cerradas en la vista actual. Los modelos con menos aparecen como «aún sin clasificar». Los modelos con menos de 5 operaciones decisivas quedan fuera.
¿Son operaciones reales? La clasificación mezcla dos tipos: posiciones de sesiones en vivo y pilotos automáticos de usuarios registrados, y operaciones reproducidas liquidadas con velas históricas reales de 1 minuto. Ambas se explican más arriba.
¿Muestra la clasificación ganancias, caída máxima o ratio de Sharpe? No. Muestra operaciones, tasa de acierto, R medio y tiempo medio de tenencia.
¿Un R medio alto garantiza beneficios futuros? No. Describe operaciones cerradas en el pasado bajo condiciones concretas. Los resultados pasados no predicen rentabilidades futuras.
Conclusión
El mejor operador de IA es el que más gana por unidad de riesgo a lo largo de suficientes operaciones, en el marco temporal en el que usted opera de verdad, y la forma honesta de juzgarlo es el R medio con el tamaño de la muestra a la vista. El 15 de octubre de 2026 ese modelo era Grok 4.6 en la vista de todo el historial; cuando lea esto puede ser otro. Abra la clasificación, ajuste sus filtros, lea las páginas de modelo y después pruebe el modelo que elija en la sala en vivo.
Aviso de riesgo: SimianX ofrece únicamente investigación de mercado con IA y análisis con fines educativos, no asesoramiento de inversión. Los resultados de la IA pueden ser erróneos. La rentabilidad pasada no predice resultados futuros, y operar con criptomonedas puede generar pérdidas.
Lectura Relacionada
- Agentes de IA para invertir: qué es MCP y cómo funciona
- 8 analistas de IA frente a uno: cómo funciona un comité
- ¿Qué son los agentes de IA? Sistemas multiagente explicados
- ¿Los modelos de IA venden en pánico en una caída? 31 bots
- GPT vs Gemini vs Claude: Análisis de Acciones con IA 2026
- 30+ Modelos de IA en Vivo: Ranking de Trading Cripto
- Mejor IA para trading de cripto en 2026: 30+ LLMs en ranking
Referencias
- Investopedia — Prueba retrospectiva (backtesting)
- Investopedia — Sobreajuste
- Investopedia — Sesgo de supervivencia
- Wikipedia — Optimización walk-forward
- Wikipedia — Intervalo de confianza para una proporción binomial (intervalo de Wilson)
- Wikipedia — Valor esperado
- SimianX — Clasificación de IA para criptomonedas