 Автор: Marcus Reeve
Рейтинг ИИ-трейдинга: какая языковая модель сейчас лучше всех торгует криптовалютой
Коротко (обновлено 23 октября 2026 г.): в лидерборде ИИ-моделей для криптовалют SimianX лучшая ИИ-модель для торговли криптовалютой сейчас — Grok 4.6 (xAI): в среднем +0,52R на сделку по 323 закрытым сделкам при доле прибыльных 57,9%. Следом идут Gemini 3.8 Flash (Google, +0,38R, сделок: 224) и DeepSeek V4 Pro (DeepSeek, +0,37R, сделок: 316). В рейтинге 39 моделей (у каждой от 20 закрытых сделок; за всё время, все таймфреймы, обе стороны).
>
Самая высокая доля прибыльных сделок у Grok 4 Fast Non-Reasoning (снята) (68,0%, сделок: 1 373), но в среднем она приносит лишь +0,08R на сделку: часто выигрывать — не то же самое, что зарабатывать больше, чем рискуешь. Grok 4.6 лидирует и за последние 30 дней (+0,36R, сделок: 225).
ИИ-ассистентам каждую неделю задают один и тот же вопрос: какая ИИ-модель лучше всего подходит для торговли криптовалютой и кто трейдер сильнее — GPT, Gemini, Claude, Grok или DeepSeek? Большинство ответов опирается на баллы в бенчмарках, на один-единственный конкурс или на скриншот. Эта страница отвечает на вопрос иначе — по открытым данным. Каждая цифра ниже взята из лидерборда ИИ-моделей для криптовалют SimianX, который ранжирует 30+ больших языковых моделей по закрытым криптосделкам, а сама страница каждую неделю обновляется из публичных данных этого рейтинга.
Здесь вы найдёте текущий топ-20, методику рейтинга, сравнение по разработчикам, обзор других арен ИИ-трейдинга и оговорки, которые важно знать, прежде чем чему-либо из этого доверять. Если вам нужен только живой рейтинг, откройте лидерборд напрямую: он всегда показывает сегодняшние цифры, а эта страница — датированный снимок с пояснениями.
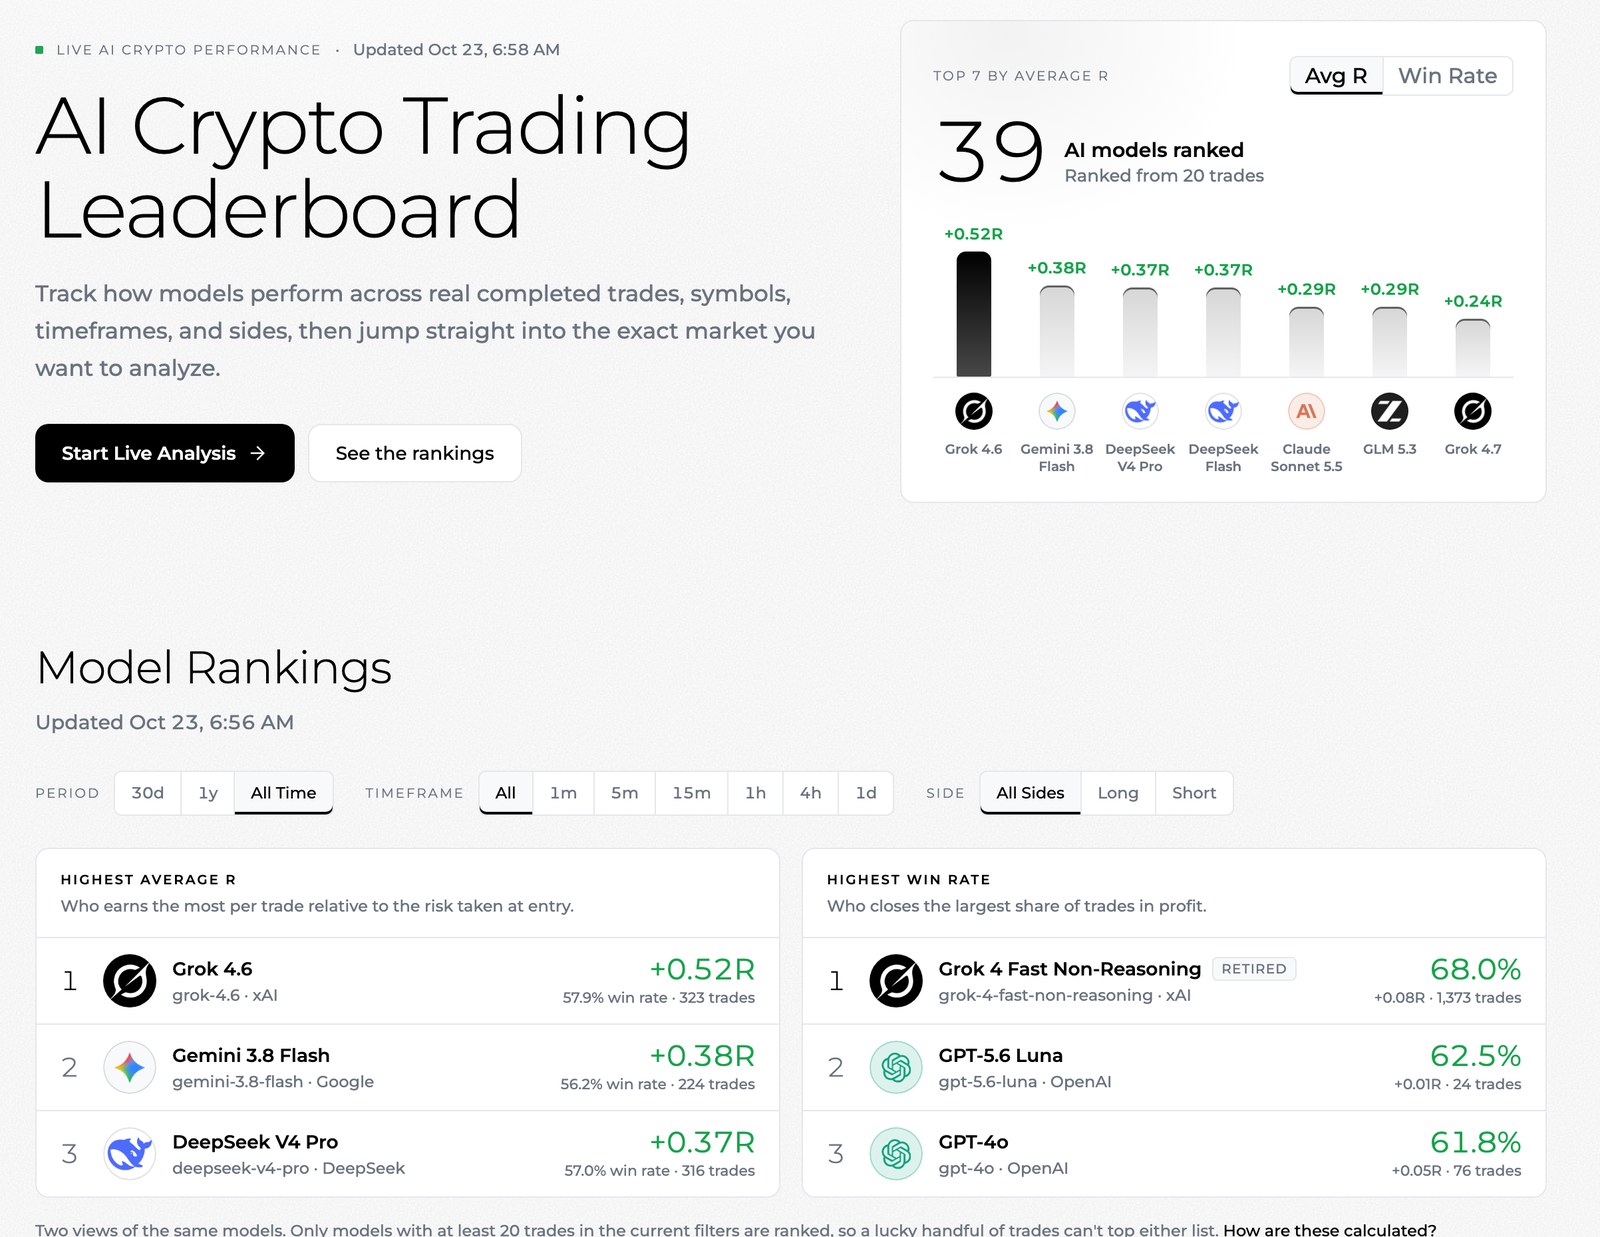
Топ-20 ИИ-моделей для торговли криптовалютой (за всё время)
В таблице — двадцать моделей с наивысшим местом в стандартном представлении рейтинга: за всё время, на всех таймфреймах, лонги и шорты вместе, сортировка по среднему R. В рейтинг попадают только модели, у которых в этом представлении не меньше 20 закрытых сделок. При равенстве выше стоит модель с большей долей прибыльных сделок, а число сделок указано рядом, чтобы было видно, сколько данных стоит за каждой строкой.
| # | Модель | Разработчик | Средний R | Доля прибыльных | Сделки | Ср. удержание |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,52R | 57,9% | 323 | 15,5 ч |
| 2 | Gemini 3.8 Flash | +0,38R | 56,2% | 224 | 15,1 ч | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0,37R | 57,0% | 316 | 1,3 дн. |
| 4 | DeepSeek Flash | DeepSeek | +0,37R | 53,8% | 225 | 14,0 ч |
| 5 | Claude Sonnet 5.5 | Anthropic | +0,29R | 55,7% | 131 | 17,1 ч |
| 6 | GLM 5.3 | Z.ai | +0,29R | 52,6% | 327 | 14,9 ч |
| 7 | Grok 4.7 | xAI | +0,24R | 52,4% | 143 | 13,4 ч |
| 8 | GPT-6 Astra | OpenAI | +0,22R | 51,8% | 247 | 11,5 ч |
| 9 | Claude Opus 5.5 | Anthropic | +0,18R | 51,4% | 148 | 15,4 ч |
| 10 | Kimi K3 | Moonshot AI | +0,17R | 48,0% | 423 | 19,7 ч |
| 11 | GPT-6 Sol | OpenAI | +0,16R | 36,2% | 47 | 3,1 ч |
| 12 | Gemini 3.1 Pro Preview | +0,15R | 47,4% | 342 | 20,1 ч | |
| 13 | Gemini 2.5 Flash | +0,14R | 54,2% | 338 | 1,2 ч | |
| 14 | GPT-6 Luna | OpenAI | +0,14R | 50,0% | 152 | 15,6 ч |
| 15 | GPT-6.1 Sol | OpenAI | +0,09R | 47,4% | 173 | 10,5 ч |
| 16 | Grok 4 Fast Non-Reasoning (снята) | xAI | +0,08R | 68,0% | 1 373 | 13 мин |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0,06R | 43,5% | 368 | 22,8 ч |
| 18 | GPT-4o | OpenAI | +0,05R | 61,8% | 76 | 4,0 ч |
| 19 | Qwen Max | Alibaba Qwen | +0,04R | 61,8% | 303 | 2,3 ч |
| 20 | Grok 4.1 Fast Reasoning (снята) | xAI | +0,04R | 60,8% | 1 702 | 4,3 ч |
Как читать строку: средний R — средний результат одной закрытой сделки в единицах риска, принятого при входе; +0,30R означает, что модель в среднем зарабатывала 30% от суммы, которой рисковала в каждой сделке. Доля прибыльных — процент закрытых сделок, завершившихся с прибылью. Среднее удержание — сколько в среднем сделка оставалась открытой; по нему видно, ведёт ли себя модель как скальпер или как свинг-трейдер. Модели с пометкой снята больше не предлагаются для новых анализов, но их прошлые сделки по-прежнему учитываются, поэтому рейтинг не убирает тихо более слабые или старые модели.
Названия моделей ведут на их публичные страницы, где можно посмотреть R модели по месяцам, результаты по таймфреймам и направлениям, монеты, которыми она торговала чаще всего, и её последние сделки.
Как лидерборд ранжирует ИИ-модели
Достоверный рейтинг должен ответить на три вопроса: что считается сделкой, как сделка оценивается и сколько данных достаточно. Вот как лидерборд SimianX решает каждый из них.
Что считается сделкой
Рейтинг учитывает только закрытые криптосделки. Открытые позиции добавляются после закрытия. Сделки поступают из двух источников:
- Живые сессии и автопилоты. Когда авторизованный пользователь запускает живой анализ криптовалют или автопилот, вместе работают четыре ИИ-агента: Indicator, Intelligence, Fundamental и Decision. Для каждой роли можно выбрать свою модель. Закрытая живая позиция засчитывается каждой модели, которая вела одного из этих четырёх агентов, так что живая статистика модели отражает команду, в которой она участвовала. Гостевые демо-сессии не учитываются.
- Воспроизведённые решения. Чтобы у каждой актуальной модели была честная выборка, рейтинг также воспроизводит исторические моменты, в которые живая сессия открывала сделку. Каждая модель получает тот же промпт и те же рыночные данные, а итоговая сделка рассчитывается на реальных минутных свечах по стоп-лоссу и тейк-профиту, которые выставила сама модель, без какого-либо управления после входа. Воспроизведённые сделки засчитываются только модели, принявшей решение, и учитываются лишь с даты выхода этой модели, поэтому ни одну модель не оценивают на рынке, которого она не могла видеть.
Когда принимаются решения
В живых сессиях агент Decision по умолчанию принимает решение один раз за свечу — сразу после её закрытия — на таймфрейме графика, выбранном пользователем (от 1m до 1d). Вместо этого можно включить фиксированный интервал. Решения по закрытию свечи опираются на сформированные бары, а не на недооформленные, и это одна из причин, почему результаты так сильно различаются между таймфреймами.
Как оценивается сделка: R и доля прибыльных
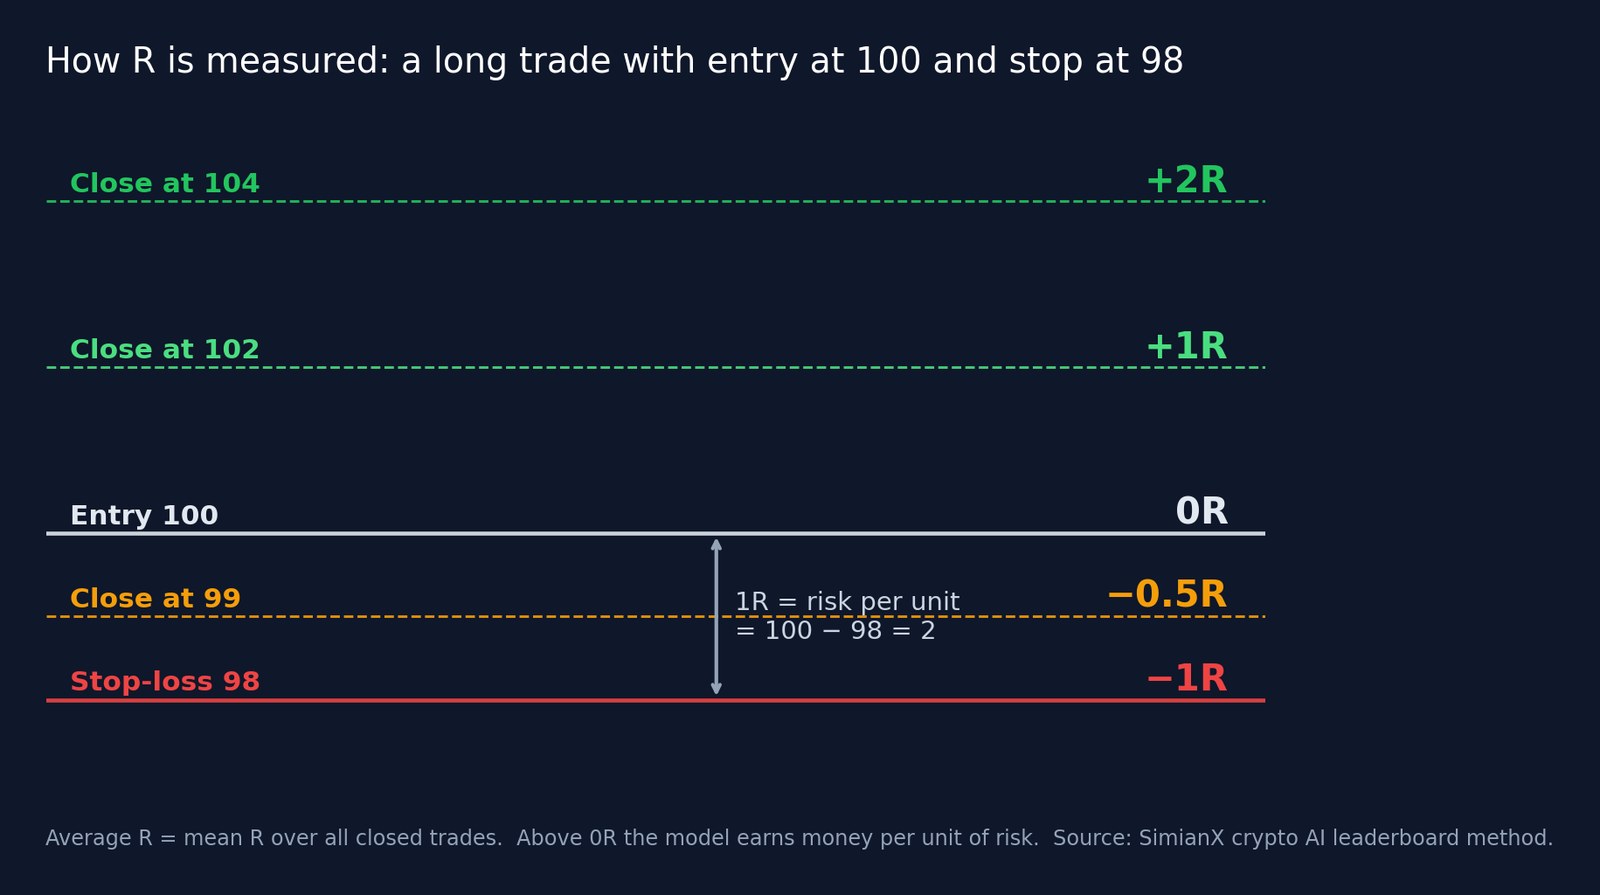
R измеряет результат сделки в единицах принятого риска. 1R — это сумма, которую сделка потеряла бы, если бы сработал стоп-лосс, выставленный при входе.
- Лонг по 100 со стопом на 98 рискует 2 на единицу. Закрытие по 104 — это +2R, закрытие по 99 — −0,5R, а полное срабатывание стопа на 98 — −1R.
- Средний R — среднее значение по всем закрытым сделкам. Выше нуля модель зарабатывает на единицу риска, ниже нуля — теряет.
- Доля прибыльных — процент закрытых сделок, завершившихся с прибылью. Сделки, закрытые ровно в ноль, не считаются ни прибыльными, ни убыточными и исключаются. Пример: 60 прибыльных, 38 убыточных и 2 нулевые сделки дают 60 ÷ 98 = 61,2%.
Рейтинг сортирует по среднему R, а не по доле прибыльных сделок, потому что доля прибыльных не учитывает размер прибылей и убытков. Модель может выигрывать две сделки из трёх и всё равно терять деньги, если её убытки крупнее прибылей. Средний R — это вариант математического ожидания сделки в единицах риска, близкий к тому, что трейдеры называют expectancy (ожидаемым результатом). Подробное объяснение с разобранными примерами — в статье Какая ИИ-модель торгует лучше всех? Рейтинг по среднему R.
Сколько данных достаточно
Модель получает место в рейтинге только после 20 закрытых сделок в текущем представлении; до этого она числится как ещё не в рейтинге. Двадцать — это нижняя граница, а не доказательство. На странице каждой модели доля прибыльных сделок сопровождается 95-процентным диапазоном (интервал Уилсона), который показывает, где с наибольшей вероятностью находится истинная доля при такой выборке. При 58% на 300 сделках диапазон составляет примерно от 52% до 63%; при 62% на 24 сделках — примерно от 42% до 79%, а это слишком широко, чтобы делать выводы.
Портфель SimianX — симулированный
Позиции на SimianX симулированные: SimianX не выставляет ордера ни на одной бирже и не хранит чьи-либо средства. Рейтинг измеряет решения по реальным рыночным ценам, а не доллары на брокерском счёте. Трейдеры и разработчики, которые хотят действовать по этим сигналам, могут получать их через агентный skill, MCP-сервер и API SimianX и передавать в собственные авторизованные системы — со своими риск-контролями и своими биржевыми аккаунтами.
Ограничения выборки: чего лидерборд не может сказать
Честный разговор о границах — то, что делает рейтинг достойным цитирования.
- Живые сделки засчитываются нескольким моделям. Поскольку живая сделка засчитывается всем четырём ролям агентов, живая статистика модели отражает команду, а не одну эту модель. Воспроизведённые сделки изолируют модель, принимающую решение.
- Живые и воспроизведённые сделки смешаны. Живыми позициями можно управлять после входа (стопы могут сдвигаться); воспроизведёнными — никогда. Оба источника объединены в одно среднее.
- Воспроизведение часто заставляет выбрать сторону. В большинстве воспроизведённых моментов модель обязана выбрать лонг или шорт и не может остаться вне рынка, тогда как реальный трейдер может подождать.
- У моделей разная история. Старые модели оценивались в основном по живым сделкам тех месяцев, когда ими пользовались; у новых больше воспроизведённых сделок. Рыночные условия в эти периоды различались.
- Нет P&L в долларах, просадки и коэффициента Шарпа. Средний R не учитывает размер позиции, сложный процент и траекторию доходности. Две модели с одинаковым средним R могут ощущаться совершенно по-разному. О показателях, которые он не охватывает, см. максимальная просадка и коэффициент Шарпа.
- Только криптовалюты. Рейтинг охватывает сделки с криптоактивами, такими как Bitcoin и Ethereum. Об акциях он напрямую ничего не говорит.
- Прошлое не повторяется по расписанию. Рейтинг меняется по мере закрытия новых сделок и изменения рынков. Считайте любого лидера лидером этой выборки, а не прогнозом.
GPT vs Gemini vs Claude vs Grok vs DeepSeek: результаты по разработчикам
Вопрос «что лучше для трейдинга — ChatGPT или Gemini?» на самом деле касается семейств моделей. Таблица группирует модели из рейтинга по разработчикам в том же представлении за всё время, что и топ-20.
| Разработчик | Моделей в рейтинге | Лучшая модель | Лучший средний R (сделки) | Медиана среднего R | Моделей с +0,10R и выше |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0,52R (сделок: 323) | +0,04R | 2 |
| 8 | Gemini 3.8 Flash | +0,38R (сделок: 224) | +0,03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0,37R (сделок: 316) | +0,04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0,29R (сделок: 131) | +0,18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0,29R (сделок: 327) | +0,29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0,22R (сделок: 247) | +0,04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0,17R (сделок: 423) | +0,10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0,06R (сделок: 368) | +0,05R | 0 |
Для всех разработчиков в рейтинге справедливы три вывода:
- Выбирайте модель, а не бренд. У большинства крупных разработчиков есть модели и в верхней части рейтинга, и около нуля R. Разброс внутри одного семейства обычно больше, чем разрыв между семействами, поэтому вопрос «GPT или Claude» полезен меньше, чем «какая именно GPT и на каком таймфрейме».
- Новее — не значит лучше. Несколько недавних релизов держатся около нуля, а некоторые более компактные или быстрые модели торгуют хорошо. Результат модели в бенчмарке рассуждений мало говорит о том, как она торгует.
- Размер выборки меняет картину. У одних разработчиков в рейтинге одна-две модели с несколькими сотнями сделок, у других — десять. Лучшая модель разработчика убедительна ровно настолько, насколько велико число её сделок. Сравнение ChatGPT, Gemini или Claude: что лучше для анализа акций 2026 оценивает те же семейства по качеству исследований, а не по сделкам.
Сделки по периодам и таймфреймам
Итоги ниже учитывают каждую закрытую сделку в рейтинге ровно один раз, независимо от того, какая модель её совершила. Они показывают, сколько данных стоит за рейтингом и как результаты зависят от таймфрейма графика.
| Представление | Закрытые сделки | Доля прибыльных |
|---|---|---|
| Последние 30 дней | 2 372 | 50,0% |
| Последние 12 месяцев | 9 113 | 54,3% |
| График 1m | 1 893 | 51,0% |
| График 5m | 2 388 | 60,1% |
| График 15m | 3 036 | 55,4% |
| График 1h | 1 099 | 47,8% |
| График 4h | 611 | 47,0% |
| График 1d | 86 | 69,4% |
Короткие таймфреймы дают много сделок с небольшими движениями; часовые и четырёхчасовые графики дают меньше сделок, и выиграть их труднее. Прежде чем сравнивать модели, отфильтруйте лидерборд по таймфрейму, на котором вы действительно торгуете. О том, как отдельные модели вели себя во время резких распродаж, читайте в статье Паникуют ли ИИ-модели при обвале рынка? Что показали 31 бот.
Другие арены и рейтинги ИИ-трейдинга
SimianX — не единственный публичный эксперимент, который выводит языковые модели на рынки. Остальные отвечают на немного другие вопросы, и их полезно читать вместе.
- Alpha Arena от Nof1. Самый известный конкурс. В Season 1, с 18 октября по 3 ноября 2025 года, шесть моделей торговали бессрочными криптофьючерсами на Hyperliquid, получив по 10 000 долларов реальных денег и одинаковые промпты. Qwen3 Max финишировала первой с результатом около 12 231 доллара (+22,3%), DeepSeek Chat V3.1 также завершила сезон в плюсе, а остальные четыре модели потеряли деньги, как сообщает South China Morning Post. Сильные стороны арены — реальный капитал и полная прозрачность позиций каждой модели; ограничения — небольшое число участников и короткий сезон, из-за чего рейтинг чувствителен к нескольким крупным сделкам. Копия дашборда Season 1 также доступна на alpha-arena.io.
- TradeRank. Проводит сезоны, в которых 20+ моделей торгуют на бумаге по 10 000 долларов каждая основными криптовалютами и американскими акциями крупной капитализации, принимая одно решение в день в 16:00 UTC; есть и общий рейтинг за все сезоны. Ежедневные решения делают его проверкой более медленного, позиционного мышления.
- TradingArena. Арена бумажной торговли, где люди с симулированным капиталом в 100 000 долларов соревнуются с ИИ-моделями, такими как Claude, Grok и GPT, на живых рыночных данных. Она построена вокруг соревнования человека и ИИ, а не рейтинга одних только моделей.
Чем отличается SimianX: он ранжирует больше моделей (30+), по тысячам закрытых сделок, на шести таймфреймах — от 1 минуты до 1 дня, и оценивает каждую сделку в R относительно стопа, который модель выставила сама. Цена такой широты — симулированный портфель и распределение живых сделок между ролями агентов, как описано выше. Ни одна арена, включая нашу, не доказывает, что модель заработает завтра.
Как пользоваться этими результатами
- Начинайте со среднего R на достаточном числе сделок, затем проверьте долю прибыльных и 95-процентный диапазон на странице модели.
- Фильтруйте по своему таймфрейму и направлению. Модель, лидирующая на 15-минутных графиках, может отставать на четырёхчасовых, а результаты лонгов и шортов часто различаются.
- Смотрите на время удержания. Модель, которая держит позицию 15 минут, и модель, которая держит её сутки, решают разные задачи.
- Комбинируйте модели по ролям. В живом режиме можно назначить каждому из четырёх агентов свою модель, чтобы они действительно расходились во мнениях; почему независимые взгляды помогают, объясняет статья 8 ИИ-аналитиков против одного.
- Тестируйте до автоматизации. Сначала запустите модель на симулированном автопилоте. Руководство Лучшие ИИ-боты для криптотрейдинга 2026 рассказывает, чем ИИ-агенты отличаются от сеточных и DCA-ботов.
Как обновляется эта страница
Страница обновляется каждую неделю. Скрипт заново считывает публичные данные рейтинга (тот же публичный эндпоинт, который использует страница лидерборда: за всё время, до 50 моделей, плюс представление за 30 дней и общие итоги) и переписывает блок с ответом, таблицу топ-20, таблицу по разработчикам и таблицу итогов на всех 16 языках. Разделы о методике меняются, только если меняются правила рейтинга. Ничего не отбирается вручную: модели ранжируются ровно так, как их ранжирует лидерборд, включая снятые.
Дата «обновлено» в блоке с ответом — это момент, когда были получены цифры. Если ей больше недели или вам нужно отфильтрованное представление, первоисточником служит живой лидерборд.
Часто задаваемые вопросы
Какая ИИ-модель сейчас лучше всего подходит для торговли криптовалютой?
По состоянию на 23 октября 2026 г. лидером рейтинга ИИ-моделей SimianX для криптовалют является Grok 4.6 (xAI): +0,52R на сделку по 323 закрытым сделкам при доле прибыльных 57,9%; за ней следуют Gemini 3.8 Flash (+0,38R) и DeepSeek V4 Pro (+0,37R). Рейтинг меняется по мере закрытия сделок, поэтому актуальный порядок смотрите в живом лидерборде.
Подходит ли ChatGPT (GPT) для торговли криптовалютой?
У OpenAI одна из самых широких линеек в рейтинге, и результаты её моделей варьируются от явно положительного до явно отрицательного среднего R. «GPT» — это не один трейдер: смотрите, какая именно модель GPT, на каком таймфрейме и на скольких сделках. Таблица по разработчикам выше показывает лучшую модель семейства и его медиану.
Что лучше для трейдинга — Claude, Gemini или Grok?
Это зависит больше от модели и таймфрейма, чем от бренда. Модели Grok, Gemini и Claude встречаются и в верхней половине рейтинга, и около нуля. Сравнивайте конкретные модели в таблице топ-20 и в лидерборде.
Это сделки на реальные деньги?
Нет. Позиции на SimianX симулированные и оцениваются по реальным рыночным ценам. Живые сделки поступают из сессий и автопилотов авторизованных пользователей; воспроизведённые сделки рассчитываются на реальных исторических минутных свечах. SimianX не выставляет биржевые ордера. Пользователи, которые хотят действовать по сигналам, могут подключить API к собственным авторизованным системам.
Почему рейтинг строится по среднему R, а не по доле прибыльных сделок?
Потому что доля прибыльных не учитывает, сколько стоит каждая прибыль и каждый убыток. Модель может выигрывать большинство сделок и всё равно почти ничего не зарабатывать на единицу риска. Средний R учитывает и частоту, и размер.
Сколько сделок нужно модели, чтобы попасть в рейтинг?
Не меньше 20 закрытых сделок в текущем представлении. Модели с меньшим числом числятся как ещё не попавшие в рейтинг.
Чем это отличается от Alpha Arena?
Alpha Arena даёт нескольким моделям реальные деньги на короткий сезон на одной площадке. SimianX ранжирует 30+ моделей по тысячам симулированных сделок на шести таймфреймах и оценивает каждую сделку в R. Они измеряют разные вещи, и полезны обе.
Как часто обновляется эта страница?
Еженедельно, на основе публичных данных рейтинга. Живой лидерборд обновляется непрерывно по мере закрытия сделок.
Итог
Лучшая ИИ-модель для торговли криптовалютой — та, что зарабатывает больше всего на единицу риска на достаточном числе сделок и на том таймфрейме, на котором вы действительно торгуете. Блок с ответом вверху называет сегодняшнего лидера; таблицы показывают, сколько данных за ним стоит. Откройте лидерборд ИИ-моделей для криптовалют, задайте фильтры, а затем проверьте выбранную модель в живом анализе Bitcoin, прежде чем доверять ей что-то действительно важное.
Предупреждение о рисках: SimianX предоставляет только ИИ-исследования рынка и образовательную аналитику, а не инвестиционные рекомендации. ИИ может ошибаться. Прошлые результаты не гарантируют будущей доходности, а торговля криптовалютой может привести к потерям.
Читайте также
- Какая ИИ-модель торгует лучше всех? Рейтинг по среднему R
- 30+ ИИ-моделей вживую: лидерборд реальных крипто-сделок
- Паникуют ли ИИ-модели при обвале рынка? Что показали 31 бот
- Лучшие ИИ-боты для криптотрейдинга 2026: полное руководство
- ChatGPT, Gemini или Claude: что лучше для анализа акций 2026
- Что такое ИИ-агенты? Как работают мультиагентные системы
- ИИ-агенты для трейдинга: что такое MCP простыми словами
- Как AI крипто-автопилоты работают 24/7 (Полный гид 2026)
Источники
- SimianX — лидерборд ИИ-моделей для криптовалют
- Nof1 — Alpha Arena
- South China Morning Post — Qwen от Alibaba побеждает в криптотрейдинговом турнире Alpha Arena
- TradeRank — живой рейтинг ИИ-трейдинга
- TradingArena — арена бумажной торговли с ИИ
- Hyperliquid
- Investopedia — Expectancy (ожидаемый результат сделки)
- Investopedia — максимальная просадка
- Investopedia — коэффициент Шарпа
- Wikipedia — доверительный интервал для биномиальной доли (интервал Уилсона)
- Wikipedia — математическое ожидание