ИИ-агенты простыми словами: от одной модели в цикле до команды специалистов
ИИ-агент — это программная система, которая с помощью модели искусственного интеллекта самостоятельно добивается цели: она оценивает ситуацию, выбирает следующий шаг, действует через инструменты вроде веб-поиска, кода или API и проверяет результат, прежде чем продолжить. Мультиагентная система распределяет ту же работу между несколькими специализированными агентами: они делятся находками, спорят там, где расходятся во мнениях, и передают общий ответ одному агенту, который принимает окончательное решение.
Это определение из двух предложений охватывает почти всё, что означает термин в 2026 году, — от помощников-программистов, исправляющих ошибки во всём репозитории кода, до исследовательских инструментов, которые прочитывают сотни страниц, прежде чем написать отчёт. Но оно же скрывает самое трудное. Агенты стоят дороже, чем ответ в чате, работают дольше, а маленькая ошибка в начале длинной задачи может незаметно испортить весь результат.
В SimianX мы каждый день создаём мультиагентные системы и работаем с ними. Четыре агента анализируют акцию или криптовалютную пару в реальном времени в нашем разделе живого анализа, комитет из восьми агентов обсуждает одну акцию или монету в углублённом исследовании, а открытый криптовалютный рейтинг оценивает более 30 ИИ-моделей по каждой закрытой ими сделке. В этом руководстве мы разбираем эту систему как наглядный пример, а также нейтрально описываем продукты и исследования, которые определяют развитие агентов.
Главное
- Агент — это модель плюс инструменты, память и цикл, которым управляет сама модель. Если каждый шаг жёстко задан в коде, это рабочий процесс, а не агент.
- Мультиагентные системы полезны, когда задача делится на независимые части или когда нужны точки зрения, которые должны сложиться до того, как кто-то сверит записи. Кроме того, они расходуют гораздо больше токенов.
- Большинство сбоев агентов вызвано накоплением ошибок, ненадёжными инструментами, слабой оценкой качества и неконтролируемыми расходами, а не тем, что модель «недостаточно умна».
- Оценивайте агента по повторяющимся результатам на ваших собственных задачах: доле успешных выполнений, стабильности от запуска к запуску, стоимости одной завершённой задачи и полному журналу его действий.
Что такое ИИ-агент? Рабочее определение
Сама идея старше больших языковых моделей. Стандартный учебник по искусственному интеллекту — Artificial Intelligence: A Modern Approach Стюарта Рассела и Питера Норвига — определяет агента как всё, что воспринимает среду через датчики и воздействует на неё через исполнительные механизмы. Под это определение подходит термостат. И шахматная программа тоже.
После 2022 года изменилось то, что «мыслящим ядром» теперь может служить языковая модель. Вместо того чтобы следовать правилам, написанным вручную, модель читает описание ситуации на обычном языке, составляет план и выбирает, какой инструмент вызвать дальше. Широко цитируемое руководство Anthropic Building Effective Agents проводит границу, которой сегодня пользуется большинство инженеров: рабочие процессы — это системы, где модели и инструменты связаны заранее заданными путями в коде, а агенты — системы, где модель сама динамически управляет своим процессом и использованием инструментов.
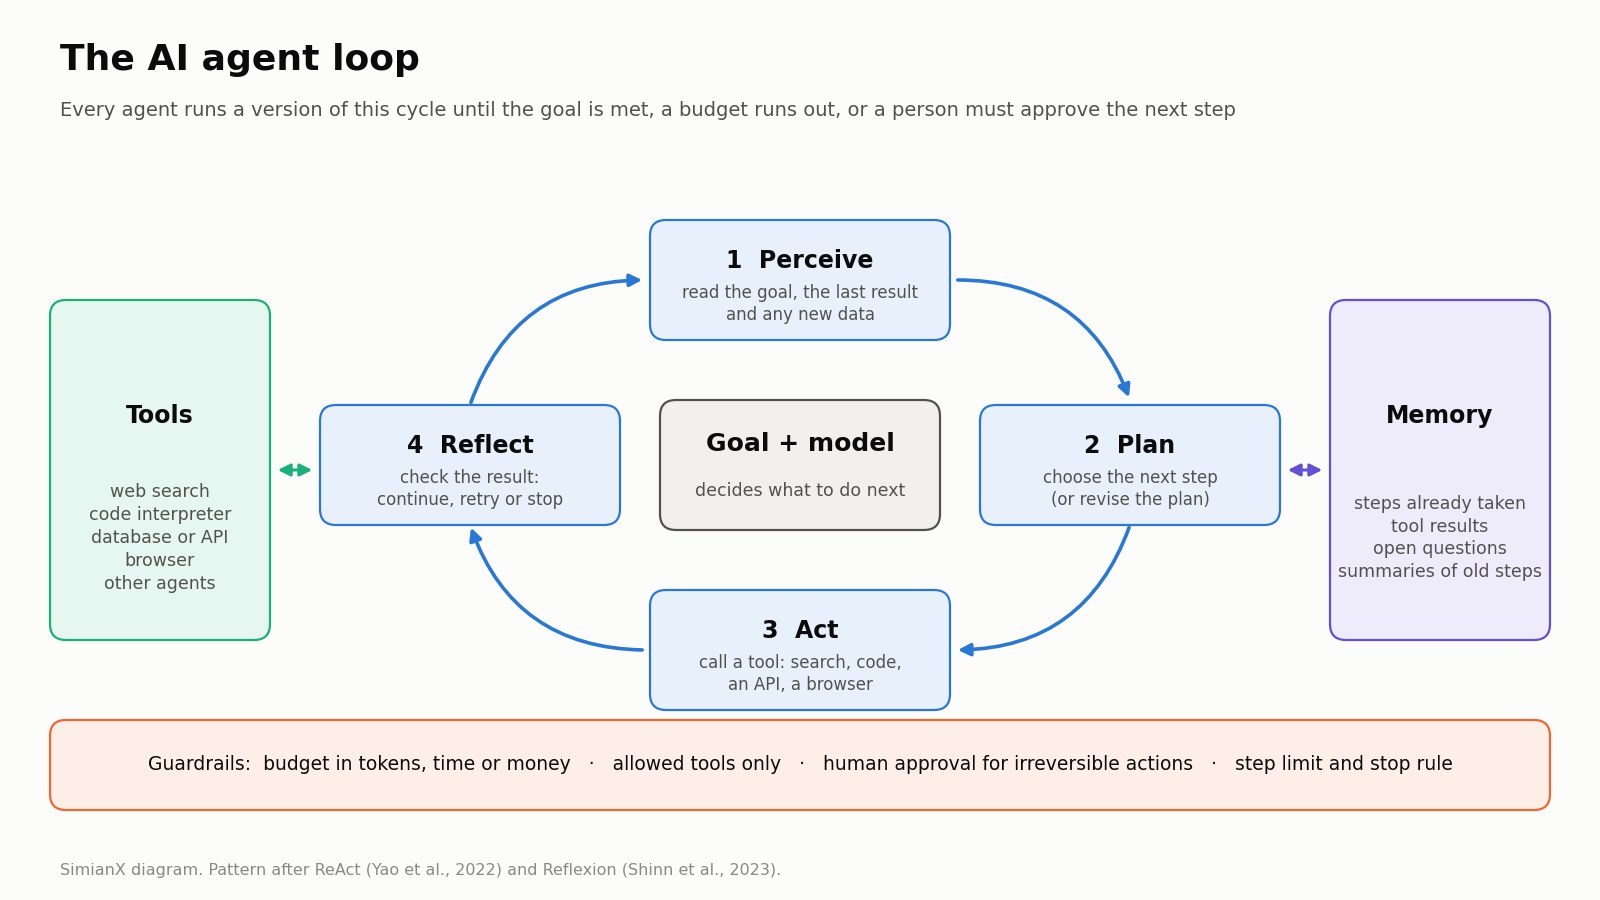
На практике современный ИИ-агент состоит из пяти частей:
- Цель. «Исправь этот падающий тест», «кратко изложи, что сегодня двигало акции Nvidia», «реши, открывать ли позицию на этой 15-минутной свече».
- Модель, которая рассуждает о цели и текущем состоянии.
- Инструменты, которые она может вызывать: поиск, интерпретатор кода, запрос к базе данных, API рыночных данных, браузер.
- Память или состояние: что уже было опробовано, что вернули инструменты и что пока неизвестно.
- Цикл с правилом остановки: агент продолжает работу, пока цель не достигнута, бюджет не исчерпан или человеку не нужно одобрить следующий шаг.
Уберите цикл — и получите чат-бота. Зафиксируйте каждый шаг заранее — и получите рабочий процесс. Агентом систему делает именно цикл, которым управляет сама модель.
ИИ-агент, чат-бот и рабочий процесс: в чём разница
Эти три понятия постоянно путают, отчасти потому, что слово «агент» хорошо продаётся. У Gartner даже есть название для практики выдавать чат-боты и роботизированную автоматизацию процессов за агентов — «агентское отмывание» (agent washing), — и в оценке от июня 2025 года компания писала, что лишь около 130 из тысяч поставщиков агентного ИИ предлагают настоящие агенты. Эта таблица — самый быстрый способ отличить одно от другого.
| Чат-бот | Рабочий процесс (конвейер) | ИИ-агент | |
|---|---|---|---|
| Кто выбирает следующий шаг | Пользователь, по одному сообщению | Разработчик, в заранее написанном коде | Модель, во время работы |
| Использует инструменты | Иногда, один вызов на ответ | Да, в фиксированном порядке | Да, выбирает и повторяет по мере необходимости |
| Продолжает работу без нового запроса | Нет | Да, по фиксированному маршруту | Да, пока не достигнута цель или не исчерпан бюджет |
| Типичный результат | Ответ | Предсказуемый результат известного процесса | Выполненная задача: изменение кода, отчёт, решение |
| Стоимость и скорость | Дёшево, секунды | От дешёвого до умеренного, предсказуемо | Дороже и непредсказуемо, от секунд до часов |
| Типичный сбой | Неверный ответ, который сразу видно | Ломается на входных данных, которые никто не предусмотрел | Уходит в сторону, зацикливается или строит работу на мелкой ранней ошибке |
| Лучше всего подходит для | Вопросов и черновиков | Повторяющихся процессов с известными шагами | Открытых задач, путь решения которых нельзя прописать заранее |
Полезное правило из того же руководства Anthropic: начинайте с самого простого рабочего варианта и добавляйте автономию, только когда она явно улучшает результат. Многие задачи, которые продают под видом агентов, лучше, дешевле и безопаснее решаются рабочими процессами.
Как работают ИИ-агенты: цикл «восприятие — план — действие — рефлексия»
Любой агент, как бы его ни называли в рекламе, проходит ту или иную версию одного и того же цикла.
Восприятие
Агент собирает сведения о текущей ситуации: цель пользователя, результат своего последнего действия, содержимое файла, страницу результатов поиска, последнюю свечу на графике. Всё, что он знает, должно поместиться в контекстное окно модели, поэтому хорошие агенты избирательны. Они сжимают старые шаги в краткие сводки, сохраняют исходные данные, которые понадобятся снова, и отбрасывают остальное.
Планирование
Модель решает, что делать дальше. Иногда это полный план, написанный заранее; чаще — один следующий шаг, выбранный после того, как стал известен последний результат. Влиятельная статья ReAct (Yao et al., 2022) показала, что чередование коротких заметок-рассуждений с действиями позволяет модели собирать информацию и корректировать курс, и этот подход превзошёл на ряде задач базовые варианты, которые только действуют или только рассуждают. Большинство агентных фреймворков до сих пор следуют этой схеме.
Действие
Агент вызывает инструмент. Современные модели формируют структурированный запрос, например «найди X» или «выполни этот запрос с такими параметрами», а окружающее программное обеспечение исполняет его и возвращает результат. Для этой «сантехники» уже появились стандарты. Model Context Protocol (MCP), представленный Anthropic в ноябре 2024 года и в декабре 2025 года переданный фонду Agentic AI Foundation при Linux Foundation, определяет, как агент подключается к инструментам и источникам данных. Протокол Agent2Agent (A2A) от Google, теперь тоже проект Linux Foundation, описывает, как общаются между собой агенты разных разработчиков.
Рефлексия
Агент сверяет результат с целью. Тест прошёл? Совпадает ли число со вторым источником? Разумен ли ещё план? Исследования вроде Reflexion (Shinn et al., 2023) показали, что если позволить агенту записать, что пошло не так, и попробовать снова, результаты в задачах на программирование и рассуждение улучшаются. На этапе рефлексии агент должен и решать, когда остановиться: потому что цель достигнута, потому что он застрял или потому что человеку нужно одобрить рискованное действие.
Вокруг цикла стоят ограничители: бюджет в токенах, времени или деньгах, список разрешённых агенту инструментов и точки, где человек должен сказать «да». В торговле это как минимум лимит на размер позиции, стоп-лосс на каждой сделке и чёткая граница между виртуальной (бумажной) торговлей и реальными деньгами.
Один агент или мультиагентная система
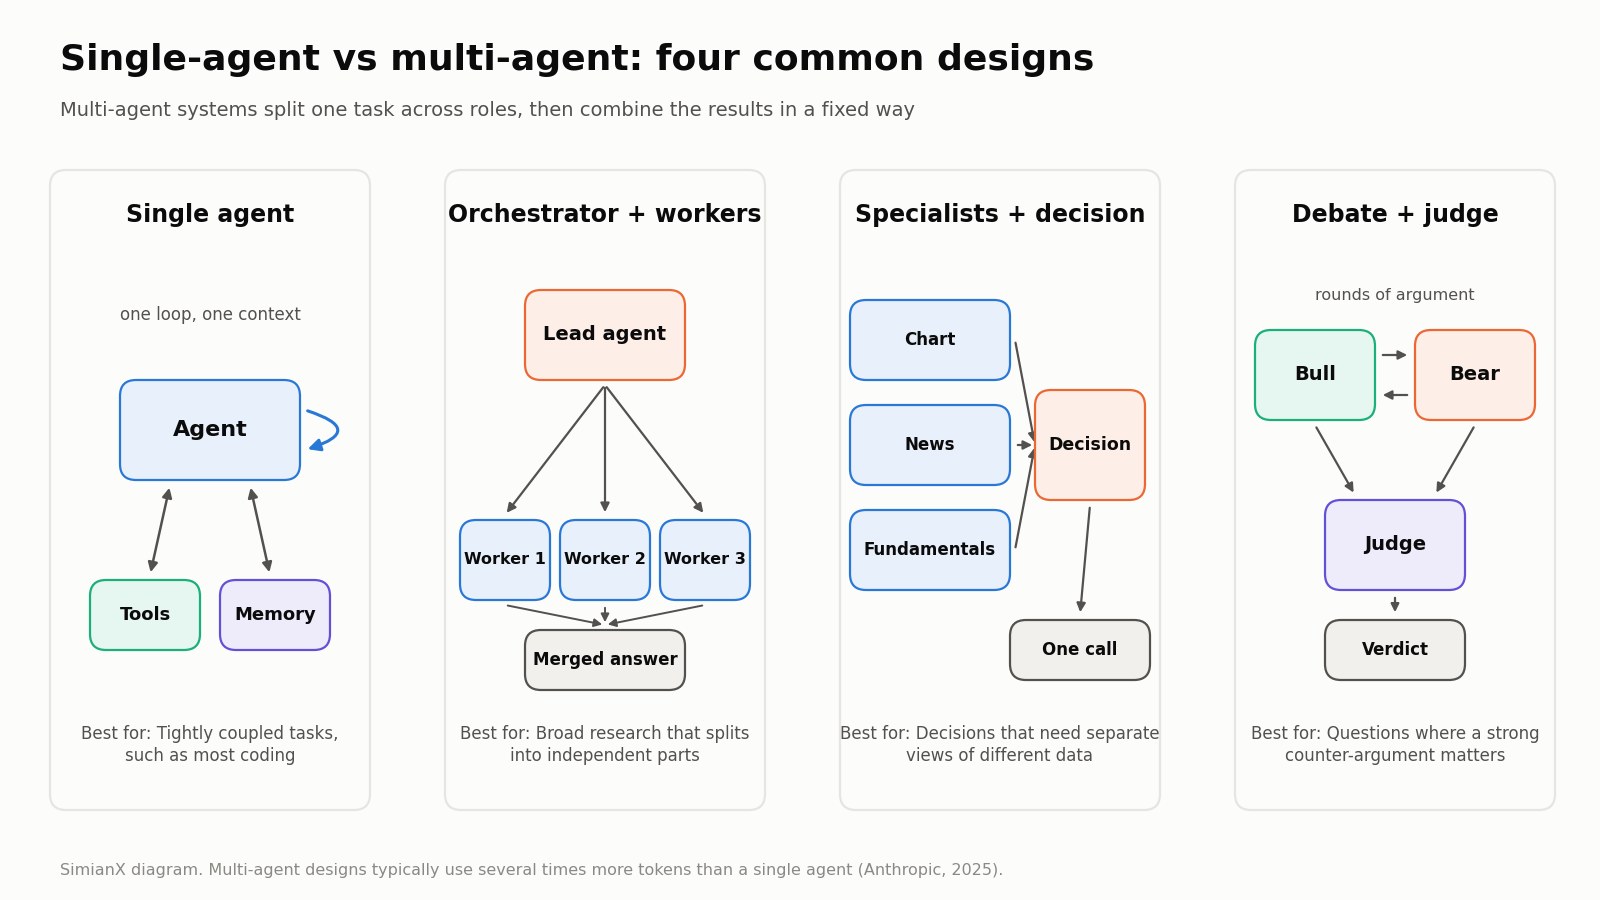
Одиночный агент проходит цикл сам. Мультиагентная система отдаёт разные части работы разным агентам — у каждого свои инструкции, инструменты и контекст, — а затем объединяет то, что они сделали. Распространены четыре архитектуры:
- Координатор и исполнители. Ведущий агент делит задачу на части, отправляет каждую агенту-исполнителю и сводит результаты. Так часто устроены исследовательские ассистенты.
- Специалисты, которые передают данные агенту-решателю. Каждый агент отвечает за свою область — графики, новости или финансовые показатели, — а последний агент взвешивает их оценки. Именно так устроен наш раздел живого анализа, о котором речь пойдёт ниже.
- Дебаты. Агенты отстаивают противоположные позиции, прежде чем арбитр примет решение. Du et al. (2023) выяснили, что несколько экземпляров модели, спорящих в течение нескольких раундов, повышали фактическую точность и качество рассуждений по сравнению с одной моделью, отвечающей в одиночку.
- Голосование или ансамбли. Несколько агентов или несколько моделей независимо отвечают на один и тот же вопрос, а ответы затем объединяются.
Доказательства в пользу мультиагентных систем реальны, но зависят от условий. В июне 2025 года Anthropic сообщила, что в её мультиагентной исследовательской системе ведущий агент Claude Opus 4, руководивший субагентами Claude Sonnet 4, превзошёл одиночного агента Claude Opus 4 на 90,2% во внутренней оценке исследовательских задач. В том же материале честно названа цена: агенты расходовали примерно в четыре раза больше токенов, чем чат, а мультиагентные системы — примерно в пятнадцать раз больше. Там же отмечено, что в большинстве задач программирования по-настоящему параллельных частей меньше, чем в исследованиях, поэтому такие задачи подходят хуже.
| Один агент | Мультиагентная система | |
|---|---|---|
| Настройка и отладка | Проще: один промпт, один журнал | Сложнее: несколько промптов, передачи между агентами и сводный журнал |
| Стоимость задачи | Ниже | Часто в несколько раз выше |
| Скорость | Последовательно | Параллельные части завершаются быстрее; координация добавляет накладные расходы |
| Охват | Ограничен одним контекстным окном | Каждый агент получает для своей части чистый контекст |
| Проверка ошибок | Должен сам замечать свои ошибки | Агенты могут оспаривать друг друга, а разногласия видны |
| Типичный сбой | Туннельное зрение на неверной первой идее | Недопонимание, дублирование работы или слабое итоговое объединение |
| Лучше всего подходит для | Тесно связанных задач, как большинство задач программирования | Широких исследований и решений, которым нужны независимые точки зрения |
Наше эмпирическое правило: используйте больше одного агента, когда вам нужны оценки, складывающиеся независимо, до того как кто-то сверит записи. Анализ графика не должен окрашиваться заголовком, который только что прочитал новостной агент, а «медвежий» сценарий должен писать агент, чья единственная задача — искать проблемы.
Где ИИ-агенты ошибаются
Агенты дают сбои предсказуемым образом, и любое честное руководство должно уделить этому время. Исследование 2025 года Why Do Multi-Agent LLM Systems Fail? (Cemri et al.) разметило более 1600 журналов выполнения из семи популярных мультиагентных фреймворков и выявило 14 различных типов сбоев в трёх группах: проблемы в устройстве системы, рассогласование между агентами и слабая проверка итогового результата.
Накопление ошибок
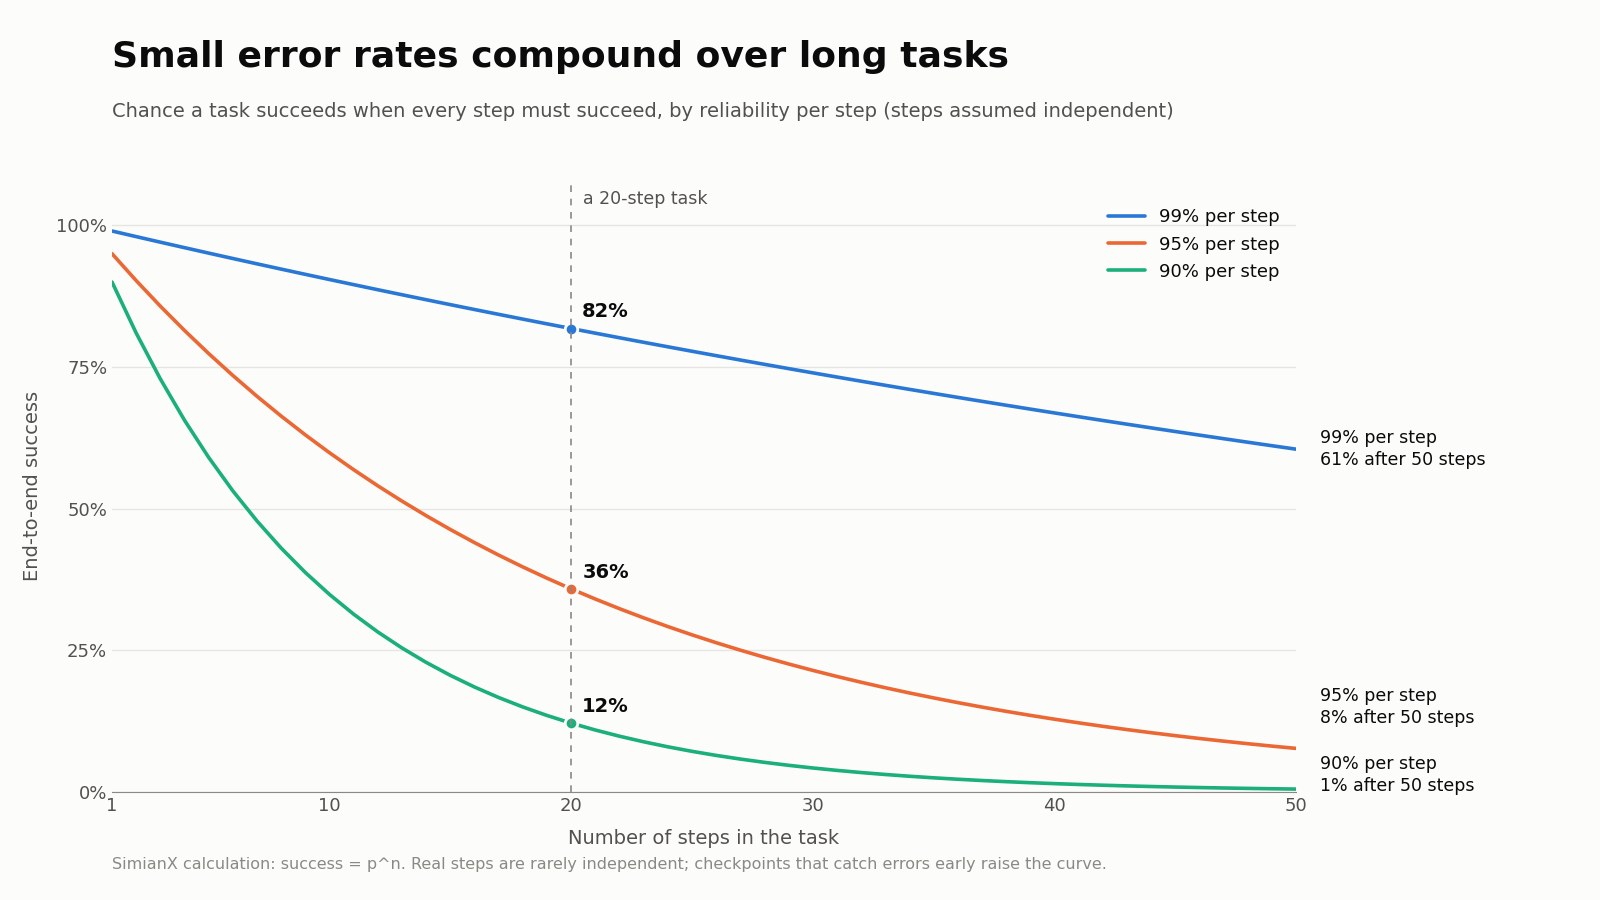
Длинные задачи умножают небольшие доли ошибок. Если каждый шаг задачи удаётся в 95% случаев и шаги независимы, задача из 20 шагов удаётся лишь примерно в 36% случаев (0,95 в двадцатой степени). При 99% на шаг та же задача удаётся примерно в 82% случаев. Поэтому надёжность каждого шага важнее блеска на отдельном шаге, и поэтому агентам нужны контрольные точки, которые ловят ошибку, прежде чем следующий шаг на неё опирается.
Галлюцинации и неверно прочитанные результаты инструментов
Модель может выдумать факт, неверно прочитать результат инструмента или перенести устаревшее число дальше так, будто оно актуально. Агенты усугубляют проблему, потому что выдуманное значение может стать входными данными для следующего действия. Решение — в устройстве системы: передавать исходные данные, а не пересказ, проверять ключевые числа в коде, а не доверять арифметике модели, и требовать источник для каждого важного утверждения.
Стоимость
Каждый проход цикла — это ещё один вызов модели, а контекст по ходу задачи растёт. Задача, которая в демонстрации выглядит дешёвой, в рабочей эксплуатации может обойтись во много раз дороже, когда агент повторяет попытки, рефлексирует и перечитывает. Устанавливайте жёсткие бюджеты на задачу и измеряйте стоимость завершённой задачи, а не одного вызова.
Задержка
Агенты обменивают скорость на качество. Ответ в чате занимает секунды; исследовательскому агенту могут понадобиться минуты, а агент-программист, прорабатывающий крупное изменение, может работать гораздо дольше. Нашему собственному комитету углублённого исследования из восьми агентов нужно несколько минут на одну акцию, потому что агенты исследуют, спорят и голосуют, прежде чем что-либо будет написано.
Оценка качества
Агенты недетерминированы: одна и та же задача может пройти успешно в одном запуске и провалиться в следующем. Тестовый набор tau-bench ввёл метрику pass^k — вероятность того, что агент справится со всеми k попытками одной и той же задачи — и показал, что даже сильные агенты с вызовом функций того времени проходили все восемь попыток менее чем в 25% случаев в сценарии розничной торговли. Один впечатляющий запуск говорит мало. Открытые тестовые наборы вроде SWE-bench для программирования и OSWorld для управления компьютером полезны, но это не ваши задачи.
Безопасность и права доступа
Агентом, который читает веб-страницы или электронные письма, можно манипулировать с помощью скрытых в них инструкций — такая атака называется внедрением промпта и возглавляет список рисков OWASP для приложений на основе LLM. Давайте агентам минимально необходимый доступ, не допускайте секретов в их контекст и требуйте одобрения перед любым необратимым действием, например перед переводом денег.
У этих проблем есть деловые последствия. В том же июньском отчёте 2025 года Gartner предсказала, что к концу 2027 года будет отменено более 40% проектов в области агентного ИИ, назвав причинами растущие затраты, неясную ценность для бизнеса и недостаточный контроль рисков.
Наглядный пример: как агенты SimianX делят торговое решение
Торговля — суровая проверка для агентов. Данные поступают непрерывно, правильный ответ в момент решения неизвестен, а каждое решение в итоге оценивает рынок. Вот как наша система распределяет работу.
Живой анализ: три специалиста и агент-решатель
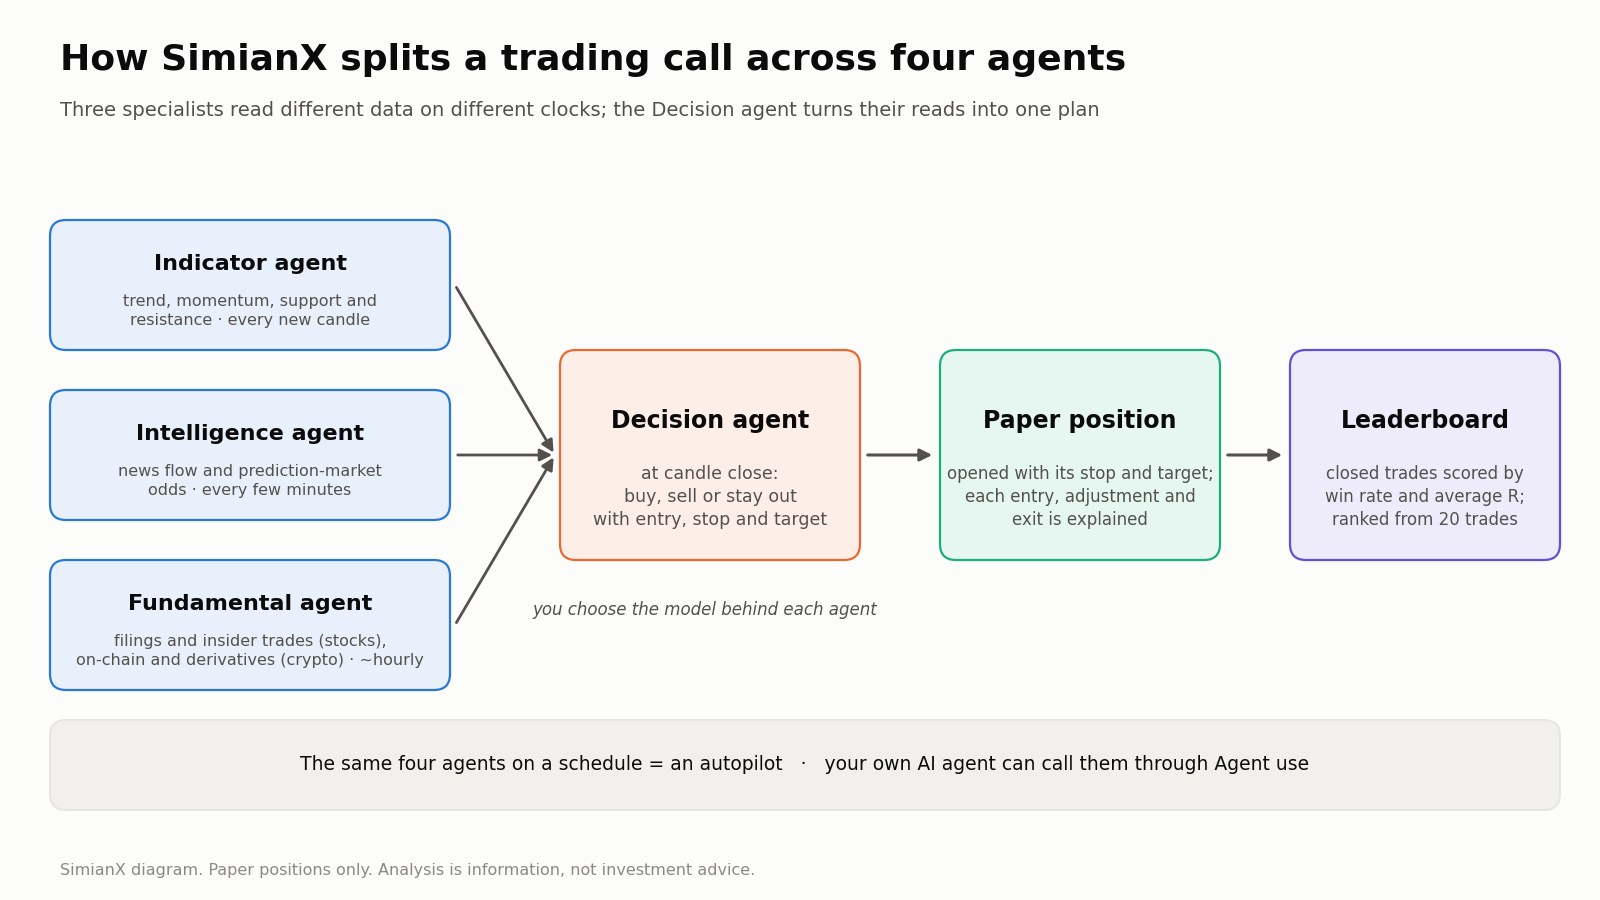
Когда вы открываете американскую акцию или криптовалютную пару в разделе живого анализа и выбираете таймфрейм, за работу берутся четыре агента. Охват — более 13 000 акций и ETF США и более 4000 криптовалютных пар, от минутных свечей и выше.
- Индикаторный агент читает график: тренд, импульс, поддержку и сопротивление. Он запускается на каждой новой свече.
- Информационный агент читает поток новостей по инструменту и, где они есть, котировки рынков прогнозов. Он обновляется каждые несколько минут.
- Фундаментальный агент читает обязательную отчётность и сделки инсайдеров для акции либо ончейн-данные и данные по деривативам для монеты. Они меняются медленно, поэтому по умолчанию агент обновляется примерно раз в час.
- Агент-решатель при закрытии свечи взвешивает оценки трёх других и говорит, что делать: покупать, продавать или оставаться вне рынка, с точкой входа, стоп-лоссом и целью.
Когда появляется подходящая ситуация, система открывает виртуальную позицию с этим стоп-лоссом и целью, а затем объясняет каждый вход, корректировку и выход по мере развития сделки. Модель для каждого агента выбираете вы. Эти же четыре агента могут работать по расписанию как автопилот, а оценённый поток новостей, на который опирается информационный агент, — тот же самый поток, что питает Пульс рынка.
Зачем делить работу именно так? Три специалиста работают в разном ритме, поэтому разделение позволяет обновлять анализ графика на каждой свече, не платя за повторное чтение отчётности, которая не изменилась. Это сохраняет контекст каждого агента небольшим и сфокусированным. И это делает разногласия видимыми: когда график говорит о пробое, а информационный агент предупреждает о квартальном отчёте завтра, агент-решатель обязан разобраться с этим противоречием, а не усреднить его.
Углублённое исследование: комитет из восьми агентов
Для более медленного и глубокого взгляда на одну акцию или монету углублённое исследование собирает комитет из восьми участников. Четыре аналитика работают параллельно: фундаментальные данные, график, новости и четвёртое место, которое для акций занимает аналитик по выбору момента, а для криптовалют — аналитик по деривативам. Затем «бычий» и «медвежий» исследователи выстраивают самые сильные аргументы каждой стороны. Руководитель исследования ведёт дебаты по главным разногласиям, каждый участник повторно излагает свою позицию на заключительном голосовании, а риск-менеджер пишет решение с проверенными ценовыми уровнями. Наш разбор обновлённого комитета проводит через полный запуск экран за экраном.
Это схема дебатов из научной литературы, перенесённая в рабочий продукт. «Медведь» нужен потому, что комитет из соглашающихся аналитиков на деле — одно мнение, повторённое четыре раза.
Как рейтинг измеряет результаты
Агента, принимающего торговые решения, нужно оценивать по результатам, а не по тому, насколько убедительно звучат его рассуждения. Криптовалютный рейтинг оценивает ИИ-модели, стоящие за этими виртуальными позициями, и учитывает только закрытые сделки, рассчитанные по реальным рыночным ценам. Сейчас в нём более 30 моделей от нескольких ИИ-лабораторий, и каждая оценивается двумя способами:
- Доля прибыльных сделок: процент закрытых сделок, завершившихся с прибылью.
- Средний R: прибыль на сделку в единицах риска, принятого при входе. Длинная позиция по 100 со стоп-лоссом на 98 рискует 2 на единицу; закрытие по 104 — это +2R, а полное срабатывание стопа — −1R.
Модель попадает в рейтинг только после 20 закрытых сделок в текущих фильтрах, поэтому горстка удачных сделок не выведет её на вершину, а фильтровать можно по периоду, таймфрейму и направлению. Важно читать обе цифры вместе: высокая доля прибыльных сделок при низком R может скрывать несколько крупных убытков, а умеренная доля при высоком R может означать меньше сделок, но с более крупной прибылью. Мы сравнивали модели, стоящие за рейтингом, в статье «Какая ИИ-модель торгует лучше?» и в нашем руководстве GPT vs Gemini vs Claude.
Подключение собственного агента
Та же система открыта и для внешних агентов. На странице «Использование агентами» объясняется, как дать Claude Code, Codex, Cursor или другому агенту навык (skill) SimianX и ключ API, чтобы он мог запускать живой анализ четырьмя агентами по любому инструменту, следить за оценённым потоком новостей или запускать углублённое исследование. Ваш агент получает собственный ключ с бюджетом, который задаёте вы. Он никогда не получает ваш логин от сайта, и каждая позиция, которой он управляет, — виртуальная.
Предупреждение о рисках: всё описанное выше — программное обеспечение, которое выдаёт аналитику и виртуальные сделки. Это информация, а не инвестиционная рекомендация. ИИ-модели ошибаются, результаты рейтинга описывают прошлые сделки и не предсказывают будущую доходность, и ни одна модель или комитет не устраняют рыночный риск. Никогда не торгуйте деньгами, потерю которых не можете себе позволить, только потому, что так посоветовал ИИ.
Типы ИИ-агентов в 2026 году
Классификация из учебника
Учебники классифицируют агентов по тому, как они принимают решения, и эти категории по-прежнему помогают понять современные системы:
| Тип | Как принимает решения | Пример |
|---|---|---|
| Простой рефлекторный агент | Фиксированные правила «условие — действие» для текущего входа | Термостат; ценовое оповещение |
| Рефлекторный агент на основе модели | Правила плюс внутреннее представление о том, чего он не видит напрямую | Спам-фильтр, учитывающий историю отправителя |
| Целевой агент | Ищет действия, ведущие к заданной цели | Планировщик маршрутов |
| Агент, основанный на полезности | Выбирает действие с наилучшим ожидаемым компромиссом | Торговый агент, соизмеряющий доходность и риск |
| Обучающийся агент | Улучшает поведение на основе обратной связи | Рекомендательная система, которая подстраивается по кликам |
Агенты на языковых моделях смешивают эти типы. Они целевые по тому, к чему стремятся, основаны на полезности, когда взвешивают варианты, и учатся в пределах задачи, анализируя результаты.
Категории продуктов
Если группировать по тому, что они реально делают, агенты, которыми люди пользуются в 2026 году, делятся на пять больших категорий. Названные здесь продукты — примеры, а не рекомендации, и их возможности быстро меняются.
Агенты для программирования. ИИ-агент для программирования читает репозиторий кода, правит файлы, запускает тесты и предлагает изменение, часто в виде запроса на слияние (pull request). Примеры — Claude Code от Anthropic, Codex от OpenAI, агент для программирования в GitHub Copilot, Cursor и Devin от Cognition. Их обычно сравнивают на SWE-bench, где нужно решать реальные задачи из проектов с открытым исходным кодом. Исследование METR показывает, что длина программных задач, которые передовые агенты выполняют с надёжностью 50%, удваивается примерно каждые семь месяцев начиная с 2019 года.
Исследовательские агенты. Они ищут в интернете или в коллекции документов, читают множество источников и пишут отчёт со ссылками. Google запустила Gemini Deep Research в декабре 2024 года, а OpenAI в феврале 2025 года добавила в ChatGPT функцию deep research. Их слабое место — качество источников: хорошо написанный отчёт всё равно может опираться на слабый источник.
Агенты для браузера и управления компьютером. Они управляют браузером или целым рабочим столом: смотрят на экран, нажимают и печатают. Anthropic выпустила функцию computer use в октябре 2024 года. Operator от OpenAI, запущенный в январе 2025 года, в июле 2025 года вошёл в состав ChatGPT agent, а у Google есть Project Mariner. Они медленнее и менее надёжны, чем агенты, работающие через API, поэтому их обычно оставляют для сайтов, у которых нет API.
Универсальные агенты. Они берут широкую цель и для её выполнения сочетают просмотр веб-страниц, код и работу с файлами. Самый известный пример — Manus, запущенный в марте 2025 года. В декабре 2025 года Meta договорилась о покупке компании; в апреле 2026 года Национальная комиссия по развитию и реформам Китая предписала отменить сделку.
Торговые агенты и агенты рыночного анализа. Они читают рыночные данные, новости и отчётность, составляют торговые планы или управляют позициями. Академические фреймворки вроде TradingAgents (Xiao et al., 2024) моделируют торговую фирму с ролями аналитиков, исследователей, трейдера и управления рисками, а продукты вроде SimianX запускают похожие комитеты на живых данных. Рынки состязательны и зашумлены, поэтому именно в этой категории публичная история результатов по каждой сделке важнее всего.
Как оценить ИИ-агента: чек-лист
Выбираете ли вы агента для программирования, исследовательский инструмент или торгового помощника, полезных агентов от демонстрационных отделяют одни и те же вопросы.
| Вопрос | Как выглядит хороший ответ | Тревожный признак |
|---|---|---|
| Это действительно агент? | Сам выбирает шаги и инструменты | Жёсткий сценарий с ярлыком «агент» |
| Работает ли он на ваших задачах? | Проверен на 10–20 реальных задачах из вашей работы | Только демонстрации поставщика и баллы в тестовых наборах |
| Стабилен ли он? | Похожие результаты при многократном запуске одной задачи | Один блестящий запуск, а потом провалы |
| Сколько стоит выполненная задача? | Стоимость одной завершённой задачи измеряется и ограничивается | Называются только цены за вызов |
| Сколько времени он тратит? | Скорость соответствует задаче | Минуты ожидания ради ответа в одну строку |
| Видно ли, что он сделал? | Полный журнал шагов, вызовов инструментов и источников | Итоговый ответ без следов |
| К чему у него есть доступ? | Минимальные права, песочница или виртуальный режим, одобрение необратимых действий | Широкие учётные данные и никакого шага одобрения |
| Как он останавливается? | Бюджеты, лимиты шагов и чёткое правило остановки | Крутится в цикле, пока кто-нибудь не заметит |
| Насколько свежи его данные? | Метка времени у каждого значения | Устаревшие цифры, выданные за актуальные |
| Для торговых агентов: какова история результатов? | Закрытые сделки по реальным ценам, указан размер выборки, доля прибыльных сделок и доходность с поправкой на риск | Только тесты на исторических данных или доля прибыльных сделок без их количества |
Часто задаваемые вопросы
Что такое ИИ-агент простыми словами?
ИИ-агент — это программа, которая с помощью модели ИИ сама добивается цели. Она оценивает ситуацию, выбирает шаг, выполняет его с помощью инструмента вроде поиска или кода, проверяет результат и повторяет всё это, пока работа не будет сделана или не понадобится человек.
Чем ИИ-агент отличается от чат-бота?
Чат-бот отвечает на одно сообщение за раз и затем ждёт вас. Агент продолжает двигаться к цели на протяжении многих шагов, сам выбирает инструменты и может довести задачу до конца — например, исправить код или написать отчёт — без нового запроса на каждом шаге.
Что такое мультиагентная система?
Мультиагентная система — это группа ИИ-агентов с разными ролями, работающих над одной задачей. Они могут делить работу, спорить с противоположных позиций или голосовать, а итоговый агент или фиксированное правило объединяет их результаты. На широких задачах они часто превосходят одиночного агента, но обходятся гораздо дороже.
Что такое ИИ-агент для программирования?
ИИ-агент для программирования работает внутри программного проекта: читает код, правит файлы, запускает тесты и предлагает изменения. Примеры — Claude Code, OpenAI Codex, агент для программирования в GitHub Copilot, Cursor и Devin.
Что такое Manus AI?
Manus — универсальный ИИ-агент, запущенный в марте 2025 года, который берёт широкую цель и выполняет её с помощью просмотра веб-страниц, кода и файлов. В декабре 2025 года Meta договорилась о покупке компании, а в апреле 2026 года китайские регуляторы предписали отменить сделку.
Могут ли ИИ-агенты торговать акциями или криптовалютой?
Они умеют анализировать рынки и управлять позициями, а некоторые продукты, включая SimianX, позволяют агентам вести виртуальные позиции со стоп-лоссами и целями. Результаты сильно различаются в зависимости от модели и рынка, поэтому оценивайте любого торгового агента по истории закрытых сделок и воспринимайте его выводы как информацию, а не как совет.
Как подключить собственного ИИ-агента к живому анализу рынка?
На странице SimianX «Использование агентами» показано, как установить навык SimianX в Claude Code, Codex, Cursor и другие агенты. Ваш агент получает собственный ключ API с бюджетом под вашим контролем и может запускать живой мультиагентный анализ, следить за оценённым потоком новостей и запускать углублённое исследование.
Читайте также
- ИИ-анализ акций по-новому: комитет из 8 агентов ответит вам
- 8 ИИ-аналитиков vs 1: точность +37%, риск −41% реальный
- Какая ИИ-модель торгует лучше? 30 LLM, реальный крипто P&L
- 30+ ИИ-моделей, 6 провайдеров: лидерборд крипты в реале
- GPT vs Gemini vs Claude: AI-анализ акций — полный гид 2026
- Мульти-агентный ИИ vs ChatGPT для NVDA: сравнение в 2026
- Как AI крипто-автопилоты работают 24/7 (Полный гид 2026)
- Анализ акций в реальном времени: AI-агенты по акциям США
- Agentic AI-инвестиции: гайд для новичков нового поколения
Источники
- Russell & Norvig — Artificial Intelligence: A Modern Approach
- Anthropic — Building Effective Agents (декабрь 2024 года)
- Anthropic — How we built our multi-agent research system (июнь 2025 года)
- Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du et al. — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri et al. — Why Do Multi-Agent LLM Systems Fail?
- Yao et al. — tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao et al. — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — официальная документация
- Agent2Agent (A2A) Protocol — официальный сайт
- Gartner — более 40% проектов агентного ИИ будут отменены к концу 2027 года (июнь 2025 года)
- TechCrunch — Китай заблокировал сделку Meta с Manus на 2 млрд долларов (апрель 2026 года)
- IBM — Что такое ИИ-агенты?
- OWASP — Топ-10 рисков для приложений на больших языковых моделях