อธิบายเอเจนต์ AI: จากโมเดลเดียวที่ทำงานเป็นวงรอบ สู่ทีมผู้เชี่ยวชาญ
เอเจนต์ AI คือระบบซอฟต์แวร์ที่ใช้โมเดล AI ไล่ตามเป้าหมายได้ด้วยตัวเอง มันอ่านสถานการณ์ ตัดสินใจขั้นตอนถัดไป ลงมือผ่านเครื่องมืออย่างการค้นหาเว็บ โค้ด หรือ API แล้วตรวจผลลัพธ์ก่อนจะทำต่อ ส่วน ระบบหลายเอเจนต์ (multi-agent) จะแบ่งงานนั้นให้เอเจนต์เฉพาะทางหลายตัว ซึ่งแบ่งปันสิ่งที่ค้นพบ โต้แย้งกันในจุดที่เห็นต่าง และส่งคำตอบที่รวมกันแล้วให้เอเจนต์ตัวเดียวเป็นผู้ตัดสินขั้นสุดท้าย
คำนิยามสองประโยคนี้ครอบคลุมความหมายส่วนใหญ่ของคำนี้ในปี 2026 ตั้งแต่ผู้ช่วยเขียนโค้ดที่แก้ข้อบกพร่องของโปรแกรมได้ทั่วทั้งคลังโค้ด ไปจนถึงเครื่องมือค้นคว้าที่อ่านเอกสารหลายร้อยหน้าก่อนเขียนรายงาน แต่คำนิยามนี้ก็ซ่อนส่วนที่ยากเอาไว้ด้วย เอเจนต์มีต้นทุนสูงกว่าคำตอบแชตหนึ่งครั้ง ใช้เวลานานกว่า และข้อผิดพลาดเล็กๆ ในช่วงต้นของงานที่ยาวอาจทำลายผลลัพธ์ทั้งหมดได้อย่างเงียบๆ
เราสร้างและใช้งานระบบหลายเอเจนต์ทุกวันที่ SimianX เอเจนต์สี่ตัววิเคราะห์หุ้นหรือคู่ซื้อขายคริปโตแบบสดใน ห้องวิเคราะห์สด ของเรา คณะกรรมการแปดเอเจนต์ถกเถียงเกี่ยวกับหุ้นหรือเหรียญหนึ่งตัวใน การวิจัยเชิงลึก และ กระดานผู้นำคริปโต แบบสาธารณะให้คะแนนโมเดล AI มากกว่า 30 โมเดลจากทุกการซื้อขายที่ปิดแล้ว คู่มือนี้ใช้ระบบดังกล่าวเป็นตัวอย่างจริง ควบคู่กับคำอธิบายที่เป็นกลางเกี่ยวกับผลิตภัณฑ์เอเจนต์และงานวิจัยที่กำหนดทิศทางของวงการนี้
ประเด็นสำคัญ
- เอเจนต์คือโมเดลบวกเครื่องมือ หน่วยความจำ และวงรอบที่โมเดลควบคุมเอง หากทุกขั้นตอนถูกกำหนดตายตัวไว้ในโค้ด สิ่งนั้นคือเวิร์กโฟลว์ ไม่ใช่เอเจนต์
- ระบบหลายเอเจนต์ช่วยได้เมื่องานแบ่งออกเป็นส่วนที่อิสระต่อกัน หรือเมื่อต้องการมุมมองที่ควรก่อตัวขึ้นเองก่อนที่ใครจะมาเทียบความเห็นกัน แต่ก็ใช้โทเคนมากกว่าหลายเท่า
- ความล้มเหลวส่วนใหญ่ของเอเจนต์มาจากข้อผิดพลาดที่ทบต้น เครื่องมือที่เชื่อถือไม่ได้ การประเมินที่อ่อน และต้นทุนที่บานปลาย ไม่ใช่เพราะโมเดล "ไม่ฉลาดพอ"
- ตัดสินเอเจนต์จากผลลัพธ์ที่ได้ซ้ำๆ บนงานของคุณเอง ได้แก่ อัตราความสำเร็จ ความสม่ำเสมอระหว่างการทำงานแต่ละรอบ ต้นทุนต่องานที่เสร็จสมบูรณ์ และบันทึกครบถ้วนของทุกสิ่งที่มันทำ
เอเจนต์ AI คืออะไร? นิยามที่ใช้งานได้จริง
แนวคิดนี้เก่ากว่าโมเดลภาษาขนาดใหญ่ ตำรา AI มาตรฐานอย่าง ปัญญาประดิษฐ์: แนวทางสมัยใหม่ (Artificial Intelligence: A Modern Approach) ของสจ๊วร์ต รัสเซลล์ และปีเตอร์ นอร์วิก นิยามเอเจนต์ว่าเป็นอะไรก็ตามที่รับรู้สภาพแวดล้อมผ่านเซนเซอร์ และกระทำต่อสภาพแวดล้อมนั้นผ่านตัวขับเคลื่อน เทอร์โมสตัตก็นับเป็นเอเจนต์ โปรแกรมหมากรุกก็เช่นกัน
สิ่งที่เปลี่ยนไปหลังปี 2022 คือโมเดลภาษาสามารถทำหน้าที่เป็นแกนกลางของการให้เหตุผลได้แล้ว แทนที่จะทำตามกฎที่คนเขียนขึ้นเอง โมเดลจะอ่านสถานการณ์เป็นภาษาธรรมดา เขียนแผน และเลือกว่าจะเรียกใช้เครื่องมือใดต่อไป คู่มือ Building Effective Agents (การสร้างเอเจนต์ที่มีประสิทธิภาพ) ของ Anthropic ซึ่งถูกอ้างถึงอย่างกว้างขวาง ได้ขีดเส้นแบ่งที่วิศวกรส่วนใหญ่ใช้กันในปัจจุบัน: เวิร์กโฟลว์ คือระบบที่โมเดลและเครื่องมือถูกประสานงานผ่านเส้นทางโค้ดที่กำหนดไว้ล่วงหน้า ส่วน เอเจนต์ คือระบบที่โมเดลกำหนดกระบวนการและการใช้เครื่องมือของตัวเองอย่างยืดหยุ่นระหว่างทำงาน
ในทางปฏิบัติ เอเจนต์ AI สมัยใหม่มีห้าส่วน:
- เป้าหมาย เช่น "แก้การทดสอบที่ล้มเหลวนี้" "สรุปว่าอะไรทำให้หุ้น Nvidia เคลื่อนไหววันนี้" หรือ "ตัดสินใจว่าจะเปิดสถานะบนแท่งเทียน 15 นาทีนี้หรือไม่"
- โมเดล ที่ให้เหตุผลเกี่ยวกับเป้าหมายและสถานะปัจจุบัน
- เครื่องมือ ที่เรียกใช้ได้ ได้แก่ การค้นหา ตัวประมวลผลโค้ด การสืบค้นฐานข้อมูล API ข้อมูลตลาด และเบราว์เซอร์
- หน่วยความจำหรือสถานะ: สิ่งที่ลองไปแล้ว สิ่งที่เครื่องมือส่งกลับมา และสิ่งที่ยังไม่รู้
- วงรอบที่มีกฎการหยุด: ทำต่อไปจนกว่าจะบรรลุเป้าหมาย งบประมาณหมด หรือต้องให้มนุษย์อนุมัติขั้นตอนถัดไป
ตัดวงรอบออกไป คุณจะได้แชตบอต กำหนดทุกขั้นตอนไว้ล่วงหน้า คุณจะได้เวิร์กโฟลว์ วงรอบที่โมเดลควบคุมเองคือสิ่งที่ทำให้มันเป็นเอเจนต์
เอเจนต์ AI เทียบกับแชตบอตและเวิร์กโฟลว์
คำทั้งสามถูกใช้ปนกันอยู่ตลอด ส่วนหนึ่งเพราะคำว่า "เอเจนต์" ขายได้ Gartner ตั้งชื่อให้การติดป้ายใหม่แก่แชตบอตและระบบอัตโนมัติกระบวนการด้วยหุ่นยนต์ซอฟต์แวร์ (RPA) ว่าเป็นเอเจนต์ว่า "การฟอกเอเจนต์" (agent washing) และ ประเมินไว้เมื่อเดือนมิถุนายน 2025 ว่าในบรรดาผู้ขาย AI แบบเอเจนต์หลายพันราย มีเพียงราว 130 รายที่ให้ของจริง ตารางนี้คือวิธีที่เร็วที่สุดในการแยกแยะทั้งสามอย่าง
| แชตบอต | เวิร์กโฟลว์ (ไปป์ไลน์) | เอเจนต์ AI | |
|---|---|---|---|
| ใครตัดสินขั้นตอนถัดไป | ผู้ใช้ ทีละข้อความ | นักพัฒนา ผ่านโค้ดที่เขียนไว้ล่วงหน้า | โมเดล ขณะทำงาน |
| ใช้เครื่องมือ | บางครั้ง หนึ่งครั้งต่อหนึ่งคำตอบ | ใช้ ตามลำดับตายตัว | ใช้ เลือกและทำซ้ำตามความจำเป็น |
| ทำงานต่อได้โดยไม่ต้องสั่งใหม่ | ไม่ได้ | ได้ ตามเส้นทางตายตัว | ได้ จนกว่าจะถึงเป้าหมายหรือหมดงบประมาณ |
| ผลลัพธ์ทั่วไป | คำตอบ | ผลลัพธ์ที่คาดการณ์ได้จากกระบวนการที่รู้จัก | งานที่เสร็จแล้ว: การแก้โค้ด รายงาน หรือการตัดสินใจ |
| ต้นทุนและความเร็ว | ถูก ไม่กี่วินาที | ถูกถึงปานกลาง คาดการณ์ได้ | สูงกว่าและไม่แน่นอน ตั้งแต่ไม่กี่วินาทีถึงหลายชั่วโมง |
| ความล้มเหลวที่พบบ่อย | คำตอบผิดที่มองเห็นได้ | พังเมื่อเจอข้อมูลนำเข้าที่ไม่มีใครวางแผนไว้ | หลงทาง วนซ้ำ หรือต่อยอดจากข้อผิดพลาดเล็กๆ ในช่วงต้น |
| เหมาะกับ | การถามตอบและการร่างเนื้อหา | กระบวนการซ้ำๆ ที่รู้ขั้นตอนแน่ชัด | งานปลายเปิดที่เขียนเส้นทางไว้ล่วงหน้าไม่ได้ |
กฎที่มีประโยชน์จากคู่มือเดียวกันของ Anthropic คือ เริ่มจากทางเลือกที่ง่ายที่สุดที่ใช้ได้ผล และเพิ่มความเป็นอิสระก็ต่อเมื่อมันทำให้ผลลัพธ์ดีขึ้นอย่างชัดเจน งานจำนวนมากที่ถูกโฆษณาว่าเป็นเอเจนต์ จะดีกว่า ถูกกว่า และปลอดภัยกว่าหากทำเป็นเวิร์กโฟลว์
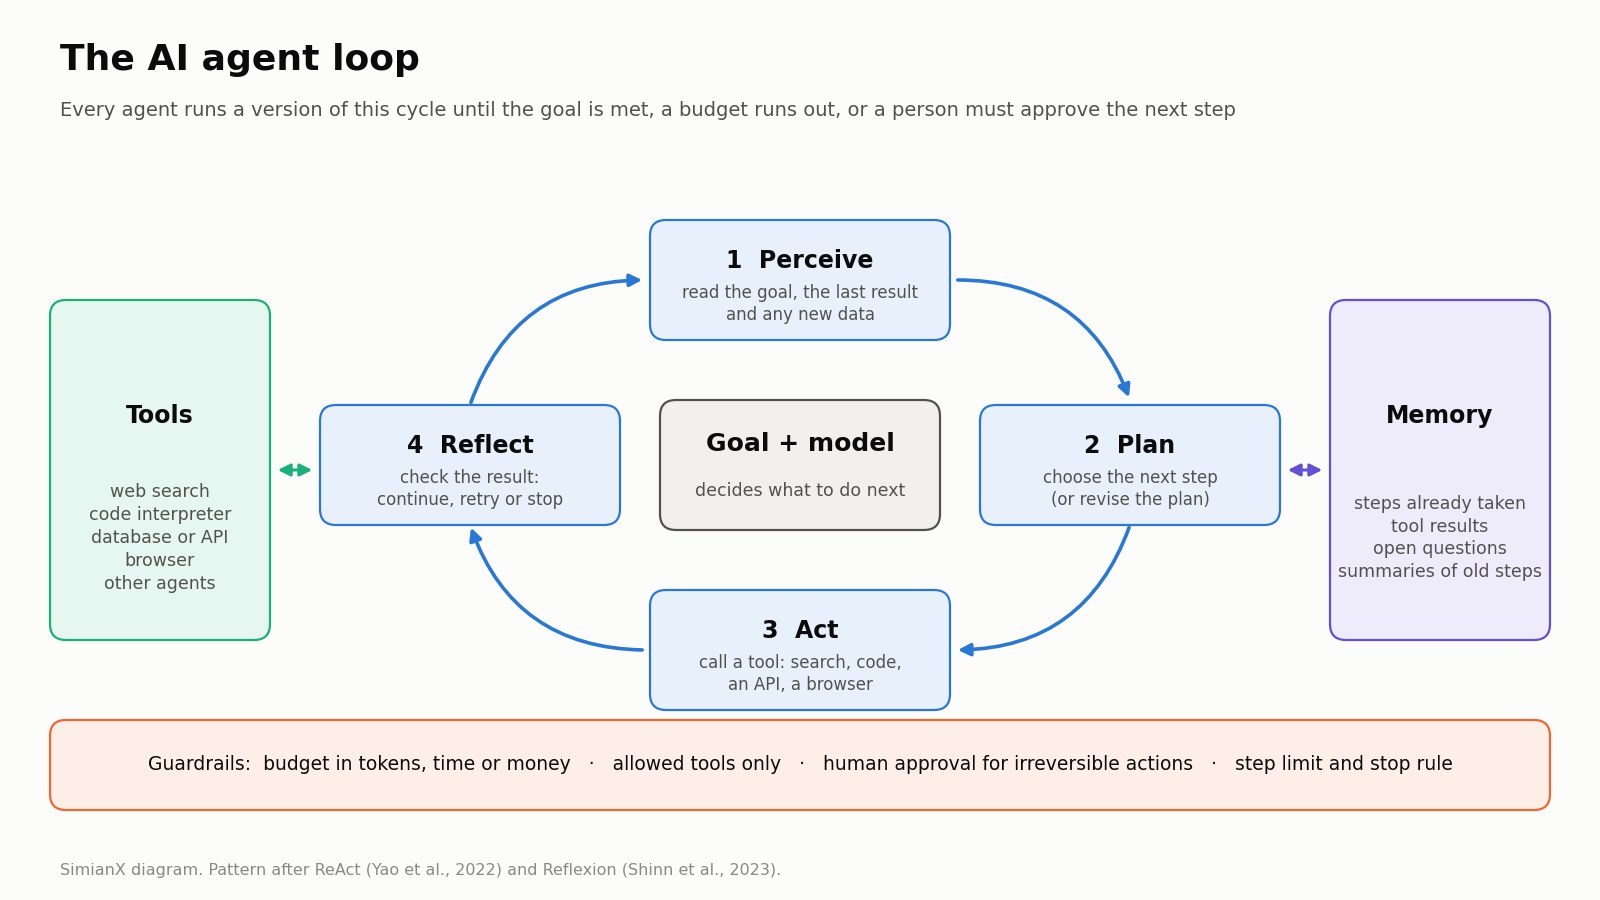
เอเจนต์ AI ทำงานอย่างไร: วงรอบ รับรู้ วางแผน ลงมือ ทบทวน
เอเจนต์ทุกตัว ไม่ว่าจะติดแบรนด์อะไร ล้วนทำงานด้วยวงรอบเดียวกันในรูปแบบใดรูปแบบหนึ่ง
รับรู้
เอเจนต์รวบรวมสถานการณ์ปัจจุบัน ได้แก่ เป้าหมายของผู้ใช้ ผลของการกระทำครั้งล่าสุด เนื้อหาในไฟล์ หน้าผลการค้นหาหนึ่งหน้า หรือแท่งเทียนล่าสุดบนกราฟ ทุกสิ่งที่มันรู้ต้องบรรจุลงในหน้าต่างบริบทของโมเดลได้ เอเจนต์ที่ดีจึงเลือกสรร มันสรุปขั้นตอนเก่า เก็บข้อมูลดิบที่ต้องใช้อีกไว้ และทิ้งส่วนที่เหลือ
วางแผน
โมเดลตัดสินใจว่าจะทำอะไรต่อ บางครั้งเป็นแผนเต็มที่เขียนไว้ตั้งแต่ต้น แต่บ่อยกว่านั้นคือขั้นตอนถัดไปเพียงขั้นเดียวที่เลือกหลังจากเห็นผลล่าสุด งานวิจัย ReAct (Yao และคณะ, 2022) ซึ่งทรงอิทธิพล แสดงให้เห็นว่าการสลับระหว่างบันทึกการให้เหตุผลสั้นๆ กับการลงมือทำ ช่วยให้โมเดลรวบรวมข้อมูลและปรับทิศทางได้ และทำได้ดีกว่าแนวทางที่ลงมืออย่างเดียวหรือให้เหตุผลอย่างเดียวในหลายงาน กรอบงานเอเจนต์ส่วนใหญ่ยังคงใช้รูปแบบนี้
ลงมือ
เอเจนต์เรียกใช้เครื่องมือ โมเดลสมัยใหม่จะส่งคำขอแบบมีโครงสร้าง เช่น "ค้นหา X" หรือ "เรียกใช้คำสั่งสืบค้นนี้ด้วยพารามิเตอร์เหล่านี้" แล้วซอฟต์แวร์ที่อยู่รอบๆ จะดำเนินการและส่งผลกลับมา ปัจจุบันงานเชื่อมต่อเบื้องหลังเหล่านี้มีมาตรฐานแล้ว Model Context Protocol (MCP) ซึ่ง Anthropic เปิดตัวในเดือนพฤศจิกายน 2024 และ บริจาคให้ Agentic AI Foundation ภายใต้มูลนิธิ Linux ในเดือนธันวาคม 2025 กำหนดวิธีที่เอเจนต์เชื่อมต่อกับเครื่องมือและแหล่งข้อมูล ส่วน โปรโตคอล Agent2Agent (A2A) ของ Google ซึ่งปัจจุบันเป็นโครงการของมูลนิธิ Linux เช่นกัน ครอบคลุมวิธีที่เอเจนต์จากผู้ผลิตต่างรายสื่อสารกัน
ทบทวน
เอเจนต์ตรวจผลลัพธ์เทียบกับเป้าหมาย การทดสอบผ่านหรือไม่? ตัวเลขตรงกับแหล่งที่สองหรือเปล่า? แผนยังสมเหตุสมผลอยู่ไหม? งานวิจัยอย่าง Reflexion (Shinn และคณะ, 2023) แสดงให้เห็นว่าการให้เอเจนต์จดว่าอะไรผิดพลาดแล้วลองใหม่ ช่วยให้ผลลัพธ์ในงานเขียนโค้ดและงานให้เหตุผลดีขึ้น การทบทวนยังเป็นจุดที่เอเจนต์ควรตัดสินใจหยุด เพราะบรรลุเป้าหมายแล้ว เพราะติดขัด หรือเพราะต้องให้คนอนุมัติเรื่องที่มีความเสี่ยง
รอบวงรอบนี้มีรั้วป้องกันอยู่ ได้แก่ งบประมาณที่กำหนดเป็นโทเคน เวลา หรือเงิน รายชื่อเครื่องมือที่เอเจนต์ใช้ได้ และจุดที่มนุษย์ต้องตอบตกลง ในบริบทการซื้อขาย อย่างน้อยที่สุดหมายถึงเพดานขนาดสถานะ จุดตัดขาดทุนในทุกการซื้อขาย และเส้นแบ่งที่ชัดเจนระหว่างการซื้อขายจำลองกับเงินจริง
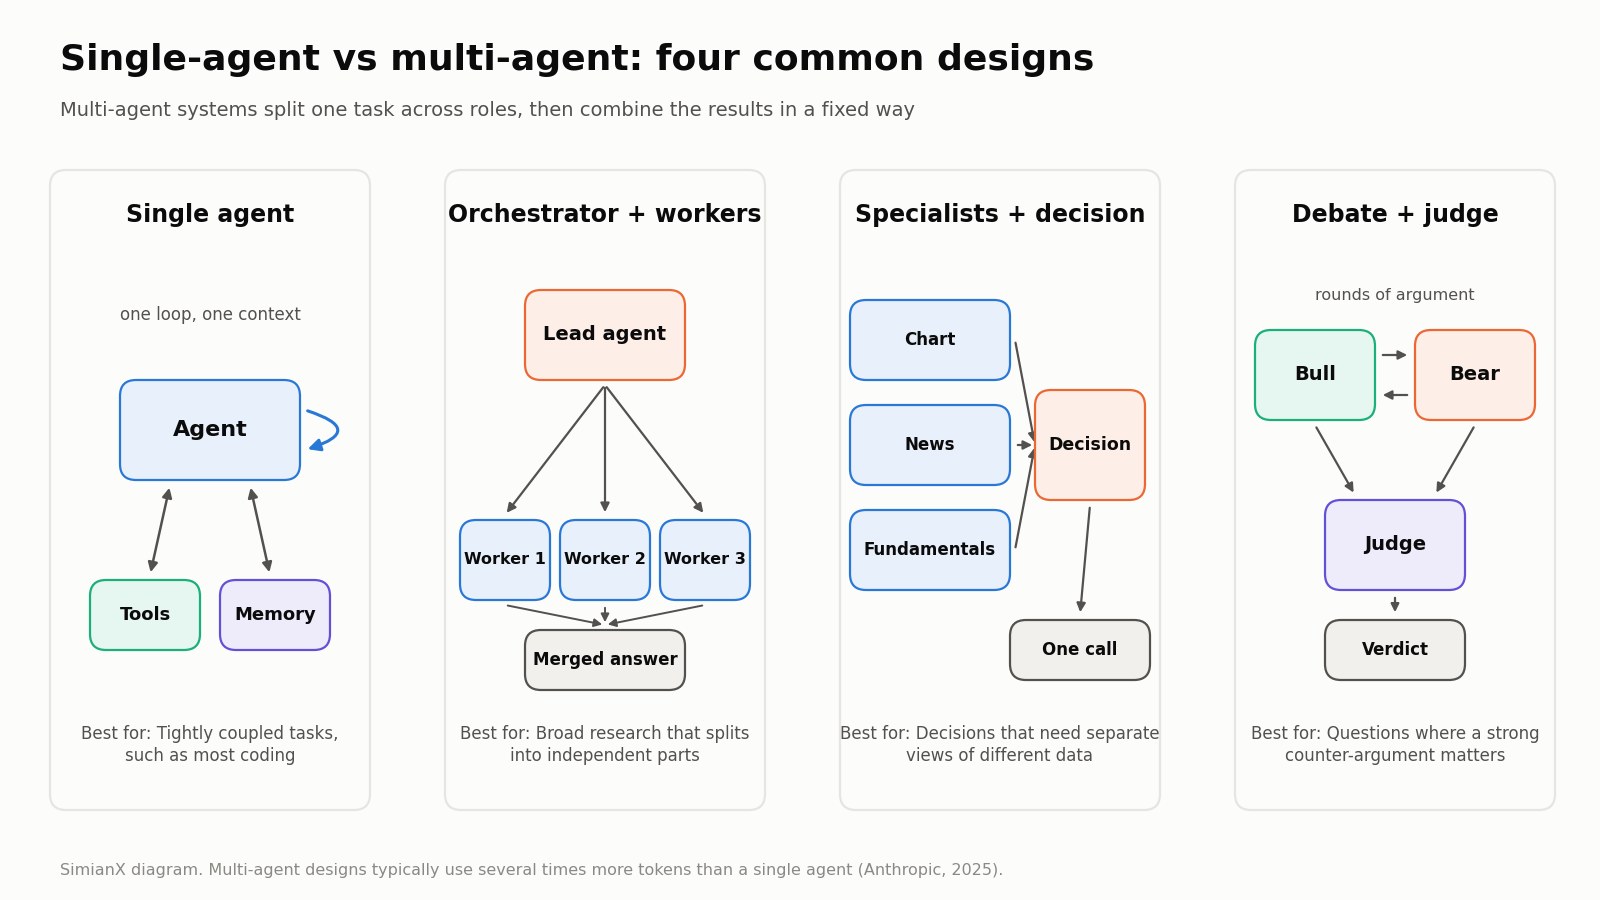
เอเจนต์เดี่ยวเทียบกับระบบหลายเอเจนต์
เอเจนต์เดี่ยวทำงานวงรอบเพียงลำพัง ระบบหลายเอเจนต์มอบส่วนต่างๆ ของงานให้เอเจนต์ต่างตัว โดยแต่ละตัวมีคำสั่ง เครื่องมือ และบริบทของตัวเอง แล้วจึงรวมผลงานเข้าด้วยกัน รูปแบบที่พบบ่อยมีสี่แบบ:
- ผู้ประสานงานและผู้ปฏิบัติงาน เอเจนต์หลักแบ่งงานเป็นส่วนๆ ส่งแต่ละส่วนให้เอเจนต์ผู้ปฏิบัติงาน แล้วรวมผลลัพธ์ ผู้ช่วยค้นคว้ามักทำงานแบบนี้
- ผู้เชี่ยวชาญที่ส่งมุมมองให้ผู้ตัดสินใจ เอเจนต์แต่ละตัวดูแลด้านเดียว เช่น กราฟ ข่าว หรือข้อมูลการเงิน และเอเจนต์ตัวสุดท้ายชั่งน้ำหนักมุมมองเหล่านั้น นี่คือโครงสร้างของห้องวิเคราะห์สดของเรา ซึ่งอธิบายไว้ด้านล่าง
- การโต้วาที เอเจนต์ถกเถียงกันคนละฝั่งก่อนที่ผู้ตัดสินจะชี้ขาด Du และคณะ (2023) พบว่าการให้โมเดลหลายชุดโต้วาทีกันสองสามรอบ ช่วยเพิ่มความถูกต้องของข้อเท็จจริงและการให้เหตุผล เมื่อเทียบกับให้โมเดลเดียวตอบตามลำพัง
- การลงคะแนนหรือการรวมกลุ่ม เอเจนต์หลายตัวหรือโมเดลหลายตัวตอบคำถามเดียวกันอย่างอิสระ แล้วนำคำตอบมารวมกัน
หลักฐานที่สนับสนุนระบบหลายเอเจนต์มีจริงแต่มีเงื่อนไข Anthropic รายงานเมื่อเดือนมิถุนายน 2025 ว่าใน ระบบค้นคว้าแบบหลายเอเจนต์ ของบริษัท เอเจนต์หลัก Claude Opus 4 ที่สั่งการเอเจนต์ย่อย Claude Sonnet 4 ทำผลงานได้ดีกว่าเอเจนต์ Claude Opus 4 ตัวเดียวถึง 90.2% ในการประเมินงานค้นคว้าภายในของบริษัท บทความเดียวกันยังพูดตรงไปตรงมาเรื่องต้นทุน: เอเจนต์ใช้โทเคนราวสี่เท่าของการแชต และระบบหลายเอเจนต์ใช้ราวสิบห้าเท่า บทความยังระบุว่างานเขียนโค้ดส่วนใหญ่มีส่วนที่ทำคู่ขนานกันได้จริงน้อยกว่างานค้นคว้า จึงเหมาะกับแนวทางนี้น้อยกว่า
| เอเจนต์เดี่ยว | ระบบหลายเอเจนต์ | |
|---|---|---|
| การตั้งค่าและการแก้จุดบกพร่อง | ง่ายกว่า: ชุดคำสั่งเดียว บันทึกการทำงานชุดเดียว | ยากกว่า: หลายชุดคำสั่ง การส่งต่องาน และบันทึกการทำงานที่รวมกัน |
| ต้นทุนต่องาน | ต่ำกว่า | มักสูงกว่าหลายเท่า |
| ความเร็ว | ทำทีละขั้น | ส่วนที่ทำคู่ขนานเสร็จเร็วขึ้น แต่การประสานงานเพิ่มภาระ |
| ความกว้างของงาน | จำกัดด้วยหน้าต่างบริบทเดียว | เอเจนต์แต่ละตัวได้บริบทใหม่สำหรับส่วนของตน |
| การตรวจข้อผิดพลาด | ต้องจับความผิดพลาดของตัวเองให้ได้ | เอเจนต์โต้แย้งกันได้ และความเห็นต่างมองเห็นได้ |
| ความล้มเหลวที่พบบ่อย | ยึดติดกับความคิดแรกที่ผิด | สื่อสารผิดพลาด ทำงานซ้ำซ้อน หรือรวมผลขั้นสุดท้ายได้ไม่ดี |
| เหมาะที่สุดกับ | งานที่ผูกพันกันแน่น เช่น งานเขียนโค้ดส่วนใหญ่ | งานค้นคว้ากว้างๆ และการตัดสินใจที่ต้องการมุมมองอิสระ |
หลักง่ายๆ ของเราคือ ใช้เอเจนต์มากกว่าหนึ่งตัวเมื่อคุณต้องการมุมมองที่ก่อตัวขึ้นอย่างอิสระก่อนที่ใครจะมาเทียบความเห็นกัน การอ่านกราฟไม่ควรถูกพาดหัวข่าวที่เอเจนต์ข่าวเพิ่งอ่านมาย้อมสี และข้อโต้แย้งฝั่งขาลงควรเขียนโดยเอเจนต์ที่มีหน้าที่เดียวคือหาจุดอ่อน
จุดที่เอเจนต์ AI ล้มเหลว
เอเจนต์ล้มเหลวในรูปแบบที่คาดเดาได้ และคู่มือที่ซื่อตรงต้องให้เวลากับเรื่องนี้ งานวิจัยปี 2025 เรื่อง Why Do Multi-Agent LLM Systems Fail? (ทำไมระบบ LLM หลายเอเจนต์จึงล้มเหลว?) (Cemri และคณะ) ได้กำกับข้อมูลบันทึกการทำงานกว่า 1,600 ชุดจากกรอบงานหลายเอเจนต์ยอดนิยม 7 ตัว และพบรูปแบบความล้มเหลวที่แตกต่างกัน 14 แบบในสามกลุ่ม ได้แก่ ปัญหาในการออกแบบระบบ ความไม่สอดคล้องกันระหว่างเอเจนต์ และการตรวจสอบผลลัพธ์ขั้นสุดท้ายที่อ่อน
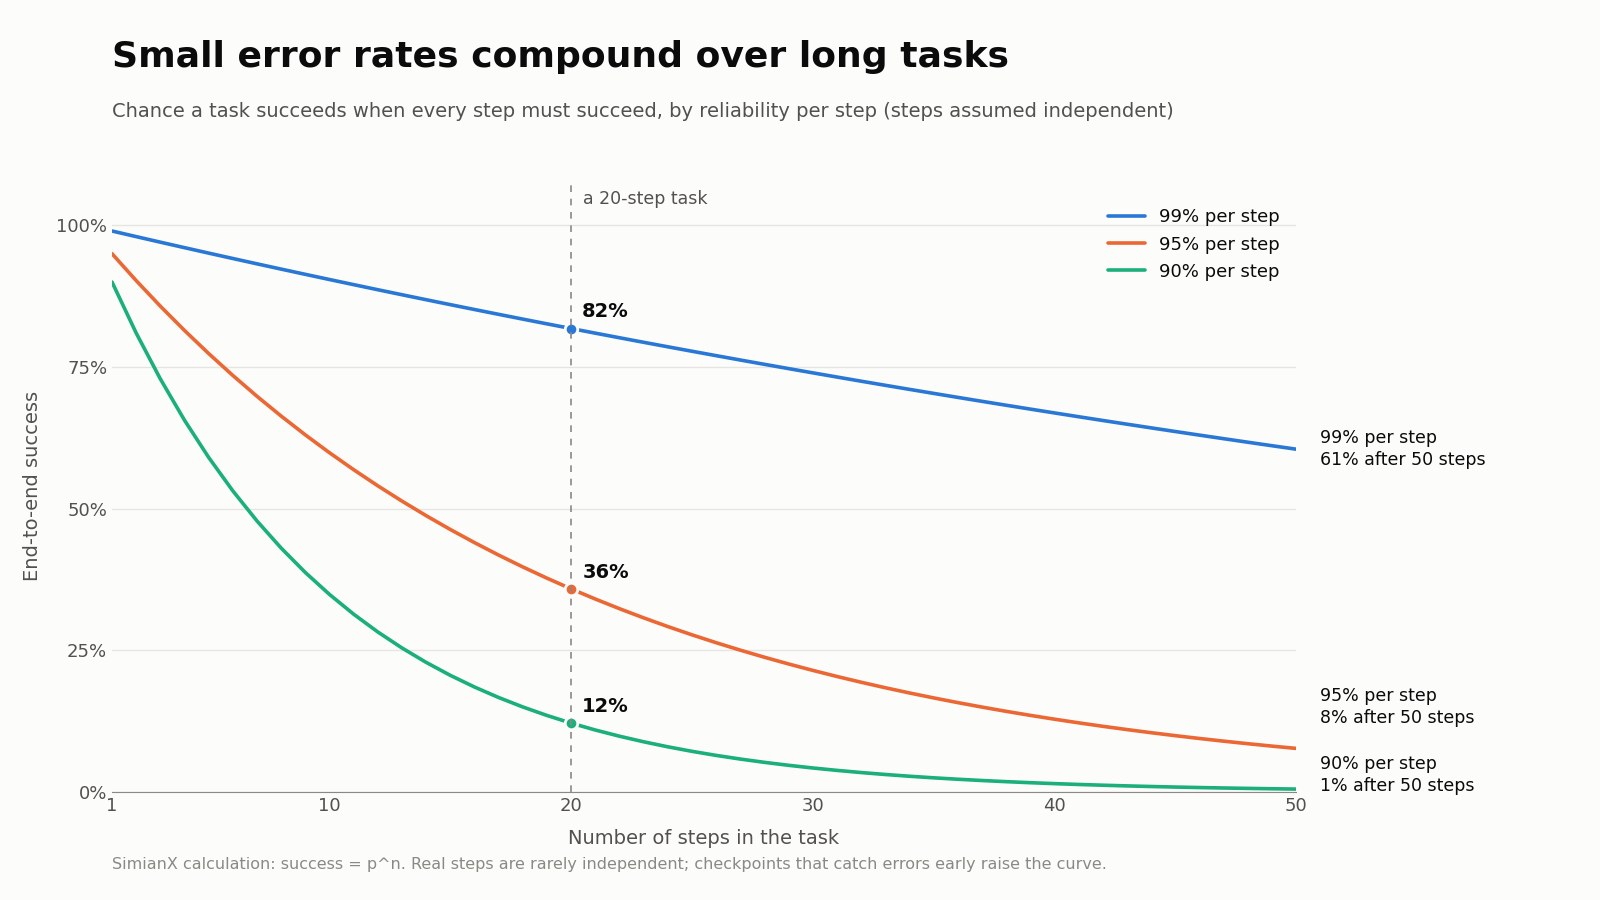
ข้อผิดพลาดที่ทบต้น
งานที่ยาวทำให้อัตราความผิดพลาดเล็กๆ คูณทวีขึ้น หากแต่ละขั้นของงานสำเร็จ 95% และแต่ละขั้นเป็นอิสระต่อกัน งาน 20 ขั้นจะสำเร็จเพียงราว 36% (0.95 ยกกำลัง 20) ถ้าแต่ละขั้นสำเร็จ 99% งานเดียวกันจะสำเร็จราว 82% นี่คือเหตุผลที่ความน่าเชื่อถือในแต่ละขั้นสำคัญกว่าความเก่งกาจในขั้นใดขั้นหนึ่ง และเป็นเหตุผลที่เอเจนต์ต้องมีจุดตรวจที่จับข้อผิดพลาดได้ก่อนที่ขั้นถัดไปจะต่อยอดจากมัน
อาการหลอนและการอ่านผลจากเครื่องมือผิด
โมเดลอาจแต่งข้อเท็จจริงขึ้นมา อ่านผลจากเครื่องมือผิด หรือนำตัวเลขเก่าไปใช้ต่อราวกับเป็นค่าปัจจุบัน เอเจนต์ทำให้ปัญหานี้แย่ลง เพราะค่าที่แต่งขึ้นอาจกลายเป็นข้อมูลนำเข้าของการกระทำถัดไป วิธีแก้อยู่ที่โครงสร้าง: ส่งต่อข้อมูลดิบแทนการถอดความ ตรวจตัวเลขสำคัญด้วยโค้ดแทนการเชื่อการคำนวณของโมเดล และกำหนดให้ทุกข้อกล่าวอ้างที่สำคัญต้องมีแหล่งที่มา
ต้นทุน
ทุกครั้งที่ผ่านวงรอบคือการเรียกโมเดลอีกหนึ่งครั้ง และบริบทก็ขยายใหญ่ขึ้นตามความคืบหน้าของงาน งานที่ดูถูกในการสาธิตอาจมีต้นทุนสูงกว่าหลายเท่าในการใช้งานจริง เมื่อเอเจนต์ลองใหม่ ทบทวน และอ่านซ้ำ จงตั้งงบประมาณตายตัวต่องาน และวัดต้นทุนของงานที่ เสร็จสมบูรณ์ ไม่ใช่ของการเรียกเพียงครั้งเดียว
ความหน่วง
เอเจนต์แลกความเร็วกับคุณภาพ คำตอบแชตใช้เวลาไม่กี่วินาที เอเจนต์ค้นคว้าอาจใช้เวลาหลายนาที และเอเจนต์เขียนโค้ดที่ทำการเปลี่ยนแปลงขนาดใหญ่อาจทำงานนานกว่านั้นมาก คณะกรรมการวิจัยเชิงลึกแปดเอเจนต์ของเราเองก็ใช้เวลาหลายนาทีต่อหุ้นหนึ่งตัว เพราะเอเจนต์ต้องค้นคว้า ถกเถียง และลงคะแนนก่อนจะเขียนอะไรออกมา
การประเมินผล
เอเจนต์ไม่ได้ให้ผลแน่นอนตายตัว งานเดียวกันอาจสำเร็จในรอบหนึ่งและล้มเหลวในรอบถัดไป ชุดทดสอบมาตรฐาน tau-bench ได้แนะนำตัวชี้วัดชื่อ pass^k ซึ่งคือโอกาสที่เอเจนต์จะทำงานเดียวกันสำเร็จครบทั้ง k ครั้ง และพบว่าแม้แต่เอเจนต์เรียกใช้ฟังก์ชันที่แข็งแกร่งในขณะนั้น ก็ทำสำเร็จครบทั้งแปดครั้งได้ไม่ถึง 25% ในโดเมนค้าปลีก การทำงานที่น่าประทับใจเพียงครั้งเดียวแทบไม่บอกอะไรคุณ ชุดทดสอบสาธารณะอย่าง SWE-bench สำหรับงานเขียนโค้ด และ OSWorld สำหรับการใช้คอมพิวเตอร์ มีประโยชน์ แต่ไม่ใช่งานของคุณ
ความปลอดภัยและสิทธิ์การเข้าถึง
เอเจนต์ที่อ่านหน้าเว็บหรืออีเมลอาจถูกชักจูงด้วยคำสั่งที่ซ่อนอยู่ในนั้น การโจมตีนี้เรียกว่า การแทรกคำสั่ง (prompt injection) ซึ่งอยู่อันดับหนึ่งใน รายการความเสี่ยงของแอปพลิเคชัน LLM ของ OWASP ให้สิทธิ์เอเจนต์เท่าที่จำเป็นที่สุด เก็บข้อมูลลับไว้นอกบริบทของมัน และกำหนดให้ต้องได้รับอนุมัติก่อนทำสิ่งที่ย้อนกลับไม่ได้ เช่น การโอนเงิน
ปัญหาเหล่านี้ส่งผลทางธุรกิจ ในประกาศเดือนมิถุนายน 2025 ฉบับเดียวกัน Gartner คาดการณ์ว่าโครงการ AI แบบเอเจนต์มากกว่า 40% จะถูกยกเลิกภายในสิ้นปี 2027 โดยอ้างถึงต้นทุนที่พุ่งสูง มูลค่าทางธุรกิจที่ไม่ชัดเจน และการควบคุมความเสี่ยงที่ไม่เพียงพอ
ตัวอย่างจริง: เอเจนต์ของ SimianX แบ่งงานตัดสินใจซื้อขายอย่างไร
การซื้อขายเป็นบททดสอบที่หนักสำหรับเอเจนต์ ข้อมูลไหลเข้ามาอย่างต่อเนื่อง ไม่มีใครรู้คำตอบที่ถูกต้องในตอนที่ตัดสินใจ และทุกการตัดสินใจจะถูกตลาดให้คะแนนในท้ายที่สุด ระบบของเราแบ่งงานดังนี้
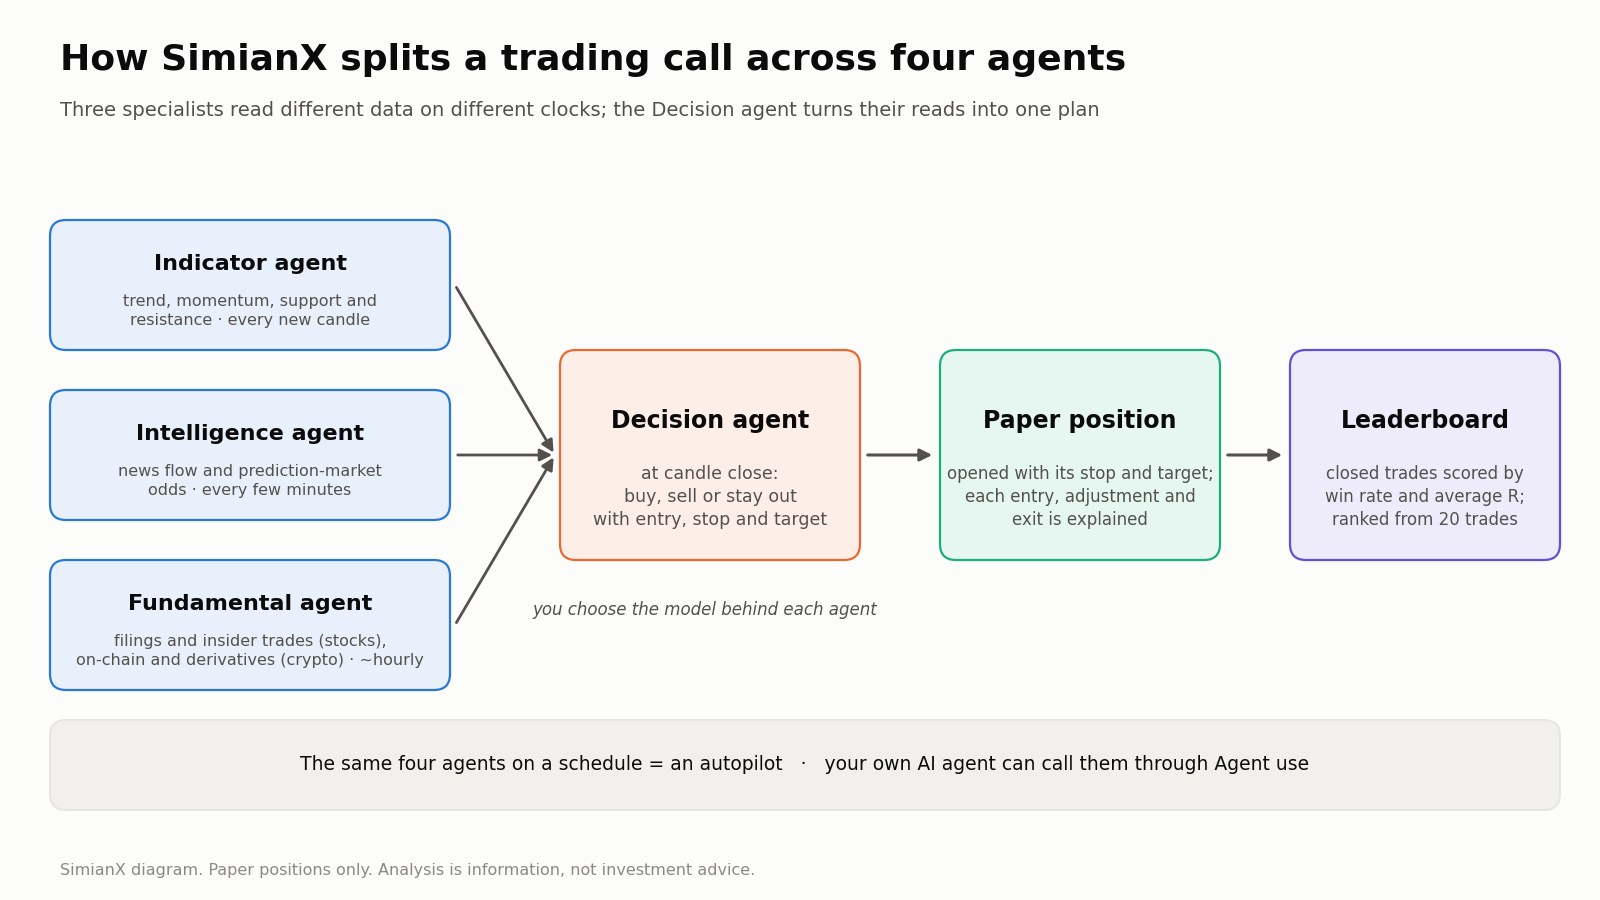
การวิเคราะห์สด: ผู้เชี่ยวชาญสามตัวกับเอเจนต์ตัดสินใจหนึ่งตัว
เมื่อคุณเปิดหุ้นสหรัฐฯ หรือคู่ซื้อขายคริปโตใน ห้องวิเคราะห์สด และเลือกกรอบเวลา เอเจนต์สี่ตัวจะเริ่มทำงาน ครอบคลุมหุ้นและ ETF ของสหรัฐฯ มากกว่า 13,000 ตัว และคู่ซื้อขายคริปโตมากกว่า 4,000 คู่ ตั้งแต่แท่งเทียน 1 นาทีขึ้นไป
- เอเจนต์ตัวชี้วัด อ่านกราฟ ได้แก่ แนวโน้ม แรงส่ง แนวรับ และแนวต้าน ทำงานทุกครั้งที่มีแท่งเทียนใหม่
- เอเจนต์ข่าวกรอง อ่านกระแสข่าวของสินทรัพย์นั้น และหากมี ก็อ่านค่าความน่าจะเป็นจากตลาดพยากรณ์ด้วย ปรับข้อมูลใหม่ทุกไม่กี่นาที
- เอเจนต์ปัจจัยพื้นฐาน อ่านรายงานที่ยื่นต่อหน่วยงานกำกับและการซื้อขายของคนวงในสำหรับหุ้น หรือข้อมูลบนบล็อกเชนและข้อมูลอนุพันธ์สำหรับเหรียญ ข้อมูลเหล่านี้เปลี่ยนช้า ค่าเริ่มต้นจึงปรับข้อมูลใหม่ราวชั่วโมงละครั้ง
- เอเจนต์ตัดสินใจ ชั่งน้ำหนักมุมมองของอีกสามตัวเมื่อแท่งเทียนปิด แล้วบอกว่าควรทำอะไร คือ ซื้อ ขาย หรืออยู่นอกตลาด พร้อมจุดเข้า จุดตัดขาดทุน และเป้าหมายราคา
เมื่อเกิดจังหวะการซื้อขาย ระบบจะเปิดสถานะจำลองด้วยจุดตัดขาดทุนและเป้าหมายนั้น จากนั้นอธิบายทุกการเข้า การปรับ และการออก ขณะที่การซื้อขายดำเนินไป คุณเลือกโมเดลเบื้องหลังเอเจนต์แต่ละตัวได้ เอเจนต์ทั้งสี่ตัวเดียวกันนี้ยังทำงานตามตารางเวลาในรูปแบบ ระบบนำทางอัตโนมัติ ได้ และกระแสข่าวที่ให้คะแนนแล้วซึ่งเอเจนต์ข่าวกรองใช้ ก็คือแหล่งข่าวชุดเดียวกับที่ขับเคลื่อน ชีพจรตลาด
ทำไมต้องแบ่งงานแบบนี้? ผู้เชี่ยวชาญทั้งสามทำงานตามจังหวะเวลาที่ต่างกัน การแยกพวกมันออกจากกันทำให้การอ่านกราฟปรับใหม่ได้ทุกแท่งเทียน โดยไม่ต้องเสียเงินอ่านรายงานที่ยังไม่เปลี่ยนซ้ำอีก มันยังทำให้บริบทของเอเจนต์แต่ละตัวเล็กและมีจุดเน้น และทำให้ความเห็นต่างมองเห็นได้: เมื่อกราฟบอกว่า "ทะลุแนวต้าน" แต่เอเจนต์ข่าวเตือนว่าพรุ่งนี้มีการประกาศผลประกอบการ เอเจนต์ตัดสินใจต้องจัดการกับความขัดแย้งนั้นโดยตรง แทนที่จะเฉลี่ยให้มันหายไป
การวิจัยเชิงลึก: คณะกรรมการแปดเอเจนต์
หากต้องการมุมมองที่ช้าลงและลึกขึ้นต่อหุ้นหรือเหรียญหนึ่งตัว การวิจัยเชิงลึก จะจัดตั้งคณะกรรมการแปดเอเจนต์ นักวิเคราะห์สี่ตัวค้นคว้าพร้อมกัน ได้แก่ ปัจจัยพื้นฐาน กราฟ ข่าว และที่นั่งที่สี่ ซึ่งเป็นมุมมองด้านจังหวะเวลาสำหรับหุ้น และเป็นนักวิเคราะห์อนุพันธ์สำหรับคริปโต จากนั้นนักวิจัยฝั่งขาขึ้นและนักวิจัยฝั่งขาลงจะสร้างข้อโต้แย้งที่แข็งแกร่งที่สุดของแต่ละฝ่าย ผู้จัดการฝ่ายวิจัยเป็นประธานการถกเถียงในประเด็นที่เห็นต่างกันมากที่สุด สมาชิกทุกตัวแถลงจุดยืนอีกครั้งในการลงคะแนนรอบสุดท้าย และผู้จัดการความเสี่ยงเขียนคำตัดสินพร้อมระดับราคาที่ผ่านการตรวจสอบแล้ว บทพาชมคณะกรรมการที่สร้างใหม่ ของเราติดตามการทำงานจริงหนึ่งรอบทีละหน้าจอ
นี่คือรูปแบบการโต้วาทีจากงานวิจัยที่นำมาใช้งานจริง นักวิจัยฝั่งขาลงมีอยู่ก็เพราะคณะกรรมการที่มีแต่นักวิเคราะห์ที่เห็นด้วยกันหมด แท้จริงก็คือความเห็นเดียวที่พูดซ้ำสี่ครั้ง
กระดานผู้นำวัดผลลัพธ์อย่างไร
เอเจนต์ที่ตัดสินใจซื้อขายต้องถูกให้คะแนนจากผลลัพธ์ ไม่ใช่จากความน่าเชื่อของการให้เหตุผล กระดานผู้นำคริปโต ให้คะแนนโมเดล AI ที่อยู่เบื้องหลังสถานะจำลองเหล่านี้ และนับเฉพาะการซื้อขายที่ปิดแล้วซึ่งชำระตามราคาตลาดจริงเท่านั้น ปัจจุบันครอบคลุมโมเดลมากกว่า 30 โมเดลจากห้องปฏิบัติการ AI หลายแห่ง และวัดแต่ละโมเดลสองแบบ:
- อัตราชนะ: สัดส่วนของการซื้อขายที่ปิดแล้วซึ่งจบด้วยกำไร
- ค่า R เฉลี่ย: กำไรต่อการซื้อขายหนึ่งครั้ง วัดเป็นหน่วยของความเสี่ยงที่รับไว้ตอนเข้า สถานะซื้อที่ 100 พร้อมจุดตัดขาดทุนที่ 98 มีความเสี่ยง 2 ต่อหน่วย ปิดที่ 104 คือ +2R และการโดนตัดขาดทุนเต็มจำนวนคือ −1R
โมเดลจะถูกจัดอันดับก็ต่อเมื่อมีการซื้อขายที่ปิดแล้ว 20 ครั้งภายใต้ตัวกรองปัจจุบัน การซื้อขายที่โชคดีเพียงไม่กี่ครั้งจึงดันโมเดลขึ้นอันดับหนึ่งไม่ได้ และคุณกรองตามช่วงเวลา กรอบเวลา และฝั่งซื้อขายได้ การอ่านตัวเลขทั้งสองร่วมกันเป็นเรื่องสำคัญ: อัตราชนะสูงแต่ค่า R ต่ำอาจซ่อนการขาดทุนก้อนใหญ่ไม่กี่ครั้ง ส่วนอัตราชนะปานกลางแต่ค่า R สูงอาจหมายถึงกำไรที่น้อยครั้งกว่าแต่ก้อนใหญ่กว่า เราเปรียบเทียบโมเดลเบื้องหลังกระดานนี้ไว้ใน โมเดล AI ตัวไหนซื้อขายเก่งที่สุด? และใน คู่มือเปรียบเทียบ GPT, Gemini และ Claude ของเรา
เชื่อมต่อเอเจนต์ของคุณเอง
ระบบเดียวกันนี้เปิดให้เอเจนต์ภายนอกใช้ได้ หน้า ใช้งานผ่านเอเจนต์ อธิบายวิธีมอบชุดทักษะ (skill) ของ SimianX และคีย์ API ให้กับ Claude Code, Codex, Cursor หรือเอเจนต์อื่น เพื่อให้มันเริ่มการวิเคราะห์สดด้วยเอเจนต์สี่ตัวกับสินทรัพย์ใดก็ได้ ติดตามกระแสข่าวที่ให้คะแนนแล้ว หรือสั่งการวิจัยเชิงลึก เอเจนต์ของคุณจะได้คีย์ของตัวเองพร้อมงบประมาณที่คุณกำหนด มันจะไม่ได้ข้อมูลเข้าสู่ระบบเว็บไซต์ของคุณ และทุกสถานะที่มันจัดการเป็นสถานะจำลอง
หมายเหตุความเสี่ยง: ทุกอย่างข้างต้นอธิบายซอฟต์แวร์ที่สร้างบทวิเคราะห์และการซื้อขายจำลอง ซึ่งเป็นข้อมูล ไม่ใช่คำแนะนำการลงทุน โมเดล AI ทำผิดพลาดได้ ผลบนกระดานผู้นำเป็นการซื้อขายในอดีตและไม่ได้ทำนายผลตอบแทนในอนาคต และไม่มีโมเดลหรือคณะกรรมการใดขจัดความเสี่ยงของตลาดได้ อย่านำเงินที่คุณเสียไม่ได้ไปซื้อขายเพียงเพราะคำตัดสินของ AI
ประเภทของเอเจนต์ AI ในปี 2026
การจำแนกตามตำรา
ตำราจำแนกเอเจนต์ตามวิธีการตัดสินใจ และหมวดหมู่เหล่านี้ยังช่วยอธิบายระบบสมัยใหม่ได้:
| ประเภท | วิธีตัดสินใจ | ตัวอย่าง |
|---|---|---|
| เอเจนต์แบบตอบสนองอย่างง่าย | กฎเงื่อนไขกับการกระทำที่ตายตัวต่อข้อมูลนำเข้าปัจจุบัน | เทอร์โมสตัต การแจ้งเตือนราคา |
| เอเจนต์แบบตอบสนองที่มีแบบจำลอง | กฎบวกภาพภายในของสิ่งที่สังเกตโดยตรงไม่ได้ | ตัวกรองสแปมที่ติดตามประวัติของผู้ส่ง |
| เอเจนต์แบบมุ่งเป้าหมาย | ค้นหาการกระทำที่นำไปสู่เป้าหมายที่กำหนด | ระบบวางแผนเส้นทาง |
| เอเจนต์แบบอรรถประโยชน์ | เลือกการกระทำที่ให้ได้เสียคาดหวังดีที่สุด | เอเจนต์ซื้อขายที่ชั่งผลตอบแทนกับความเสี่ยง |
| เอเจนต์แบบเรียนรู้ | ปรับปรุงพฤติกรรมจากผลป้อนกลับ | ระบบแนะนำที่ปรับตามการคลิก |
เอเจนต์ที่ใช้โมเดลภาษาผสมประเภทเหล่านี้เข้าด้วยกัน มันมุ่งเป้าหมายในสิ่งที่ไล่ตาม ใช้หลักอรรถประโยชน์เมื่อชั่งน้ำหนักทางเลือก และเรียนรู้ภายในงานด้วยการทบทวนผลลัพธ์
หมวดหมู่ผลิตภัณฑ์
หากจัดกลุ่มตามสิ่งที่ทำจริง เอเจนต์ที่ผู้คนใช้ในปี 2026 แบ่งได้เป็นห้าหมวดกว้างๆ ผลิตภัณฑ์ที่กล่าวถึงเป็นเพียงตัวอย่าง ไม่ใช่การรับรอง และความสามารถของผลิตภัณฑ์เหล่านี้เปลี่ยนไปอย่างรวดเร็ว
เอเจนต์เขียนโค้ด เอเจนต์ AI สำหรับเขียนโค้ดอ่านคลังโค้ด แก้ไขไฟล์ เรียกใช้ชุดทดสอบ และเสนอการเปลี่ยนแปลง ซึ่งมักอยู่ในรูปคำขอรวมโค้ด (pull request) ตัวอย่างเช่น Claude Code ของ Anthropic, Codex ของ OpenAI, เอเจนต์เขียนโค้ดใน GitHub Copilot, Cursor และ Devin ของ Cognition เอเจนต์เหล่านี้มักถูกเปรียบเทียบด้วย SWE-bench ซึ่งให้แก้ปัญหาจริงจากโครงการโอเพนซอร์ส งานวิจัยของ METR ชี้ว่าความยาวของงานซอฟต์แวร์ที่เอเจนต์ระดับแนวหน้าทำสำเร็จได้ด้วยความน่าเชื่อถือ 50% เพิ่มขึ้นเป็นสองเท่าราวทุกเจ็ดเดือน นับตั้งแต่ปี 2019
เอเจนต์ค้นคว้า ค้นหาเว็บหรือคลังเอกสาร อ่านแหล่งข้อมูลจำนวนมาก และเขียนรายงานพร้อมการอ้างอิง Google เปิดตัว Gemini Deep Research ในเดือนธันวาคม 2024 และ OpenAI เปิดตัว deep research (การค้นคว้าเชิงลึก) ใน ChatGPT ในเดือนกุมภาพันธ์ 2025 จุดอ่อนของเอเจนต์กลุ่มนี้คือคุณภาพของแหล่งข้อมูล รายงานที่เขียนดีอาจยังตั้งอยู่บนแหล่งข้อมูลที่ไม่ดี
เอเจนต์เบราว์เซอร์และเอเจนต์ใช้คอมพิวเตอร์ ควบคุมเบราว์เซอร์หรือเดสก์ท็อปทั้งเครื่องด้วยการมองหน้าจอ คลิก และพิมพ์ Anthropic เปิดตัว computer use (การใช้คอมพิวเตอร์) ในเดือนตุลาคม 2024 ส่วน Operator ของ OpenAI ที่เปิดตัวในเดือนมกราคม 2025 ถูกรวมเข้ากับ ChatGPT agent ในเดือนกรกฎาคม 2025 และ Google มี Project Mariner เอเจนต์กลุ่มนี้ช้ากว่าและน่าเชื่อถือน้อยกว่าเอเจนต์ที่ทำงานผ่าน API จึงมักใช้กับเว็บไซต์ที่ไม่มี API ให้
เอเจนต์อเนกประสงค์ รับเป้าหมายกว้างๆ แล้วผสานการท่องเว็บ โค้ด และไฟล์เพื่อทำให้สำเร็จ Manus ซึ่งเปิดตัวในเดือนมีนาคม 2025 เป็นตัวอย่างที่รู้จักกันดีที่สุด Meta ตกลงซื้อกิจการบริษัทนี้ในเดือนธันวาคม 2025 แต่ในเดือนเมษายน 2026 คณะกรรมการพัฒนาและปฏิรูปแห่งชาติของจีน สั่งให้ยกเลิกข้อตกลงนี้
เอเจนต์ซื้อขายและวิเคราะห์ตลาด อ่านข้อมูลตลาด ข่าว และรายงานที่ยื่นต่อหน่วยงานกำกับ แล้วจัดทำแผนการซื้อขายหรือจัดการสถานะ กรอบงานทางวิชาการอย่าง TradingAgents (Xiao และคณะ, 2024) จำลองบริษัทซื้อขายที่มีบทบาทนักวิเคราะห์ นักวิจัย ผู้ซื้อขาย และการบริหารความเสี่ยง ส่วนผลิตภัณฑ์อย่าง SimianX ใช้คณะกรรมการลักษณะคล้ายกันกับข้อมูลสด ตลาดเป็นสนามที่มีฝ่ายตรงข้ามและเต็มไปด้วยสัญญาณรบกวน หมวดนี้จึงเป็นหมวดที่ประวัติผลงานแบบสาธารณะซึ่งแจกแจงทีละรายการซื้อขายสำคัญที่สุด
วิธีประเมินเอเจนต์ AI: รายการตรวจสอบ
ไม่ว่าคุณจะเลือกเอเจนต์เขียนโค้ด เครื่องมือค้นคว้า หรือผู้ช่วยซื้อขาย คำถามชุดเดียวกันนี้แยกเอเจนต์ที่ใช้งานได้จริงออกจากของสาธิต
| คำถาม | ลักษณะที่ดี | สัญญาณอันตราย |
|---|---|---|
| เป็นเอเจนต์จริงหรือไม่? | เลือกขั้นตอนและเครื่องมือเอง | สคริปต์ตายตัวที่ติดป้าย "เอเจนต์" |
| ใช้ได้กับงานของคุณหรือไม่? | ทดสอบกับงานจริง 10–20 ชิ้นจากงานของคุณเอง | มีแค่การสาธิตของผู้ขายและคะแนนชุดทดสอบ |
| สม่ำเสมอหรือไม่? | ผลใกล้เคียงกันเมื่อทำงานเดียวกันหลายครั้ง | ทำได้ดีครั้งเดียว แล้วล้มเหลว |
| งานที่เสร็จหนึ่งชิ้นมีต้นทุนเท่าไร? | วัดและกำหนดเพดานต้นทุนต่องานที่เสร็จ | บอกแค่ราคาต่อการเรียกหนึ่งครั้ง |
| ใช้เวลานานแค่ไหน? | ความเร็วเหมาะกับงาน | รอหลายนาทีเพื่อคำตอบบรรทัดเดียว |
| เห็นได้ไหมว่ามันทำอะไรไป? | บันทึกครบทุกขั้นตอน การเรียกเครื่องมือ และแหล่งที่มา | มีแต่คำตอบสุดท้ายโดยไม่มีร่องรอย |
| มันแตะต้องอะไรได้บ้าง? | สิทธิ์น้อยที่สุดเท่าที่จำเป็น สภาพแวดล้อมแยกหรือโหมดจำลอง และต้องอนุมัติก่อนทำสิ่งที่ย้อนกลับไม่ได้ | ข้อมูลรับรองที่ครอบคลุมกว้างและไม่มีขั้นตอนอนุมัติ |
| มันหยุดอย่างไร? | งบประมาณ เพดานจำนวนขั้นตอน และกฎการหยุดที่ชัดเจน | วนซ้ำจนกว่าจะมีคนสังเกตเห็น |
| ข้อมูลใหม่แค่ไหน? | มีเวลากำกับข้อมูลทุกจุด | ตัวเลขเก่าที่ถูกนำเสนอเหมือนเป็นปัจจุบัน |
| สำหรับเอเจนต์ซื้อขาย: ประวัติผลงานเป็นอย่างไร? | การซื้อขายที่ปิดแล้วตามราคาจริง แสดงขนาดตัวอย่าง และแสดงทั้งอัตราชนะกับผลตอบแทนที่ปรับตามความเสี่ยง | มีแค่การทดสอบย้อนหลัง หรืออัตราชนะที่ไม่บอกจำนวนการซื้อขาย |
คำถามที่พบบ่อย
เอเจนต์ AI คืออะไร อธิบายแบบง่ายๆ?
เอเจนต์ AI คือโปรแกรมที่ใช้โมเดล AI ไปให้ถึงเป้าหมายได้ด้วยตัวเอง มันดูสถานการณ์ ตัดสินใจขั้นตอนหนึ่ง ใช้เครื่องมืออย่างการค้นหาหรือโค้ดเพื่อลงมือ ตรวจผลลัพธ์ และทำซ้ำจนงานเสร็จหรือจนต้องการคนช่วย
เอเจนต์ AI ต่างจากแชตบอตอย่างไร?
แชตบอตตอบทีละข้อความแล้วรอคุณ เอเจนต์ทำงานต่อไปสู่เป้าหมายตลอดหลายขั้นตอน เลือกเองว่าจะใช้เครื่องมือใด และทำงานให้เสร็จได้ เช่น แก้โค้ดหรือเขียนรายงาน โดยไม่ต้องรับคำสั่งใหม่ทุกขั้นตอน
ระบบหลายเอเจนต์คืออะไร?
ระบบหลายเอเจนต์คือกลุ่มเอเจนต์ AI ที่มีบทบาทต่างกันและทำงานชิ้นเดียวกัน อาจแบ่งงานกัน โต้วาทีกันคนละฝั่ง หรือลงคะแนน แล้วให้เอเจนต์ตัวสุดท้ายหรือกฎที่กำหนดไว้รวมผลลัพธ์ ในงานกว้างๆ ระบบนี้มักทำได้ดีกว่าเอเจนต์เดี่ยว แต่ต้นทุนสูงกว่ามาก
เอเจนต์ AI สำหรับเขียนโค้ดคืออะไร?
เอเจนต์ AI สำหรับเขียนโค้ดทำงานภายในโครงการซอฟต์แวร์ มันอ่านโค้ด แก้ไขไฟล์ เรียกใช้ชุดทดสอบ และเสนอการเปลี่ยนแปลง ตัวอย่างเช่น Claude Code, OpenAI Codex, เอเจนต์เขียนโค้ดใน GitHub Copilot, Cursor และ Devin
Manus AI คืออะไร?
Manus คือเอเจนต์ AI อเนกประสงค์ที่เปิดตัวในเดือนมีนาคม 2025 ซึ่งรับเป้าหมายกว้างๆ แล้วใช้การท่องเว็บ โค้ด และไฟล์เพื่อทำให้สำเร็จ Meta ตกลงซื้อกิจการบริษัทนี้ในเดือนธันวาคม 2025 และในเดือนเมษายน 2026 หน่วยงานกำกับของจีนสั่งให้ยกเลิกข้อตกลงดังกล่าว
เอเจนต์ AI ซื้อขายหุ้นหรือคริปโตได้ไหม?
เอเจนต์วิเคราะห์ตลาดและจัดการสถานะได้ และผลิตภัณฑ์บางตัว รวมถึง SimianX ให้เอเจนต์บริหารสถานะจำลองพร้อมจุดตัดขาดทุนและเป้าหมาย ผลลัพธ์แตกต่างกันมากตามโมเดลและตลาด จึงควรตัดสินเอเจนต์ซื้อขายทุกตัวจากประวัติการซื้อขายที่ปิดแล้ว และถือว่าผลลัพธ์ของมันเป็นข้อมูล ไม่ใช่คำแนะนำ
ฉันจะเชื่อมต่อเอเจนต์ AI ของตัวเองเข้ากับการวิเคราะห์ตลาดแบบสดได้อย่างไร?
หน้า ใช้งานผ่านเอเจนต์ ของ SimianX แสดงวิธีติดตั้งชุดทักษะของ SimianX ใน Claude Code, Codex, Cursor และเอเจนต์อื่นๆ เอเจนต์ของคุณจะได้คีย์ API ของตัวเองพร้อมงบประมาณที่คุณควบคุม และสามารถเริ่มการวิเคราะห์สดแบบหลายเอเจนต์ ติดตามกระแสข่าวที่ให้คะแนนแล้ว และสั่งการวิจัยเชิงลึกได้
อ่านเพิ่มเติม
- วิเคราะห์หุ้นด้วย AI โฉมใหม่: คณะกรรมการ 8 เอเจนต์ที่คุณถามต่อได้
- 8 AI นักวิเคราะห์ vs 1: +37% แม่นยำ, −41% เสี่ยงน้อยกว่ามาก
- โมเดล AI ตัวไหนเทรดเก่งที่สุด? 30 LLM ที่วัดด้วย P&L จริง
- 30+ โมเดล AI, 6 ผู้ให้บริการ: ลีดเดอร์บอร์ดคริปโตสด ปี 2026
- GPT vs Gemini vs Claude: คู่มือวิเคราะห์หุ้น AI ปี 2026
- AI หลายเอเจนต์ vs ChatGPT สำหรับ NVDA: เปรียบเทียบปี 2026
- AI crypto autopilot เทรด 24/7 ได้อย่างไร (คู่มือฉบับสมบูรณ์ 2026)
- วิเคราะห์หุ้นสด: AI เอเจนต์ครอบคลุมหุ้นสหรัฐแบบเรียลไทม์
- Agentic AI ลงทุน: คู่มือมือใหม่สำหรับตลาดยุคใหม่ฉบับเต็ม
แหล่งอ้างอิง
- รัสเซลล์และนอร์วิก — ปัญญาประดิษฐ์: แนวทางสมัยใหม่ (Artificial Intelligence: A Modern Approach)
- Anthropic — Building Effective Agents (ธันวาคม 2024)
- Anthropic — How we built our multi-agent research system (มิถุนายน 2025)
- Yao และคณะ — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn และคณะ — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du และคณะ — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri และคณะ — Why Do Multi-Agent LLM Systems Fail?
- Yao และคณะ — tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao และคณะ — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — เอกสารทางการ
- โปรโตคอล Agent2Agent (A2A) — เว็บไซต์ทางการ
- Gartner — โครงการ AI แบบเอเจนต์กว่า 40% จะถูกยกเลิกภายในสิ้นปี 2027 (มิถุนายน 2025)
- TechCrunch — จีนสกัดข้อตกลงซื้อ Manus มูลค่า 2 พันล้านดอลลาร์ของ Meta (เมษายน 2026)
- IBM — เอเจนต์ AI คืออะไร?
- OWASP — 10 ความเสี่ยงสูงสุดของแอปพลิเคชันโมเดลภาษาขนาดใหญ่