GPT vs Gemini vs Claude pour l'analyse boursière AI : Guide 2026
GPT vs Gemini vs Claude pour l'analyse boursière AI n'est plus une simple question de « quel chatbot donne la réponse la plus intelligente ? » En 2026, les investisseurs sérieux ont besoin d'un flux de travail capable de lire les dépôts, d'analyser les appels de résultats, d'examiner les graphiques, de comparer les évaluations, de suivre les nouvelles en direct, d'expliquer l'incertitude et de produire une note de recherche prête à la décision. C'est pourquoi ce guide va au-delà du battage médiatique des modèles et compare GPT, Gemini, Claude, et l'approche multi-agents utilisée par SimianX AI pour une recherche de marché pratique. Ce guide confronte également les trois familles à 4 992 positions gérées par IA en direct issues de notre propre salle de commandement, car la comparaison la plus révélatrice n'est pas de savoir quel modèle paraît le plus intelligent, mais comment l'entraînement de chaque laboratoire se manifeste quand une position perd de l'argent.
Pourquoi l'analyse boursière AI a besoin de plus d'un modèle intelligent
Une décision de recherche boursière n'est pas seulement un problème de langage. C'est un problème de raisonnement multi-signal. Un modèle peut bien résumer un 10-K mais manquer un catalyseur en direct. Un autre peut être excellent dans la lecture à long terme mais plus faible dans l'analyse de sensibilité de style tableur. Un troisième peut rédiger des mémos d'investissement soignés mais dépendre fortement de la qualité des données connectées.
Pour la recherche boursière AI, le système le plus utile doit répondre à des questions telles que :
- Qu'est-ce qui a changé lors du dernier appel de résultats ?
- Les multiples d'évaluation s'élargissent-ils plus rapidement que les revenus ou les flux de trésorerie disponibles ?
- Le momentum est-il soutenu par le volume, ou l'action des prix est-elle fragile ?
- Le sentiment des nouvelles contredit-il les fondamentaux ?
- Quelles hypothèses soutiennent les scénarios optimistes et pessimistes ?
- Qu'est-ce qui rendrait la thèse erronée ?
Point clé à retenir : Le meilleur AI pour l'analyse boursière n'est généralement pas un modèle unique. C'est un flux de travail qui combine des données fraîches, un raisonnement spécialisé, des citations transparentes, des vérifications de risque et un examen humain.
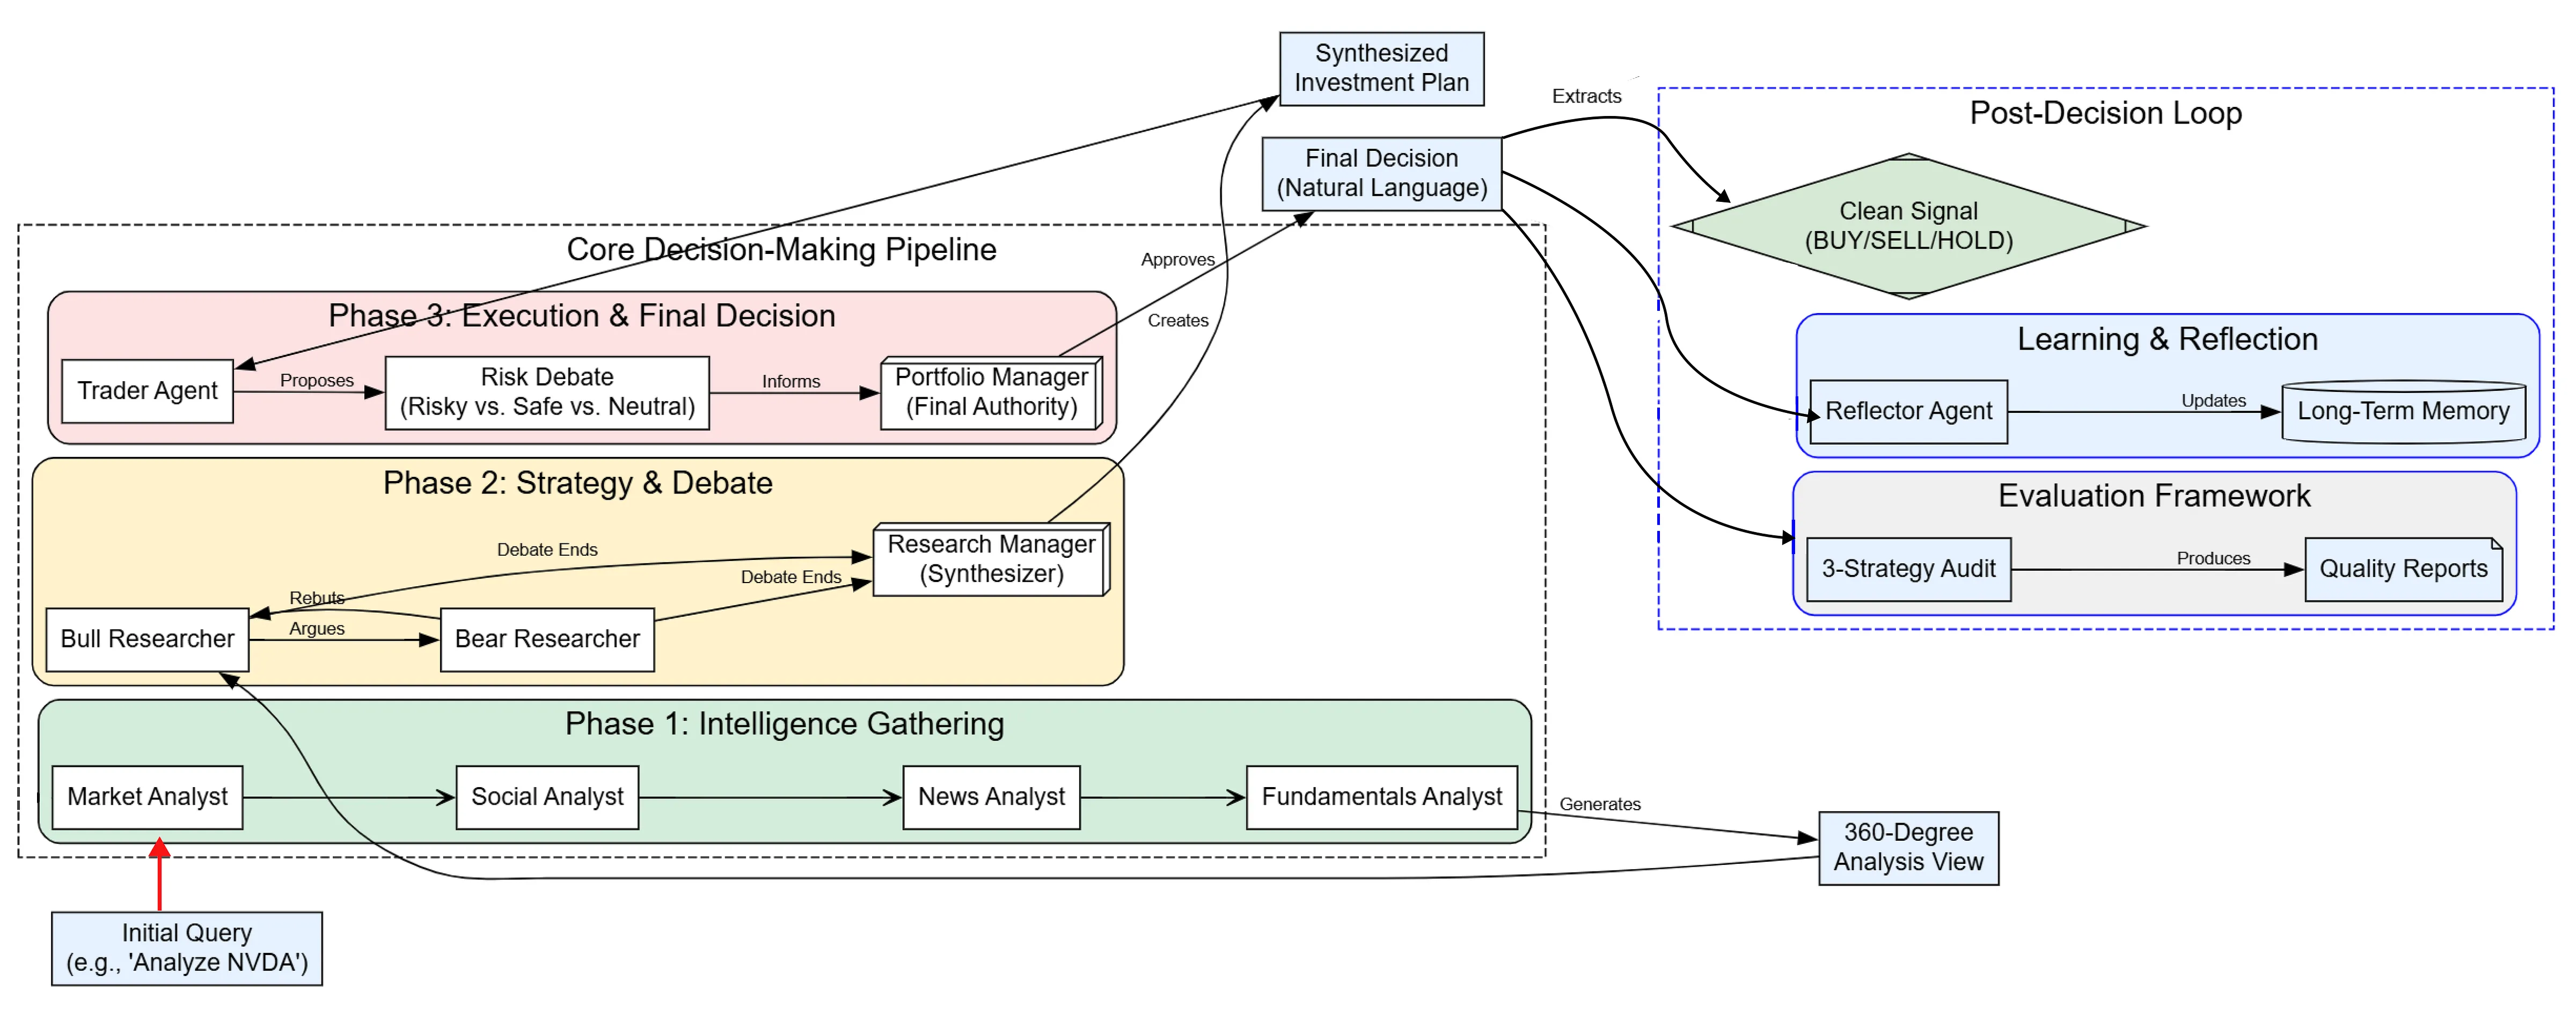
C'est ici que l'analyse boursière multi-agents devient importante. SimianX AI utilise une approche multi-agents pour aider les investisseurs à comparer les fondamentaux, la structure du marché, les signaux techniques, le sentiment et le risque de manière plus structurée qu'une réponse unique d'un chatbot.
GPT vs Gemini vs Claude pour l'analyse boursière AI : Verdict rapide
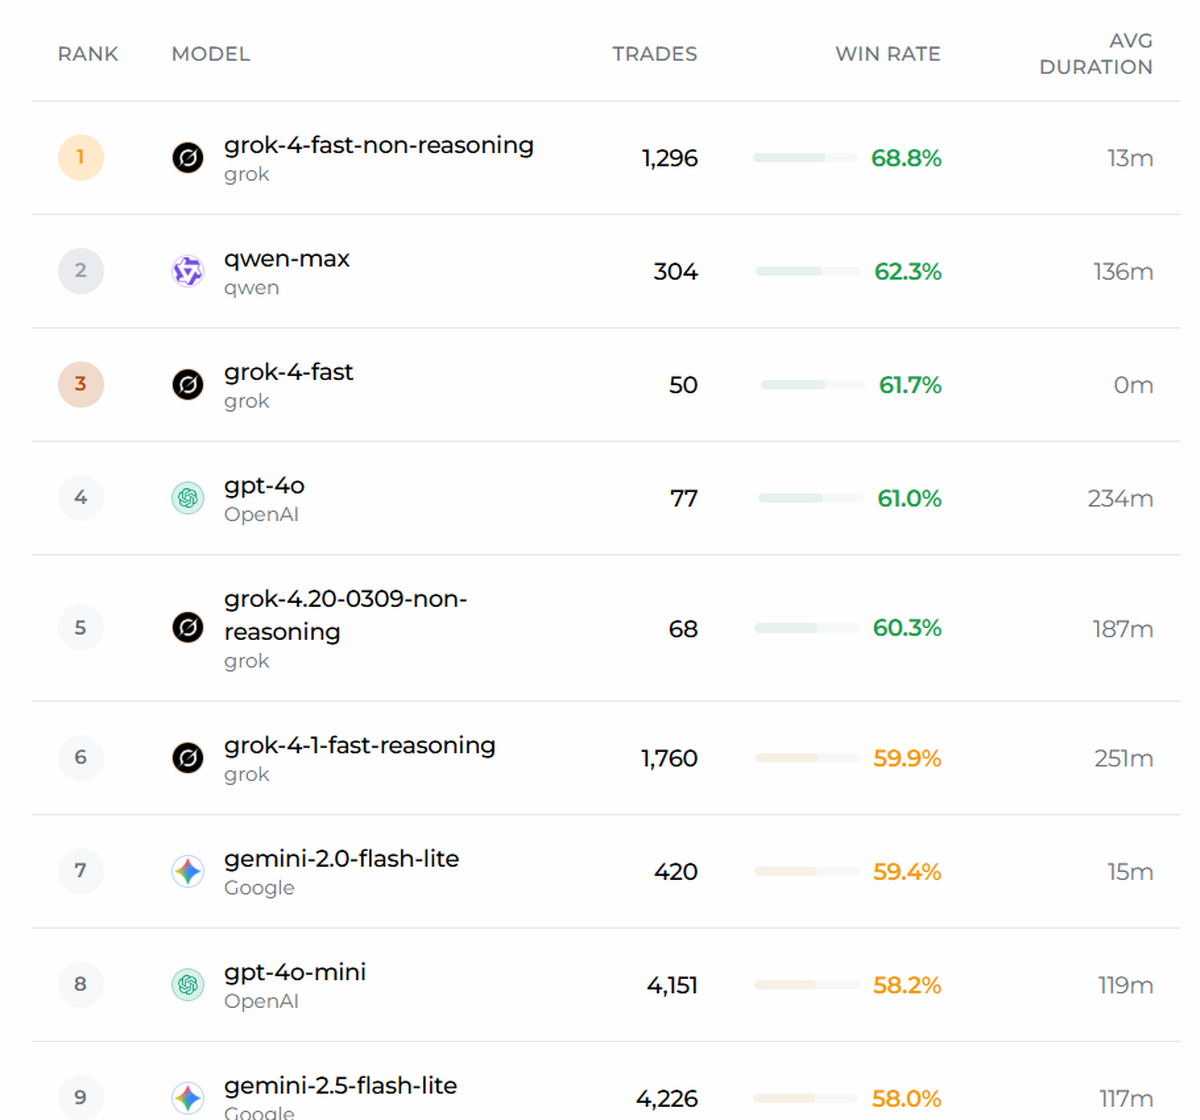
Chaque famille de modèles a un “meilleur usage” différent dans la recherche boursière. La réponse pratique dépend de si vous avez besoin d'analyse de données, de recherche à long terme, d'intégration de flux de travail financiers, ou de débat multi-agents.
| Plateforme | Cas d'utilisation d'analyse boursière le plus fort | Précautions | Mieux associé avec |
|---|---|---|---|
| GPT / ChatGPT | Analyse soutenue par le code, modélisation de scénarios, tableaux, graphiques, synthèse de recherche | Nécessite des sources vérifiées et une conception de prompt soignée | Vérifications de données de style Python, dépôts, modèles d'évaluation |
| Gemini | Recherche à long terme, multimodale, grands PDF, rapports de recherche, graphiques | La qualité de la sortie dépend de la sélection des sources et de la configuration | Ensembles de documents volumineux, cartes de marché, synthèse de notes d'analystes |
| Claude | Flux de travail financiers professionnels, rédaction soignée, livrables de style Excel/PowerPoint | Les fonctionnalités financières d'entreprise peuvent dépendre d'un accès payant/connecteurs | Mémos d'investissement, pitchbooks, révision de modèles, flux de travail de conformité |
| SimianX AI | Analyse boursière multi-agents avec des couches techniques, fondamentales, d'actualités et de débat | Nécessite toujours le jugement de l'investisseur ; aucune IA ne peut garantir des rendements | Traders et chercheurs qui souhaitent une diversité de modèles dans un seul flux de travail |
Les modèles GPT d'OpenAI sont souvent utiles pour un raisonnement financier structuré, une analyse de données personnalisée et une modélisation de scénarios. Google Gemini est convaincant pour une recherche large et riche en documents, en particulier lors de la comparaison de dépôts, de rapports, d'images et de contextes longs. Claude est fort lorsque la sortie doit ressembler à un mémo financier professionnel, un plan de pitchbook ou un bref de comité d'investissement.
GPT pour l'analyse boursière : Meilleur pour le travail de données et la modélisation de scénarios
GPT est particulièrement utile lorsque la tâche de recherche implique de transformer des données financières désordonnées en analyses structurées. Dans un flux de travail de recherche boursière, cela peut signifier inspecter des fichiers téléchargés, créer des tableaux et des graphiques, calculer des taux de croissance et expliquer des hypothèses en langage clair. GPT peut aider à analyser l'historique des prix exportés, nettoyer un CSV de métriques trimestrielles ou construire un simple modèle de flux de trésorerie actualisé à partir d'hypothèses fournies par l'utilisateur.
Par exemple, un flux de travail boursier alimenté par GPT pourrait ressembler à ceci :
- Télécharger une feuille de calcul des revenus, de la marge brute, du résultat d'exploitation, du flux de trésorerie disponible et du nombre d'actions.
- Demander à GPT de calculer la croissance composée, les tendances de marge et la conversion du flux de trésorerie disponible.
- Demander des hypothèses de scénario haussier, de base et baissier.
- Générer un tableau d'évaluation en utilisant
EV/Ventes,EV/EBITDAouC/B. - Comparer les résultats avec les dépôts réels et les données du marché.
Le plus grand avantage de GPT est son raisonnement flexible avec une analyse soutenue par du code. Il est très bon pour transformer des entrées brutes en calculs, graphiques et explications écrites. Pour les investisseurs qui ont déjà des données provenant de dépôts auprès de la SEC, d'APIs financières ou d'une feuille de calcul, GPT peut devenir un puissant assistant de recherche.
Cependant, GPT n'est pas automatiquement un choix fiable d'actions. Si vous demandez : « Devrais-je acheter NVDA aujourd'hui ? » sans fournir d'horizon temporel, de tolérance au risque, de contexte de portefeuille ou de source de données en direct, la réponse peut sembler confiante tout en étant incomplète. Utilisez GPT pour la construction d'analyses, pas pour l'exécution aveugle de transactions.
Quand devriez-vous utiliser GPT pour la recherche sur le marché boursier ?
Utilisez GPT lorsque vous devez modéliser, calculer, expliquer et documenter. Il fonctionne bien pour les écrans personnalisés, l'analyse de scénarios, les modèles de résumé des bénéfices, les tableaux d'exposition de portefeuille et les explications en langage simple de ratios complexes. Il est également utile pour vérifier si votre propre thèse a des hypothèses manquantes.
Un bon prompt GPT pour l'analyse boursière pourrait être :
Analysez les 12 derniers trimestres de revenus, de marge brute, de marge d'exploitation, de flux de trésorerie libre, de dette et de nombre d'actions de cette entreprise. Identifiez les ruptures de tendance, calculez les plages d'évaluation haussière/base/baissière et listez les cinq hypothèses les plus susceptibles d'être erronées.
Ce prompt fonctionne parce qu'il demande une analyse structurée, des calculs et de l'incertitude, pas seulement une réponse d'achat/vente.
Gemini pour l'analyse boursière : Meilleur pour la recherche à long terme et la synthèse de sources
Le principal avantage de Gemini est la recherche multimodale à long contexte. Pour l'analyse boursière, cela a de l'importance car la recherche sur les entreprises publiques s'étend souvent aux rapports annuels, aux dépôts trimestriels, aux transcriptions, aux vidéos de produits, aux PDF réglementaires, aux commentaires des analystes et aux documents macro. Un modèle capable de traiter de grandes fenêtres de contexte peut comparer beaucoup plus de matériel source dans un seul flux de travail.
Cela rend Gemini utile pour des questions telles que :
- “Comparez les trois derniers rapports annuels de
AAPL,MSFTetGOOGLpour le langage des dépenses en capital en IA.”
- “Résumez chaque changement de facteur de risque sur deux ans de dépôts.”
- “Créez une carte du marché de l'exposition à la chaîne d'approvisionnement des semi-conducteurs.”
- “Extrayez et comparez le ton de la direction à partir de cinq transcriptions d'appels de résultats.”
- “Construisez un bref de recherche adapté aux graphiques à partir de plusieurs PDF.”
Gemini est le plus puissant lorsque la tâche est large, riche en documents et multimodale. Il peut aider les investisseurs à trouver des modèles à travers de grands corpus de recherche qui seraient fastidieux à inspecter manuellement.
L'avertissement est que la capacité à traiter de grands contextes ne signifie pas automatiquement un meilleur jugement d'investissement. Si les sources sont obsolètes, biaisées, promotionnelles ou incomplètes, le résultat peut toujours être défectueux. Dans la recherche sur les actions, la sélection des sources fait partie de l'analyse. Gemini est puissant lorsque vous lui fournissez des dépôts de haute qualité, des transcriptions, des données de marché et des sources de recherche.
Claude pour l'analyse des actions AI : Meilleur pour les flux de travail financiers professionnels
L'avantage de Claude est la discipline de flux de travail. Claude est souvent utile lorsque la recherche financière doit devenir un livrable écrit soigné, tel qu'un mémo d'investissement, un résumé des bénéfices, une mise à jour de portefeuille ou une note de diligence raisonnable. Son style d'écriture peut être soigné, équilibré et facile à adapter pour des lecteurs professionnels.
Cela rend Claude précieux pour :
- Rédiger des mémos d'investissement avec un raisonnement équilibré
- Examiner la méthodologie d'évaluation
- Construire ou vérifier des modèles financiers
- Préparer des livrables de style pitchbook
- Résumer des transcriptions de bénéfices
- Créer des commentaires prêts pour le conseil d'administration ou les clients
- Tester une thèse avant une réunion du comité d'investissement
La limitation de Claude est l'accès pratique. Les flux de travail les plus spécifiques à la finance peuvent dépendre des connecteurs disponibles, des fonctionnalités payantes ou des téléchargements manuels. Pour un investisseur individuel, Claude peut toujours être excellent pour le raisonnement et l'écriture, mais le pipeline de données peut nécessiter des outils externes.
Quelle est la meilleure façon de comparer GPT vs Gemini vs Claude pour l'analyse des actions AI ?
La meilleure façon de comparer ces modèles n'est pas de demander à chacun d'eux une sélection d'actions. Un meilleur test est de donner à chaque modèle la même tâche de recherche et d'évaluer la sortie sur les preuves, les calculs, la prise de conscience des risques et l'utilité.
Utilisez ce cadre d'évaluation :
| Facteur d'évaluation | Ce qu'il faut vérifier | Pourquoi c'est important |
|---|---|---|
| Actualité des données | Utilise-t-il des dépôts, des nouvelles et des prix actuels ? | Des données anciennes peuvent briser une thèse de trading |
| Qualité de la source | Les citations proviennent-elles de dépôts, de communiqués d'entreprise, de données financières crédibles ou de nouvelles réputées ? | Des sources faibles créent des conclusions faibles |
| Précision numérique | Les ratios, les taux de croissance et les tableaux d'évaluation sont-ils corrects ? | De petites erreurs de calcul peuvent changer la thèse |
| Analyse des risques | Explique-t-il les points de baisse, d'incertitude et d'invalidation ? | Une bonne recherche n'est pas seulement une preuve haussière |
| Transparence | Pouvez-vous retracer pourquoi le modèle a atteint sa conclusion ? | L'auditabilité aide à prévenir la confiance aveugle |
| Applicabilité | Fournit-il des étapes suivantes, pas seulement un résumé ? | Les investisseurs ont besoin de décisions, de listes de surveillance et de déclencheurs |
Un test de comparaison simple :
- Choisissez un ticker, comme
TSLA,NVDAouAAPL. - Rassemblez le même paquet de sources : dernier 10-K/10-Q, transcription des bénéfices récents, un an de données de prix, nouvelles récentes et principaux indicateurs d'évaluation.
- Demandez à GPT, Gemini et Claude de produire la même sortie : thèse, principaux moteurs, risques, plage d'évaluation et ce qui changerait la conclusion.
- Vérifiez chaque chiffre par rapport au paquet de sources.
- Comparez quelle sortie est la plus utile pour votre processus d'investissement réel.
Le modèle qui semble le plus confiant n'est pas toujours le modèle le plus correct. Pour l'analyse boursière, le gagnant est le système le plus facile à vérifier.
Ce que 4 992 transactions IA réelles révèlent sur la façon dont chaque laboratoire entraîne ses modèles
Tout ce qui précède relève de l'argument qualitatif. La vraie question est de savoir si ces différences apparaissent réellement dans les résultats — nous sommes donc allés consulter nos propres journaux.
SimianX exploite une salle de commandement en direct dans laquelle des modèles d'IA prennent des positions réelles et surveillées, avec des entrées, des stop-loss et des objectifs définis. Entre le 22 janvier et le 28 août 2026, ce système a clôturé 4 992 positions, générant 20 016 enregistrements modèle-position répartis sur 35 modèles et 6 fournisseurs.
Lisez bien cette section : nous mesurons le style de la maison, pas le talent de trading
Deux réserves déterminent la façon dont vous devez utiliser ces chiffres, et toutes deux comptent davantage que les chiffres eux-mêmes.
Premièrement, aucun laboratoire ne propose aujourd'hui un modèle entraîné spécifiquement pour trader. GPT, Gemini, Claude, Grok, DeepSeek et Qwen sont tous des systèmes généralistes à qui l'on demande un travail pour lequel aucun n'a été optimisé. Un tableau de taux de réussite n'est donc pas un classement de compétence en trading. Ce qu'il expose réellement, c'est le tempérament de chaque maison : la manière dont les choix d'entraînement et d'alignement d'une organisation façonnent le comportement de ses modèles lorsqu'ils sont contraints d'agir dans l'incertitude, avec de vraies conséquences. À quelle vitesse admet-il qu'il s'est trompé ? Dans quelle mesure nuance-t-il ? S'engage-t-il sur un chiffre ? Cette disposition est une empreinte digitale du laboratoire plutôt que de la version du modèle, ce qui explique qu'elle tende à persister d'une sortie à l'autre — et pourquoi elle constitue un guide plus fiable sur le comportement du prochain modèle de ce laboratoire que n'importe quel score de benchmark.
Deuxièmement, il s'agit de positions crypto, pas d'actions. Nous les publions dans un guide de recherche boursière parce que la propriété mesurée — la posture de raisonnement dans l'incertitude — appartient au modèle et non à l'actif. La crypto se négocie 24h/24 et 7j/7, ce qui produit un échantillon exploitable en quelques mois plutôt qu'en plusieurs années. Considérez la direction de ces conclusions comme transposable à la recherche sur actions, et les pourcentages absolus comme propres à la crypto. Le classement complet est public sur le Classement Crypto SimianX, et nous détaillons la méthodologie dans Quel Modèle d'IA Trade le Mieux ? 30 LLMs au P&L Réel.
Notes méthodologiques : « décisives » exclut les positions clôturées à l'équilibre. Une même position peut faire intervenir plusieurs modèles dans des rôles d'agent différents, elle peut donc être comptabilisée pour plus d'un fournisseur — c'est la convention utilisée par notre classement public. Les modèles n'ont pas été attribués au hasard ; ce sont les utilisateurs qui les ont choisis, si bien que la répartition des unités de temps et des instruments diffère selon le modèle. Ce biais se révèle être la découverte la plus importante de tout le jeu de données.
Constat 1 — Sur la précision brute, les familles de tête sont indiscernables
| Modèle | Positions clôturées | Taux de réussite | P&L moyen par position |
|---|---|---|---|
gpt-4o-mini | 4 340 | 59,0 % | +0,075 % |
gemini-2.5-flash-lite | 4 458 | 58,8 % | +0,080 % |
grok-4-1-fast-non-reasoning | 2 647 | 57,1 % | +0,085 % |
Au niveau des fournisseurs, le tableau est identique : OpenAI 58,7 %, xAI 58,6 %, Google 58,3 % — chacun sur environ 4 500 positions décisives. Un écart de 0,4 point sur des échantillons de cette taille, c'est du bruit, pas un avantage.
Si vous cherchiez « quel modèle gagne », voilà la réponse, et elle est décevante : au niveau des résultats réalisés, remplacer GPT par Gemini ne change presque rien.
Constat 2 — Le cadrage compte environ 25 fois plus que le modèle
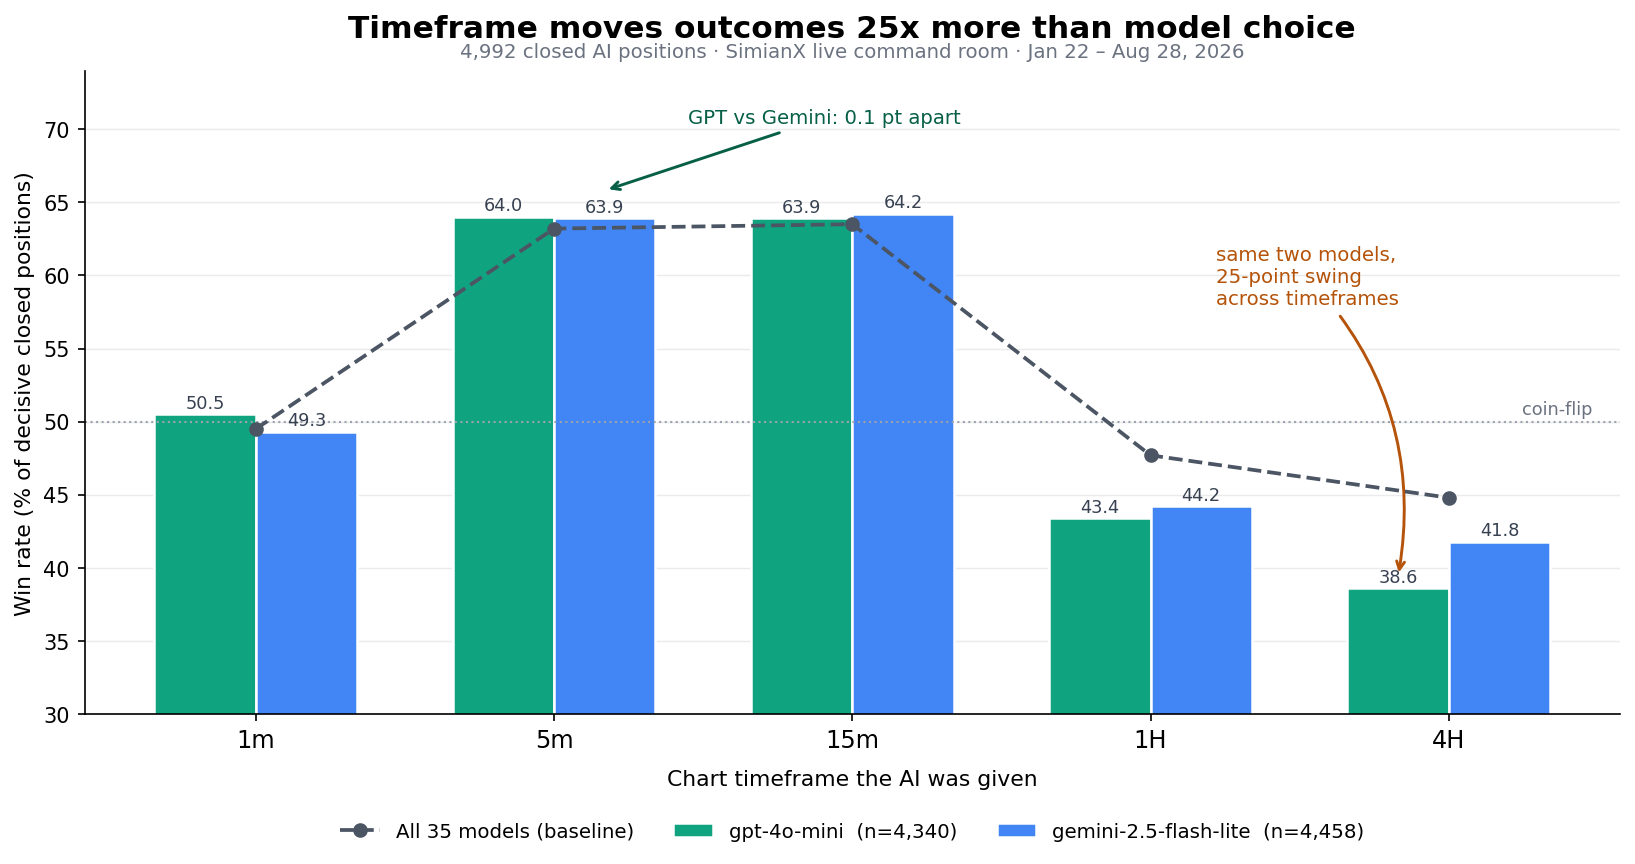
Les deux mêmes modèles, classés selon l'unité de temps du graphique qui leur a été fournie :
| Unité de temps | gpt-4o-mini | gemini-2.5-flash-lite | Les 35 modèles |
|---|---|---|---|
| 1m | 50,5 % | 49,3 % | 49,5 % |
| 5m | 64,0 % | 63,9 % | 63,2 % |
| 15m | 63,9 % | 64,2 % | 63,5 % |
| 1H | 43,4 % | 44,2 % | 47,7 % |
| 4H | 38,6 % | 41,8 % | 44,8 % |
Les deux modèles se suivent à environ un point près dans chaque case. Le même modèle oscille de 25 points entre sa meilleure unité de temps et la pire.
C'est l'enseignement le plus utile du jeu de données, et il se transpose directement à la recherche sur actions : avant d'accuser le modèle, vérifiez le cadrage. Une réponse faible est bien plus souvent une question mal posée — mauvais horizon, mauvais dossier de preuves, mauvais contexte — qu'un modèle faible.
Constat 3 — Les chiffres de première ligne mentent tant qu'on ne contrôle pas le cadrage
Claude en est l'illustration. claude-haiku-4-5 affiche un taux de réussite brut de 52,4 %, ce qui ressemble à une nette défaite face à GPT et Gemini. Mais 66 % de ses positions ont été prises sur le graphique en 1 minute — la pire unité de temps du jeu de données pour tous les modèles testés. À conditions comparables, Claude obtient 52,8 % en 1m contre une base de 49,5 % tous modèles confondus : au-dessus de la moyenne sur le cadrage qu'on lui a réellement donné.
Rien dans le tableau brut n'était faux. C'était simplement une comparaison non appariée. Tout article du type « nous avons testé les modèles » qui ne contrôle pas la tâche décrit une composition, pas une capacité.
Constat 4 — Même précision, tempérament totalement différent
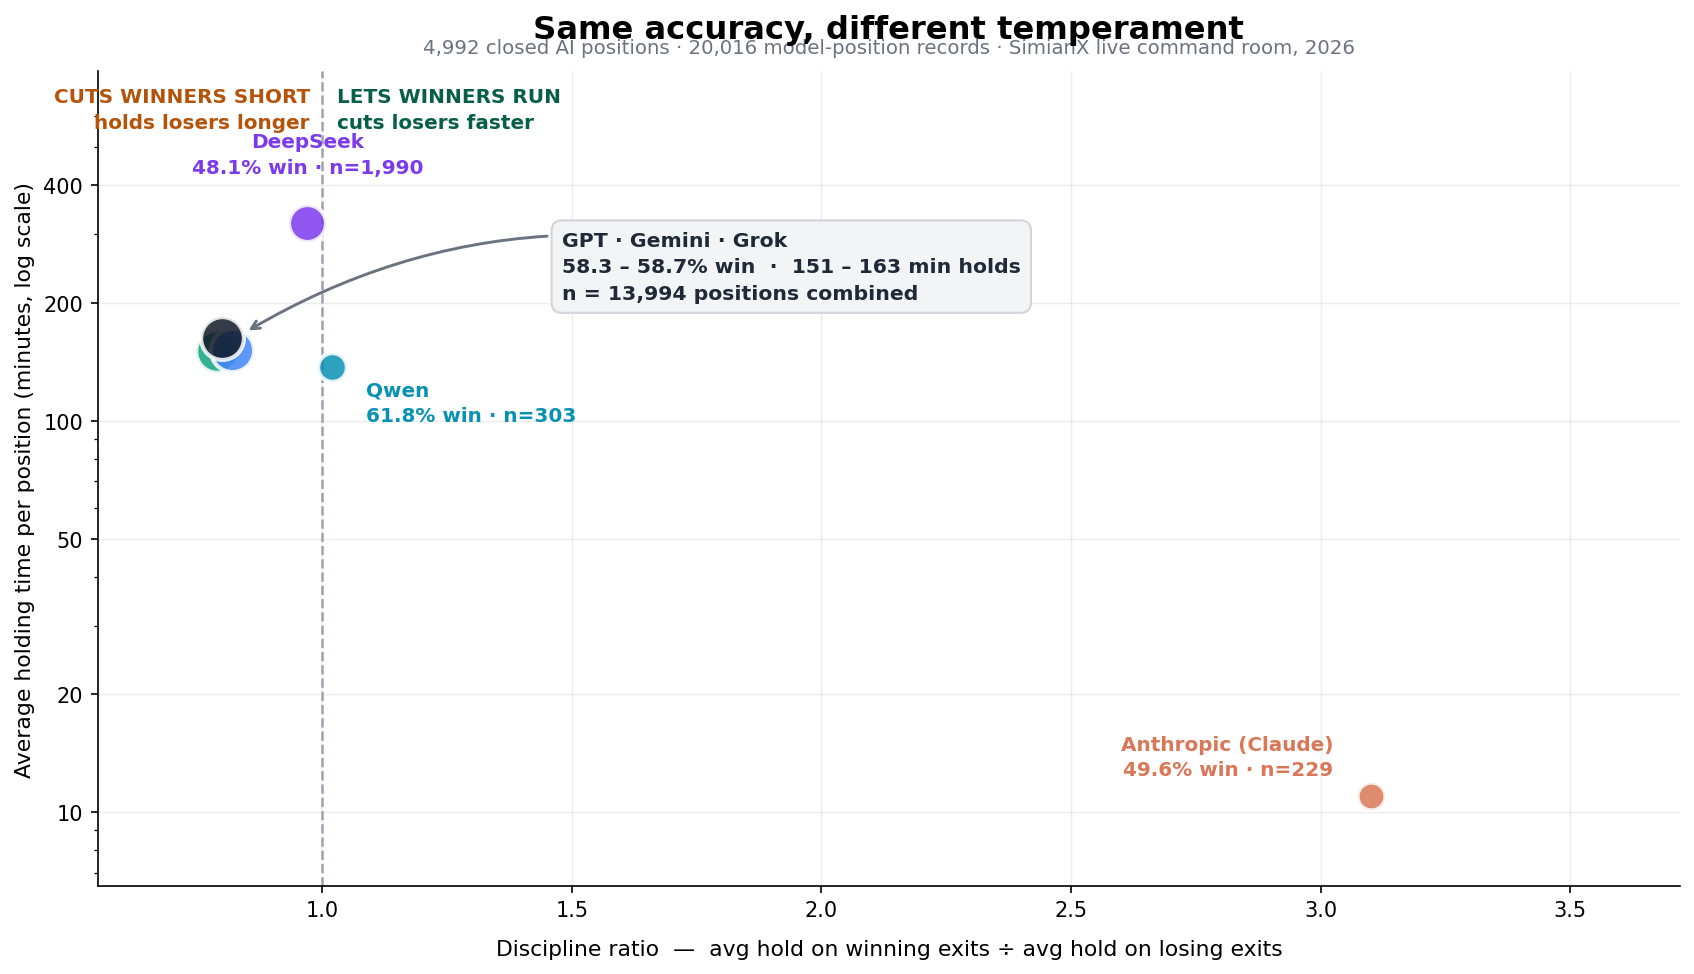
C'est sur le comportement que les familles se distinguent vraiment.
| Famille | Durée moyenne | Stop déclenché | Confiance moyenne | Signale « risque élevé » | Ratio de discipline* |
|---|---|---|---|---|---|
| OpenAI (GPT) | 151 min | 22,7 % | 0,604 | 3 % | 0,79 |
| Google (Gemini) | 152 min | 23,5 % | 0,682 | 9 % | 0,82 |
| xAI (Grok) | 163 min | 22,5 % | 0,678 | <1 % | 0,80 |
| Anthropic (Claude) | 11 min | 32,3 % | 0,677 | 0 % | 3,10 |
| DeepSeek | 320 min | 21,5 % | 0,645 | 1 % | 0,97 |
| Qwen | 137 min | 38,3 % | 0,684 | 2 % | 1,02 |
*Ratio de discipline = durée moyenne de détention sur les sorties gagnantes ÷ durée moyenne sur les sorties perdantes. En dessous de 1,0, le modèle est resté plus longtemps sur ses pertes que sur ses gains.
Trois éléments ressortent.
GPT, Gemini et Grok héritent du pire réflexe de l'investisseur particulier. Chacun conserve ses positions perdantes plus longtemps que les gagnantes — 68 minutes contre 54 chez OpenAI, 64 contre 52 chez Google. C'est l'effet de disposition, cette même réticence à matérialiser une perte qui coûte de l'argent aux traders humains, reproduite par des modèles entraînés en grande partie sur de l'écriture humaine.
Anthropic fait exception, et dans le bon sens. Claude coupe une position perdante en 7 minutes en moyenne et conserve une gagnante 21 minutes — un ratio de discipline de 3,10, de la gestion du risque comme dans les manuels. C'est aussi la famille la plus disposée à se tromper vite, ce qui se traduit par un taux de stops déclenchés élevé. Son taux de réussite brut plus faible n'est pas de la négligence : c'est l'arithmétique de nombreuses petites pertes rapides sur les cadrages les plus difficiles.
OpenAI est la mieux calibrée. GPT annonce une confiance moyenne de 0,604 contre environ 0,68 pour tous les autres — la famille la moins susceptible de vous dire qu'elle est sûre. Pour un travail de recherche, c'est une qualité, pas une faiblesse.
Gemini est la plus prompte à lever la main : elle signale un cadrage comme « risque élevé » dans 9 % des décisions — trois fois plus souvent qu'OpenAI, et infiniment plus souvent que Claude, qui n'a pas utilisé l'étiquette une seule fois dans cet échantillon.
Un dernier résultat, valable pour l'ensemble du système : sur les six familles, les objectifs de prise de bénéfice ne se sont exécutés que sur 1,5 à 2,8 % des positions. Les modèles de tous les laboratoires gèrent massivement leurs sorties au jugement, en direct, plutôt que de laisser un objectif préétabli faire le travail. Savoir s'il s'agit de discipline ou d'ingérence est exactement le genre de question qu'une revue multi-agent est conçue pour faire remonter, et nous en examinons la version en scénario de krach dans Les modèles d'IA vendent-ils en panique lors d'un krach ?.
Avertissement sur la taille d'échantillon : Anthropic (229 positions) et Qwen (303) reposent sur des échantillons bien plus petits que ceux des trois grands (plus de 4 500 chacun). Lisez ces deux lignes comme indicatives, non comme établies.
Constat 5 — Les modes de raisonnement n'ont pas aidé sur les horizons courts
À laboratoire constant, en ne faisant varier que le mode de raisonnement :
| Modèle | Positions | Taux de réussite | Durée moyenne |
|---|---|---|---|
grok-4-fast-non-reasoning | 1 356 | 68,4 % | 13 min |
grok-4-1-fast-reasoning | 1 733 | 61,5 % | 240 min |
deepseek-chat | 1 486 | 49,1 % | 205 min |
deepseek-reasoner | 389 | 44,4 % | 766 min |
Dans les deux laboratoires, la variante à raisonnement étendu s'en est moins bien sortie sur les décisions à horizon court que sa sœur plus rapide. Une délibération plus longue a produit des détentions plus longues et davantage de temps pour que la thèse se dégrade — pas de meilleures entrées. Pour une recherche boursière lente et riche en documents, l'arbitrage s'inverse très probablement, mais ne présumez pas qu'un modèle de raisonnement soit automatiquement le meilleur instrument pour une décision sensible au temps.
Constat 6 — Chaque laboratoire a une signature d'écriture reconnaissable
Sur 1 581 enregistrements de décision où le modèle décideur est identifiable, la prose elle-même trahit chaque laboratoire.
GPT nuance. Environ la moitié de ses justifications s'appuient sur des formulations prudentes, et il s'engage rarement sur un prix :
« L'analyse suggère une position longue en raison de possibles retournements haussiers à court terme, soutenus par le RSI et le sentiment des actualités, malgré la tendance baissière générale. La configuration offre un rapport risque-rendement raisonnable. »
Gemini s'engage sur des chiffres. Il nomme un niveau précis dans 12 % de ses justifications, soit environ le double de la plupart de ses concurrents :
« Vendre à découvert sur la base du graphique en 15 minutes, qui montre une tendance baissière et des indicateurs techniques baissiers. L'objectif de profit est à 89 120,00. »
Claude est le plus précis techniquement et le moins nuancé — seules 32 % de ses justifications emploient un langage de précaution, contre 51 à 63 % pour toutes les autres familles :
« L'analyse suggère une position courte en raison d'un point de rupture avec des éléments structurels baissiers : sommets décroissants, reprises manquées de l'EMA50 et volume déclinant. Une confirmation est nécessaire avant l'entrée. »
Grok borne ses prévisions dans le temps. Il assortit 11 % de ses décisions d'une fenêtre explicite, contre 2 à 6 % ailleurs :
« Position courte recommandée en raison de signaux baissiers, d'une résistance à 9,0 et d'un potentiel de baisse du prix vers 8,93 dans les 45 à 95 prochaines minutes. »
Remarquez ce dont il s'agit : des dispositions stylistiques, pas des capacités. Elles reflètent ce que le post-entraînement de chaque laboratoire a récompensé — la prudence chez OpenAI, la décision et le signalement explicite du risque chez Google, la précision structurelle et l'aveu rapide de la perte chez Anthropic, le cadrage engagé et borné dans le temps chez xAI. Ces préférences sont des propriétés stables de la maison. Et comme aucun n'a été ajusté pour les marchés, elles constituent ce qui se rapproche le plus d'une prévision du comportement du prochain modèle de chaque laboratoire lorsque vous le pointerez vers une action.
La grille de notation à 6 axes : transformer le cadre en un chiffre
Notez la production de recherche de n'importe quel modèle sur les six facteurs du cadre d'évaluation ci-dessus, de 1 à 5 chacun, puis pondérez-les selon les dégâts qu'une défaillance sur cet axe cause réellement :
| Axe | Poids | Note de 1 | Note de 5 |
|---|---|---|---|
| Actualité des données | 25 % | Affirmations non datées | Chaque chiffre daté et sourcé |
| Précision numérique | 25 % | Les chiffres ne concordent pas avec le dépôt | Chaque nombre se recoupe |
| Qualité de la source | 15 % | Sans attribution ou de niveau blog | Dépôts primaires et communiqués de l'entreprise |
| Analyse des risques | 15 % | Uniquement le scénario haussier | Niveaux d'invalidation explicites |
| Transparence | 10 % | Conclusion sans chaîne visible | Chaque étape traçable |
| Applicabilité | 10 % | Un simple résumé | Déclencheurs, niveaux et rythme de suivi |
Prenez le total pondéré sur 5. Tout ce qui est en dessous de 3,5 repart pour un tour. Tout ce qui dépasse 4,5 sans point d'invalidation nommé relève généralement de l'excès de confiance plutôt que de l'excellence. Passez le même ticker dans deux familles et notez les deux — d'après les données ci-dessus, attendez-vous à ce que les notes soient proches et à ce que le style d'échec diffère.
Ce que cela signifie concrètement pour votre recherche boursière
- Cessez de chercher le meilleur modèle ; commencez par corriger le cadrage. Un effet de 25 points lié à l'unité de temps contre un effet de 0,4 point lié au modèle, c'est tout l'argument en faveur d'un investissement dans le flux de travail plutôt que dans la sélection du modèle.
- Associez le laboratoire à la tâche par tempérament, pas par benchmark. Vous voulez un deuxième avis qui vous dise quand il n'est pas sûr ? Prenez la famille la mieux calibrée. Vous voulez une note qui s'engage sur des niveaux ? Prenez celle qui nomme des chiffres. Vous voulez un relecteur du risque qui admette que la thèse est cassée ? Prenez celle qui coupe ses pertes en sept minutes.
- Attendez-vous à ce que le style de la maison persiste. Comme aucun laboratoire ne s'entraîne spécifiquement pour cette tâche, ce que vous observez est une disposition générale — et elle se répercutera sur leur prochaine version.
- Utilisez-en plusieurs, et faites-les se contredire au grand jour. Les familles échouent différemment, et c'est précisément pour cela qu'un débat entre elles fait remonter plus de choses que n'importe quelle réponse isolée.
Pourquoi SimianX AI adopte une approche multi-agents
Un seul modèle peut résumer, calculer et écrire. Mais l'analyse boursière bénéficie souvent d'un désaccord de spécialistes. Un signal technique peut sembler haussier tandis que l'évaluation semble tendue. Le sentiment des nouvelles peut s'améliorer tandis que la vente d'initiés soulève des questions. Un modèle qui mélange tout en une seule réponse trop rapidement peut cacher ces conflits.
SimianX AI se concentre sur l'analyse de marché multi-agents plutôt que sur une réponse unique d'un chatbot. Sa valeur réside dans la conception de flux de travail : des agents spécialisés peuvent examiner les fondamentaux, les techniques, le sentiment, les nouvelles et le risque, puis comparer leurs résultats avant qu'un rapport final ne soit produit.
Cela est important car le meilleur flux de travail d'analyse boursière par IA devrait séparer les rôles :
- Agent fondamental : croissance des revenus, marges, flux de trésorerie libre, levier, évaluation
- Agent technique :
RSI,MACD, moyennes mobiles, volatilité, support/résistance
- Agent d'actualités : catalyseurs, mises à jour des analystes, dépôts auprès de la SEC, changements de direction
- Agent de risque : briseurs de thèse, risque de drawdown, préoccupations concernant la taille des positions
- Agent de décision : intègre les preuves dans un langage de recherche de type achat/maintien/vente
Cela ne signifie pas que SimianX AI, GPT, Gemini, Claude ou toute plateforme d'IA peut garantir des rendements. L'analyse boursière implique toujours de l'incertitude. L'IA devrait soutenir une meilleure recherche, pas remplacer la gestion des risques, la taille des positions ou le jugement des investisseurs.
Flux de recherche boursière par IA pratique que vous pouvez utiliser aujourd'hui
Voici un flux de travail répétable pour utiliser GPT, Gemini, Claude ou SimianX AI sans transformer l'IA en un sélectionneur d'actions en boîte noire.
Étape 1 : Commencez par la question d'investissement
Mauvais prompt :
Cette action est-elle un achat ?
Meilleur prompt :
Évaluez si AAPL est attrayant pour un trade de swing de 6 à 12 mois basé sur les bénéfices récents, l'évaluation, la tendance technique, les catalyseurs d'actualités et le risque à la baisse. Montrez les hypothèses et citez les sources.
Le deuxième prompt définit le ticker, l'horizon temporel, les dimensions de recherche et les preuves requises.
Étape 2 : Séparer les faits de l'interprétation
Demandez à l'IA de produire deux sections :
- Faits : chiffres, dates, dépôts, déclarations de direction, niveaux de prix
- Interprétation : ce que ces faits peuvent impliquer pour la thèse
Cela réduit le risque d'hallucination car vous pouvez vérifier la couche factuelle avant de lire la couche d'opinion.
Étape 3 : Forcer un scénario pessimiste
Toute analyse d'actions d'IA devrait inclure un scénario pessimiste sérieux. Demandez :
Quelles preuves rendraient cette thèse incorrecte, et quelles données devrais-je surveiller chaque semaine ?
C'est là que les modèles deviennent souvent plus utiles. Ils vous aident à convertir un risque vague en points de surveillance concrets.
Étape 4 : Utiliser plusieurs modèles ou agents
Un flux de travail robuste pourrait utiliser :
- Gemini pour digérer un grand ensemble de dépôts, de transcriptions et de rapports de marché.
- GPT pour calculer des scénarios de valorisation et construire des tableaux.
- Claude pour rédiger un mémo d'investissement poli et critiquer les hypothèses.
- SimianX AI pour effectuer une révision multi-agents et comparer les perspectives techniques, fondamentales, d'actualités et de risques sur une seule plateforme.
Étape 5 : Vérifier avant d'agir
Les recherches de marché générées par l'IA doivent toujours être vérifiées contre des sources fiables. Vérifiez les dépôts, les données de marché, les dates des nouvelles et les calculs avant de prendre toute décision d'investissement.
Ne considérez jamais une recommandation d'action générée par l'IA comme définitive. Vérifiez les sources, vérifiez les chiffres, comprenez les risques et envisagez de consulter un professionnel financier agréé pour des conseils adaptés à votre situation.
GPT vs Gemini vs Claude : Lequel les investisseurs devraient-ils choisir ?
Choisissez GPT si vous voulez un analyste flexible pour le nettoyage des données, les calculs, les explications de graphiques, les tableaux de valorisation et la modélisation de scénarios. Il est particulièrement utile lorsque vous pouvez fournir des données structurées et souhaitez un raisonnement basé sur du code.
Choisissez Gemini si vous devez traiter de très grands ensembles de documents, comparer de nombreux PDF, synthétiser de longs paquets de recherche ou générer des rapports de recherche cités à partir d'un large matériel source.
Choisissez Claude si votre travail ressemble à une documentation financière professionnelle : mémos d'investissement, pitchbooks, revues de modèles, résumés de bénéfices et rapports internes polis.
Choisissez SimianX AI si vous souhaitez que la comparaison elle-même devienne un flux de travail : plusieurs agents examinant le même titre sous différents angles, débattant des preuves et produisant un résultat de recherche plus clair.
La réponse la plus forte n'est pas « GPT bat Gemini » ou « Claude bat GPT ». La réponse la plus forte est :
Utilisez le bon modèle pour le bon travail de recherche, puis combinez les résultats à travers un processus transparent, multi-agents, révisé par des humains.
FAQ sur GPT vs Gemini vs Claude pour l'analyse boursière AI
GPT est-il plus précis que Gemini pour l'analyse boursière ?
Pas de façon mesurable. Sur 4 992 positions gérées par IA en direct, gpt-4o-mini a clôturé avec un taux de réussite de 59,0 % et gemini-2.5-flash-lite avec 58,8 % — un écart de 0,2 point sur environ 4 300 positions chacun, ce qui relève du bruit statistique. En contrôlant l'unité de temps du graphique, les deux se suivent à environ un point près dans chaque tranche. Ce qui diffère, c'est le tempérament et non la précision : l'unité de temps que vous confiez à un modèle a fait bouger les résultats environ 25 fois plus que le choix du modèle.
Quel est le meilleur AI pour la recherche sur le marché boursier en 2026 ?
Il n'y a pas de gagnant universel. GPT est fort pour les calculs et l'analyse de données flexible, Gemini est fort pour la recherche à long terme et la synthèse de sources multimodales, et Claude est fort pour les flux de travail financiers professionnels et les livrables soignés. Pour de nombreux investisseurs, la meilleure configuration est une plateforme multi-agents comme SimianX AI qui combine différents rôles analytiques.
Comment utiliser l'IA pour la recherche boursière sans hallucinations ?
Utilisez des paquets de sources de haute qualité, exigez des citations, séparez les faits de l'interprétation et vérifiez tous les chiffres par rapport aux dépôts ou aux données financières fiables. Demandez au modèle de montrer les hypothèses, l'incertitude et le scénario pessimiste. Évitez les invites qui demandent des prédictions « garanties » non soutenues.
GPT, Gemini ou Claude peuvent-ils prédire les prix des actions avec précision ?
Ils peuvent aider à analyser les facteurs qui influencent le prix, mais aucun modèle d'IA ne peut prédire de manière fiable les prix des actions avec certitude. Les marchés réagissent aux bénéfices, à la liquidité, aux chocs macroéconomiques, à la réglementation, au positionnement et aux nouvelles inattendues. L'IA est mieux utilisée pour accélérer la recherche, pas pour des prévisions garanties.
SimianX AI est-il meilleur que l'utilisation de ChatGPT, Gemini ou Claude seul ?
SimianX AI est différent car il se concentre sur l'analyse de marché multi-agents plutôt que sur une seule réponse de chatbot. Son avantage est la conception de flux de travail : des agents spécialisés peuvent examiner les fondamentaux, les techniques, les nouvelles et le risque, puis comparer les conclusions. Cela peut être plus pratique pour les investisseurs qui souhaitent une recherche boursière structurée et vérifiable.
Quel modèle d'IA est le meilleur pour analyser les dépôts de la SEC ?
Gemini est attrayant pour des ensembles de documents très volumineux, GPT est utile pour extraire des métriques et construire des tableaux, et Claude est fort pour transformer l'analyse des dépôts en mémos professionnels. La meilleure approche est de combiner extraction, calcul et synthèse écrite, puis de vérifier chaque chiffre par rapport au dépôt original.
Conclusion
Le débat GPT vs Gemini vs Claude pour l'analyse boursière par IA concerne vraiment la qualité du flux de travail. GPT est excellent pour l'analyse de données et la modélisation de scénarios. Gemini est puissant pour la recherche à long terme et la synthèse de grandes sources. Claude est fort pour l'écriture de style financier, la création de documents et les résultats de recherche professionnels. Mais l'analyse boursière est un problème multi-signal, ce qui signifie que la meilleure réponse vient souvent de la combinaison de modèles, de sources et de perspectives spécialisées.
C'est la valeur fondamentale de SimianX AI : elle transforme la recherche boursière par IA en un processus multi-agents où les signaux techniques, les fondamentaux, les nouvelles, le sentiment et le risque peuvent être examinés ensemble au lieu d'être cachés dans une seule réponse de chatbot. Explorez SimianX AI pour construire une approche plus transparente, disciplinée et prête à la recherche pour l'analyse boursière alimentée par l'IA.
Lecture Liée
- SimianX AI : plateforme multi-agents d'analyse boursière
- 8 Analystes IA vs 1 : +37% Précision, −41% Risque Net
- Pipelines IA Multi-Agents pour Recherche Hedge Fund
- Quel Modèle d'IA Trade le Mieux ? 30 LLMs au P&L Réel
- 30+ Modèles IA, 6 Fournisseurs : Classement Crypto Live
- Les modèles d'IA vendent-ils en panique lors d'un krach ?
- IA Multi-Agent vs ChatGPT pour NVDA: Comparatif 2026