Les agents IA expliqués : d'un modèle en boucle à une équipe de spécialistes
Un agent IA est un système logiciel qui utilise un modèle d'intelligence artificielle pour poursuivre un objectif de manière autonome : il analyse la situation, décide de l'étape suivante, agit au moyen d'outils comme la recherche web, le code ou une API, puis vérifie le résultat avant de continuer. Un système multi-agents répartit ce travail entre plusieurs agents spécialisés qui partagent ce qu'ils trouvent, se contredisent là où ils divergent et remettent une réponse combinée à un agent chargé de trancher.
Cette définition en deux phrases couvre l'essentiel de ce que le terme désigne en 2026, des assistants de programmation qui corrigent des bogues dans tout un dépôt de code aux outils de recherche qui lisent des centaines de pages avant de rédiger un rapport. Elle masque aussi les difficultés. Les agents coûtent plus cher qu'une réponse de messagerie instantanée, ils prennent plus de temps, et une petite erreur au début d'une longue tâche peut ruiner le résultat sans bruit.
Chez SimianX, nous concevons et exploitons des systèmes multi-agents au quotidien. Quatre agents analysent en direct une action ou une paire de cryptomonnaies dans notre salle d'analyse en direct, un comité de huit agents débat d'une seule action ou d'une seule cryptomonnaie dans la recherche approfondie, et un classement crypto public note plus de 30 modèles d'IA sur chaque transaction qu'ils clôturent. Ce guide s'appuie sur ce système comme exemple concret, aux côtés de descriptions neutres des produits d'agents et des travaux de recherche qui structurent le domaine.
À retenir
- Un agent, c'est un modèle doté d'outils, d'une mémoire et d'une boucle que le modèle pilote lui-même. Si chaque étape est figée dans le code, c'est un flux de travail, pas un agent.
- Les systèmes multi-agents sont utiles quand une tâche se découpe en parties indépendantes, ou quand elle exige des points de vue qui doivent se former avant toute mise en commun. Ils consomment aussi beaucoup plus de jetons.
- La plupart des échecs d'agents viennent d'erreurs qui s'accumulent, d'outils peu fiables, d'une évaluation insuffisante et de coûts qui s'emballent, et non d'un modèle « pas assez intelligent ».
- Jugez un agent sur des résultats répétés dans vos propres tâches : taux de réussite, constance d'une exécution à l'autre, coût par tâche menée à bien et trace complète de ce qu'il a fait.
Qu'est-ce qu'un agent IA ? Une définition pratique
L'idée est plus ancienne que les grands modèles de langage. Le manuel de référence en intelligence artificielle, Artificial Intelligence: A Modern Approach de Stuart Russell et Peter Norvig, définit un agent comme toute entité qui perçoit son environnement au moyen de capteurs et agit sur cet environnement au moyen d'actionneurs. Un thermostat répond à cette définition. Un programme d'échecs aussi.
Ce qui a changé après 2022, c'est qu'un modèle de langage peut désormais servir de moteur de raisonnement. Au lieu de suivre des règles écrites à la main, le modèle lit la situation en langage naturel, rédige un plan et choisit l'outil à appeler ensuite. Le guide d'Anthropic Building Effective Agents, très cité, trace la frontière qu'emploient aujourd'hui la plupart des ingénieurs : les flux de travail sont des systèmes où modèles et outils sont orchestrés selon des chemins de code prédéfinis, tandis que les agents sont des systèmes où le modèle dirige lui-même, de façon dynamique, son processus et son usage des outils.
En pratique, un agent IA moderne comporte cinq éléments :
- Un objectif. « Corrige ce test qui échoue », « résume ce qui a fait bouger Nvidia aujourd'hui », « décide s'il faut ouvrir une position sur cette bougie de 15 minutes ».
- Un modèle qui raisonne sur l'objectif et sur l'état actuel.
- Des outils qu'il peut appeler : recherche, interpréteur de code, requête dans une base de données, API de données de marché, navigateur.
- Une mémoire ou un état : ce qu'il a déjà tenté, ce que les outils ont renvoyé et ce qui reste inconnu.
- Une boucle avec une règle d'arrêt : il continue jusqu'à ce que l'objectif soit atteint, qu'un budget soit épuisé ou qu'un humain doive valider l'étape suivante.
Supprimez la boucle et vous obtenez un chatbot. Figez chaque étape à l'avance et vous obtenez un flux de travail. C'est la boucle pilotée par le modèle lui-même qui en fait un agent.
Agent IA, chatbot ou flux de travail
Les trois termes sont sans cesse confondus, en partie parce que le mot « agent » fait vendre. Gartner a un nom pour la pratique qui consiste à rebaptiser agents des chatbots et des outils d'automatisation robotisée des processus, l'« agent washing », et estimait en juin 2025 que seuls 130 environ des milliers de fournisseurs d'IA agentique proposent un véritable agent. Ce tableau est le moyen le plus rapide de les distinguer.
| Chatbot | Flux de travail (chaîne fixe) | Agent IA | |
|---|---|---|---|
| Qui décide de l'étape suivante | L'utilisateur, message après message | Le développeur, dans du code écrit à l'avance | Le modèle, au moment de l'exécution |
| Utilise des outils | Parfois, un appel par réponse | Oui, dans un ordre fixe | Oui, choisis et répétés selon les besoins |
| Continue sans nouvelle consigne | Non | Oui, le long d'un chemin fixe | Oui, jusqu'à l'objectif ou à l'épuisement d'un budget |
| Résultat type | Une réponse | Un résultat prévisible issu d'un processus connu | Une tâche accomplie : une modification de code, un rapport, une décision |
| Coût et rapidité | Bon marché, quelques secondes | Bon marché à modéré, prévisible | Plus élevé et variable, de quelques secondes à plusieurs heures |
| Échec type | Une mauvaise réponse visible | Casse face à des entrées que personne n'avait prévues | Dérive, tourne en boucle ou bâtit sur une petite erreur initiale |
| Idéal pour | Questions et brouillons | Processus répétables aux étapes connues | Tâches ouvertes dont le chemin ne peut pas être scénarisé |
Une règle utile tirée du même guide d'Anthropic : commencez par l'option la plus simple qui fonctionne, et n'ajoutez de l'autonomie que si elle améliore nettement les résultats. Beaucoup de tâches vendues comme des agents sont meilleures, moins chères et plus sûres sous forme de flux de travail.
Comment fonctionnent les agents IA : la boucle percevoir, planifier, agir, réfléchir
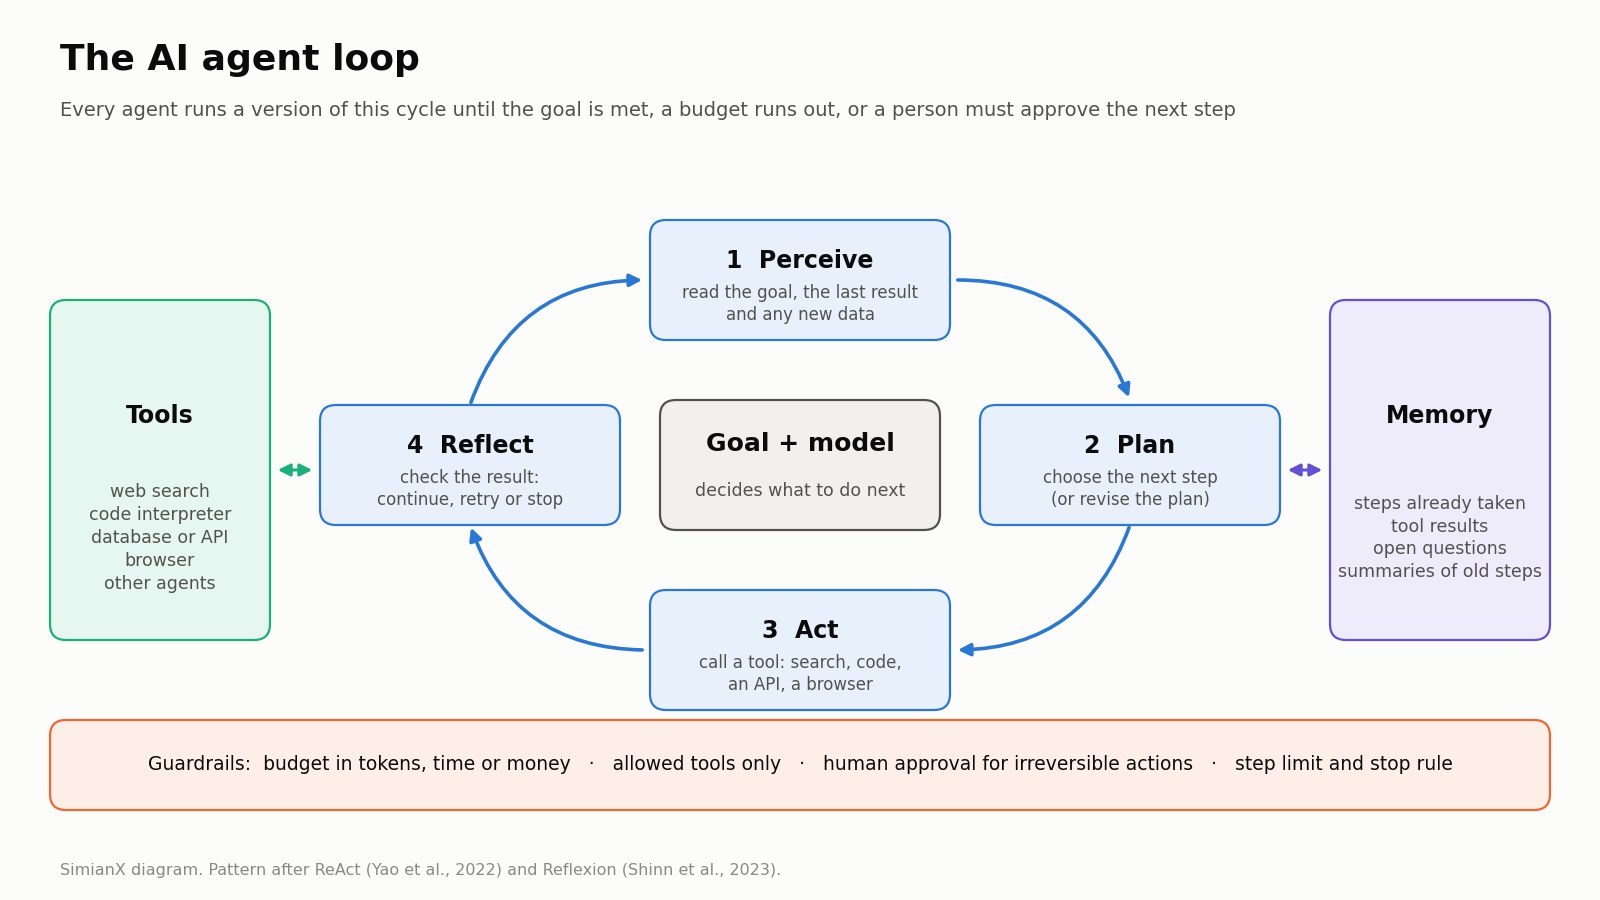
Tout agent, quelle que soit sa marque, exécute une version d'une même boucle.
Percevoir
L'agent rassemble sa situation du moment : l'objectif de l'utilisateur, le résultat de sa dernière action, le contenu d'un fichier, une page de résultats de recherche, la dernière bougie d'un graphique. Tout ce qu'il sait doit tenir dans la fenêtre de contexte du modèle, si bien que les bons agents sont sélectifs. Ils résument les étapes anciennes, conservent les données brutes dont ils auront de nouveau besoin et écartent le reste.
Planifier
Le modèle décide de ce qu'il fera ensuite. Parfois, il s'agit d'un plan complet rédigé d'emblée ; le plus souvent, c'est la seule étape suivante, choisie après avoir vu le dernier résultat. L'article de référence ReAct (Yao et al., 2022) a montré qu'alterner de courtes notes de raisonnement et des actions permet à un modèle de collecter de l'information et de corriger sa trajectoire, et cette approche a battu sur plusieurs tâches les méthodes qui se contentaient d'agir ou de raisonner. La plupart des cadres logiciels pour agents suivent encore ce schéma.
Agir
L'agent appelle un outil. Les modèles modernes émettent une requête structurée, par exemple « cherche X » ou « exécute cette requête avec ces paramètres », et le logiciel qui les entoure l'exécute puis renvoie le résultat. Des standards existent désormais pour cette tuyauterie. Le Model Context Protocol (MCP), présenté par Anthropic en novembre 2024 et confié à l'Agentic AI Foundation de la Linux Foundation en décembre 2025, définit la manière dont un agent se connecte à des outils et à des sources de données. Le protocole Agent2Agent (A2A) de Google, devenu lui aussi un projet de la Linux Foundation, régit la façon dont des agents conçus par des fournisseurs différents dialoguent entre eux.
Réfléchir
L'agent confronte le résultat à l'objectif. Le test est-il passé ? Le chiffre correspond-il à une deuxième source ? Le plan tient-il toujours ? Des travaux comme Reflexion (Shinn et al., 2023) ont montré que laisser un agent noter ce qui n'a pas fonctionné puis réessayer améliore les résultats sur des tâches de programmation et de raisonnement. La réflexion est aussi le moment où un agent doit décider de s'arrêter : parce que l'objectif est atteint, parce qu'il est bloqué ou parce qu'une personne doit valider une action risquée.
Autour de la boucle se trouvent les garde-fous : un budget en jetons, en temps ou en argent, une liste des outils que l'agent a le droit d'utiliser et les points où un humain doit donner son accord. Sur les marchés, cela signifie au minimum une limite de taille de position, un stop sur chaque transaction et une frontière nette entre les transactions fictives et l'argent réel.
Agent unique ou système multi-agents
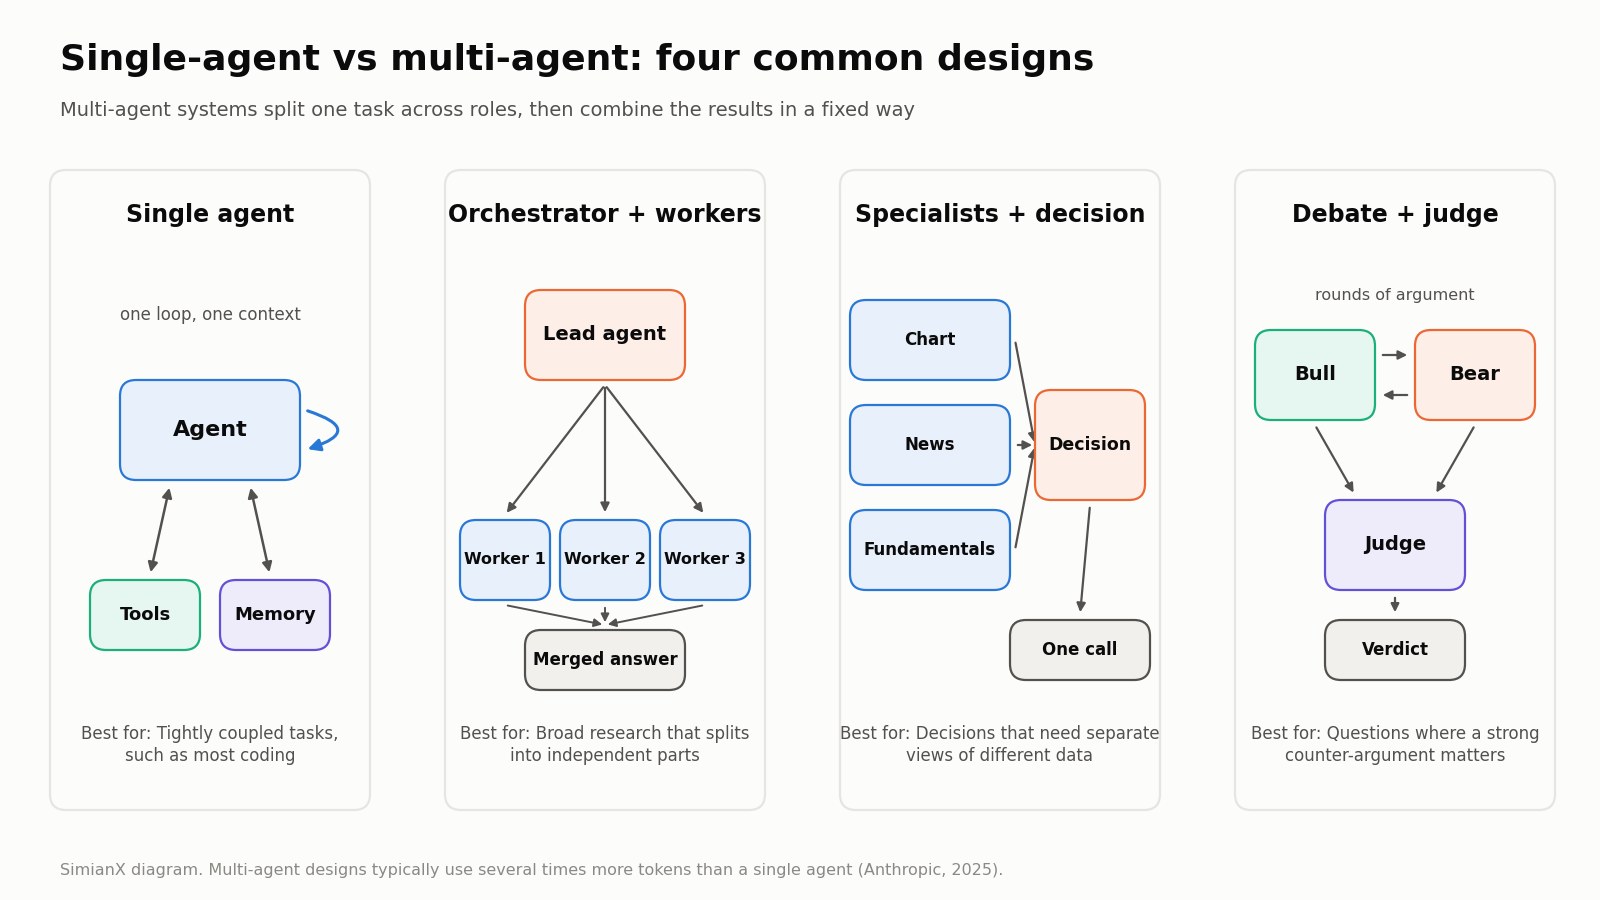
Un agent unique exécute la boucle seul. Un système multi-agents confie différentes parties du travail à différents agents, chacun avec ses propres consignes, outils et contexte, puis combine ce qu'ils produisent. On distingue quatre architectures courantes :
- Orchestrateur et exécutants. Un agent principal découpe la tâche, envoie chaque morceau à un agent exécutant et fusionne les résultats. Les assistants de recherche fonctionnent souvent ainsi.
- Des spécialistes au service d'un décideur. Chaque agent couvre un domaine, comme les graphiques, l'actualité ou les états financiers, et un agent final pèse leurs avis. C'est la structure de notre salle d'analyse en direct, décrite plus bas.
- Le débat. Des agents défendent des positions opposées avant qu'un juge ne tranche. Du et al. (2023) ont constaté que plusieurs instances d'un modèle débattant pendant quelques tours amélioraient l'exactitude factuelle et le raisonnement par rapport à un modèle unique répondant seul.
- Le vote ou les ensembles. Plusieurs agents, ou plusieurs modèles, répondent indépendamment à la même question, puis les réponses sont agrégées.
Les preuves en faveur des systèmes multi-agents sont réelles, mais conditionnelles. Anthropic a indiqué en juin 2025 que, dans son système de recherche multi-agents, un agent principal Claude Opus 4 dirigeant des sous-agents Claude Sonnet 4 a dépassé de 90,2 % un agent Claude Opus 4 seul lors de son évaluation interne de recherche. Le même compte rendu est franc sur le prix : les agents consommaient environ quatre fois plus de jetons qu'une conversation, et les systèmes multi-agents environ quinze fois plus. Il souligne aussi que la plupart des tâches de programmation comportent moins de parties réellement parallélisables que la recherche, ce qui les rend moins adaptées.
| Agent unique | Système multi-agents | |
|---|---|---|
| Mise en place et débogage | Plus simple : une consigne, une trace | Plus difficile : plusieurs consignes, des passages de relais et une trace combinée |
| Coût par tâche | Plus faible | Souvent plusieurs fois plus élevé |
| Rapidité | Séquentiel | Les parties parallèles finissent plus tôt ; la coordination ajoute une surcharge |
| Étendue | Limitée par une seule fenêtre de contexte | Chaque agent dispose d'un contexte neuf pour sa partie |
| Détection des erreurs | Doit repérer ses propres erreurs | Les agents peuvent se contredire, et le désaccord est visible |
| Échec type | Vision tunnel sur une première idée fausse | Malentendus, travail en double ou fusion finale bâclée |
| Idéal pour | Tâches très imbriquées, comme la plupart des travaux de programmation | Recherche large et décisions qui exigent des points de vue indépendants |
Notre règle empirique : utilisez plusieurs agents quand vous voulez des avis qui se forment indépendamment avant toute mise en commun. La lecture d'un graphique ne doit pas être influencée par le titre que l'agent d'actualité vient de lire, et la thèse baissière doit être rédigée par un agent dont la seule mission est de trouver les problèmes.
Où les agents IA échouent
Les agents échouent de manière prévisible, et tout guide honnête doit s'y attarder. Une étude de 2025, Why Do Multi-Agent LLM Systems Fail? (Cemri et al.), a annoté plus de 1 600 traces d'exécution issues de sept cadres multi-agents populaires et a relevé 14 modes d'échec distincts, répartis en trois groupes : des défauts dans la conception du système, des désalignements entre agents et une vérification insuffisante du résultat final.
Les erreurs qui s'accumulent
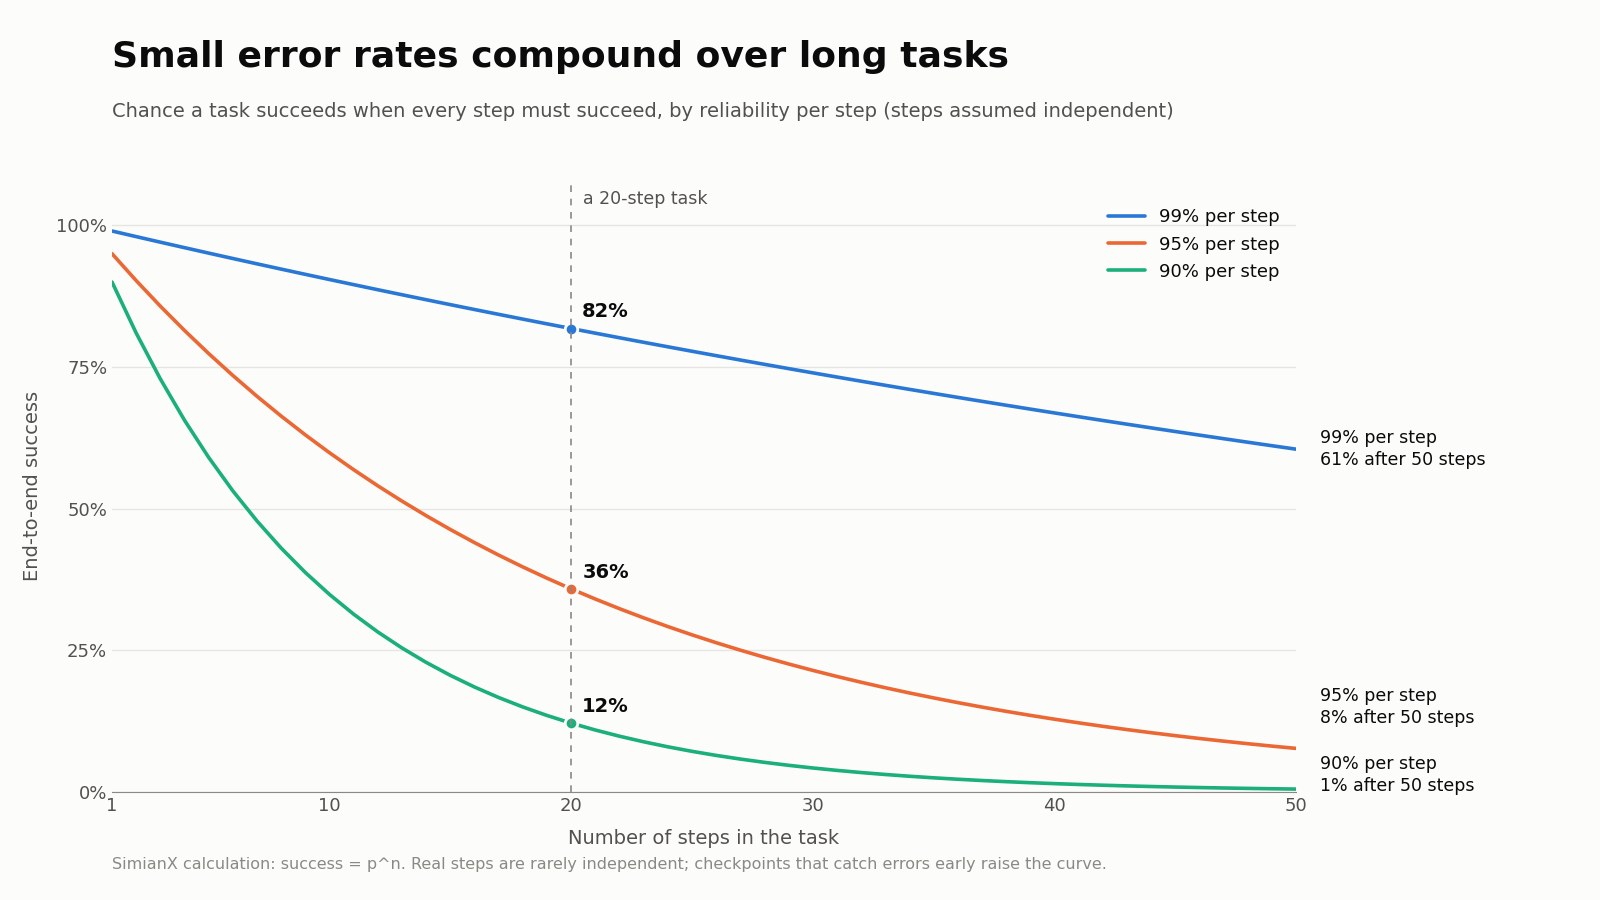
Les tâches longues multiplient les petits taux d'erreur. Si chaque étape d'une tâche réussit 95 % du temps et que les étapes sont indépendantes, une tâche de 20 étapes ne réussit qu'environ 36 % du temps (0,95 à la puissance 20). Avec 99 % par étape, la même tâche réussit environ 82 % du temps. Voilà pourquoi la fiabilité de chaque étape compte davantage que l'éclat sur une étape isolée, et pourquoi les agents ont besoin de points de contrôle qui interceptent une erreur avant que l'étape suivante ne s'appuie dessus.
Hallucinations et outils mal interprétés
Un modèle peut inventer un fait, mal lire le résultat d'un outil ou reporter un chiffre périmé comme s'il était à jour. Les agents aggravent le problème, car une valeur inventée peut devenir l'entrée de l'action suivante. La solution est structurelle : transmettre les données brutes plutôt qu'une paraphrase, vérifier les chiffres clés par du code au lieu de se fier à l'arithmétique du modèle, et exiger une source pour chaque affirmation importante.
Le coût
Chaque passage dans la boucle est un nouvel appel au modèle, et le contexte grossit au fil de la tâche. Une tâche qui semble bon marché lors d'une démonstration peut coûter bien plus cher en production dès que l'agent réessaie, réfléchit et relit. Fixez des budgets stricts par tâche et mesurez le coût d'une tâche menée à bien, pas celui d'un seul appel.
La latence
Les agents échangent de la rapidité contre de la qualité. Une réponse de messagerie prend quelques secondes ; un agent de recherche peut prendre des minutes, et un agent de programmation qui travaille sur une modification importante peut tourner bien plus longtemps. Notre propre comité de recherche approfondie à huit agents a besoin de plusieurs minutes pour une seule action, car les agents enquêtent, débattent et votent avant que quoi que ce soit ne soit rédigé.
L'évaluation
Les agents ne sont pas déterministes : la même tâche peut réussir lors d'une exécution et échouer à la suivante. Le banc d'essai τ-bench a introduit une mesure appelée pass^k, la probabilité qu'un agent réussisse les k tentatives d'une même tâche, et a constaté que même les agents à appel de fonctions les plus performants de l'époque réussissaient les huit tentatives moins de 25 % du temps dans son domaine de la vente au détail. Une seule exécution impressionnante ne dit pas grand-chose. Les bancs d'essai publics comme SWE-bench pour la programmation et OSWorld pour l'utilisation d'un ordinateur sont utiles, mais ce ne sont pas vos tâches.
Sécurité et permissions
Un agent qui lit des pages web ou des courriels peut être manipulé par des instructions qui y sont dissimulées, une attaque connue sous le nom d'injection de requête (prompt injection), qui figure en tête de la liste OWASP des risques pour les applications fondées sur des LLM. Donnez aux agents le minimum d'accès dont ils ont besoin, tenez les secrets hors de leur contexte et exigez une validation avant toute action irréversible, comme un mouvement d'argent.
Ces problèmes ont des conséquences économiques. Dans le même communiqué de juin 2025, Gartner prévoyait que plus de 40 % des projets d'IA agentique seront abandonnés d'ici fin 2027, en raison de coûts croissants, d'une valeur métier floue et d'une maîtrise des risques insuffisante.
Un exemple concret : comment les agents de SimianX se partagent une décision de marché
Les marchés financiers sont un test exigeant pour les agents. Les données arrivent en continu, la bonne réponse est inconnue au moment de décider, et chaque décision finit par être notée par le marché. Voici comment notre système répartit le travail.
Analyse en direct : trois spécialistes et un agent de décision
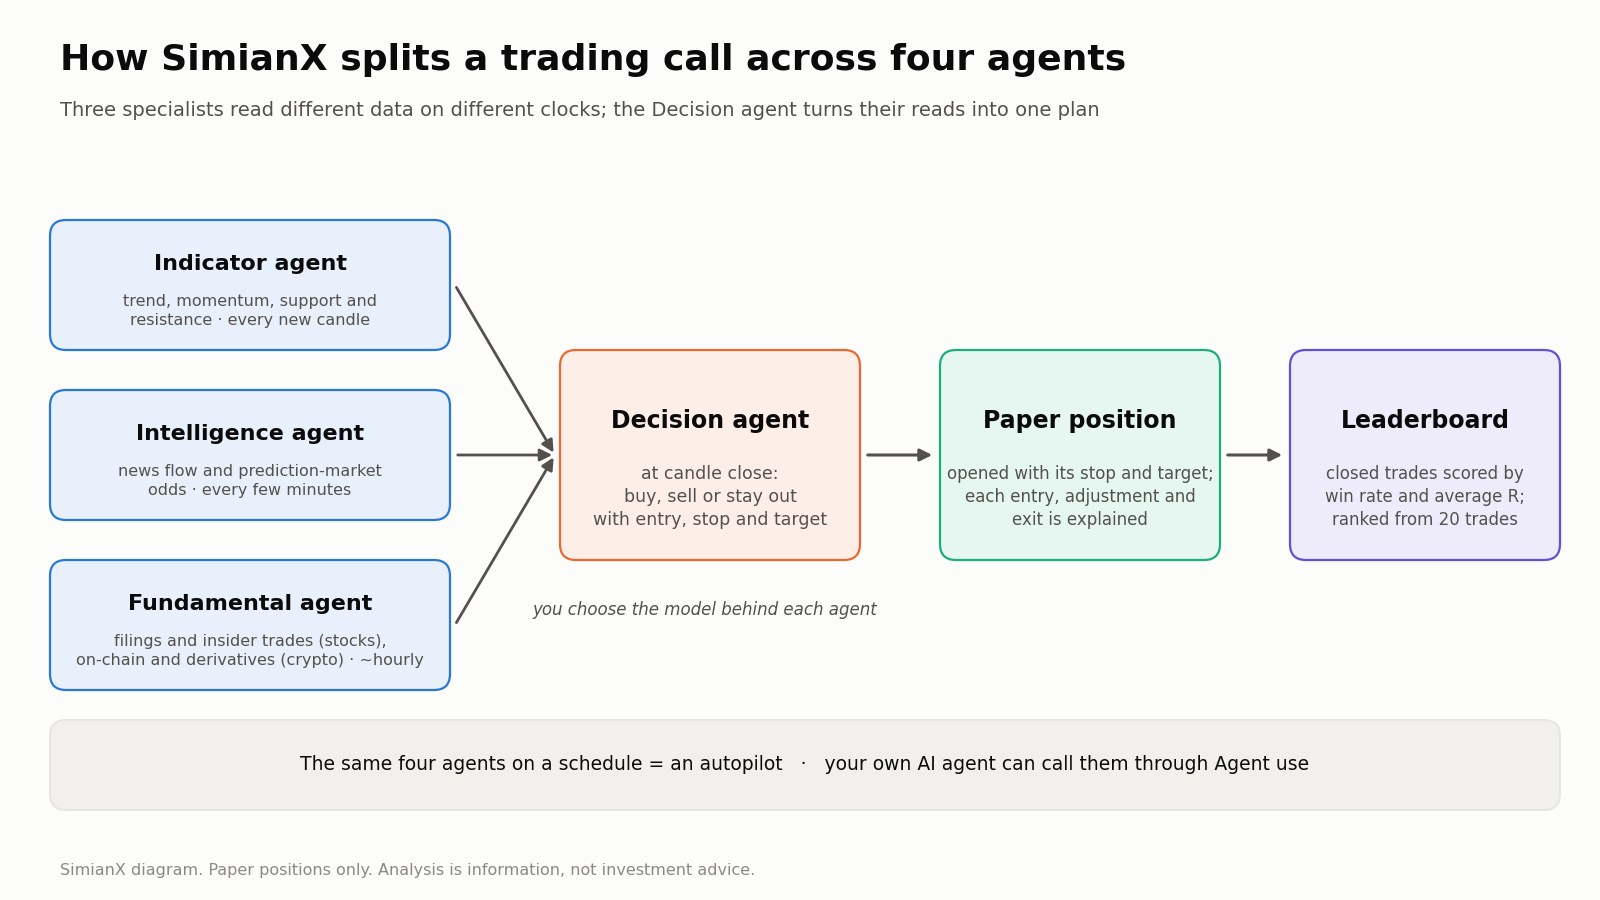
Lorsque vous ouvrez une action américaine ou une paire de cryptomonnaies dans la salle d'analyse en direct et que vous choisissez une unité de temps, quatre agents se mettent au travail. La couverture s'étend à plus de 13 000 actions et ETF américains et à plus de 4 000 paires de cryptomonnaies, à partir des bougies d'une minute.
- L'agent Indicateurs lit le graphique : tendance, dynamique, supports et résistances. Il s'exécute à chaque nouvelle bougie.
- L'agent Renseignement lit le flux d'actualités sur le symbole et, quand elles existent, les probabilités des marchés de prédiction. Il se met à jour toutes les quelques minutes.
- L'agent Fondamentaux lit les documents réglementaires et les transactions des dirigeants pour une action, ou les données sur la blockchain (on-chain) et sur les dérivés pour une cryptomonnaie. Ces données évoluent lentement : par défaut, il se met à jour environ une fois par heure.
- L'agent Décision pèse les trois autres à la clôture d'une bougie et dit quoi faire : acheter, vendre ou rester à l'écart, avec un point d'entrée, un stop et un objectif.
Quand une configuration se présente, le système ouvre une position fictive avec ce stop et cet objectif, puis explique chaque entrée, ajustement et sortie au fil de la transaction. Vous choisissez le modèle derrière chaque agent. Les quatre mêmes agents peuvent aussi tourner selon un calendrier sous forme de pilote automatique, et le flux d'actualités notées dont se nourrit l'agent Renseignement est celui qui alimente le Pouls du Marché.
Pourquoi découper le travail ainsi ? Les trois spécialistes tournent à des rythmes différents : les séparer permet de rafraîchir la lecture du graphique à chaque bougie sans payer pour relire un document réglementaire qui n'a pas changé. Cela garde le contexte de chaque agent restreint et ciblé. Et cela rend le désaccord visible : quand le graphique annonce une « cassure » et que l'agent d'actualité signale une publication de résultats le lendemain, l'agent Décision doit traiter ce conflit au lieu d'en faire la moyenne.
Recherche approfondie : un comité de huit agents
Pour un regard plus posé et plus profond sur une action ou une cryptomonnaie, la recherche approfondie réunit un comité de huit. Quatre analystes enquêtent en parallèle : les fondamentaux, le graphique, l'actualité, et un quatrième siège qui apporte une lecture du bon moment pour agir côté actions et un analyste des dérivés côté crypto. Un chercheur haussier et un chercheur baissier construisent ensuite la thèse la plus solide de chaque camp. Un directeur de recherche anime un débat sur les principaux désaccords, chaque membre réaffirme sa position lors d'un vote final, et un gestionnaire des risques rédige la décision avec des niveaux de prix vérifiés. Notre visite guidée du comité reconstruit suit une exécution complète, écran par écran.
C'est le schéma du débat issu de la littérature scientifique, mis en production. Le baissier existe parce qu'un comité d'analystes conciliants n'est en réalité qu'une seule opinion répétée quatre fois.
Comment le classement mesure les résultats
Un agent qui prend des décisions de marché doit être jugé sur ses résultats, pas sur la force de persuasion de son raisonnement. Le classement crypto note les modèles d'IA qui se trouvent derrière ces positions fictives, et seules comptent les transactions clôturées, dénouées aux prix réels du marché. Il couvre actuellement plus de 30 modèles issus de plusieurs laboratoires d'IA et mesure chacun de deux façons :
- Taux de réussite : la part des transactions clôturées qui se sont soldées par un gain.
- R moyen : le gain par transaction exprimé en unités du risque pris à l'entrée. Une position acheteuse à 100 avec un stop à 98 risque 2 par unité ; clôturer à 104 donne +2R, et un stop touché en entier donne −1R.
Un modèle n'est classé qu'après 20 transactions clôturées dans les filtres actifs, de sorte qu'une poignée de transactions chanceuses ne peut pas le hisser en tête, et l'on peut filtrer par période, unité de temps et sens. Lire les deux chiffres ensemble est essentiel : un taux de réussite élevé avec un R faible peut cacher quelques grosses pertes, tandis qu'un taux de réussite modeste avec un R élevé peut traduire des gains moins fréquents mais plus importants. Nous avons comparé les modèles du classement dans Quel Modèle d'IA Trade le Mieux ? 30 LLMs au P&L Réel et dans notre guide GPT vs Gemini vs Claude.
Connecter votre propre agent
Le même système est ouvert aux agents extérieurs. La page Utilisation par agent explique comment fournir à Claude Code, Codex, Cursor ou à un autre agent le skill SimianX et une clé d'API, afin qu'il puisse lancer une analyse en direct à quatre agents sur n'importe quel symbole, suivre le flux d'actualités notées ou lancer une recherche approfondie. Votre agent reçoit sa propre clé, avec le budget que vous fixez. Il n'obtient jamais vos identifiants du site, et chaque position qu'il gère est une position fictive.
Avertissement sur les risques : Tout ce qui précède décrit un logiciel qui produit des analyses et des transactions fictives. Il s'agit d'information, pas de conseil en investissement. Les modèles d'IA se trompent, les résultats du classement décrivent des transactions passées et ne préjugent pas des performances futures, et aucun modèle ni aucun comité ne supprime le risque de marché. N'engagez jamais de l'argent que vous ne pouvez pas vous permettre de perdre sur la foi d'une recommandation d'IA.
Les types d'agents IA en 2026
La classification des manuels
Les manuels classent les agents selon leur manière de décider, et ces catégories aident encore à comprendre les systèmes modernes :
| Type | Comment il décide | Exemple |
|---|---|---|
| Agent réflexe simple | Règles fixes condition-action appliquées à l'entrée du moment | Un thermostat ; une alerte de prix |
| Agent réflexe fondé sur un modèle | Des règles plus une représentation interne de ce qu'il ne peut pas observer directement | Un filtre anti-spam qui suit l'historique d'un expéditeur |
| Agent fondé sur des buts | Cherche les actions qui atteignent un but fixé | Un calculateur d'itinéraire |
| Agent fondé sur l'utilité | Choisit l'action offrant le meilleur compromis attendu | Un agent de marché qui met en balance gain et risque |
| Agent apprenant | Améliore son comportement grâce aux retours | Un système de recommandation qui s'ajuste aux clics |
Les agents fondés sur des modèles de langage combinent ces types. Ils sont fondés sur des buts dans ce qu'ils poursuivent, sur l'utilité lorsqu'ils pèsent des options, et ils apprennent au sein d'une tâche en réfléchissant à leurs résultats.
Les catégories de produits
Classés selon ce qu'ils font réellement, les agents utilisés en 2026 se répartissent en cinq grandes catégories. Les produits cités sont des exemples, pas des recommandations, et leurs capacités évoluent vite.
Les agents de programmation. Un agent IA de programmation lit un dépôt de code, modifie des fichiers, lance les tests et propose une modification, souvent sous forme de demande de fusion (pull request). Parmi les exemples figurent Claude Code d'Anthropic, Codex d'OpenAI, l'agent de programmation de GitHub Copilot, Cursor et Devin de Cognition. On les compare souvent sur SWE-bench, qui leur demande de résoudre de vrais tickets issus de projets à code source ouvert. Des travaux de METR suggèrent que la durée des tâches logicielles que les agents de pointe accomplissent avec 50 % de fiabilité a doublé environ tous les sept mois depuis 2019.
Les agents de recherche. Ils interrogent le web ou une collection de documents, lisent de nombreuses sources et rédigent un rapport sourcé. Google a lancé Gemini Deep Research en décembre 2024, et OpenAI a lancé deep research dans ChatGPT en février 2025. Leur point faible est la qualité des sources : un rapport bien écrit peut reposer sur une source médiocre.
Les agents de navigation et d'utilisation d'ordinateur. Ils pilotent un navigateur ou tout un bureau en regardant l'écran, en cliquant et en tapant. Anthropic a lancé computer use en octobre 2024. Operator, d'OpenAI, lancé en janvier 2025, a été intégré à ChatGPT agent en juillet 2025, et Google dispose de Project Mariner. Ils sont plus lents et moins fiables que les agents qui passent par des API, c'est pourquoi on les réserve généralement aux sites qui n'en proposent pas.
Les agents généralistes. Ils reçoivent un objectif large et combinent navigation, code et fichiers pour l'atteindre. Manus, lancé en mars 2025, en est l'exemple le plus connu. Meta a accepté d'acquérir l'entreprise en décembre 2025 ; en avril 2026, la Commission nationale du développement et de la réforme de Chine a ordonné l'annulation de l'opération.
Les agents de marché et d'analyse financière. Ils lisent des données de marché, l'actualité et des documents réglementaires, puis produisent des plans de transaction ou gèrent des positions. Des cadres académiques comme TradingAgents (Xiao et al., 2024) modélisent une société de gestion avec des rôles d'analyste, de chercheur, d'opérateur et de gestion des risques, et des produits comme SimianX font tourner des comités similaires sur des données en direct. Les marchés sont adverses et bruités : c'est donc la catégorie où un historique public, transaction par transaction, compte le plus.
Comment évaluer un agent IA : la liste de contrôle
Que vous choisissiez un agent de programmation, un outil de recherche ou un assistant d'investissement, les mêmes questions séparent les agents utiles des démonstrations.
| Question | Ce qui est bon signe | Signal d'alerte |
|---|---|---|
| Est-ce vraiment un agent ? | Il choisit ses propres étapes et ses outils | Un script figé affublé de l'étiquette « agent » |
| Fonctionne-t-il sur vos tâches ? | Testé sur 10 à 20 tâches réelles tirées de votre propre travail | Uniquement des démonstrations du fournisseur et des scores de bancs d'essai |
| Est-il constant ? | Des résultats similaires quand la même tâche est lancée plusieurs fois | Une exécution brillante, puis des échecs |
| Combien coûte une tâche menée à bien ? | Le coût par tâche accomplie est mesuré et plafonné | Seuls des prix par appel sont annoncés |
| Combien de temps prend-il ? | La rapidité convient au travail demandé | Des minutes d'attente pour une réponse d'une ligne |
| Pouvez-vous voir ce qu'il a fait ? | Une trace complète des étapes, des appels d'outils et des sources | Une réponse finale sans aucune trace |
| À quoi a-t-il accès ? | Accès minimal, bac à sable ou mode fictif, validation pour les actions irréversibles | Des identifiants étendus et aucune étape de validation |
| Comment s'arrête-t-il ? | Budgets, limites d'étapes et règle d'arrêt claire | Tourne en boucle jusqu'à ce que quelqu'un s'en aperçoive |
| Ses données sont-elles fraîches ? | Un horodatage sur chaque donnée | Des chiffres périmés présentés comme actuels |
| Pour les agents de marché : quel est l'historique ? | Transactions clôturées aux prix réels, taille de l'échantillon affichée, taux de réussite et rendement ajusté du risque | Seulement des tests rétrospectifs, ou un taux de réussite sans nombre de transactions |
Questions fréquentes
Qu'est-ce qu'un agent IA, en termes simples ?
Un agent IA est un programme qui utilise un modèle d'intelligence artificielle pour atteindre un objectif par lui-même. Il observe la situation, choisit une étape, utilise un outil comme la recherche ou le code pour l'exécuter, vérifie le résultat et recommence jusqu'à ce que le travail soit terminé ou qu'il ait besoin d'une personne.
Quelle est la différence entre un agent IA et un chatbot ?
Un chatbot répond à un message à la fois, puis attend votre prochaine question. Un agent continue de travailler vers un objectif sur de nombreuses étapes, choisit les outils à utiliser et peut mener une tâche à son terme, comme corriger du code ou rédiger un rapport, sans nouvelle consigne à chaque étape.
Qu'est-ce qu'un système multi-agents ?
Un système multi-agents est un groupe d'agents IA aux rôles différents qui travaillent sur une même tâche. Ils peuvent se répartir le travail, défendre des positions opposées ou voter, puis un agent final ou une règle fixe combine leurs productions. Sur des tâches larges, ils font souvent mieux qu'un agent unique, pour un coût bien plus élevé.
Qu'est-ce qu'un agent IA de programmation ?
Un agent IA de programmation travaille à l'intérieur d'un projet logiciel : il lit le code, modifie des fichiers, lance des tests et propose des modifications. Parmi les exemples figurent Claude Code, OpenAI Codex, l'agent de programmation de GitHub Copilot, Cursor et Devin.
Qu'est-ce que Manus AI ?
Manus est un agent IA généraliste, lancé en mars 2025, qui reçoit un objectif large et combine navigation, code et fichiers pour l'atteindre. Meta a accepté de racheter l'entreprise en décembre 2025, et en avril 2026 les autorités chinoises ont ordonné l'annulation de l'opération.
Les agents IA peuvent-ils négocier des actions ou des cryptomonnaies ?
Ils peuvent analyser les marchés et gérer des positions, et certains produits, dont SimianX, permettent à des agents de mener des positions fictives avec stops et objectifs. Les résultats varient fortement selon le modèle et le marché : jugez donc tout agent de marché sur son historique de transactions clôturées, et considérez ce qu'il produit comme de l'information, non comme un conseil.
Comment connecter mon propre agent IA à une analyse de marché en direct ?
La page Utilisation par agent de SimianX explique comment installer le skill SimianX dans Claude Code, Codex, Cursor et d'autres agents. Votre agent reçoit sa propre clé d'API, avec un budget que vous contrôlez, et peut lancer des analyses multi-agents en direct, suivre le flux d'actualités notées et lancer des recherches approfondies.
Lecture Liée
- Analyse d'actions par IA : un comité de 8 agents vous répond
- 8 Analystes IA vs 1 : +37% Précision, −41% Risque Net
- Quel Modèle d'IA Trade le Mieux ? 30 LLMs au P&L Réel
- 30+ Modèles IA, 6 Fournisseurs : Classement Crypto Live
- GPT vs Gemini vs Claude pour l’analyse boursière IA 2026
- IA Multi-Agent vs ChatGPT pour NVDA: Comparatif 2026
- Autopilotes IA pour la crypto 24/7 : le guide complet 2026
- Analyse Boursière en Direct : Agents IA sur Actions US
- Investir avec Agentic IA : Guide Débutant Next-Gen
Références
- Russell et Norvig — Artificial Intelligence: A Modern Approach
- Anthropic — Building Effective Agents (décembre 2024)
- Anthropic — How we built our multi-agent research system (juin 2025)
- Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du et al. — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri et al. — Why Do Multi-Agent LLM Systems Fail?
- Yao et al. — τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao et al. — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — documentation officielle
- Protocole Agent2Agent (A2A) — site officiel
- Gartner — Plus de 40 % des projets d'IA agentique seront abandonnés d'ici fin 2027 (juin 2025)
- TechCrunch — La Chine bloque le rachat de Manus par Meta pour 2 milliards de dollars (avril 2026)
- IBM — Qu'est-ce qu'un agent IA ?
- OWASP — Top 10 des risques pour les applications à base de grands modèles de langage