 लेखक: Marcus Reeve
AI ट्रेडर को कैसे परखें: औसत R, जीत दर और नमूने का आकार
छोटा जवाब: 15 अक्टूबर 2026 तक SimianX क्रिप्टो AI रैंकिंग तालिका पर (पूरी अवधि, सभी टाइमफ़्रेम, खरीद और बिक्री दोनों पक्ष) सबसे ऊँचे औसत R वाला मॉडल Grok 4.6 था, जिसने 240 सौदों में प्रति सौदा +0.59R कमाया। उसके बाद DeepSeek V4 Pro (+0.44R, 253 सौदे) और Gemini 3.8 Flash (+0.44R, 168 सौदे) रहे। सबसे ऊँची जीत दर वाले मॉडल Grok 4 Fast Non-Reasoning ने अपने 1,373 सौदों में से 68.0% मुनाफ़े में बंद किए, लेकिन उसका औसत केवल +0.08R रहा। यही अंतर इस तालिका का सबसे काम का सबक है: कोई मॉडल कितनी बार जीतता है, यह इस बात से कहीं कम बताता है कि वह उठाए गए जोखिम के बदले कितना कमाता है।
सौदे बंद होने के साथ रैंकिंग बदलती रहती है, इसलिए इन नामों को एक तय तारीख़ की तस्वीर मानें और भरोसा करने से पहले लाइव तालिका देख लें। इस गाइड का बाक़ी हिस्सा बताता है कि तालिका कैसे बनती है, औसत R का मतलब क्या है, ख़ुद को धोखा दिए बिना इसे कैसे पढ़ें, और यह क्या नहीं बता सकती।
"सबसे अच्छा AI ट्रेडर" कौन है, इसका जवाब देना कठिन क्यों है
कौन-सा AI सबसे अच्छा ट्रेड करता है, इस बारे में ज़्यादातर दावे तीन में से किसी एक कसौटी पर फ़ेल हो जाते हैं।
बेंचमार्क सौदे नहीं हैं। तर्क या कोडिंग के किसी बेंचमार्क में अव्वल आने वाले मॉडल ने ट्रेडिंग के बारे में कुछ भी साबित नहीं किया है। बाज़ार शोर से भरे होते हैं और लगातार बदलते रहते हैं, और अच्छा सौदा अनिश्चितता के बीच लिया गया फ़ैसला है, याददाश्त की परीक्षा नहीं।
बैकटेस्ट को मनमाफ़िक ढाला जा सकता है। किसी बैकटेस्ट को तब तक बदला जा सकता है जब तक उसका ग्राफ़ एकदम सही न दिखने लगे, और यही ओवरफ़िटिंग है: रणनीति ने असल में उत्तर-पुस्तिका पहले ही देख ली है। इसका इलाज आगे की ओर चलने वाला परीक्षण है, जो वॉक-फ़ॉरवर्ड परीक्षण के विचार के क़रीब है, जिसमें हर फ़ैसला उसका नतीजा पता चलने से पहले लिया जाता है।
छोटे नमूने क़िस्मत वालों को चमका देते हैं। दस सौदे किसी भी मॉडल को प्रतिभाशाली या बेकार दिखा सकते हैं। भरोसेमंद तालिका को नमूने का एक न्यूनतम आकार चाहिए और उसे वह आकार दिखाना भी चाहिए।
SimianX की तालिका इन्हीं तीन समस्याओं को ध्यान में रखकर बनाई गई है। यह पूर्ण नहीं है, और नीचे दिया गया सीमाओं वाला हिस्सा ख़ुद रैंकिंग जितना ही अहम है।
SimianX रैंकिंग तालिका कैसे काम करती है
तालिका केवल बंद हो चुके क्रिप्टो सौदों को गिनती है; खुली पोज़ीशन बंद होने के बाद जुड़ती हैं। इसके सौदे दो स्रोतों से आते हैं।
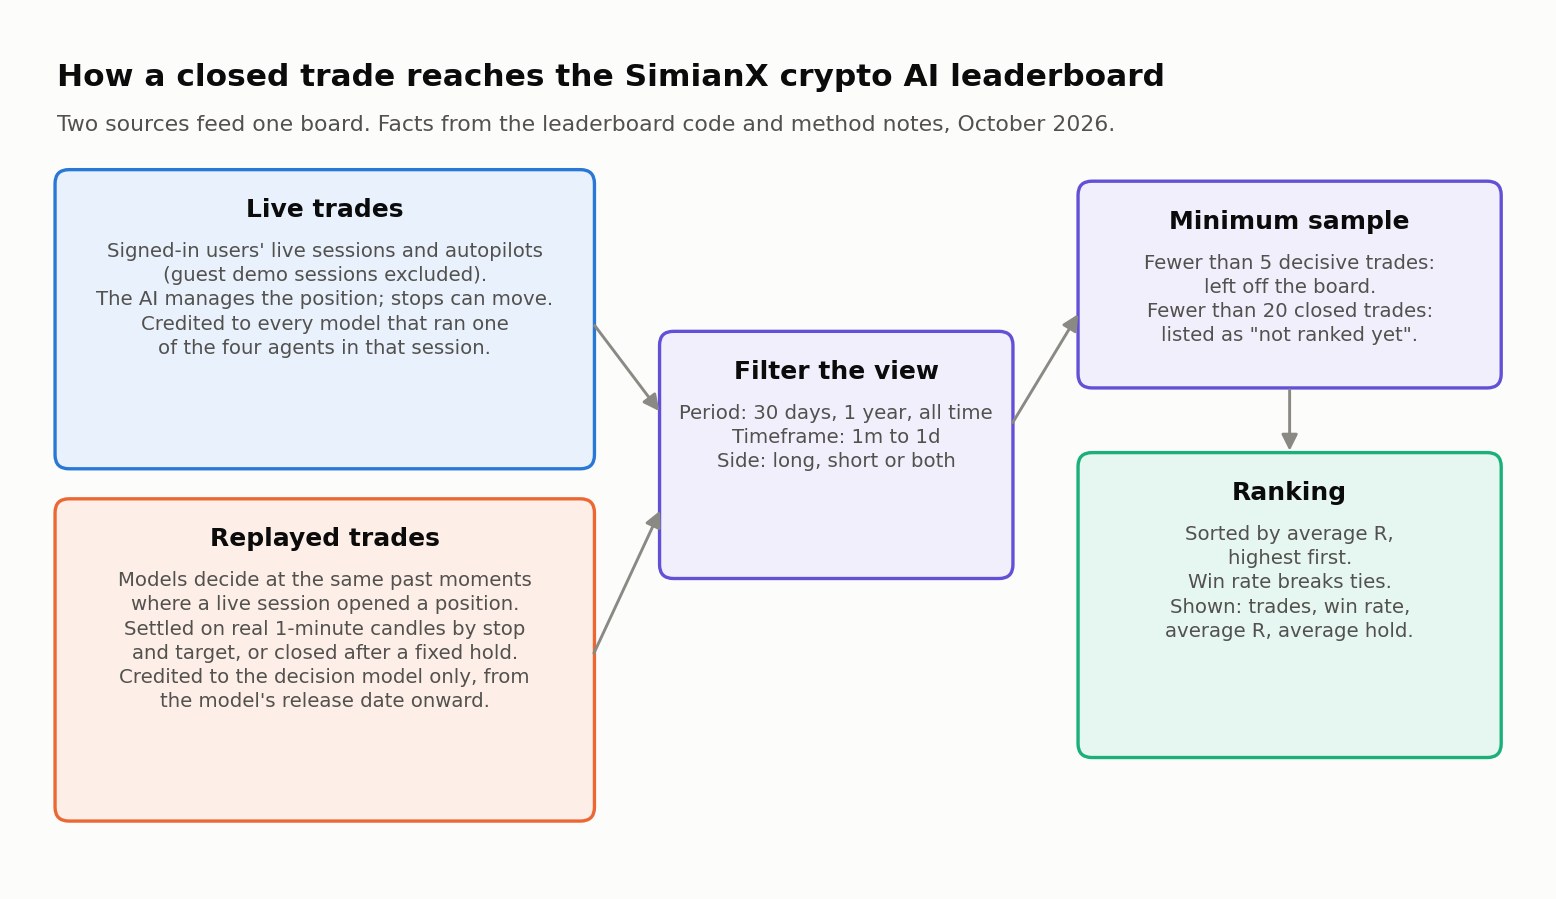
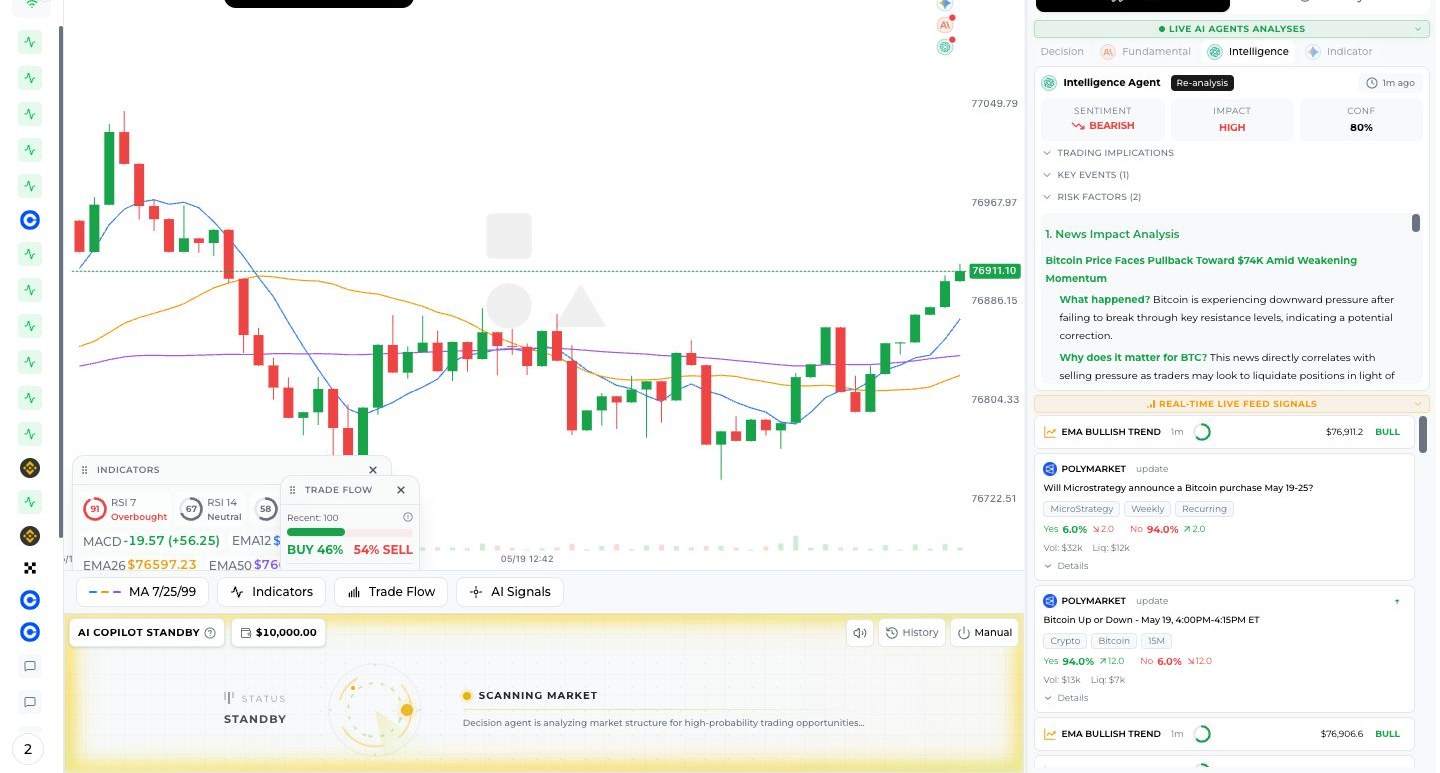
असली सौदे। ये साइन-इन किए हुए उपयोगकर्ताओं के लाइव क्रिप्टो सत्रों और ऑटोपायलटों से आते हैं, जिनमें पोज़ीशन का प्रबंधन AI ने किया। मेहमानों के डेमो सत्र शामिल नहीं होते। लाइव विश्लेषण कक्ष में चार एजेंट साथ काम करते हैं, इंडिकेटर (Indicator), इंटेलिजेंस (Intelligence), फ़ंडामेंटल (Fundamental) और डिसीज़न (Decision), और उपयोगकर्ता हर एजेंट के लिए अलग मॉडल चुन सकता है। इसलिए एक असली सौदे का श्रेय उस सत्र में चारों में से किसी भी एजेंट को चलाने वाले हर मॉडल को जाता है, और हर मॉडल का पेज दिखाता है कि उसने कौन-कौन सी भूमिकाएँ निभाईं।
दोहराए गए सौदे। मॉडलों की बराबरी से तुलना करने के लिए तालिका इतिहास को दोबारा भी चलाती है। दोहराव वाले समूह के हर मॉडल से लाइव निर्णय वाले उसी प्रॉम्प्ट के ज़रिए कहा जाता है कि वह अतीत के उन्हीं पलों पर फ़ैसला ले, जब किसी लाइव सत्र ने पोज़ीशन खोली थी। फिर उसकी एंट्री का निपटारा एक्सचेंज की असली 1-मिनट कैंडल पर उसके अपने स्टॉप और लक्ष्य से होता है, या एक तय होल्डिंग अवधि के बाद बाज़ार भाव पर सौदा बंद कर दिया जाता है; बीच में कोई प्रबंधन नहीं होता। दोहराया गया सौदा तभी गिना जाता है जब वह मॉडल के जारी होने की तारीख़ को या उसके बाद खोला गया हो, और उसका श्रेय केवल निर्णय लेने वाले मॉडल को जाता है।
15 अक्टूबर 2026 तक तालिका के पीछे के डेटाबेस में 5,154 बंद असली पोज़ीशन (22 जनवरी 2026 से) और 3,056 दोहराए गए सौदे (13 जुलाई 2026 से) थे। चूँकि एक असली पोज़ीशन अधिकतम चार मॉडलों के खाते में गिनी जा सकती है, इसलिए किसी मॉडल के सौदों की संख्या उन पोज़ीशनों की संख्या नहीं है जो उसने अकेले खोलीं।
पेज रैंकिंग के जो नियम लागू करता है, वे ये हैं:
| नियम | यह क्या करता है |
|---|---|
| क्रम | प्रति सौदा औसत R, सबसे ऊँचा पहले; बराबरी होने पर जीत दर से फ़ैसला |
| रैंक पाने की न्यूनतम शर्त | मौजूदा दृश्य में कम से कम 20 बंद सौदे; इससे कम वाले मॉडल "अभी रैंक नहीं" के रूप में दिखते हैं |
| तालिका में दिखने की न्यूनतम शर्त | कम से कम 5 निर्णायक सौदे (जीत और हार मिलाकर); बराबरी पर बंद सौदे जीत दर से बाहर रखे जाते हैं |
| कॉलम | सौदे, जीत दर, औसत R, औसत होल्डिंग समय |
| फ़िल्टर | अवधि (30 दिन, 1 साल, पूरी अवधि), टाइमफ़्रेम (1 मिनट से 1 दिन), पक्ष (खरीद या बिक्री) |
| सेवानिवृत्त मॉडल | "सेवानिवृत्त" टैग के साथ तालिका पर बने रहते हैं; उनके पुराने सौदे गिने जाते रहते हैं |
| मॉडल पेज | जीत दर के नीचे 95% का दायरा, मॉडल की निभाई भूमिकाएँ, हाल के सौदे और अवधि के हिसाब से ब्योरा |
तालिका क्या नहीं दिखाती: डॉलर में लाभ-हानि, अधिकतम गिरावट, शार्प अनुपात या पोज़ीशन का आकार। मुख्य पैमाना औसत R है।
औसत R का मतलब क्या है
R किसी सौदे के नतीजे को एंट्री के समय उठाए गए जोखिम की इकाइयों में मापता है। 1R वह रक़म है जो सौदा तब गँवाता, जब वह खुलते समय लगाए गए स्टॉप-लॉस को छू लेता।
- 100 पर खरीद और 98 पर स्टॉप का मतलब है प्रति इकाई 2 का जोखिम। 104 पर बंद करना +2R है, 99 पर बंद करना −0.5R है, और 98 के स्टॉप पर लगना −1R है।
- औसत R सभी बंद सौदों का औसत है। शून्य से ऊपर का मतलब है कि मॉडल जोखिम की हर इकाई पर पैसा कमाता है; +0.20R का मतलब है कि उसने हर सौदे में जितना जोखिम उठाया, औसतन उसका पाँचवाँ हिस्सा कमाया।
औसत R किसी सौदे के अपेक्षित मान का ही एक रूप है, जिसे जोखिम की इकाइयों में मापा जाता है। इसी वजह से तालिका जीत दर नहीं, बल्कि R के आधार पर क्रम लगाती है: अगर किसी मॉडल के घाटे उसके मुनाफ़ों से बड़े हों, तो वह अक्सर जीतकर भी पैसा गँवा सकता है।
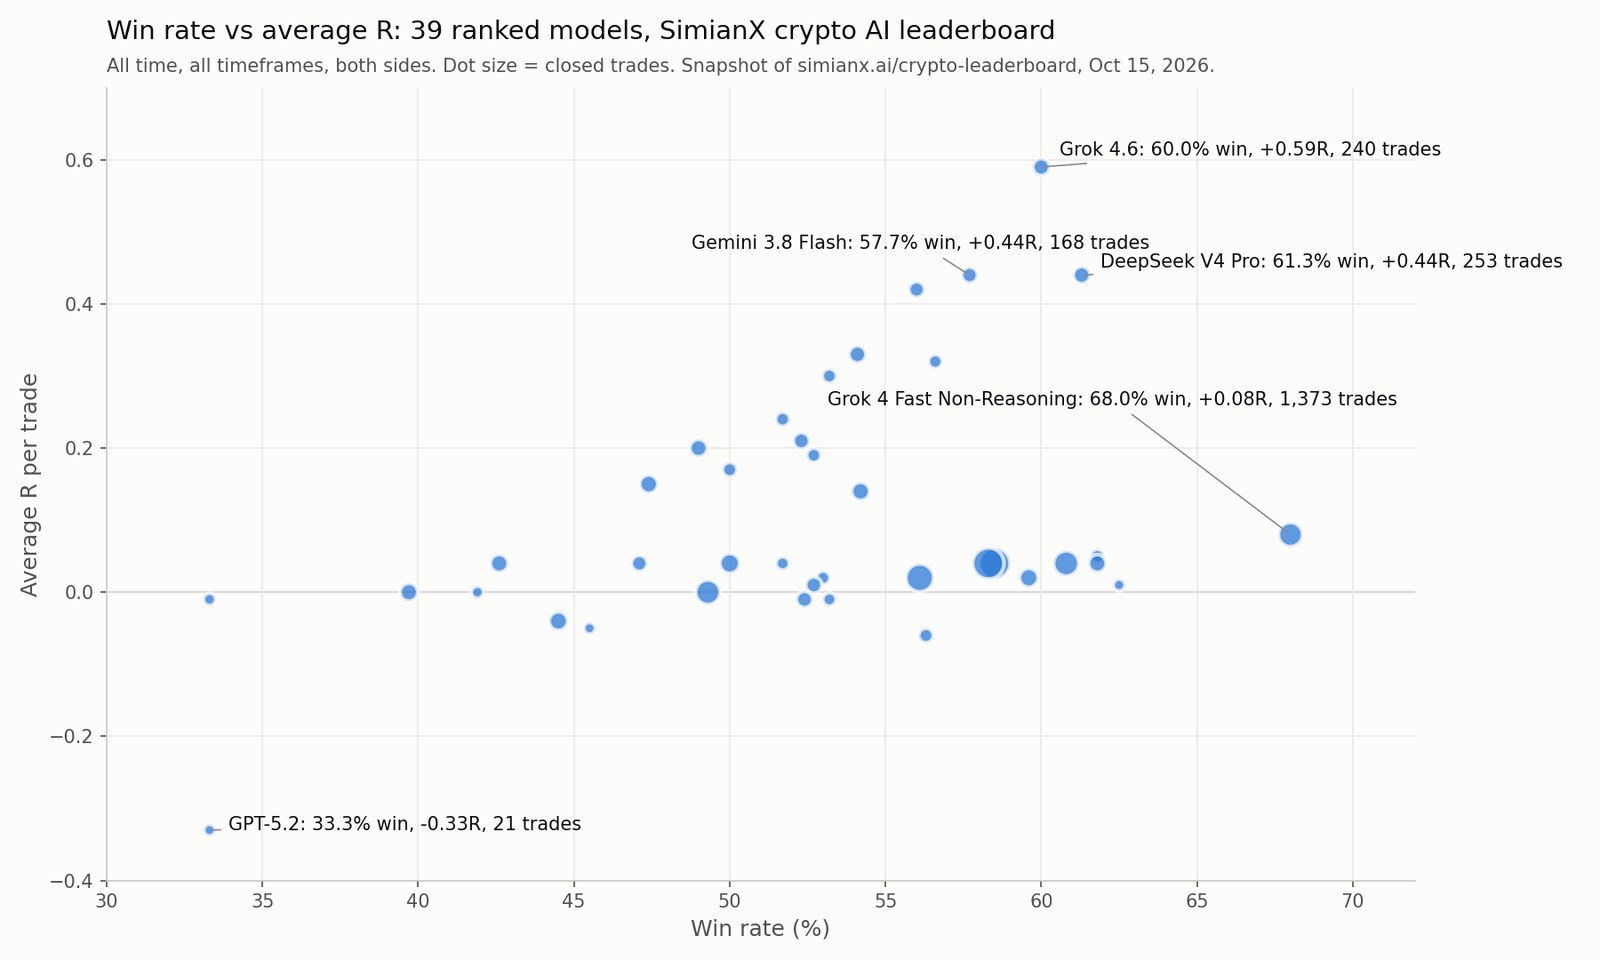
15 अक्टूबर 2026 की तालिका
नीचे की तालिका डिफ़ॉल्ट दृश्य (पूरी अवधि, सभी टाइमफ़्रेम, दोनों पक्ष) में रैंक पाए शीर्ष दस मॉडल दिखाती है। उस दिन 39 मॉडल रैंक में थे और 5 और मॉडल "अभी रैंक नहीं" के रूप में दर्ज थे, जो आठ प्रदाताओं से थे: OpenAI, Anthropic, Google, xAI, DeepSeek, Qwen, Kimi और Z.ai।
| रैंक | मॉडल | प्रदाता | औसत R | जीत दर | सौदे |
|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.59R | 60.0% | 240 |
| 2 | DeepSeek V4 Pro | DeepSeek | +0.44R | 61.3% | 253 |
| 3 | Gemini 3.8 Flash | +0.44R | 57.7% | 168 | |
| 4 | DeepSeek Flash | DeepSeek | +0.42R | 56.0% | 166 |
| 5 | GLM 5.3 | Z.ai | +0.33R | 54.1% | 257 |
| 6 | Claude Sonnet 5.5 | Anthropic | +0.32R | 56.6% | 76 |
| 7 | GPT-6 Luna | OpenAI | +0.30R | 53.2% | 94 |
| 8 | Grok 4.7 | xAI | +0.24R | 51.7% | 89 |
| 9 | GPT-6 Astra | OpenAI | +0.21R | 52.3% | 197 |
| 10 | Gemini 3.1 Pro Preview | +0.20R | 49.0% | 286 |
अब उसी दिन की तीन सबसे ऊँची जीत दरों से तुलना करें:
| मॉडल | जीत दर | औसत R | सौदे | औसत R के हिसाब से रैंक |
|---|---|---|---|---|
| Grok 4 Fast Non-Reasoning (सेवानिवृत्त) | 68.0% | +0.08R | 1,373 | 15 |
| GPT-5.6 Luna | 62.5% | +0.01R | 24 | 28 |
| GPT-4o | 61.8% | +0.05R | 76 | 16 |
तीन बातें सामने आती हैं। पहली, ऊँची जीत दर के साथ शून्य के क़रीब R का मतलब आमतौर पर होता है कई छोटे मुनाफ़े और कुछ बड़े घाटे। दूसरी, रैंक पाए मॉडलों का औसत सबसे ऊपर +0.59R से लेकर सबसे नीचे −0.33R तक फैला है, यानी इस डेटा पर मॉडल का चुनाव साफ़ तौर पर मायने रखता है। तीसरी, नए मॉडल अपने-आप नहीं जीतते: हाल में जारी कई मॉडल शून्य R के आसपास हैं।
ख़ुद को धोखा दिए बिना तालिका कैसे पढ़ें
- नमूने का आकार जाँचें। मॉडल पेज हर जीत दर के नीचे 95% का दायरा दिखाते हैं (एक विल्सन अंतराल)। 240 सौदों पर 60% की जीत दर हो, तो असली जीत दर सबसे अधिक संभावना से लगभग 54% और 66% के बीच है। 24 सौदों पर 62.5% हो, तो दायरा लगभग 43% से 79% तक जाता है, जो कोई ठोस निष्कर्ष निकालने के लिए बहुत चौड़ा है।
- R और जीत दर को साथ पढ़ें। सबसे अच्छी तस्वीर वह है जिसमें ठीक-ठाक जीत दर के साथ बहुत सारे सौदों पर कमाया गया धनात्मक औसत R हो। अकेली ऊँची जीत दर काफ़ी नहीं है।
- अपने ट्रेड करने के तरीक़े के हिसाब से छाँटें। एक ही मॉडल 1-मिनट और 4-घंटे के चार्ट पर, और खरीद व बिक्री के सौदों में अलग बर्ताव कर सकता है। निष्कर्ष निकालने से पहले टाइमफ़्रेम और पक्ष तय करें।
- होल्डिंग समय देखें। औसत अवधि कुछ मिनटों से लेकर एक दिन से ज़्यादा तक है। 13 मिनट रखने वाला मॉडल और 16 घंटे रखने वाला मॉडल अलग-अलग काम कर रहे हैं।
- अवधि पर नज़र रखें। 30 दिन का दृश्य हाल के बर्ताव पर जल्दी प्रतिक्रिया देता है; पूरी अवधि में डेटा ज़्यादा है, पर बाज़ार की पुरानी स्थितियाँ भी शामिल हैं।
- मॉडल पेज खोलें। हाल के सौदे, मॉडल की निभाई भूमिकाएँ और उसका ब्योरा बताते हैं कि कोई आँकड़ा कैसे कमाया गया।
सीमाएँ: तालिका क्या नहीं बता सकती
इन बातों को साफ़ बताना ही रैंकिंग को उद्धृत करने लायक बनाता है।
- असली और दोहराए गए सौदे मिले हुए हैं। दोनों स्रोत अलग तरह से मापे जाते हैं। असली पोज़ीशनों का एंट्री के बाद प्रबंधन हो सकता है (स्टॉप खिसक सकते हैं); दोहराए गए सौदों का एंट्री और निकास के बीच कभी प्रबंधन नहीं होता।
- असली सौदों का श्रेय बँटता है। एक असली सौदा उस सत्र में चारों में से किसी भी एजेंट को चलाने वाले हर मॉडल के खाते में गिना जाता है, इसलिए किसी मॉडल का असली रिकॉर्ड अकेले उस मॉडल का नहीं, बल्कि पूरी टीम का होता है। दोहराए गए सौदे केवल निर्णय लेने वाले मॉडल को अलग करके मापते हैं।
- दोहराव में अक्सर पक्ष चुनना ज़रूरी होता है। हर तीन में से दो दोहराए गए पलों में मॉडल को खरीद या बिक्री में से एक चुनना ही पड़ता है; वह किनारे नहीं बैठ सकता। असली ट्रेडिंग में धैर्य रखने की छूट होती है।
- हर मॉडल दोहराया नहीं जाता। दोहराव वाला समूह मौजूदा मॉडलों की एक सूची है। पुराने मॉडल ज़्यादातर असली सौदों पर मापे जाते हैं, उन्हीं बाज़ारों और अवधियों में जिनमें उपयोगकर्ताओं ने उन्हें चलाया।
- डॉलर में लाभ-हानि, गिरावट या शार्प अनुपात नहीं। औसत R पोज़ीशन के आकार, चक्रवृद्धि और मॉडल के रास्ते को नज़रअंदाज़ करता है। एक जैसे औसत R वाले दो मॉडल रखने में बहुत अलग महसूस हो सकते हैं।
- केवल क्रिप्टो। तालिका क्रिप्टो सौदों को कवर करती है। यह शेयरों के बारे में सीधे कुछ नहीं कहती।
- अतीत तय कार्यक्रम से नहीं दोहराता। बाज़ार बदलने और नए सौदे बंद होने के साथ रैंकिंग बदलती है।
रैंकिंग में हेराफेरी करना कठिन क्यों है
- असली सौदे केवल आगे की ओर। लाइव फ़ैसला उसका नतीजा सामने आने से पहले होता है और बाद में बदला नहीं जा सकता।
- दोहराव के लिए जारी होने की तारीख़ का नियम। दोहराया गया सौदा केवल मॉडल के जारी होने की तारीख़ से आगे ही गिना जाता है।
- सेवानिवृत्त मॉडल बने रहते हैं। कमज़ोर या पुराने मॉडलों को समूह को बेहतर दिखाने के लिए हटाया नहीं जाता, जिससे उत्तरजीविता पूर्वाग्रह से बचाव होता है।
- दिखाई देने वाला न्यूनतम नमूना। दृश्य में 20 से कम सौदों वाले मॉडल सूची में दिखते हैं, पर रैंक नहीं पाते।
अपने विश्लेषण के लिए मॉडल चुनना
लाइव विश्लेषण कक्ष में आप चारों एजेंटों में से हर एक के पीछे का मॉडल चुन सकते हैं, और एक ऑटोपायलट उन्हीं चार एजेंटों को तय कार्यक्रम पर चलाता है। तालिका को एक आधार की तरह इस्तेमाल करें:
- पर्याप्त सौदों पर औसत R से शुरुआत करें, फिर जीत दर और उसका दायरा जाँचें।
- तुलना करने से पहले अपने टाइमफ़्रेम और पक्ष के हिसाब से छाँटें।
- नियमित अंतराल पर दोबारा जाँचें। नए मॉडल अक्सर आते हैं, और 15 अक्टूबर 2026 का अगुआ उस जगह पर हमेशा नहीं रहेगा।
- अगर आप चाहते हैं कि एजेंट सच में असहमत हों, तो अलग-अलग भूमिकाओं में अलग मॉडल रखें; स्वतंत्रता क्यों मायने रखती है, यह जानने के लिए 8 AI विश्लेषक बनाम एक पढ़ें।
चारों एजेंट काम कैसे बाँटते हैं, यह जानने के लिए AI एजेंट क्या हैं? मल्टी-एजेंट AI सिस्टम कैसे काम करते हैं पढ़ें। क्रिप्टो सौदों के बजाय शेयर शोध में मॉडल एक-दूसरे से कैसे तुलना करते हैं, यह देखने के लिए GPT बनाम Gemini बनाम Claude: AI शेयर विश्लेषण गाइड देखें।
अक्सर पूछे जाने वाले सवाल
इस समय सबसे अच्छा ट्रेड करने वाला AI मॉडल कौन-सा है? 15 अक्टूबर 2026 को पूरी अवधि वाली तालिका पर सबसे ऊँचा औसत R Grok 4.6 का था (240 सौदों पर +0.59R)। सौदे बंद होने के साथ क्रम बदलता है, इसलिए मौजूदा स्थिति के लिए रैंकिंग तालिका देखें।
जीत दर के बजाय औसत R से रैंक क्यों? क्योंकि जीत दर मुनाफ़ों और घाटों के आकार को नज़रअंदाज़ करती है। 15 अक्टूबर 2026 को सबसे ऊँची जीत दर वाले मॉडल ने प्रति सौदा केवल +0.08R कमाया।
रैंक पाने के लिए किसी मॉडल को कितने सौदे चाहिए? मौजूदा दृश्य में कम से कम 20 बंद सौदे। इससे कम वाले मॉडल "अभी रैंक नहीं" के अंतर्गत दिखते हैं। 5 से कम निर्णायक सौदों वाले मॉडल तालिका से बाहर रहते हैं।
क्या ये असली सौदे हैं? तालिका में दो तरह के सौदे मिले हैं: साइन-इन किए हुए उपयोगकर्ताओं के लाइव सत्रों और ऑटोपायलटों की पोज़ीशन, और असली ऐतिहासिक 1-मिनट कैंडल पर निपटाए गए दोहराए गए सौदे। दोनों ऊपर समझाए गए हैं।
क्या तालिका मुनाफ़ा, गिरावट या शार्प अनुपात दिखाती है? नहीं। यह सौदे, जीत दर, औसत R और औसत होल्डिंग समय दिखाती है।
क्या ऊँचा औसत R भविष्य के मुनाफ़े की गारंटी है? नहीं। यह ख़ास परिस्थितियों में बंद हुए पिछले सौदों का वर्णन करता है। पिछले नतीजे भविष्य के रिटर्न का अनुमान नहीं हैं।
निष्कर्ष
सबसे अच्छा AI ट्रेडर वह है जो उस टाइमफ़्रेम में, जिसमें आप असल में ट्रेड करते हैं, पर्याप्त सौदों पर जोखिम की हर इकाई के बदले सबसे ज़्यादा कमाता है, और इसे ईमानदारी से परखने का तरीक़ा है नमूने के आकार को सामने रखते हुए औसत R पढ़ना। 15 अक्टूबर 2026 को पूरी अवधि वाले दृश्य में यह Grok 4.6 था; जब तक आप यह पढ़ें, तब तक कोई और मॉडल हो सकता है। रैंकिंग तालिका खोलें, अपने फ़िल्टर लगाएँ, मॉडल पेज पढ़ें, और फिर अपना चुना हुआ मॉडल लाइव विश्लेषण कक्ष में आज़माएँ।
जोखिम सूचना: SimianX केवल AI आधारित बाज़ार शोध और शैक्षिक विश्लेषण देता है, निवेश सलाह नहीं। AI का आउटपुट ग़लत हो सकता है। पिछला प्रदर्शन भविष्य के नतीजों का अनुमान नहीं है, और क्रिप्टो ट्रेडिंग में पैसा डूब सकता है।
संबंधित लेख
- AI agent trading और MCP: एआई एजेंट निवेश में कैसे काम करते हैं
- 8 AI विश्लेषक बनाम एक: बहु-एजेंट समिति कैसे काम करती है
- AI एजेंट क्या हैं? मल्टी-एजेंट AI सिस्टम कैसे काम करते हैं
- क्या AI मॉडल गिरावट में घबराकर बेचते हैं? 31 बॉट बताते हैं
- ChatGPT vs Gemini vs Claude: AI स्टॉक विश्लेषण गाइड 2026
- 30+ AI मॉडल की लाइव रैंकिंग: क्रिप्टो ट्रेड लीडरबोर्ड गाइड
- क्रिप्टो ट्रेडिंग का सबसे अच्छा AI मॉडल 2026: 30+ LLM की रैंकिंग