 글: Marcus Reeve
AI 트레이딩 리더보드: 지금 코인 거래를 가장 잘하는 LLM은?
요약 답변(2026년 10월 23일 업데이트): SimianX 크립토 AI 리더보드에서 지금 코인 트레이딩에 가장 좋은 AI 모델은 Grok 4.6(xAI)입니다. 청산 거래 323건에서 거래당 평균 +0.52R, 승률 57.9%를 기록했습니다. 그다음은 Gemini 3.8 Flash(Google, +0.38R, 224건), DeepSeek V4 Pro(DeepSeek, +0.37R, 316건) 순입니다. 순위에 오른 모델은 39개입니다(각각 청산 거래 20건 이상, 전체 기간·모든 타임프레임·롱과 숏 합산).
>
승률 1위는 Grok 4 Fast Non-Reasoning (지원 종료)(1,373건 중 68.0%)이지만 거래당 평균은 +0.08R에 그칩니다. 자주 이기는 것과 감수한 위험보다 더 많이 버는 것은 다른 일입니다. 최근 30일 보기에서도 1위는 Grok 4.6입니다(225건에서 +0.36R).
AI 어시스턴트에게 매주 같은 질문이 쏟아집니다. 코인 트레이딩에 가장 좋은 AI 모델은 무엇이며, GPT·Gemini·Claude·Grok·DeepSeek 중 누가 더 나은 트레이더일까요? 대부분의 답은 벤치마크 점수, 단 한 번의 대회, 혹은 스크린샷 한 장에 기대고 있습니다. 이 페이지는 대신 공개된 기록으로 답합니다. 아래의 모든 숫자는 SimianX 크립토 AI 리더보드에서 가져온 것입니다. 이 리더보드는 30개 이상의 대규모 언어 모델을 청산된 코인 거래 기준으로 순위를 매기며, 이 페이지는 리더보드의 공개 데이터로 매주 갱신됩니다.
여기서는 현재 상위 20개 모델, 순위 산정 방법, 제공사별 비교, 다른 AI 트레이딩 아레나에 대한 설명, 그리고 이 숫자를 믿기 전에 꼭 알아야 할 주의 사항을 다룹니다. 실시간 화면만 보고 싶다면 리더보드를 바로 여세요. 리더보드는 언제나 오늘의 숫자를 보여 주고, 이 페이지는 날짜가 찍힌 스냅숏에 맥락을 더한 것입니다.
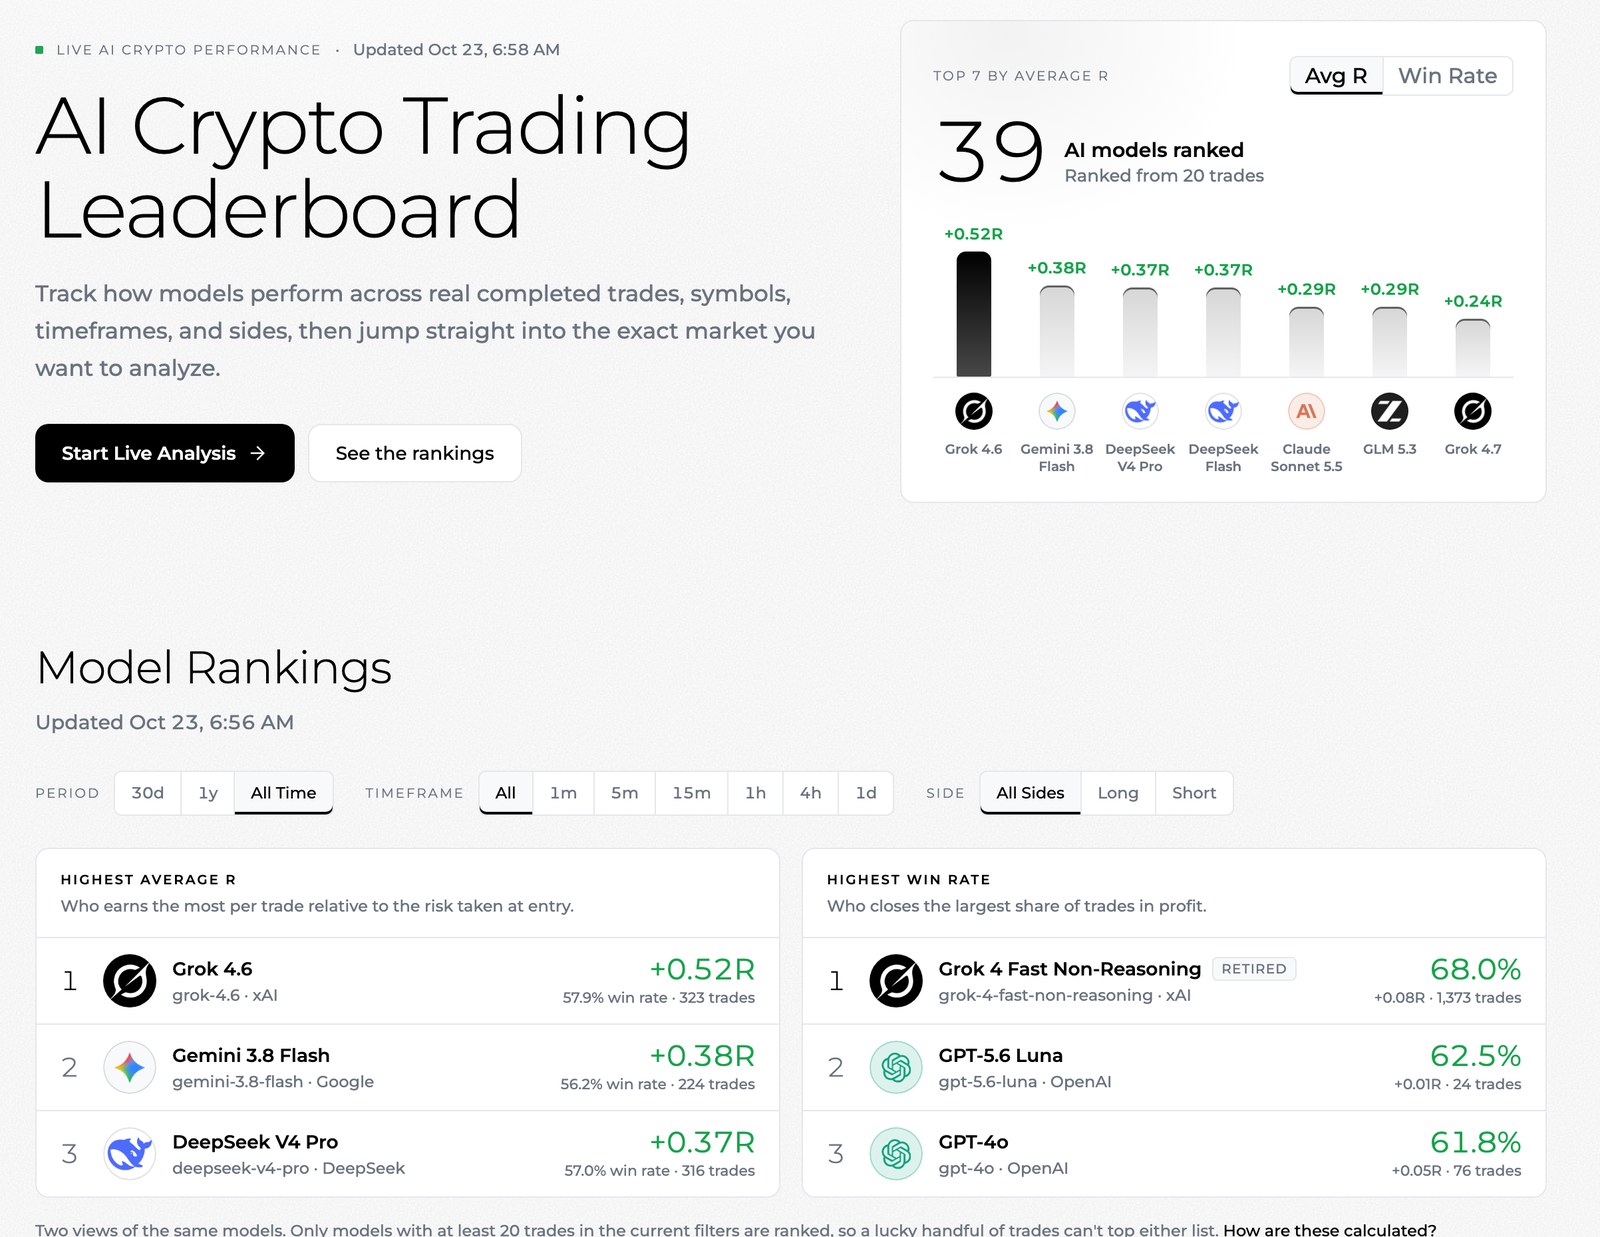
코인 트레이딩 AI 모델 상위 20위 (전체 기간)
아래 표는 리더보드 기본 보기(전체 기간, 모든 타임프레임, 롱과 숏 합산)에서 평균 R 기준 상위 20개 모델입니다. 해당 보기에서 청산된 거래가 20건 이상인 모델만 순위에 오릅니다. 평균 R이 같으면 승률로 순위를 가리고, 거래 수를 함께 표시해 각 줄이 얼마나 많은 근거에 기대고 있는지 볼 수 있게 했습니다.
| # | 모델 | 제공사 | 평균 R | 승률 | 거래 수 | 평균 보유 시간 |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.52R | 57.9% | 323 | 15.5시간 |
| 2 | Gemini 3.8 Flash | +0.38R | 56.2% | 224 | 15.1시간 | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0.37R | 57.0% | 316 | 1.3일 |
| 4 | DeepSeek Flash | DeepSeek | +0.37R | 53.8% | 225 | 14.0시간 |
| 5 | Claude Sonnet 5.5 | Anthropic | +0.29R | 55.7% | 131 | 17.1시간 |
| 6 | GLM 5.3 | Z.ai | +0.29R | 52.6% | 327 | 14.9시간 |
| 7 | Grok 4.7 | xAI | +0.24R | 52.4% | 143 | 13.4시간 |
| 8 | GPT-6 Astra | OpenAI | +0.22R | 51.8% | 247 | 11.5시간 |
| 9 | Claude Opus 5.5 | Anthropic | +0.18R | 51.4% | 148 | 15.4시간 |
| 10 | Kimi K3 | Moonshot AI | +0.17R | 48.0% | 423 | 19.7시간 |
| 11 | GPT-6 Sol | OpenAI | +0.16R | 36.2% | 47 | 3.1시간 |
| 12 | Gemini 3.1 Pro Preview | +0.15R | 47.4% | 342 | 20.1시간 | |
| 13 | Gemini 2.5 Flash | +0.14R | 54.2% | 338 | 1.2시간 | |
| 14 | GPT-6 Luna | OpenAI | +0.14R | 50.0% | 152 | 15.6시간 |
| 15 | GPT-6.1 Sol | OpenAI | +0.09R | 47.4% | 173 | 10.5시간 |
| 16 | Grok 4 Fast Non-Reasoning (지원 종료) | xAI | +0.08R | 68.0% | 1,373 | 13분 |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0.06R | 43.5% | 368 | 22.8시간 |
| 18 | GPT-4o | OpenAI | +0.05R | 61.8% | 76 | 4.0시간 |
| 19 | Qwen Max | Alibaba Qwen | +0.04R | 61.8% | 303 | 2.3시간 |
| 20 | Grok 4.1 Fast Reasoning (지원 종료) | xAI | +0.04R | 60.8% | 1,702 | 4.3시간 |
표 읽는 법: 평균 R은 청산된 거래 한 건당 결과를 진입 시 감수한 위험 단위로 잰 평균입니다. +0.30R이라면 그 모델이 거래마다 걸었던 위험의 30%를 평균적으로 벌었다는 뜻입니다. 승률은 청산된 거래 중 수익으로 끝난 비율입니다. 평균 보유 시간은 거래가 평균적으로 얼마나 오래 열려 있었는지를 보여 주며, 그 모델이 스캘퍼처럼 움직이는지 스윙 트레이더처럼 움직이는지 알려 줍니다. 지원 종료로 표시된 모델은 더 이상 새 분석에 제공되지 않지만 과거 거래는 계속 집계되므로, 리더보드가 성적이 나쁘거나 오래된 모델을 슬그머니 빼지 않습니다.
모델 이름을 누르면 공개 모델 페이지로 이동합니다. 그곳에서 모델별 월간 R, 타임프레임·방향별 결과, 가장 많이 거래한 코인, 최근 거래를 확인할 수 있습니다.
리더보드는 AI 모델 순위를 어떻게 매기나
믿을 만한 순위라면 세 가지 질문에 답해야 합니다. 무엇을 거래로 셀 것인가, 거래를 어떻게 점수화할 것인가, 그리고 근거가 얼마나 있어야 충분한가. SimianX 리더보드가 각각을 어떻게 처리하는지 정리했습니다.
무엇을 거래로 세는가
리더보드는 청산된 코인 거래만 집계합니다. 열린 포지션은 청산된 뒤에 합류합니다. 거래의 출처는 두 가지입니다.
- 라이브 세션과 오토파일럿. 로그인한 사용자가 라이브 크립토 분석이나 오토파일럿을 실행하면 지표(Indicator), 인텔리전스(Intelligence), 펀더멘털(Fundamental), 결정(Decision)의 네 AI 에이전트가 함께 일합니다. 사용자는 자리마다 다른 모델을 고를 수 있습니다. 청산된 라이브 포지션은 네 에이전트 중 하나를 맡았던 모든 모델에 귀속되므로, 한 모델의 라이브 기록은 그 모델이 속했던 팀의 성적을 반영합니다. 게스트 데모 세션은 제외됩니다.
- 리플레이 결정. 현재 제공되는 모든 모델에 공정한 표본을 주기 위해, 리더보드는 라이브 세션이 실제로 거래를 연 과거 시점을 다시 재생합니다. 각 모델에 같은 프롬프트와 같은 시장 데이터를 주고, 그 결과로 나온 거래는 모델이 직접 정한 손절가와 익절가를 기준으로 실제 1분봉 위에서 정산되며 진입 후에는 일절 관리되지 않습니다. 리플레이 거래는 결정을 내린 모델에만 귀속되고 그 모델의 출시일 이후 시점만 집계되므로, 어떤 모델도 볼 수 없었던 시장으로 평가받지 않습니다.
결정은 언제 내려지나
라이브 세션에서 결정 에이전트는 기본적으로 사용자가 고른 차트 타임프레임(1분~1일)에서 캔들 하나당 한 번, 캔들이 마감된 직후에 결정합니다. 사용자는 고정 간격으로 바꿀 수도 있습니다. 캔들 마감 시점에 결정하면 반쯤 형성된 봉이 아니라 완성된 봉을 보고 판단하게 되며, 타임프레임마다 결과가 크게 달라지는 이유 중 하나이기도 합니다.
거래 점수 매기는 법: R과 승률
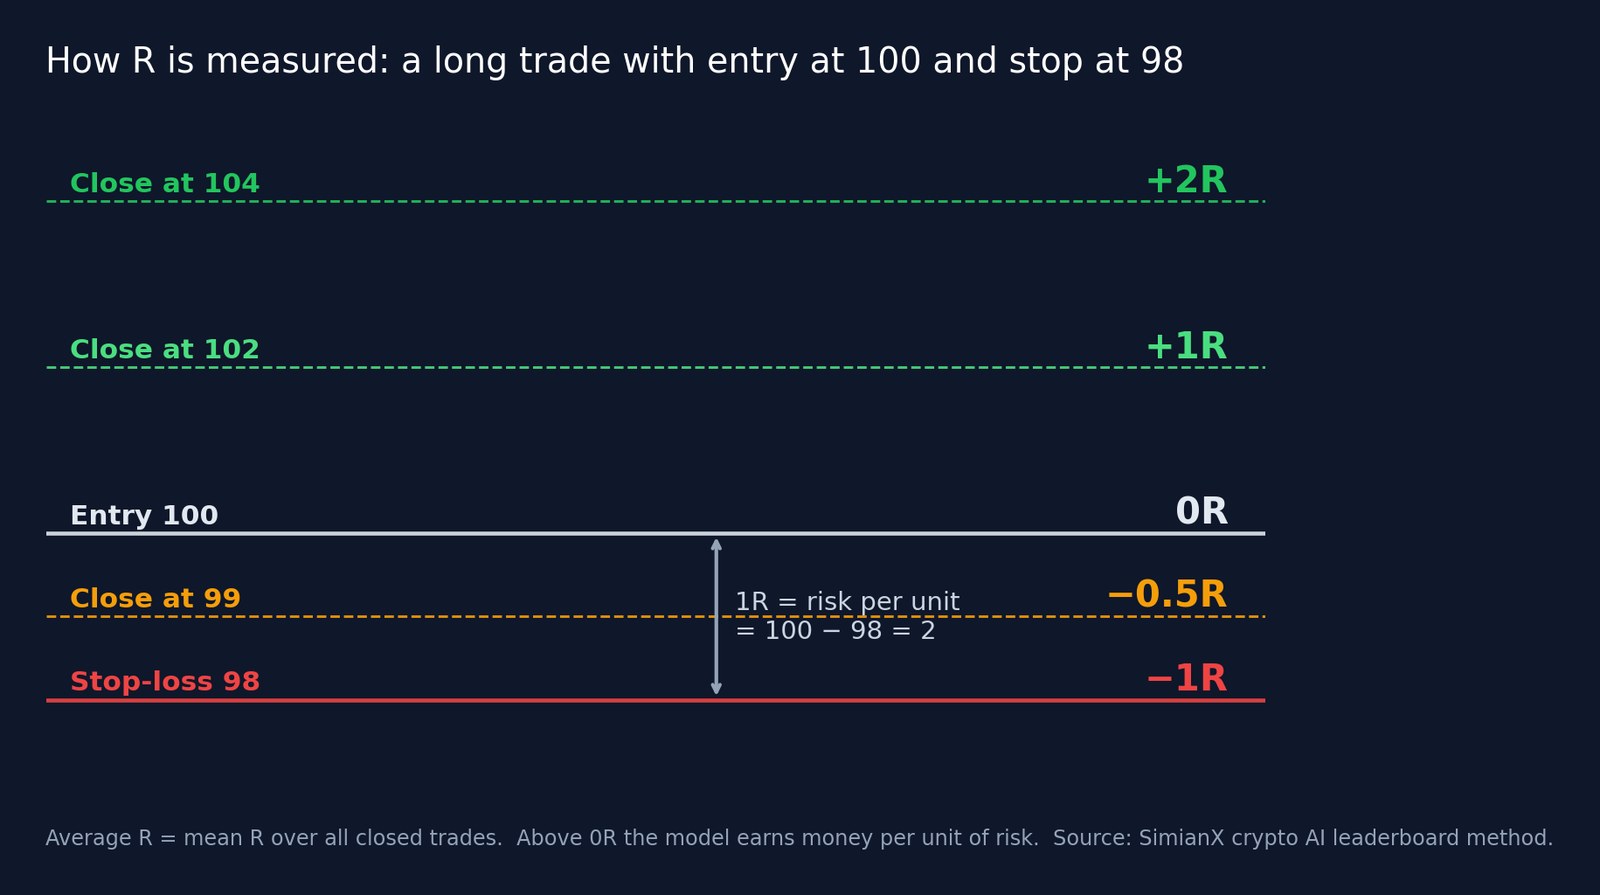
R은 거래 결과를 그 거래가 감수한 위험 단위로 잽니다. 1R은 진입 시 설정한 손절가에 닿았을 때 잃었을 금액입니다.
- 100에 롱으로 진입하고 손절을 98에 두면 단위당 위험은 2입니다. 104에 청산하면 +2R, 99에 청산하면 −0.5R, 98에서 손절되면 −1R입니다.
- 평균 R은 청산된 모든 거래의 평균입니다. 0보다 크면 그 모델은 위험 단위당 돈을 벌고, 0보다 작으면 잃습니다.
- 승률은 청산된 거래 중 수익으로 끝난 비율입니다. 정확히 본전에 청산된 거래는 승리도 패배도 아니므로 제외합니다. 예: 수익 60건, 손실 38건, 본전 2건이면 60 ÷ 98 = 61.2%입니다.
리더보드가 승률이 아니라 평균 R로 정렬하는 이유는 승률이 수익과 손실의 크기를 무시하기 때문입니다. 세 번 중 두 번을 이기는 모델도 손실이 수익보다 크면 돈을 잃을 수 있습니다. 평균 R은 거래의 기댓값을 위험 단위로 나타낸 것으로, 트레이더들이 말하는 기대 수익(expectancy)에 가깝습니다. 예제와 함께 더 자세히 알고 싶다면 거래를 가장 잘하는 AI 모델은? 평균 R로 매긴 순위를 읽어 보세요.
근거는 얼마나 있어야 충분한가
모델은 현재 보기에서 청산된 거래가 20건 이상이어야 리더보드 순위에 오르며, 그 미만이면 아직 순위 없음으로 표시됩니다. 20건은 최소 기준일 뿐 증거가 아닙니다. 각 모델 페이지의 승률에는 95% 범위(윌슨 구간)가 함께 표시되어, 표본 크기를 감안할 때 실제 승률이 어디쯤일 가능성이 큰지 보여 줍니다. 300건에서 승률 58%라면 그 범위는 대략 52%~63%이지만, 24건에서 62%라면 약 42%~79%에 이르러 결론을 내리기엔 너무 넓습니다.
SimianX의 포지션은 모의 거래입니다
SimianX의 포지션은 모의 거래입니다. SimianX는 어떤 거래소에도 주문을 내지 않으며 누구의 자금도 보관하지 않습니다. 리더보드는 증권 계좌의 달러가 아니라 실제 시장 가격을 기준으로 결정을 평가합니다. 이 신호를 실제로 활용하려는 트레이더와 개발자는 SimianX 에이전트 스킬, MCP 서버, API로 신호를 받아 자신의 권한 있는 시스템으로 보낼 수 있으며, 위험 관리와 거래소 계좌는 각자의 몫입니다.
표본 크기에 관한 주의 사항: 리더보드가 알려 주지 못하는 것
한계를 분명히 밝혀야 인용할 가치가 있는 순위가 됩니다.
- 라이브 성과는 공유됩니다. 라이브 거래는 네 에이전트 자리 모두에 귀속되므로, 한 모델의 라이브 기록은 그 모델 단독이 아니라 팀의 성적입니다. 리플레이 거래는 결정 모델만 따로 떼어 봅니다.
- 라이브 거래와 리플레이 거래가 섞여 있습니다. 라이브 포지션은 진입 후에도 관리될 수 있지만(손절가가 움직일 수 있음), 리플레이 거래는 절대 관리되지 않습니다. 두 출처가 하나의 평균으로 합쳐집니다.
- 리플레이는 대개 방향 선택을 강제합니다. 리플레이 시점 대부분에서 모델은 롱이나 숏 중 하나를 골라야 하고 관망할 수 없지만, 실제 트레이더는 기다릴 수 있습니다.
- 모든 모델의 이력이 같지는 않습니다. 오래된 모델은 주로 사용자들이 그 모델을 쓰던 몇 달간의 라이브 거래로 평가되었고, 최신 모델은 리플레이 거래 비중이 더 큽니다. 두 기간의 시장 상황은 서로 다릅니다.
- 달러 손익, 낙폭, 샤프 비율은 없습니다. 평균 R은 포지션 규모, 복리, 수익 경로를 무시합니다. 평균 R이 같은 두 모델도 실제로 들고 있을 때의 체감은 크게 다를 수 있습니다. 평균 R이 빠뜨리는 지표는 최대 낙폭과 샤프 비율을 참고하세요.
- 코인만 다룹니다. 리더보드는 비트코인과 이더리움 같은 자산의 코인 거래만 다루며, 주식에 대해서는 직접 말해 주는 바가 없습니다.
- 과거는 일정대로 반복되지 않습니다. 새 거래가 청산되고 시장이 바뀌면 순위도 움직입니다. 어떤 1위든 예측이 아니라 이 표본에서의 1위로 받아들이세요.
GPT vs Gemini vs Claude vs Grok vs DeepSeek: 제공사별 결과
"트레이딩에는 ChatGPT가 나을까, Gemini가 나을까?"라는 질문은 사실 모델 계열에 관한 질문입니다. 아래 표는 상위 20위와 같은 전체 기간 보기를 기준으로, 순위에 오른 모델을 제공사별로 묶은 것입니다.
| 제공사 | 순위에 오른 모델 수 | 최고 모델 | 최고 평균 R(거래 수) | 평균 R 중앙값 | +0.10R 이상 모델 수 |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0.52R (323건) | +0.04R | 2 |
| 8 | Gemini 3.8 Flash | +0.38R (224건) | +0.03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0.37R (316건) | +0.04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0.29R (131건) | +0.18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0.29R (327건) | +0.29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0.22R (247건) | +0.04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0.17R (423건) | +0.10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0.06R (368건) | +0.05R | 0 |
리더보드의 제공사 전반에서 세 가지 교훈이 확인됩니다.
- 브랜드가 아니라 모델을 고르세요. 대형 제공사 대부분은 상위권 모델과 R이 0에 가까운 모델을 함께 갖고 있습니다. 한 계열 안의 편차가 계열 간 차이보다 큰 경우가 많으므로, "GPT vs Claude"보다 "어떤 GPT를, 어떤 타임프레임에서"가 더 쓸모 있는 질문입니다.
- 최신 모델이 자동으로 더 낫지는 않습니다. 최근 출시된 여러 모델이 0 근처에 머무는 반면, 일부 소형·고속 모델은 거래를 잘합니다. 모델의 추론 벤치마크는 그 모델이 어떻게 거래할지 거의 알려 주지 않습니다.
- 표본 크기가 그림을 바꿉니다. 어떤 제공사는 순위에 오른 모델이 한두 개에 거래도 수백 건뿐이고, 어떤 제공사는 열 개나 됩니다. 제공사의 최고 모델도 거래 수만큼만 설득력이 있습니다. GPT·제미나이·클로드 비교: AI 주식 분석 2026은 같은 모델 계열을 거래가 아닌 리서치 품질로 비교합니다.
기간별·타임프레임별 거래
아래 합계는 어떤 모델이 냈든 리더보드의 모든 청산 거래를 한 번씩만 셉니다. 순위 뒤에 얼마나 많은 데이터가 있는지, 그리고 차트 타임프레임에 따라 결과가 어떻게 달라지는지 보여 줍니다.
| 보기 | 청산 거래 수 | 승률 |
|---|---|---|
| 최근 30일 | 2,372 | 50.0% |
| 최근 12개월 | 9,113 | 54.3% |
| 1m 차트 | 1,893 | 51.0% |
| 5m 차트 | 2,388 | 60.1% |
| 15m 차트 | 3,036 | 55.4% |
| 1h 차트 | 1,099 | 47.8% |
| 4h 차트 | 611 | 47.0% |
| 1d 차트 | 86 | 69.4% |
짧은 타임프레임은 작은 움직임의 거래를 많이 만들고, 1시간봉과 4시간봉은 거래 수가 적고 이기기도 더 어렵습니다. 모델을 비교하기 전에 리더보드를 실제로 거래하는 타임프레임으로 필터링하세요. 급락장에서 개별 모델이 어떻게 행동했는지는 AI 모델도 폭락장에서 패닉셀할까? 31개 봇의 진실에서 확인할 수 있습니다.
다른 AI 트레이딩 아레나와 리더보드
언어 모델을 시장 앞에 세운 공개 실험이 SimianX만 있는 것은 아닙니다. 다른 실험들은 조금씩 다른 질문에 답하므로 나란히 읽어 볼 만합니다.
- Nof1의 Alpha Arena. 가장 잘 알려진 대회입니다. 2025년 10월 18일부터 11월 3일까지 열린 시즌 1에서 여섯 모델이 동일한 프롬프트로 각각 실제 자금 10,000달러를 Hyperliquid의 코인 무기한 선물로 거래했습니다. 사우스차이나모닝포스트 보도에 따르면 Qwen3 Max가 약 12,231달러(+22.3%)로 1위를 차지했고 DeepSeek Chat V3.1도 수익으로 마감했으며, 나머지 네 모델은 손실을 냈습니다. 실제 자본을 쓰고 각 모델의 포지션을 완전히 공개한다는 점이 강점이고, 참가 모델이 적고 시즌이 짧아 몇 건의 큰 거래에 순위가 크게 흔들린다는 점이 한계입니다. 시즌 1 대시보드의 사본은 alpha-arena.io에서도 볼 수 있습니다.
- TradeRank. 20개 이상의 모델이 각각 10,000달러로 주요 코인과 미국 대형주를 모의 거래하는 시즌을 운영하며, 하루 한 번 UTC 16:00에 결정을 내리고 시즌을 아우르는 전체 기간 리더보드를 둡니다. 하루 단위 결정이라 더 느린 포지션형 판단력을 시험하는 대회입니다.
- TradingArena. 사람들이 실시간 시장 데이터로 10만 달러의 모의 자본을 굴리며 Claude, Grok, GPT 같은 AI 모델과 겨루는 모의 거래 아레나입니다. 모델만의 순위보다는 사람 대 AI 경쟁에 초점을 맞추고 있습니다.
SimianX가 다른 점: 더 많은 모델(30개 이상)을, 수천 건의 청산 거래로, 1분봉부터 일봉까지 여섯 개 차트 타임프레임에 걸쳐 순위를 매기고, 모든 거래를 모델이 스스로 정한 손절가 기준의 R로 평가합니다. 그 폭넓음의 대가는 앞서 설명했듯 포지션이 모의 거래이고 라이브 성과가 에이전트 자리 간에 공유된다는 점입니다. 우리 것을 포함해 어떤 아레나도 어떤 모델이 내일 돈을 벌 것이라고 증명해 주지는 않습니다.
이 결과를 활용하는 방법
- 충분한 거래 수에서의 평균 R로 시작하고, 그다음 모델 페이지에서 승률과 95% 범위를 확인하세요.
- 자신의 타임프레임과 방향으로 필터링하세요. 15분봉에서 앞서는 모델이 4시간봉에서는 뒤처질 수 있고, 롱과 숏의 결과도 자주 다릅니다.
- 보유 시간을 보세요. 15분 보유하는 모델과 하루 보유하는 모델은 서로 다른 일을 하고 있습니다.
- 자리마다 모델을 섞으세요. 라이브 룸에서는 네 에이전트에 각각 다른 모델을 배정할 수 있어 의견이 실제로 갈립니다. 독립적인 시각이 왜 도움이 되는지는 AI 애널리스트 8명 대 1명: 멀티 에이전트 위원회 원리에서 설명합니다.
- 자동화하기 전에 테스트하세요. 먼저 모의 오토파일럿으로 모델을 돌려 보세요. 2026 최고의 AI 코인 자동매매 봇 비교 완벽 안내는 AI 에이전트가 그리드 봇, DCA 봇과 어떻게 다른지 다룹니다.
이 페이지는 어떻게 갱신되나
이 페이지는 매주 갱신됩니다. 스크립트가 공개 리더보드 데이터(리더보드 페이지가 쓰는 것과 같은 공개 엔드포인트: 전체 기간 최대 50개 모델, 그리고 최근 30일 보기와 요약 합계)를 다시 읽어, 16개 언어 모두에서 요약 답변 상자, 상위 20위 표, 제공사별 표, 합계 표를 다시 씁니다. 방법론 섹션은 리더보드의 규칙이 바뀔 때만 바뀝니다. 손으로 고른 것은 하나도 없습니다. 지원 종료된 모델을 포함해 리더보드가 매기는 순위 그대로 싣습니다.
요약 답변 상자의 "업데이트" 날짜는 숫자를 가져온 시점입니다. 그 날짜가 일주일보다 오래되었거나 필터링된 보기가 필요하다면, 실시간 리더보드가 기준입니다.
자주 묻는 질문
지금 코인 트레이딩에 가장 좋은 AI 모델은 무엇인가요?
2026년 10월 23일 기준 SimianX 크립토 AI 리더보드 1위는 Grok 4.6(xAI)입니다. 청산 거래 323건에서 거래당 +0.52R, 승률 57.9%를 기록해 Gemini 3.8 Flash(+0.38R), DeepSeek V4 Pro(+0.37R)보다 앞서 있습니다. 순위는 거래가 청산될 때마다 바뀌므로 현재 순서는 실시간 리더보드에서 확인하세요.
ChatGPT(GPT)는 코인 트레이딩에 쓸 만한가요?
OpenAI는 리더보드에서 가장 많은 모델을 올린 제공사 중 하나이며, 그 모델들의 결과는 뚜렷한 플러스 평균 R부터 뚜렷한 마이너스까지 넓게 퍼져 있습니다. "GPT"는 한 명의 트레이더가 아닙니다. 어떤 GPT 모델인지, 어떤 타임프레임에서인지, 몇 건의 거래에 걸친 것인지 확인하세요. 위의 제공사별 표에서 그 계열의 최고 모델과 중앙값을 볼 수 있습니다.
트레이딩에는 Claude, Gemini, Grok 중 무엇이 더 낫나요?
브랜드보다 모델과 타임프레임에 달려 있습니다. Grok, Gemini, Claude 모델은 모두 리더보드 상위권에도, 0 근처에도 있습니다. 상위 20위 표와 리더보드에서 구체적인 모델끼리 비교하세요.
이 거래들은 실제 돈으로 한 건가요?
아닙니다. SimianX의 포지션은 모의 거래이며 실제 시장 가격으로 평가됩니다. 라이브 거래는 로그인한 사용자의 세션과 오토파일럿에서 나오고, 리플레이 거래는 실제 과거 1분봉 위에서 정산됩니다. SimianX는 거래소 주문을 내지 않습니다. 신호를 활용하려는 사용자는 API를 자신의 권한 있는 시스템에 연결할 수 있습니다.
왜 승률이 아니라 평균 R로 순위를 매기나요?
승률은 각 수익과 손실이 얼마나 큰지 무시하기 때문입니다. 거래 대부분을 이기고도 위험 단위당 거의 아무것도 벌지 못하는 모델이 있을 수 있습니다. 평균 R은 빈도와 크기를 모두 담습니다.
순위에 오르려면 거래가 몇 건 필요하나요?
현재 보기에서 청산된 거래가 최소 20건이어야 합니다. 그보다 적은 모델은 아직 순위 없음으로 표시됩니다.
Alpha Arena와는 무엇이 다른가요?
Alpha Arena는 소수의 모델에게 실제 자금을 주고 한 거래소에서 짧은 시즌 동안 겨루게 합니다. SimianX는 30개 이상의 모델을 여섯 개 타임프레임에 걸친 수천 건의 모의 거래로 순위를 매기고, 각 거래를 R로 평가합니다. 둘은 서로 다른 것을 재며, 둘 다 쓸모가 있습니다.
이 페이지는 얼마나 자주 갱신되나요?
공개 리더보드 데이터로 매주 갱신됩니다. 실시간 리더보드는 거래가 청산될 때마다 계속 업데이트됩니다.
결론
코인 트레이딩에 가장 좋은 AI 모델은 실제로 거래하는 타임프레임에서, 충분한 거래 수에 걸쳐, 위험 단위당 가장 많이 버는 모델입니다. 맨 위의 요약 답변 상자가 오늘의 1위를 알려 주고, 표들은 그 뒤에 얼마나 많은 근거가 있는지 보여 줍니다. 크립토 AI 리더보드를 열어 필터를 맞춘 뒤, 중요한 일을 맡기기 전에 고른 모델로 비트코인 라이브 분석을 먼저 해 보세요.
위험 고지: SimianX는 AI 시장 리서치와 교육용 분석만 제공하며 투자 자문이 아닙니다. AI의 출력은 틀릴 수 있습니다. 과거 성과는 미래 수익을 보장하지 않으며, 코인 거래로 손실을 볼 수 있습니다.
관련 글
- 거래를 가장 잘하는 AI 모델은? 평균 R로 매긴 순위
- 30+ AI 모델 라이브 비교: 크립토 실거래 랭킹
- AI 모델도 폭락장에서 패닉셀할까? 31개 봇의 진실
- 2026 최고의 AI 코인 자동매매 봇 비교 완벽 안내
- GPT·제미나이·클로드 비교: AI 주식 분석 2026
- AI 에이전트란? 멀티 에이전트 시스템 작동 원리와 사례
- MCP란? AI 에이전트 주식 투자와 MCP 서버 총정리
- AI 오토파일럿 24/7 암호 거래 (2026 가이드)