AI 에이전트 완전 해설: 루프 속 단일 모델에서 전문가 팀까지
AI 에이전트란 AI 모델을 사용해 스스로 목표를 추구하는 소프트웨어 시스템입니다. 상황을 읽고, 다음 단계를 정하고, 웹 검색·코드·API 같은 도구로 행동한 뒤, 결과를 확인하고 나서야 다음으로 넘어갑니다. 멀티 에이전트 시스템은 이 일을 여러 전문 에이전트에게 나눠 맡깁니다. 에이전트들은 찾아낸 내용을 공유하고, 의견이 갈리는 지점에서는 서로 반박하며, 종합한 답을 최종 판단을 내리는 한 에이전트에게 넘깁니다.
이 두 문장짜리 정의는 2026년 현재 이 용어가 뜻하는 대부분을 아우릅니다. 저장소 전체를 오가며 버그를 고치는 코딩 도우미부터, 보고서를 쓰기 전에 수백 쪽을 읽어 내는 리서치 도구까지 말입니다. 하지만 어려운 부분은 이 정의 뒤에 가려져 있습니다. 에이전트는 채팅 답변보다 비용이 더 들고, 시간이 더 걸리며, 긴 작업 초반의 작은 오류 하나가 결과 전체를 조용히 망칠 수 있습니다.
SimianX는 매일 멀티 에이전트 시스템을 만들고 운영합니다. 실시간 분석실에서는 네 에이전트가 주식이나 암호화폐 페어를 실시간으로 분석하고, 딥 리서치에서는 여덟 에이전트로 구성된 위원회가 한 종목이나 한 코인을 두고 토론하며, 공개 암호화폐 리더보드는 30개가 넘는 AI 모델을 각 모델이 청산한 모든 거래로 평가합니다. 이 가이드는 그 시스템을 실제 사례로 삼고, 이 분야를 규정하는 에이전트 제품과 연구도 중립적으로 함께 소개합니다.
핵심 요약
- 에이전트는 모델에 도구, 메모리, 그리고 모델이 직접 제어하는 루프를 더한 것입니다. 모든 단계가 코드로 고정돼 있다면 그것은 에이전트가 아니라 워크플로입니다.
- 멀티 에이전트 시스템은 작업이 서로 독립적인 부분으로 나뉠 때, 또는 서로 의견을 맞춰 보기 전에 각자 형성돼야 할 관점이 필요할 때 도움이 됩니다. 대신 토큰이 훨씬 많이 듭니다.
- 에이전트 실패의 대부분은 모델이 "충분히 똑똑하지 않아서"가 아니라 누적 오류, 믿을 수 없는 도구, 허술한 평가, 통제되지 않는 비용에서 비롯됩니다.
- 에이전트는 여러분 자신의 작업에서 반복해 얻은 결과로 판단하세요. 성공률, 실행 간 일관성, 완료된 작업당 비용, 그리고 무엇을 했는지 보여 주는 전체 기록이 기준입니다.
AI 에이전트란 무엇인가? 실무적 정의
이 개념은 대규모 언어 모델보다 오래됐습니다. 표준 AI 교과서인 스튜어트 러셀과 피터 노빅의 인공지능: 현대적 접근(Artificial Intelligence: A Modern Approach)은 에이전트를 센서로 환경을 지각하고 액추에이터로 그 환경에 작용하는 모든 것이라고 정의합니다. 온도 조절기도 여기에 해당하고, 체스 프로그램도 마찬가지입니다.
2022년 이후 달라진 점은 이제 언어 모델이 추론의 핵심을 맡을 수 있다는 것입니다. 사람이 손으로 쓴 규칙을 따르는 대신, 모델이 상황을 평이한 언어로 읽고, 계획을 세우고, 다음에 호출할 도구를 고릅니다. 널리 인용되는 Anthropic의 가이드 Building Effective Agents(효과적인 에이전트 만들기)는 오늘날 대부분의 엔지니어가 쓰는 구분선을 제시합니다. 워크플로는 모델과 도구가 미리 정해진 코드 경로를 따라 조율되는 시스템이고, 에이전트는 모델이 자신의 처리 과정과 도구 사용을 동적으로 지휘하는 시스템입니다.
실제로 현대의 AI 에이전트는 다섯 가지 요소로 이뤄집니다.
- 목표. "실패하는 이 테스트를 고쳐라", "오늘 Nvidia 주가를 움직인 요인을 요약하라", "이 15분봉에서 포지션을 열지 결정하라".
- 목표와 현재 상태를 추론하는 모델.
- 호출할 수 있는 도구: 검색, 코드 인터프리터, 데이터베이스 조회, 시장 데이터 API, 브라우저.
- 메모리 또는 상태: 이미 시도한 것, 도구가 돌려준 것, 아직 모르는 것.
- 종료 규칙이 있는 루프: 목표를 달성하거나, 예산이 바닥나거나, 다음 단계에 사람의 승인이 필요해질 때까지 계속합니다.
루프를 빼면 챗봇이 됩니다. 모든 단계를 미리 고정하면 워크플로가 됩니다. 모델 스스로 제어하는 루프가 있어야 비로소 에이전트입니다.
AI 에이전트 vs 챗봇 vs 워크플로
세 용어는 늘 뒤섞입니다. "에이전트"라는 말이 잘 팔리기 때문이기도 합니다. Gartner는 챗봇과 로보틱 프로세스 자동화(RPA)에 에이전트라는 이름만 새로 붙이는 행태를 "에이전트 워싱(agent washing)"이라고 부르며, 2025년 6월 추정에 따르면 에이전틱 AI를 판매하는 수천 개 업체 가운데 진짜를 제공하는 곳은 약 130곳에 불과합니다. 아래 표가 셋을 가장 빨리 구분하는 방법입니다.
| 챗봇 | 워크플로(파이프라인) | AI 에이전트 | |
|---|---|---|---|
| 다음 단계를 누가 정하나 | 사용자가 메시지 하나씩 | 개발자가 미리 작성한 코드로 | 실행 중에 모델이 |
| 도구 사용 | 가끔, 답변 한 번에 호출 한 번 | 사용함, 정해진 순서대로 | 사용함, 필요에 따라 골라서 반복 |
| 새 프롬프트 없이 계속 작업 | 아니요 | 예, 고정된 경로를 따라 | 예, 목표나 예산 한도에 도달할 때까지 |
| 전형적인 결과물 | 답변 | 알려진 절차에서 나오는 예측 가능한 결과 | 완료된 작업: 코드 변경, 보고서, 결정 |
| 비용과 속도 | 저렴함, 몇 초 | 저렴~보통, 예측 가능 | 더 높고 들쭉날쭉함, 몇 초~몇 시간 |
| 전형적인 실패 | 눈에 보이는 틀린 답 | 아무도 예상하지 못한 입력에서 멈춤 | 방향을 잃거나, 같은 일을 맴돌거나, 초반의 작은 오류 위에 쌓아 올림 |
| 적합한 용도 | 질문과 초안 작성 | 단계가 정해진 반복 업무 | 경로를 미리 짤 수 없는 열린 과제 |
같은 Anthropic 가이드에는 유용한 원칙이 하나 있습니다. 효과가 있는 가장 단순한 방법에서 시작하고, 결과가 분명히 나아질 때만 자율성을 더하라는 것입니다. 에이전트로 홍보되는 작업 중 상당수는 워크플로로 만드는 편이 더 낫고, 더 싸고, 더 안전합니다.
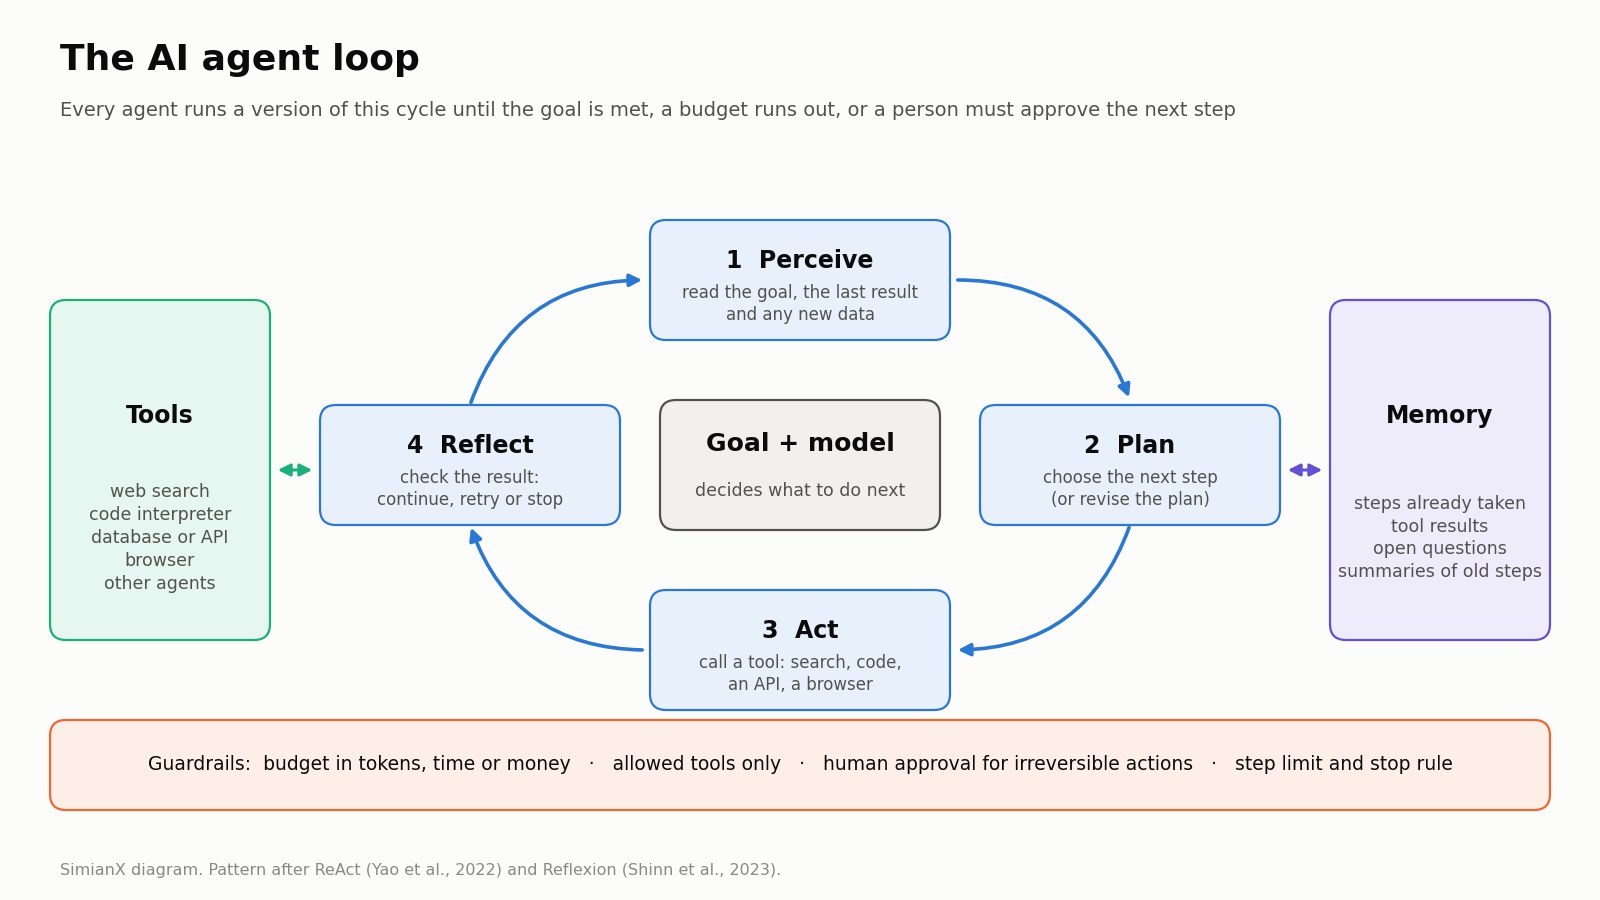
AI 에이전트의 작동 방식: 지각, 계획, 행동, 성찰 루프
어떤 이름을 달았든, 모든 에이전트는 하나의 루프를 어떤 형태로든 돌립니다.
지각
에이전트는 현재 상황을 수집합니다. 사용자의 목표, 직전 행동의 결과, 파일 내용, 검색 결과 한 페이지, 차트의 최신 캔들 같은 것들입니다. 에이전트가 아는 모든 것은 모델의 컨텍스트 창 안에 들어가야 하므로, 좋은 에이전트는 가려 담습니다. 지난 단계는 요약하고, 다시 쓸 원본 데이터는 남기고, 나머지는 버립니다.
계획
모델이 다음에 할 일을 정합니다. 처음부터 전체 계획을 쓰기도 하지만, 그보다는 직전 결과를 본 뒤 바로 다음 한 단계를 고르는 경우가 더 많습니다. 큰 영향을 끼친 ReAct 논문(Yao 외, 2022)은 짧은 추론 메모와 행동을 번갈아 수행하면 모델이 정보를 모으면서 방향을 바로잡을 수 있음을 보였고, 여러 과제에서 행동만 하는 방식과 추론만 하는 방식을 모두 앞섰습니다. 대부분의 에이전트 프레임워크는 지금도 이 패턴을 따릅니다.
행동
에이전트가 도구를 호출합니다. 최신 모델은 "X를 검색하라"나 "이 매개변수로 이 쿼리를 실행하라" 같은 구조화된 요청을 내보내고, 이를 둘러싼 소프트웨어가 그 요청을 실행한 뒤 결과를 돌려줍니다. 이런 배관 작업에는 이제 표준이 있습니다. Anthropic이 2024년 11월에 공개하고 2025년 12월 리눅스 재단 산하 Agentic AI Foundation에 기증한 Model Context Protocol(MCP)은 에이전트가 도구와 데이터 소스에 연결하는 방식을 정의합니다. Google의 Agent2Agent 프로토콜(A2A) 역시 지금은 리눅스 재단 프로젝트이며, 서로 다른 업체가 만든 에이전트끼리 소통하는 방식을 다룹니다.
성찰
에이전트는 결과를 목표에 비춰 점검합니다. 테스트를 통과했는가? 숫자가 두 번째 출처와 일치하는가? 계획이 여전히 타당한가? Reflexion(Shinn 외, 2023) 같은 연구는 에이전트가 무엇이 잘못됐는지 적어 두고 다시 시도하게 하면 코딩과 추론 과제의 결과가 좋아진다는 것을 보여 주었습니다. 성찰은 에이전트가 멈출 때를 정하는 단계이기도 합니다. 목표를 이뤘거나, 막혔거나, 위험한 일을 사람이 승인해야 할 때입니다.
루프 주변에는 안전장치가 있습니다. 토큰·시간·돈으로 정한 예산, 에이전트가 쓸 수 있는 도구 목록, 그리고 사람이 반드시 승인해야 하는 지점입니다. 트레이딩에서는 최소한 포지션 규모 한도, 모든 거래에 거는 손절가, 그리고 모의 거래와 실제 돈 사이의 명확한 경계를 뜻합니다.
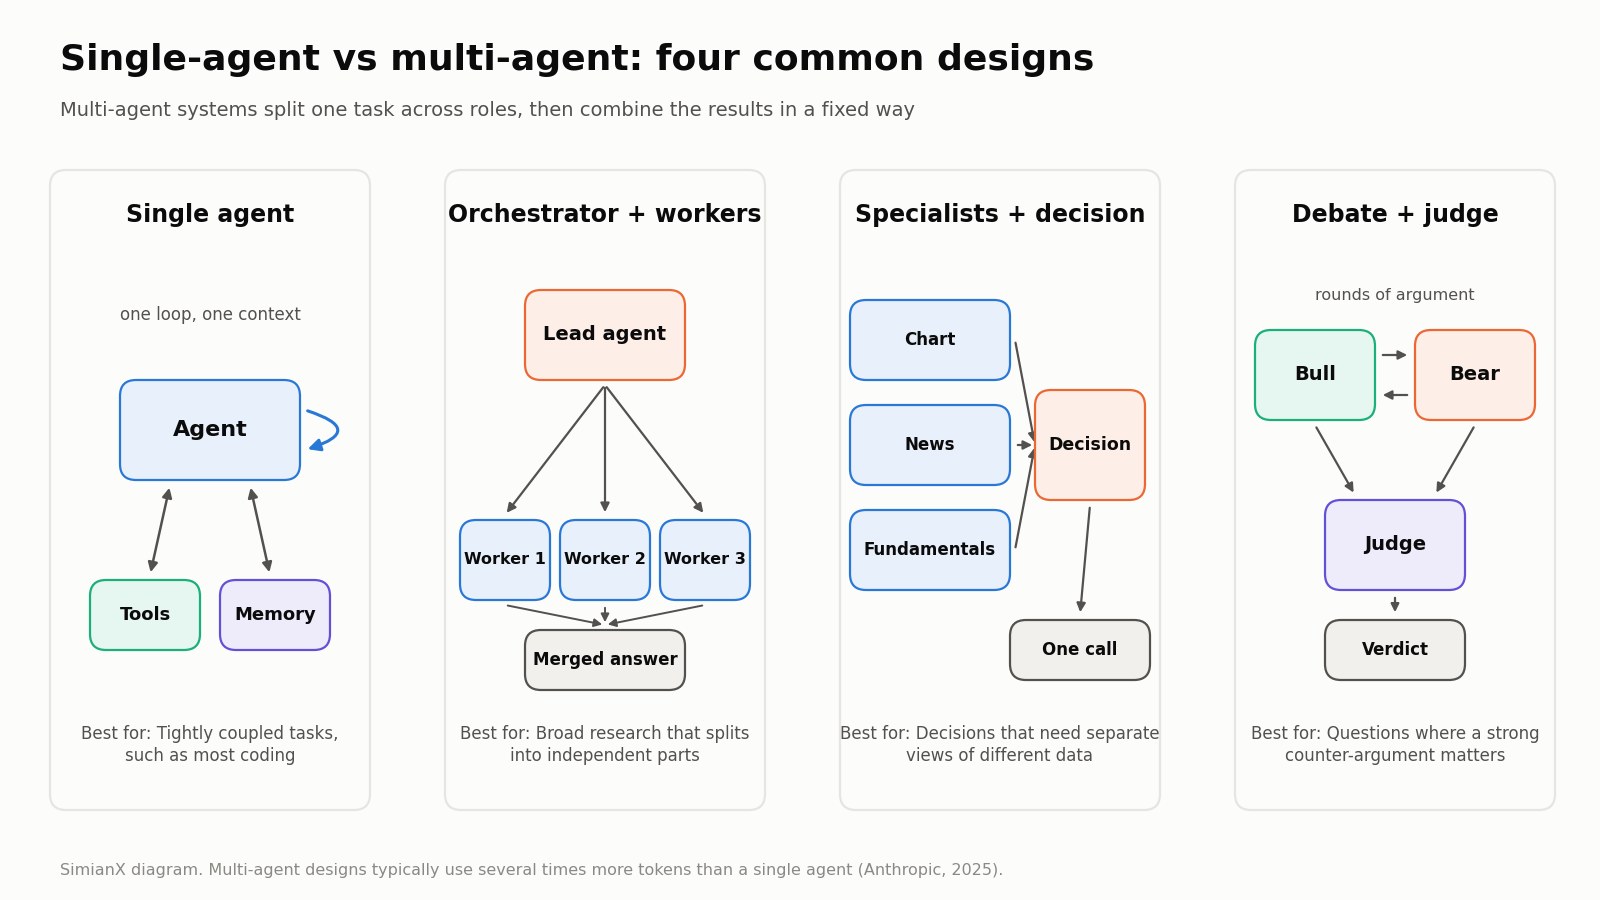
단일 에이전트 vs 멀티 에이전트 시스템
단일 에이전트는 루프를 혼자 돌립니다. 멀티 에이전트 시스템은 일의 각 부분을 서로 다른 에이전트에게 맡기고, 에이전트마다 고유한 지시, 도구, 컨텍스트를 준 다음, 그 결과물을 합칩니다. 흔히 쓰는 설계는 네 가지입니다.
- 오케스트레이터와 작업자. 리드 에이전트가 작업을 여러 부분으로 쪼개 각각을 작업자 에이전트에게 보내고, 결과를 합칩니다. 리서치 도우미가 흔히 이런 방식으로 일합니다.
- 결정권자에게 견해를 보내는 전문가들. 각 에이전트가 차트, 뉴스, 재무처럼 한 영역을 맡고, 마지막 에이전트가 그 견해들을 저울질합니다. 아래에서 설명할 SimianX 실시간 분석실의 구조가 바로 이것입니다.
- 토론. 에이전트들이 반대 입장에서 논쟁한 뒤 심판이 결정합니다. Du 외(2023)는 여러 모델 인스턴스가 몇 차례에 걸쳐 토론하면, 단일 모델이 혼자 답할 때보다 사실 정확도와 추론이 향상된다는 것을 발견했습니다.
- 투표 또는 앙상블. 여러 에이전트 또는 여러 모델이 같은 질문에 독립적으로 답하고, 그 답을 집계합니다.
멀티 에이전트 시스템을 뒷받침하는 근거는 실재하지만 조건부입니다. Anthropic은 2025년 6월, 자사의 멀티 에이전트 리서치 시스템에서 Claude Sonnet 4 하위 에이전트들을 지휘하는 Claude Opus 4 리드 에이전트가 내부 리서치 평가에서 단일 Claude Opus 4 에이전트보다 90.2% 더 좋은 성과를 냈다고 보고했습니다. 같은 글은 그 대가에 대해서도 솔직합니다. 에이전트는 채팅보다 약 4배, 멀티 에이전트 시스템은 약 15배 많은 토큰을 썼습니다. 또한 대부분의 코딩 작업은 리서치보다 진정으로 병렬 처리할 수 있는 부분이 적어서 덜 적합하다고 지적합니다.
| 단일 에이전트 | 멀티 에이전트 시스템 | |
|---|---|---|
| 구축과 디버깅 | 더 단순함: 프롬프트 하나, 실행 기록 하나 | 더 어려움: 여러 프롬프트, 인계 과정, 합쳐진 실행 기록 |
| 작업당 비용 | 더 낮음 | 흔히 몇 배 더 높음 |
| 속도 | 순차 처리 | 병렬 부분은 더 빨리 끝나지만 조율에 부담이 생김 |
| 폭 | 컨텍스트 창 하나로 제한됨 | 에이전트마다 자기 몫을 위한 새 컨텍스트를 받음 |
| 오류 점검 | 자기 실수를 스스로 잡아야 함 | 에이전트끼리 반박할 수 있고 의견 차이가 드러남 |
| 전형적인 실패 | 잘못된 첫 아이디어에 갇히는 시야 협착 | 소통 오류, 중복 작업, 허술한 최종 통합 |
| 적합한 용도 | 대부분의 코딩처럼 긴밀하게 얽힌 작업 | 폭넓은 리서치, 그리고 독립적인 관점이 필요한 결정 |
SimianX의 경험칙은 이렇습니다. 누군가 의견을 맞춰 보기 전에 각자 독립적으로 형성돼야 할 견해가 필요하다면 에이전트를 둘 이상 쓰세요. 차트 해석이 뉴스 에이전트가 방금 읽은 헤드라인에 물들어서는 안 되고, 약세 논거는 문제점을 찾는 것만이 유일한 임무인 에이전트가 써야 합니다.
AI 에이전트가 실패하는 지점
에이전트는 예측 가능한 방식으로 실패하며, 정직한 가이드라면 여기에 시간을 들여야 합니다. 2025년 연구 Why Do Multi-Agent LLM Systems Fail?(멀티 에이전트 LLM 시스템은 왜 실패하는가?)(Cemri 외)은 널리 쓰이는 멀티 에이전트 프레임워크 7개에서 나온 실행 기록 1,600건 이상에 주석을 달아, 세 그룹으로 나뉘는 14가지 실패 유형을 찾아냈습니다. 시스템 설계상의 문제, 에이전트 간 불일치, 그리고 최종 결과에 대한 허술한 검증입니다.
누적 오류
긴 작업은 작은 오류율을 거듭 곱합니다. 작업의 각 단계가 95% 확률로 성공하고 단계들이 서로 독립이라면, 20단계 작업의 성공률은 약 36%(0.95의 20제곱)에 그칩니다. 단계당 99%라면 같은 작업은 약 82% 확률로 성공합니다. 그래서 어느 한 단계의 탁월함보다 단계별 신뢰도가 더 중요하고, 다음 단계가 오류 위에 쌓이기 전에 그 오류를 잡아낼 체크포인트가 에이전트에 필요합니다.
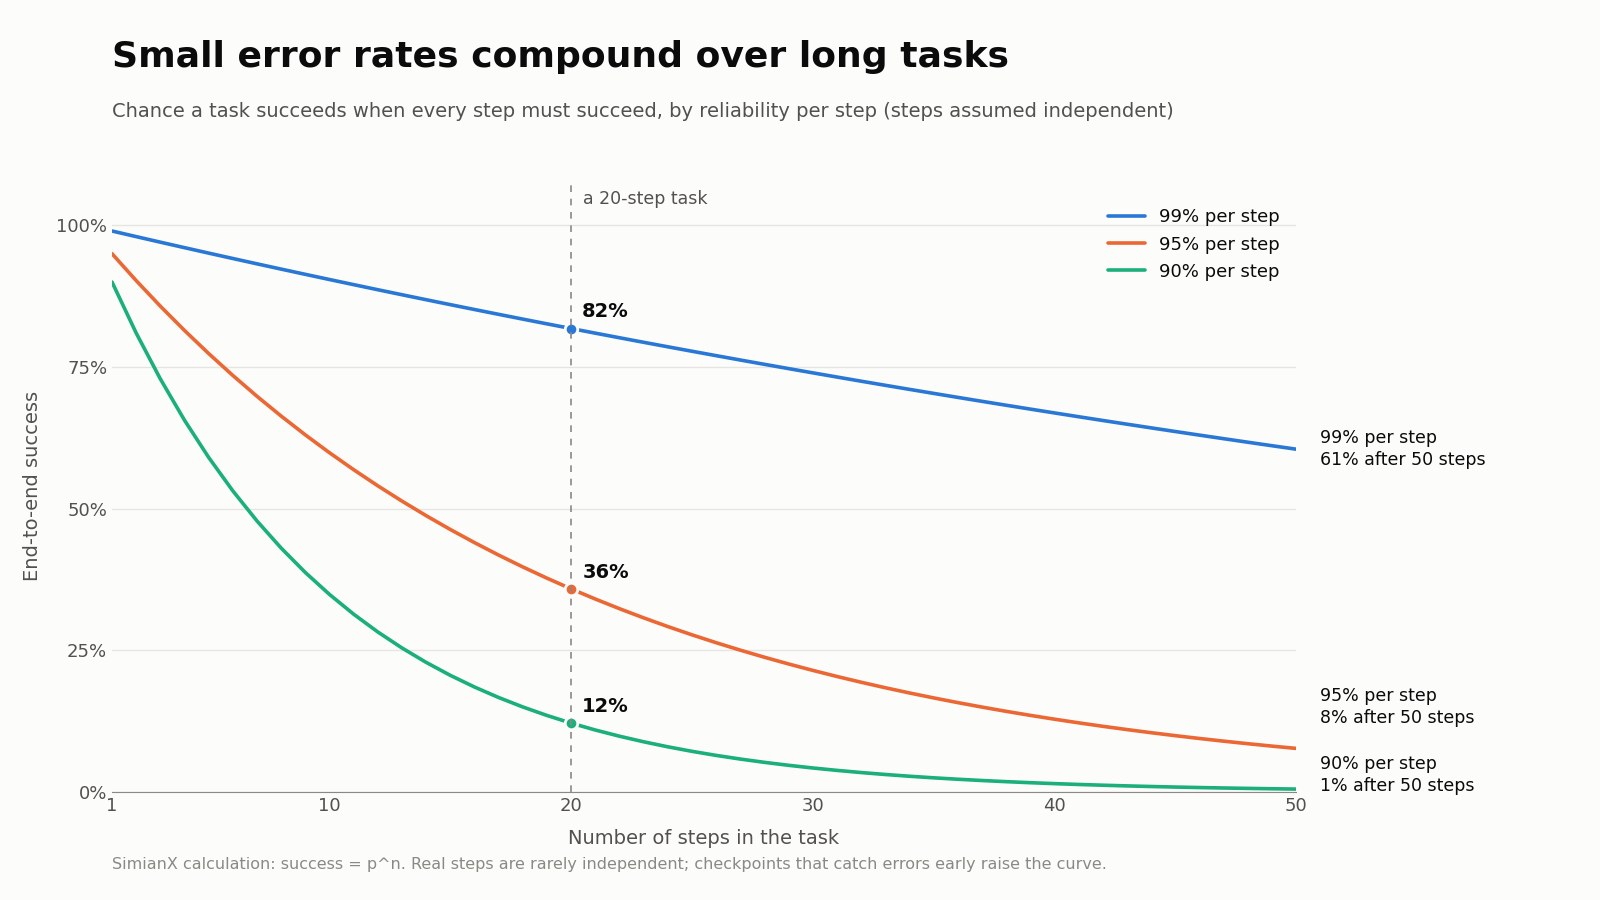
환각과 도구 결과 오독
모델은 사실을 지어내거나, 도구 결과를 잘못 읽거나, 낡은 숫자를 현재 값인 양 끌고 갈 수 있습니다. 에이전트에서는 이 문제가 더 심해집니다. 지어낸 값이 다음 행동의 입력이 될 수 있기 때문입니다. 해법은 구조적입니다. 바꿔 쓴 요약 대신 원본 데이터를 넘기고, 모델의 계산을 믿는 대신 핵심 숫자는 코드로 검증하며, 중요한 주장마다 출처를 요구하세요.
비용
루프를 한 바퀴 돌 때마다 모델 호출이 한 번 더 일어나고, 작업이 진행될수록 컨텍스트는 커집니다. 데모에서는 저렴해 보이던 작업도 실제 운영에서 에이전트가 재시도하고, 성찰하고, 다시 읽기 시작하면 몇 배의 비용이 들 수 있습니다. 작업마다 엄격한 예산을 정하고, 호출 한 번이 아니라 완료된 작업 하나의 비용을 측정하세요.
지연 시간
에이전트는 속도를 품질과 맞바꿉니다. 채팅 답변은 몇 초면 되지만, 리서치 에이전트는 몇 분이 걸릴 수 있고, 대규모 변경을 처리하는 코딩 에이전트는 훨씬 더 오래 돌 수 있습니다. SimianX의 여덟 에이전트 딥 리서치 위원회도 한 종목에 몇 분이 걸립니다. 무엇이든 쓰기 전에 에이전트들이 조사하고, 토론하고, 투표하기 때문입니다.
평가
에이전트는 비결정적입니다. 같은 작업이 한 번은 성공하고 다음에는 실패할 수 있습니다. tau-bench 벤치마크는 같은 작업을 k번 시도해 모두 성공할 확률인 pass^k라는 지표를 도입했고, 당시의 강력한 함수 호출 에이전트조차 소매 분야에서 여덟 번 모두 성공한 비율이 25%에 못 미쳤다는 사실을 밝혀냈습니다. 인상적인 실행 한 번은 거의 아무것도 알려 주지 않습니다. 코딩용 SWE-bench, 컴퓨터 사용용 OSWorld 같은 공개 벤치마크는 유용하지만, 그것이 여러분의 작업은 아닙니다.
보안과 권한
웹 페이지나 이메일을 읽는 에이전트는 그 안에 숨겨진 지시에 조종당할 수 있습니다. 프롬프트 인젝션이라 불리는 이 공격은 LLM 애플리케이션 위험에 관한 OWASP 목록의 맨 위에 올라 있습니다. 에이전트에는 꼭 필요한 최소한의 권한만 주고, 비밀 정보는 컨텍스트 밖에 두며, 돈을 옮기는 일처럼 되돌릴 수 없는 행동은 반드시 승인을 거치게 하세요.
이 문제들은 사업에도 영향을 줍니다. Gartner는 같은 2025년 6월 발표에서 비용 급증, 불분명한 사업 가치, 부적절한 위험 통제를 이유로 에이전틱 AI 프로젝트의 40% 이상이 2027년 말까지 취소될 것이라고 예측했습니다.
실제 사례: SimianX 에이전트는 매매 판단을 어떻게 나누는가
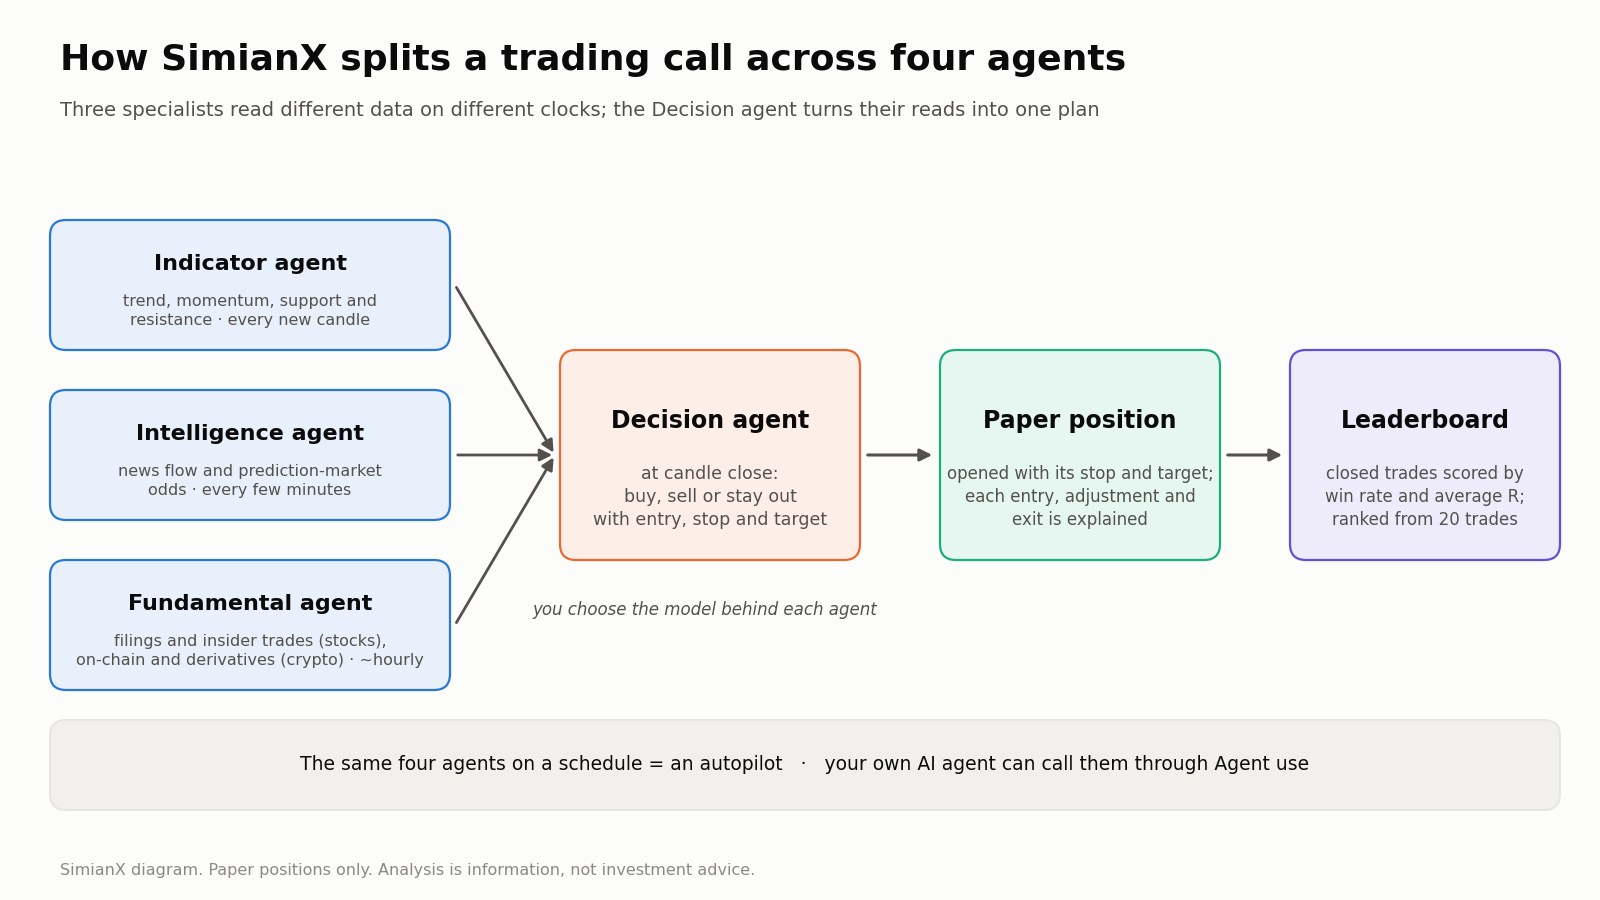
트레이딩은 에이전트에게 까다로운 시험대입니다. 데이터가 끊임없이 들어오고, 결정을 내리는 순간에는 정답을 알 수 없으며, 모든 판단은 결국 시장에서 채점됩니다. SimianX 시스템이 일을 나누는 방식은 다음과 같습니다.
실시간 분석: 세 전문가와 하나의 결정 에이전트
실시간 분석실에서 미국 주식이나 암호화폐 페어를 열고 시간 프레임을 고르면 네 에이전트가 일을 시작합니다. 분석 대상은 13,000개가 넘는 미국 주식과 ETF, 4,000개가 넘는 암호화폐 페어이며, 1분봉부터 그 이상까지 지원합니다.
- 지표 에이전트는 차트를 읽습니다. 추세, 모멘텀, 지지선과 저항선입니다. 새 캔들이 생길 때마다 실행됩니다.
- 정보 에이전트는 해당 종목의 뉴스 흐름과, 있는 경우 예측 시장의 확률을 읽습니다. 몇 분마다 갱신됩니다.
- 펀더멘털 에이전트는 주식이라면 공시와 내부자 거래를, 코인이라면 온체인 데이터와 파생상품 데이터를 읽습니다. 이런 정보는 천천히 바뀌므로 기본 설정으로 약 한 시간에 한 번 갱신됩니다.
- 결정 에이전트는 캔들이 마감될 때 나머지 셋의 견해를 저울질해 무엇을 할지 말합니다. 매수, 매도, 또는 관망이며, 진입가·손절가·목표가를 함께 제시합니다.
매매 기회가 나타나면 시스템은 그 손절가와 목표가로 모의 포지션을 열고, 거래가 진행되는 동안 진입, 조정, 청산을 하나하나 설명합니다. 각 에이전트 뒤에서 일할 모델은 사용자가 고릅니다. 같은 네 에이전트를 자동 조종 장치로 일정에 맞춰 돌릴 수도 있으며, 정보 에이전트가 활용하는 점수 매긴 뉴스 스트림은 마켓 펄스를 움직이는 바로 그 피드입니다.
왜 이렇게 나눌까요? 세 전문가는 서로 다른 주기로 돌아가므로, 분리해 두면 바뀌지 않은 공시를 다시 읽는 비용을 치르지 않고도 차트 해석을 캔들마다 새로 고칠 수 있습니다. 각 에이전트의 컨텍스트도 작고 집중된 상태로 유지됩니다. 그리고 의견 차이가 드러납니다. 차트는 "돌파"라고 하는데 뉴스 에이전트가 내일 실적 발표를 경고한다면, 결정 에이전트는 둘을 평균 내 덮어 버리는 대신 그 충돌을 직접 다뤄야 합니다.
딥 리서치: 여덟 에이전트 위원회
한 종목이나 한 코인을 더 천천히, 더 깊이 보고 싶다면 딥 리서치가 여덟 에이전트로 이뤄진 위원회를 소집합니다. 애널리스트 넷이 동시에 조사합니다. 펀더멘털, 차트, 뉴스, 그리고 네 번째 자리는 주식에서는 타이밍 관점, 암호화폐에서는 파생상품 애널리스트가 맡습니다. 이어서 강세 리서처와 약세 리서처가 각자 가장 강력한 논거를 세웁니다. 리서치 매니저가 가장 큰 쟁점을 두고 토론을 주재하고, 모든 위원이 마지막 투표에서 입장을 다시 밝히며, 리스크 매니저가 검증된 가격대와 함께 결정을 작성합니다. 새로 만든 위원회 둘러보기에서 실제 실행 한 번을 화면별로 따라가 볼 수 있습니다.
이것은 연구 문헌의 토론 패턴을 실제 서비스로 옮긴 것입니다. 약세 리서처가 있는 이유는, 맞장구만 치는 애널리스트들로 이뤄진 위원회는 사실상 하나의 의견을 네 번 되풀이하는 것에 불과하기 때문입니다.
리더보드는 결과를 어떻게 측정하는가
매매 판단을 내리는 에이전트는 추론이 얼마나 그럴듯하게 들리는지가 아니라 결과로 채점돼야 합니다. 암호화폐 리더보드는 이 모의 포지션 뒤에 있는 AI 모델들을 평가하며, 실제 시장 가격으로 정산된 청산 거래만 집계합니다. 현재 여러 AI 연구소의 모델 30개 이상을 다루며, 각 모델을 두 가지 방식으로 측정합니다.
- 승률: 청산된 거래 가운데 이익으로 끝난 거래의 비율.
- 평균 R: 진입할 때 감수한 위험을 단위로 잰 거래당 이익. 100에 매수하고 손절가를 98에 두면 단위당 2의 위험을 지는 것이고, 104에 청산하면 +2R, 손절가에 그대로 걸리면 −1R입니다.
모델은 현재 필터 조건에서 청산 거래가 20건 쌓여야 순위에 오릅니다. 그래서 운 좋은 거래 몇 건만으로는 맨 위에 오를 수 없고, 기간·시간 프레임·포지션 방향별로 걸러 볼 수도 있습니다. 두 숫자를 함께 읽는 것이 중요합니다. 승률은 높아도 R이 낮으면 큰 손실 몇 건이 가려져 있을 수 있고, 승률은 평범해도 R이 높으면 횟수는 적지만 더 큰 이익을 뜻할 수 있습니다. 리더보드 뒤의 모델들은 트레이딩 최강 AI 모델은?과 GPT·Gemini·Claude 비교 가이드에서 비교했습니다.
나만의 에이전트 연결하기
같은 시스템은 외부 에이전트에도 열려 있습니다. 에이전트 활용 페이지는 Claude Code, Codex, Cursor를 비롯한 다른 에이전트에 SimianX 스킬과 API 키를 주는 방법을 설명합니다. 그러면 에이전트가 어떤 종목이든 네 에이전트 실시간 분석을 시작하고, 점수 매긴 뉴스 스트림을 따라가고, 딥 리서치를 실행할 수 있습니다. 여러분의 에이전트는 여러분이 정한 예산이 걸린 자체 키를 받습니다. 웹사이트 로그인 정보는 절대 받지 않으며, 에이전트가 관리하는 모든 포지션은 모의 포지션입니다.
위험 고지: 위의 모든 내용은 분석과 모의 거래를 만들어 내는 소프트웨어에 관한 설명입니다. 이는 정보일 뿐 투자 조언이 아닙니다. AI 모델은 실수를 하고, 리더보드 결과는 과거 거래를 보여 줄 뿐 미래 수익을 예측하지 않으며, 어떤 모델이나 위원회도 시장 위험을 없애 주지 않습니다. AI의 판단 하나만 믿고 잃어서는 안 될 돈으로 거래하지 마세요.
2026년 AI 에이전트의 종류
교과서적 분류
교과서는 에이전트를 결정 방식에 따라 분류하며, 이 범주는 지금도 현대 시스템을 이해하는 데 도움이 됩니다.
| 유형 | 결정 방식 | 예시 |
|---|---|---|
| 단순 반사 에이전트 | 현재 입력에 대한 고정된 조건-행동 규칙 | 온도 조절기, 가격 알림 |
| 모델 기반 반사 에이전트 | 규칙에 더해, 직접 관찰할 수 없는 부분에 대한 내부 모형을 가짐 | 발신자의 이력을 추적하는 스팸 필터 |
| 목표 기반 에이전트 | 정해진 목표에 도달하는 행동을 탐색 | 경로 탐색기 |
| 효용 기반 에이전트 | 기대되는 득실이 가장 좋은 행동을 선택 | 보상과 위험을 저울질하는 트레이딩 에이전트 |
| 학습 에이전트 | 피드백으로 행동을 개선 | 클릭에 따라 갱신되는 추천 시스템 |
언어 모델 에이전트는 이 유형들을 섞어 씁니다. 무엇을 추구하느냐에서는 목표 기반이고, 선택지를 저울질할 때는 효용 기반이며, 결과를 성찰하면서 작업 안에서 학습합니다.
제품 범주
실제로 하는 일을 기준으로 묶으면, 2026년에 사람들이 쓰는 에이전트는 크게 다섯 범주로 나뉩니다. 여기에 나온 제품은 예시일 뿐 추천이 아니며, 기능은 빠르게 바뀝니다.
코딩 에이전트. AI 코딩 에이전트는 코드 저장소를 읽고, 파일을 고치고, 테스트를 돌리고, 변경안을 제안합니다. 흔히 풀 리퀘스트 형태입니다. Anthropic의 Claude Code, OpenAI의 Codex, GitHub Copilot의 코딩 에이전트, Cursor, Cognition의 Devin 등이 있습니다. 이들은 흔히 오픈소스 프로젝트의 실제 이슈를 해결하게 하는 SWE-bench로 비교됩니다. METR의 연구에 따르면, 최첨단 에이전트가 50% 신뢰도로 완료할 수 있는 소프트웨어 작업의 길이는 2019년 이후 대략 7개월마다 두 배로 늘었습니다.
리서치 에이전트. 웹이나 문서 모음을 검색하고, 많은 출처를 읽고, 출처가 달린 보고서를 씁니다. Google은 2024년 12월 Gemini Deep Research를, OpenAI는 2025년 2월 ChatGPT에 딥 리서치(deep research)를 출시했습니다. 약점은 출처의 질입니다. 잘 쓴 보고서도 부실한 출처 위에 서 있을 수 있습니다.
브라우저·컴퓨터 사용 에이전트. 화면을 보면서 클릭하고 타이핑해 브라우저나 데스크톱 전체를 조작합니다. Anthropic은 2024년 10월 컴퓨터 사용(computer use) 기능을 공개했습니다. 2025년 1월에 출시된 OpenAI의 Operator는 2025년 7월 ChatGPT agent로 통합됐고, Google에는 Project Mariner가 있습니다. API로 일하는 에이전트보다 느리고 신뢰도가 낮아서, 보통 API를 제공하지 않는 사이트에만 씁니다.
범용 에이전트. 폭넓은 목표를 받아 브라우징, 코드, 파일을 조합해 끝까지 해냅니다. 2025년 3월에 출시된 Manus가 가장 잘 알려진 예입니다. Meta는 2025년 12월 이 회사를 인수하기로 합의했지만, 2026년 4월 중국 국가발전개혁위원회가 거래를 되돌리라고 명령했습니다.
트레이딩·시장 분석 에이전트. 시장 데이터, 뉴스, 공시를 읽고 매매 계획을 내놓거나 포지션을 관리합니다. TradingAgents(Xiao 외, 2024) 같은 학술 프레임워크는 애널리스트, 리서처, 트레이더, 리스크 관리 역할을 갖춘 트레이딩 회사를 본뜨며, SimianX 같은 제품은 비슷한 위원회를 실시간 데이터로 운영합니다. 시장은 적대적이고 잡음이 많기 때문에, 공개된 거래별 실적 기록이 가장 중요한 범주가 바로 이것입니다.
AI 에이전트 평가 방법: 체크리스트
코딩 에이전트든, 리서치 도구든, 트레이딩 보조 도구든, 쓸모 있는 에이전트와 데모를 가르는 질문은 같습니다.
| 질문 | 좋은 모습 | 경고 신호 |
|---|---|---|
| 정말 에이전트인가? | 단계와 도구를 스스로 고른다 | "에이전트" 딱지만 붙은 고정 스크립트 |
| 내 작업에서 통하는가? | 내 업무에서 가져온 실제 작업 10~20개로 시험했다 | 업체 데모와 벤치마크 점수뿐 |
| 일관적인가? | 같은 작업을 여러 번 돌려도 비슷한 결과가 나온다 | 한 번은 훌륭하고 그다음은 실패 |
| 완료된 작업 하나의 비용은? | 완료 작업당 비용을 측정하고 상한을 둔다 | 호출당 가격만 제시 |
| 얼마나 걸리는가? | 속도가 용도에 맞는다 | 한 줄짜리 답에 몇 분씩 대기 |
| 무엇을 했는지 볼 수 있는가? | 단계, 도구 호출, 출처를 담은 전체 기록 | 흔적 없이 최종 답만 |
| 무엇에 손댈 수 있는가? | 최소 권한, 샌드박스나 모의 모드, 되돌릴 수 없는 행동에는 승인 | 광범위한 자격 증명, 승인 단계 없음 |
| 어떻게 멈추는가? | 예산, 단계 제한, 명확한 종료 규칙 | 누군가 알아챌 때까지 반복 |
| 데이터는 얼마나 최신인가? | 모든 데이터에 시각 표시 | 낡은 숫자를 현재 값처럼 제시 |
| 트레이딩 에이전트라면 실적 기록은? | 실제 가격으로 청산된 거래, 표본 크기 공개, 승률과 위험 조정 수익률 모두 제시 | 백테스트뿐이거나 거래 건수 없는 승률 |
자주 묻는 질문
AI 에이전트를 쉽게 말하면 무엇인가요?
AI 에이전트는 AI 모델을 써서 스스로 목표에 도달하는 프로그램입니다. 상황을 보고, 한 단계를 정하고, 검색이나 코드 같은 도구로 실행하고, 결과를 확인한 뒤, 일이 끝나거나 사람이 필요해질 때까지 이를 반복합니다.
AI 에이전트와 챗봇의 차이는 무엇인가요?
챗봇은 한 번에 메시지 하나에 답하고 여러분을 기다립니다. 에이전트는 여러 단계에 걸쳐 목표를 향해 계속 일하고, 쓸 도구를 직접 고르며, 단계마다 새 프롬프트가 없어도 코드 수정이나 보고서 작성 같은 작업을 끝낼 수 있습니다.
멀티 에이전트 시스템이란 무엇인가요?
멀티 에이전트 시스템은 역할이 서로 다른 AI 에이전트들이 하나의 작업을 함께 처리하는 구조입니다. 일을 나누거나, 반대 입장에서 토론하거나, 투표하며, 마지막 에이전트나 정해진 규칙이 결과를 합칩니다. 폭넓은 작업에서는 흔히 단일 에이전트를 앞서지만 비용이 훨씬 많이 듭니다.
AI 코딩 에이전트란 무엇인가요?
AI 코딩 에이전트는 소프트웨어 프로젝트 안에서 일합니다. 코드를 읽고, 파일을 고치고, 테스트를 돌리고, 변경안을 제안합니다. Claude Code, OpenAI Codex, GitHub Copilot의 코딩 에이전트, Cursor, Devin 등이 있습니다.
Manus AI란 무엇인가요?
Manus는 2025년 3월에 출시된 범용 AI 에이전트로, 폭넓은 목표를 받아 브라우징, 코드, 파일을 써서 끝까지 해냅니다. Meta가 2025년 12월 이 회사를 인수하기로 합의했지만, 2026년 4월 중국 규제 당국이 거래를 되돌리라고 명령했습니다.
AI 에이전트가 주식이나 암호화폐를 거래할 수 있나요?
시장을 분석하고 포지션을 관리할 수 있으며, SimianX를 비롯한 일부 제품은 에이전트가 손절가와 목표가가 걸린 모의 포지션을 운용하게 합니다. 결과는 모델과 시장에 따라 크게 다르므로, 어떤 트레이딩 에이전트든 청산된 거래 기록으로 판단하고, 그 결과물은 조언이 아니라 정보로 받아들이세요.
내 AI 에이전트를 실시간 시장 분석에 어떻게 연결하나요?
SimianX 에이전트 활용 페이지에서 Claude Code, Codex, Cursor를 비롯한 에이전트에 SimianX 스킬을 설치하는 방법을 안내합니다. 에이전트는 여러분이 통제하는 예산이 걸린 자체 API 키를 받고, 멀티 에이전트 실시간 분석을 시작하고, 점수 매긴 뉴스 스트림을 따라가고, 딥 리서치를 실행할 수 있습니다.
관련 글
- AI 주식 분석 개편: 질문할 수 있는 8 에이전트 위원회
- 애널리스트 8 vs 1: 정확도+37%, 리스크-41%분석
- 트레이딩 최강 AI 모델은? 30개 모델 실손익 비교
- 30+ AI 모델 6개 프로바이더: 크립토 실거래 랭킹
- GPT·Gemini·Claude AI 주식분석 2026
- 멀티에이전트AI vs ChatGPT NVDA 2026 비교
- AI 오토파일럿 24/7 암호 거래 (2026 가이드)
- 美 주식 라이브 분석: AI 다중 에이전트 실시간 커버
- Agentic AI 투자: 차세대 시장 초보자 가이드
참고 자료
- 러셀 & 노빅 — 인공지능: 현대적 접근(Artificial Intelligence: A Modern Approach)
- Anthropic — Building Effective Agents(2024년 12월)
- Anthropic — How we built our multi-agent research system(2025년 6월)
- Yao 외 — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn 외 — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du 외 — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri 외 — Why Do Multi-Agent LLM Systems Fail?
- Yao 외 — tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao 외 — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — 공식 문서
- Agent2Agent(A2A) 프로토콜 — 공식 사이트
- Gartner — 2027년 말까지 에이전틱 AI 프로젝트 40% 이상 취소 전망(2025년 6월)
- TechCrunch — 중국, Meta의 20억 달러 규모 Manus 인수 차단(2026년 4월)
- IBM — AI 에이전트란 무엇인가?
- OWASP — 대규모 언어 모델 애플리케이션 10대 위험