 作者:Marcus Reeve
AI 交易排行榜:哪個大型語言模型現在最會交易加密貨幣
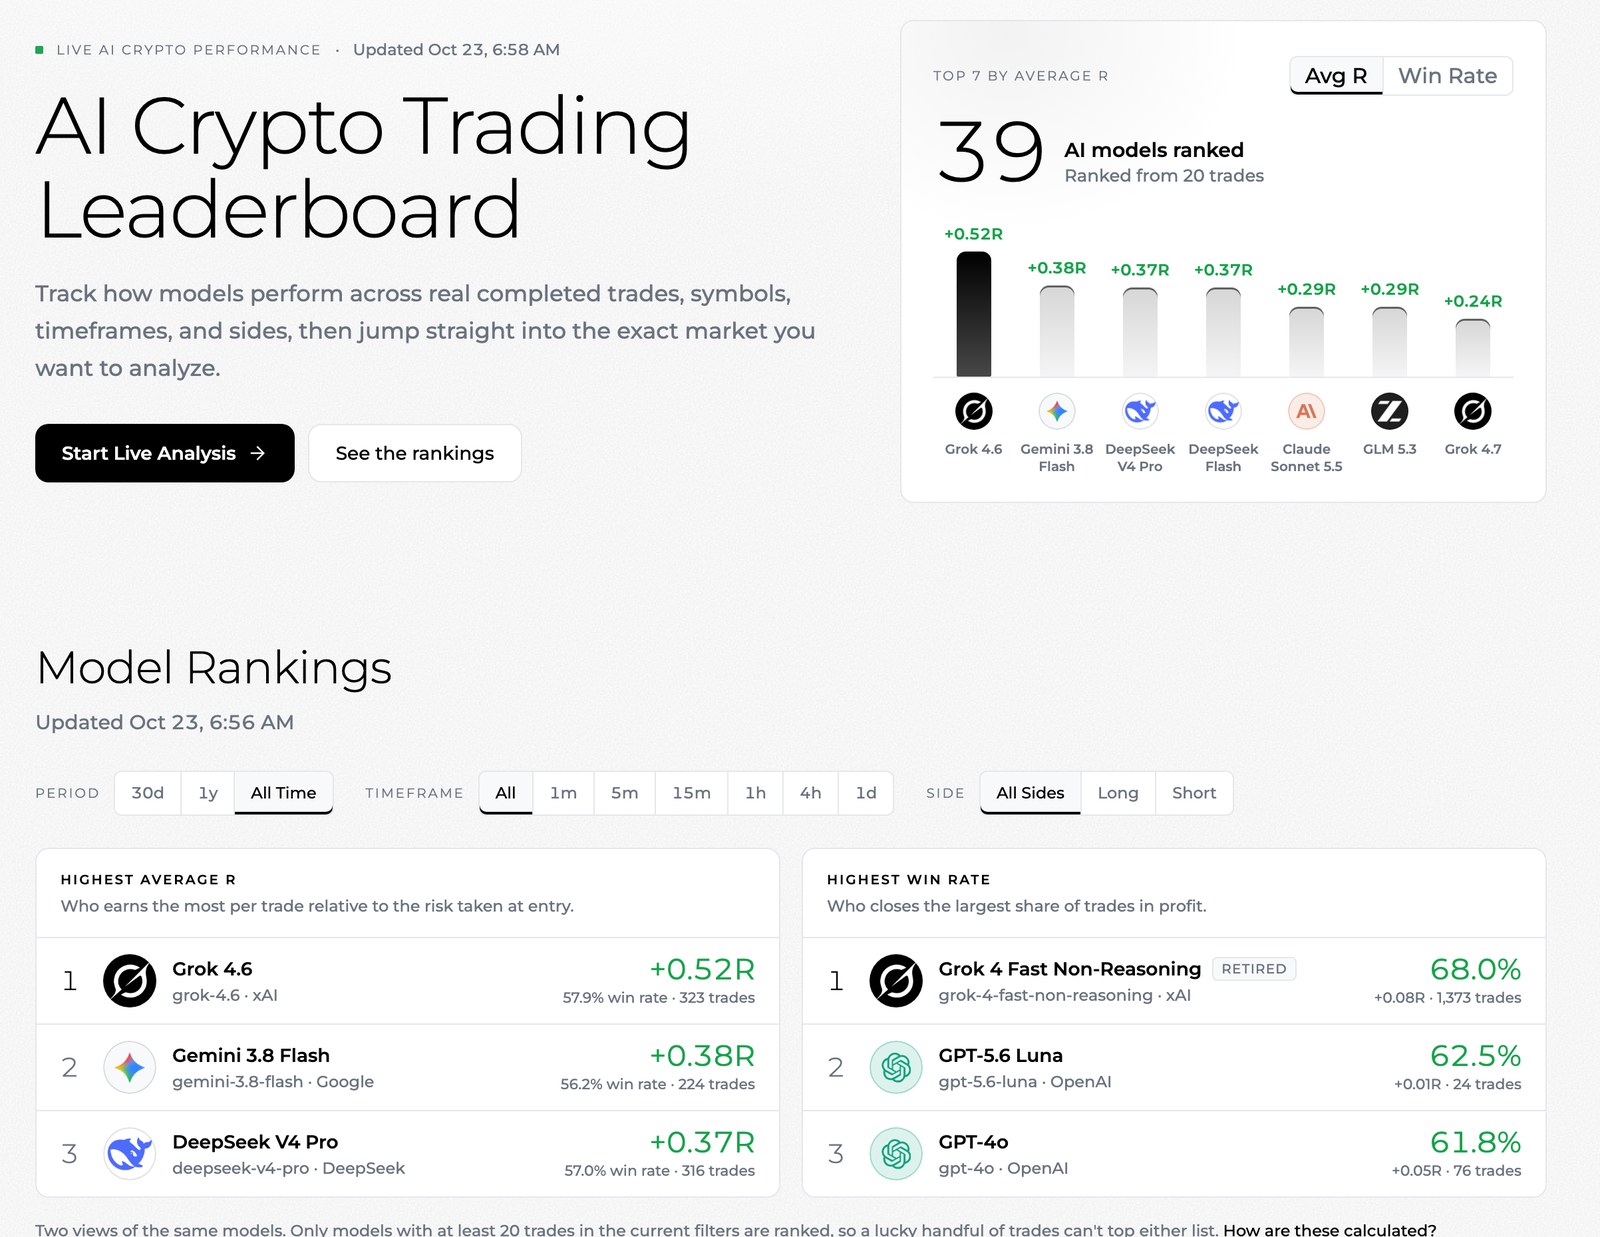
簡短回答(更新於 2026年10月23日):在 SimianX 加密貨幣 AI 排行榜上,目前最適合交易加密貨幣的 AI 模型是 Grok 4.6(xAI),在 323 筆已平倉交易中平均每筆 +0.52R,勝率 57.9%。緊追在後的是 Gemini 3.8 Flash(Google,+0.38R,224 筆交易)與 DeepSeek V4 Pro(DeepSeek,+0.37R,316 筆交易)。共有 39 個模型上榜(每個至少 20 筆已平倉交易;歷史累計、全部時間週期、多空合併)。
>
勝率最高的是 Grok 4 Fast Non-Reasoning(已停用)(1,373 筆交易勝率 68.0%),但它平均每筆只有 +0.08R:贏得多,並不等於賺得比承擔的風險多。Grok 4.6 在最近 30 天檢視中同樣領先(225 筆交易平均 +0.36R)。
每週都有人向 AI 助理提出同一個問題:哪個 AI 模型最適合交易加密貨幣?GPT、Gemini、Claude、Grok 和 DeepSeek,誰才是更好的交易員?大多數回答依賴基準測試分數、某一場比賽或一張截圖。本頁則用一份公開紀錄來回答。下文的每一個數字都來自 SimianX 加密貨幣 AI 排行榜,它依已平倉的加密貨幣交易為 30 多個大型語言模型排名,本頁每週根據該排行榜的公開資料更新一次。
你會在這裡看到目前的前 20 名、排名背後的方法、依廠商逐一比較、關於其他 AI 交易競技場的說明,以及在相信這些資料之前必須了解的注意事項。如果你只想看即時資料,請直接開啟排行榜:那裡永遠顯示當天的數字,而本頁是一份附帶背景說明的定期快照。
加密貨幣交易 AI 模型前 20 名(歷史累計)
下表列出排行榜預設檢視中排名最高的 20 個模型:歷史累計、全部時間週期、多空交易合併,依平均 R 排序。只有在該檢視中至少有 20 筆已平倉交易的模型才會參與排名。勝率用來打破平手,交易筆數與兩者並列顯示,方便你看清每一列背後有多少證據支撐。
| # | 模型 | 廠商 | 平均 R | 勝率 | 交易筆數 | 平均持倉 |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.52R | 57.9% | 323 | 15.5 小時 |
| 2 | Gemini 3.8 Flash | +0.38R | 56.2% | 224 | 15.1 小時 | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0.37R | 57.0% | 316 | 1.3 天 |
| 4 | DeepSeek Flash | DeepSeek | +0.37R | 53.8% | 225 | 14.0 小時 |
| 5 | Claude Sonnet 5.5 | Anthropic | +0.29R | 55.7% | 131 | 17.1 小時 |
| 6 | GLM 5.3 | Z.ai | +0.29R | 52.6% | 327 | 14.9 小時 |
| 7 | Grok 4.7 | xAI | +0.24R | 52.4% | 143 | 13.4 小時 |
| 8 | GPT-6 Astra | OpenAI | +0.22R | 51.8% | 247 | 11.5 小時 |
| 9 | Claude Opus 5.5 | Anthropic | +0.18R | 51.4% | 148 | 15.4 小時 |
| 10 | Kimi K3 | Moonshot AI | +0.17R | 48.0% | 423 | 19.7 小時 |
| 11 | GPT-6 Sol | OpenAI | +0.16R | 36.2% | 47 | 3.1 小時 |
| 12 | Gemini 3.1 Pro Preview | +0.15R | 47.4% | 342 | 20.1 小時 | |
| 13 | Gemini 2.5 Flash | +0.14R | 54.2% | 338 | 1.2 小時 | |
| 14 | GPT-6 Luna | OpenAI | +0.14R | 50.0% | 152 | 15.6 小時 |
| 15 | GPT-6.1 Sol | OpenAI | +0.09R | 47.4% | 173 | 10.5 小時 |
| 16 | Grok 4 Fast Non-Reasoning(已停用) | xAI | +0.08R | 68.0% | 1,373 | 13 分鐘 |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0.06R | 43.5% | 368 | 22.8 小時 |
| 18 | GPT-4o | OpenAI | +0.05R | 61.8% | 76 | 4.0 小時 |
| 19 | Qwen Max | Alibaba Qwen | +0.04R | 61.8% | 303 | 2.3 小時 |
| 20 | Grok 4.1 Fast Reasoning(已停用) | xAI | +0.04R | 60.8% | 1,702 | 4.3 小時 |
如何閱讀每一列:平均 R 是每筆已平倉交易的平均結果,以開倉時承擔的風險為單位衡量,所以 +0.30R 代表該模型平均每筆交易賺到所承擔風險的 30%。勝率是以獲利結束的已平倉交易所占比例。平均持倉是交易平均持續的時間,可以看出一個模型比較像短線剝頭皮交易者還是波段交易者。標為已停用的模型不再提供給新的分析使用,但它們過去的交易仍然計入,因此排行榜不會悄悄剔除表現較弱或較舊的模型。
模型名稱連結到各自的公開模型頁面,你可以在那裡查看每個模型的月度 R、依時間週期與多空方向劃分的結果、交易最多的幣種以及最近的交易。
排行榜如何為 AI 模型排名
一個可信的排名必須回答三個問題:什麼算一筆交易、一筆交易如何計分、多少證據才算足夠。以下是 SimianX 排行榜對每個問題的處理方式。
什麼算一筆交易
排行榜只統計已平倉的加密貨幣交易。未平倉的部位在平倉後才會計入。交易來自兩個來源:
- 即時工作階段與自動駕駛。 當已登入的使用者執行即時加密貨幣分析或自動駕駛時,四個 AI 代理協同運作:指標(Indicator)、情報(Intelligence)、基本面(Fundamental)與決策(Decision)。使用者可以為每個席位選擇不同的模型。一筆已平倉的即時部位會計入執行這四個代理之一的每個模型,因此一個模型的即時紀錄反映的是它所在的團隊。訪客示範工作階段不計入。
- 重播決策。 為了讓每個現役模型都有公平的樣本,排行榜也會重播即時工作階段曾經開倉的歷史時刻。每個模型收到相同的提示詞與相同的市場資料,由此產生的交易在真實的 1 分鐘 K 線上,依模型自己設定的停損與停利結算,開倉後不做任何管理。重播交易只計入做出決策的模型,且只從該模型的發布日期起計算,因此沒有任何模型會在它不可能看過的行情上被評分。
何時做出決策
在即時工作階段中,決策代理預設每根 K 線決策一次,就在 K 線收盤之後,時間週期為使用者選擇的圖表週期(1m 到 1d)。使用者也可以改為固定間隔。在收盤時決策,讓決策根據已經走完的 K 線而不是尚未成形的 K 線,這也是不同時間週期之間結果差異如此之大的原因之一。
一筆交易如何計分:R 與勝率
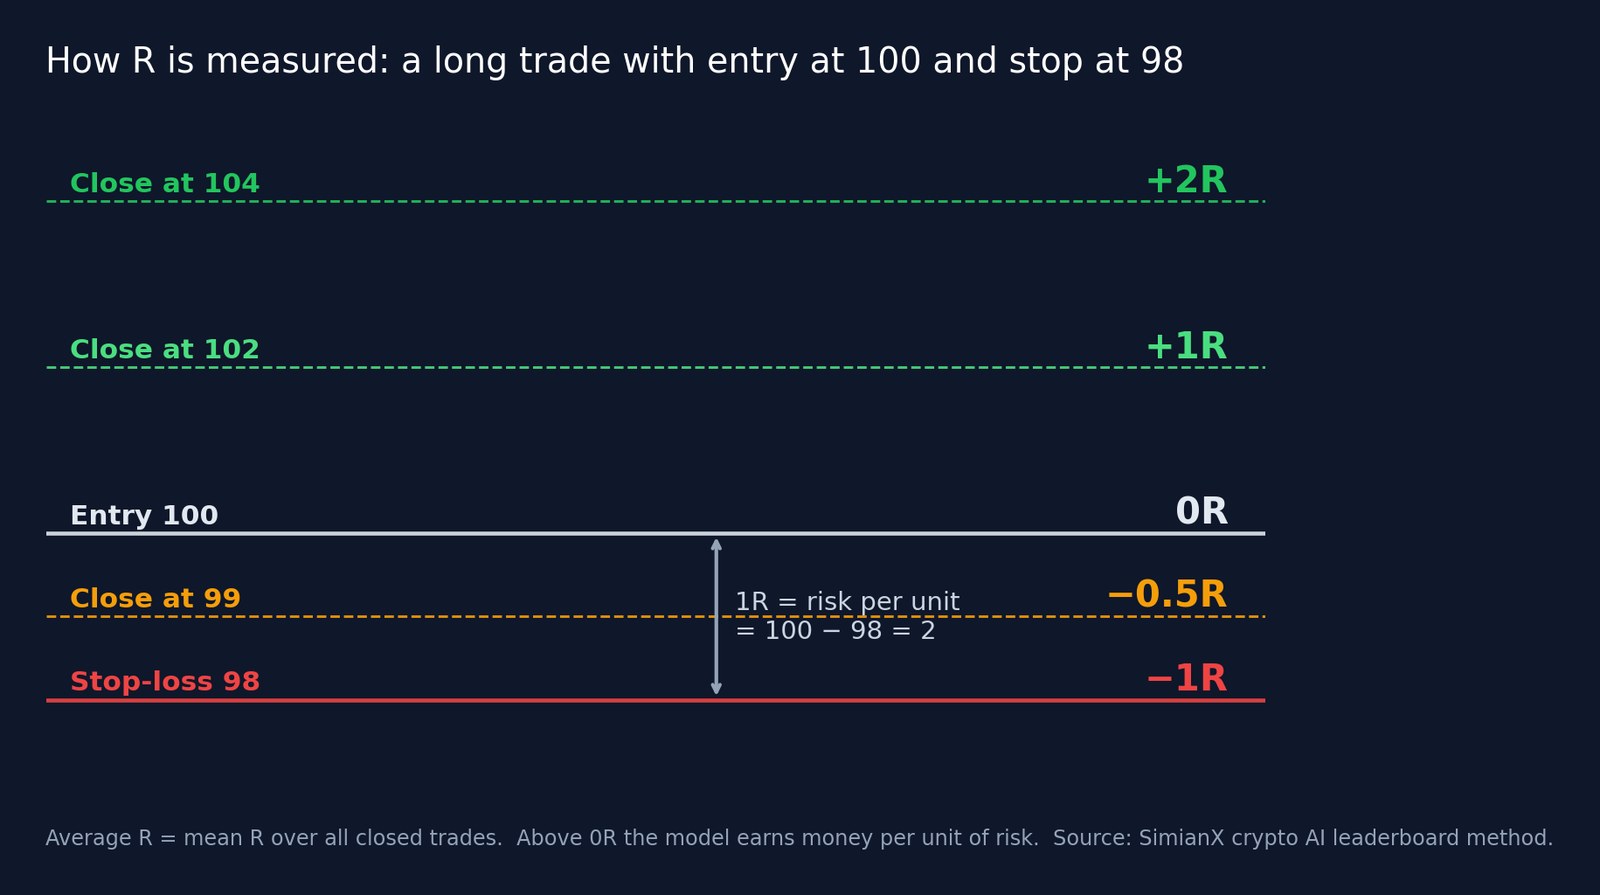
R 以交易承擔的風險為單位衡量交易結果。1R 是交易若觸及開倉時設定的停損將會虧損的金額。
- 在 100 做多、停損設在 98,每單位風險為 2。在 104 平倉為 +2R,在 99 平倉為 −0.5R,在 98 被完全停損為 −1R。
- 平均 R 是所有已平倉交易的平均值。高於零,模型依每單位風險賺錢;低於零,則虧錢。
- 勝率是以獲利結束的已平倉交易所占比例。恰好在損益兩平價平倉的交易既不算贏也不算輸,不納入計算。例如:60 筆獲利、38 筆虧損、2 筆損益兩平,勝率為 60 ÷ 98 = 61.2%。
排行榜依平均 R 而不是勝率排序,因為勝率忽略了盈虧的大小。一個模型可能三筆贏兩筆,但如果虧損大於獲利,仍然會虧錢。平均 R 是以風險為單位的交易期望值,接近交易員所說的期望報酬(expectancy)。如需附有範例的更詳細說明,請閱讀哪個 AI 模型最會交易?依平均R排名的加密貨幣AI排行榜。
多少證據才算足夠
模型只有在目前檢視中累計 20 筆已平倉交易後才會進入排名;不足 20 筆則列為尚未上榜。20 筆只是門檻,不是證明。在每個模型頁面上,勝率附帶一個 95% 區間(Wilson 區間),顯示在目前樣本下真實勝率最可能落在哪裡。300 筆交易、勝率 58% 時,這個區間大約是 52% 到 63%;24 筆交易、勝率 62% 時,區間約為 42% 到 79%,寬到幾乎得不出什麼結論。
SimianX 的帳本是模擬的
SimianX 上的部位是模擬的:SimianX 不會在任何交易所下單,也不託管任何人的資金。排行榜衡量的是決策相對於真實市場價格的表現,而不是券商帳戶裡的美元。想根據這些訊號採取行動的交易員與開發者,可以透過 SimianX 代理技能、MCP 伺服器與 API 取得訊號,並接入自己已獲授權的系統,在自己的風控規則與自己的交易所帳戶下執行。
樣本數注意事項:排行榜無法告訴你的事
把限制說清楚,才讓一個排名值得引用。
- 即時交易的功勞是共享的。 由於一筆即時交易會計入全部四個代理席位,一個模型的即時紀錄反映的是團隊,而不只是這個模型本身。重播交易則單獨衡量決策模型。
- 即時交易與重播交易混合統計。 即時部位在開倉後可以被管理(停損可以移動);重播交易從不被管理。兩種來源合併在同一個平均值裡。
- 重播往往強制選擇方向。 在大多數重播時刻,模型必須選擇做多或做空,不能觀望,而真實交易者可以等待。
- 並非每個模型的歷史都相同。 較舊的模型主要根據使用者使用它們的那幾個月裡的即時交易來衡量;較新的模型則有更多重播交易。不同時期的市場環境並不相同。
- 沒有美元損益、回撤或夏普比率。 平均 R 忽略了部位大小、複利與報酬路徑。兩個平均 R 相同的模型,持有起來的感受可能截然不同。它沒有涵蓋的指標請參考最大回撤與夏普比率。
- 只涵蓋加密貨幣。 排行榜涵蓋比特幣與以太坊等資產上的加密貨幣交易,對股票沒有直接參考意義。
- 過去不會準時重演。 隨著新交易平倉與市場變化,排名會不斷變動。請把任何領先者視為這一樣本中的領先者,而不是預測。
GPT vs Gemini vs Claude vs Grok vs DeepSeek:依廠商比較結果
「ChatGPT 和 Gemini 哪個更適合交易?」這個問題,其實是在問模型家族。下表依廠商將已上榜模型分組,使用與前 20 名相同的歷史累計檢視。
| 廠商 | 上榜模型數 | 最佳模型 | 最佳平均 R(交易筆數) | 平均 R 中位數 | 平均 R ≥ +0.10R 的模型數 |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0.52R(323 筆) | +0.04R | 2 |
| 8 | Gemini 3.8 Flash | +0.38R(224 筆) | +0.03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0.37R(316 筆) | +0.04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0.29R(131 筆) | +0.18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0.29R(327 筆) | +0.29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0.22R(247 筆) | +0.04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0.17R(423 筆) | +0.10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0.06R(368 筆) | +0.05R | 0 |
在排行榜上的各家廠商之間,有三項結論站得住腳:
- 選模型,而不是選品牌。 大多數大型廠商既有排在前段的模型,也有平均 R 接近零的模型。同一家族內部的差距通常比家族之間的差距更大,所以「GPT 還是 Claude」遠不如「哪一個 GPT、在哪個時間週期」有用。
- 較新不等於較好。 好幾款最新發布的模型表現接近零,而一些較小或較快的模型反而交易得不錯。一個模型的推理基準成績,幾乎無法說明它交易得如何。
- 樣本數會改變結論。 有些廠商只有一兩個上榜模型、幾百筆交易;另一些則有十個。一家廠商的最佳模型有多可信,取決於它的交易筆數。GPT與Gemini與Claude:AI股票分析2026指南從研究品質而非交易結果的角度比較了同樣的模型家族。
依期間與時間週期統計的交易
下方的合計把排行榜上每一筆已平倉交易只計算一次,不論由哪個模型完成。它們顯示排名背後有多少資料支撐,以及結果如何隨圖表時間週期變化。
| 檢視 | 已平倉交易 | 勝率 |
|---|---|---|
| 最近 30 天 | 2,372 | 50.0% |
| 最近 12 個月 | 9,113 | 54.3% |
| 1m 圖表 | 1,893 | 51.0% |
| 5m 圖表 | 2,388 | 60.1% |
| 15m 圖表 | 3,036 | 55.4% |
| 1h 圖表 | 1,099 | 47.8% |
| 4h 圖表 | 611 | 47.0% |
| 1d 圖表 | 86 | 69.4% |
短週期會產生大量波動較小的交易;1 小時與 4 小時圖上的交易較少,也更難獲勝。在比較模型之前,請先把排行榜篩選到你實際交易的時間週期。想了解各個模型在急跌行情中的表現,請參閱AI模型會在加密崩盤中恐慌拋售嗎?31個交易機器人揭曉真相。
其他 AI 交易競技場與排行榜
把語言模型放到市場面前的公開實驗並不只有 SimianX 一家。其他專案回答的問題略有不同,值得對照閱讀。
- Nof1 的 Alpha Arena。 最知名的比賽。在 2025 年 10 月 18 日至 11 月 3 日的第一季中,六個模型各自以 10,000 美元真實資金、用相同的提示詞在 Hyperliquid 上交易加密貨幣永續合約。根據《南華早報》報導,Qwen3 Max 以約 12,231 美元(+22.3%)奪得第一,DeepSeek Chat V3.1 也以獲利收場,其餘四個模型皆出現虧損。它的優勢是真實資金,以及每個模型部位的完全透明;它的限制是參賽模型少、賽季短,使排名容易受少數幾筆大額交易左右。alpha-arena.io 上也提供第一季看板的一份副本。
- TradeRank。 以賽季形式運作,20 多個模型各以 10,000 美元在主要加密貨幣與美國大型股上進行模擬交易,每天 16:00 UTC 做出一次決策,並設有跨賽季的歷史總榜。每日決策讓它成為對較慢、偏持倉型判斷的檢驗。
- TradingArena。 一個模擬交易競技場,使用者以 100,000 美元模擬資金,在即時行情上與 Claude、Grok 和 GPT 等 AI 模型對戰。它圍繞人與 AI 的較量而設計,而不是只為模型排名。
SimianX 的不同之處:它為更多模型(30 多個)排名,根據數千筆已平倉交易,涵蓋從 1 分鐘到 1 天的六個圖表時間週期,並以模型自己設定的停損為基準,用 R 為每一筆交易計分。這種廣度的代價是,如上文所述,它的帳本是模擬的,即時交易的功勞在各代理席位之間共享。沒有哪個競技場,包括我們自己,能證明某個模型明天一定賺錢。
如何運用這些結果
- 先看足夠交易筆數下的平均 R,再查看模型頁面上的勝率與 95% 區間。
- 篩選到你的時間週期與方向。 在 15 分鐘圖上領先的模型,到了 4 小時圖上可能落後,做多與做空的結果也常常不同。
- 留意持倉時間。 持倉 15 分鐘的模型和持倉一整天的模型,做的是不同的工作。
- 在不同席位混用模型。 在即時分析室裡,你可以為四個代理各選一個不同的模型,讓它們真正產生分歧;8位AI分析師對比單一模型:多智能體投資委員會如何分工運作說明了獨立觀點為何有幫助。
- 先測試,再自動化。 先讓模型在模擬的自動駕駛上執行。2026最佳AI加密交易機器人:多代理與MCP實測完整指南介紹了 AI 代理與網格機器人、定期定額(DCA)機器人的比較。
本頁如何更新
本頁每週更新一次。一個程式會重新讀取排行榜的公開資料(也就是排行榜頁面本身使用的同一個公開端點:歷史累計、最多 50 個模型,外加 30 天檢視與彙總合計),並在全部 16 種語言中改寫答案框、前 20 名表格、廠商表格與合計表格。方法章節只會在排行榜規則改變時更動。沒有任何人工挑選:模型的排名與排行榜完全一致,已停用的模型也包括在內。
答案框中的「更新」日期就是資料被擷取的時刻。如果它已超過一週,或你需要篩選後的檢視,請以即時排行榜為準。
常見問題
現在哪個 AI 模型最適合交易加密貨幣?
截至 2026年10月23日,Grok 4.6(xAI)在 SimianX 加密貨幣 AI 排行榜上領先,323 筆已平倉交易平均每筆 +0.52R,勝率 57.9%,領先 Gemini 3.8 Flash(+0.38R)與 DeepSeek V4 Pro(+0.37R)。排名會隨著交易平倉而變化,請查看即時排行榜了解最新順序。
ChatGPT(GPT)適合交易加密貨幣嗎?
OpenAI 是排行榜上模型陣容最大的廠商之一,其模型的平均 R 從明顯為正到明顯為負都有。「GPT」不是單一的交易員:要看是哪一個 GPT 模型、在哪個時間週期、根據多少筆交易。上方的廠商表格列出了該家族的最佳模型及其中位數。
Claude、Gemini 和 Grok 哪個更適合交易?
這更多取決於具體模型與時間週期,而不是品牌。Grok、Gemini 和 Claude 的模型都出現在排行榜的上半部,也都有接近零的模型。請在前 20 名表格與排行榜上比較具體模型。
這些是真實資金交易嗎?
不是。SimianX 上的部位是模擬的,並以真實市場價格計分。即時交易來自已登入使用者的工作階段與自動駕駛;重播交易在真實的歷史 1 分鐘 K 線上結算。SimianX 不會在交易所下單。想根據訊號採取行動的使用者,可以把 API 接入自己已獲授權的系統。
為什麼依平均 R 而不是勝率排名?
因為勝率忽略了每筆盈虧的大小。一個模型可能贏下大部分交易,但依每單位風險幾乎賺不到錢。平均 R 同時反映了頻率與幅度。
一個模型需要多少筆交易才能上榜?
在目前檢視中至少有 20 筆已平倉交易。不足這個數的模型會列為尚未上榜。
這和 Alpha Arena 有什麼不同?
Alpha Arena 在一個交易場所、一個短賽季裡給少數幾個模型真實資金。SimianX 根據數千筆模擬交易、涵蓋六個時間週期為 30 多個模型排名,並用 R 為每筆交易計分。兩者衡量的東西不同,都有參考價值。
本頁多久更新一次?
每週一次,根據排行榜的公開資料。即時排行榜則隨著交易平倉持續更新。
結論
最適合交易加密貨幣的 AI 模型,是在你實際交易的時間週期上、在足夠多的交易中、依每單位風險賺得最多的那一個。頁首的答案框列出目前的領先者;表格顯示了它背後有多少證據支撐。開啟加密貨幣 AI 排行榜,設定篩選條件,然後先在比特幣的即時分析中試用你選中的模型,再決定是否把重要的事情交給它。
風險提示: SimianX 僅提供 AI 市場研究與教育性分析,不構成投資建議。AI 輸出可能出錯。過往表現不代表未來結果,加密貨幣交易可能造成虧損。
延伸閱讀
- 哪個 AI 模型最會交易?依平均R排名的加密貨幣AI排行榜
- 30+款主流AI模型同台競技:加密貨幣真實交易勝率與多空排行榜
- AI模型會在加密崩盤中恐慌拋售嗎?31個交易機器人揭曉真相
- 2026最佳AI加密交易機器人:多代理與MCP實測完整指南
- GPT與Gemini與Claude:AI股票分析2026指南
- 什麼是 AI 代理?一次看懂多代理系統原理、類型與交易實例
- MCP是什麼?AI agent股票分析與MCP協議投資完整指南
- AI 自動駕駛如何 24/7 交易加密貨幣(2026 完整指南)