單一模型還是一個委員會?八位 AI 分析師如何互相檢核
簡短回答:八位 AI 分析師並不比一個模型聰明八倍。它們帶來的是結構。每個智能體只讀取更窄的一部分證據,在看到其他人的觀點之前先把自己的判斷寫下來,接著還要面對一位專門唱反調的同事,為自己的觀點辯護。最後由一個獨立角色把各份報告整合成一個決策,並說明什麼情況會證明這個決策是錯的。這套流程無法消除錯誤,但能讓錯誤浮上檯面,而浮上檯面的錯誤,才有機會在讓你賠錢之前被抓出來。
本文說明為什麼單一模型在股票與加密貨幣分析上力有未逮、多智能體架構究竟改變了什麼,以及它仍有哪些不足。我們以 SimianX 運行的兩種架構作為實例:由四個智能體組成的即時分析室,以及設有八個席位的深度研究委員會。下文的每一項產品細節,都在 2026 年 10 月對照線上運行的系統核實過。我們不會為這兩種架構引用任何準確率或報酬數字,因為我們沒有發布過任何站得住腳的此類數字;最接近公開證據的,是文末會談到的加密貨幣 AI 排行榜。
如果你對智能體本身還不熟悉,可以先讀什麼是 AI 代理?一次看懂多代理系統原理、類型與交易實例,文中介紹了單一智能體如何規劃、呼叫工具,以及如何把工作交給另一個智能體。
為什麼單一模型難以勝任市場分析
問一個大型語言模型該不該買某檔股票,你會得到一個流暢的回答。問題不在於這個回答總是錯的,而在於你無法判斷其中哪些部分值得信任。
以下四個弱點反覆出現:
- 所有事情一次完成。看圖、財報分析、新聞判讀與風險估算,全都擠在一次回答裡爭奪注意力。模型最先想到的內容,往往會替後面的一切定調。
- 內部沒有異議。單一回答的寫法追求前後連貫。不利的事實會被輕輕帶過,而不是被拿出來爭論,因為對話裡沒有人被安排去反駁。
- 數字是寫出來的,不是算出來的。模型可以信心滿滿地給出一個風險報酬比或價位,算術卻照樣出錯。
- 沒有稽核紀錄。判斷出錯時,你手上只有一大段文字,無從得知是哪項輸入或哪個步驟出了問題。
這並不代表單一模型毫無用處,而是說一個模型在扛整個研究部門的工作,卻沒有研究部門該有的任何制衡。
多智能體架構究竟改變了什麼
多智能體系統把一項工作拆給不同角色。在投資領域,這個思路借鏡自人類研究團隊早已採用的做法:專業人員各自撰寫獨立的研究筆記,有人專門論證反方觀點,再由決策者拍板。學術研究也指向同一方向。來自 MIT 與 Google 的研究者指出,讓多個模型實例相互辯論,可以提升基準任務上的事實準確性與推理能力(Du et al., 2023);TradingAgents 框架(Xiao et al., 2024)則把交易研究組織為分析師、多頭與空頭研究員,以及風控團隊。這些都是基準測試與模擬環境中的研究結果,並不能證明任何產品能夠賺錢。
以下是實務上會改變的地方,以及不會改變的地方:
| 問題 | 單一模型 | 智能體委員會 |
|---|---|---|
| 誰來讀取資料? | 一個模型同時讀取所有內容 | 每個角色只讀自己負責的部分(圖表、申報文件、新聞) |
| 最初的觀點是否彼此獨立? | 否,只有一種觀點 | 是,分析師在看到彼此成果之前先寫下判斷 |
| 分歧會被攤開嗎? | 很少;回答本來就追求順暢 | 刻意為之:多頭與空頭相互辯論,由主持人挑出懸而未決的問題 |
| 誰為最終判斷負責? | 就是做研究的那個聲音 | 一個必須權衡所有報告的獨立角色 |
| 能追溯錯誤嗎? | 很難;只有一整段文字 | 比較容易;每份報告和每一輪辯論發言都會保留 |
| 能修正模型的盲點嗎? | 不能 | 只能部分修正:如果每個席位都用同一個模型、同一份資料,錯誤仍可能疊在一起 |
| 成本與時間 | 低 | 較高:呼叫次數更多,每次運行需要幾分鐘 |
第二欄背後的思路,與集成學習和群眾智慧相同:只有當各個判斷彼此獨立時,把它們結合起來才最有幫助。如果八個智能體透過同一個模型讀同一則新聞標題,你得到的只是同一個觀點重複八遍。所以結構比人數更重要。
即時分析室:四個智能體盯著同一張圖
SimianX 的即時分析室會把四個智能體放到你選定的標的與圖表週期上。它涵蓋超過 13,000 檔美股與 ETF,以及超過 4,000 個加密貨幣交易對,最短可到 1 分鐘 K 線(數字為我們資料庫中上線市場的數量,統計於 2026 年 10 月 15 日)。
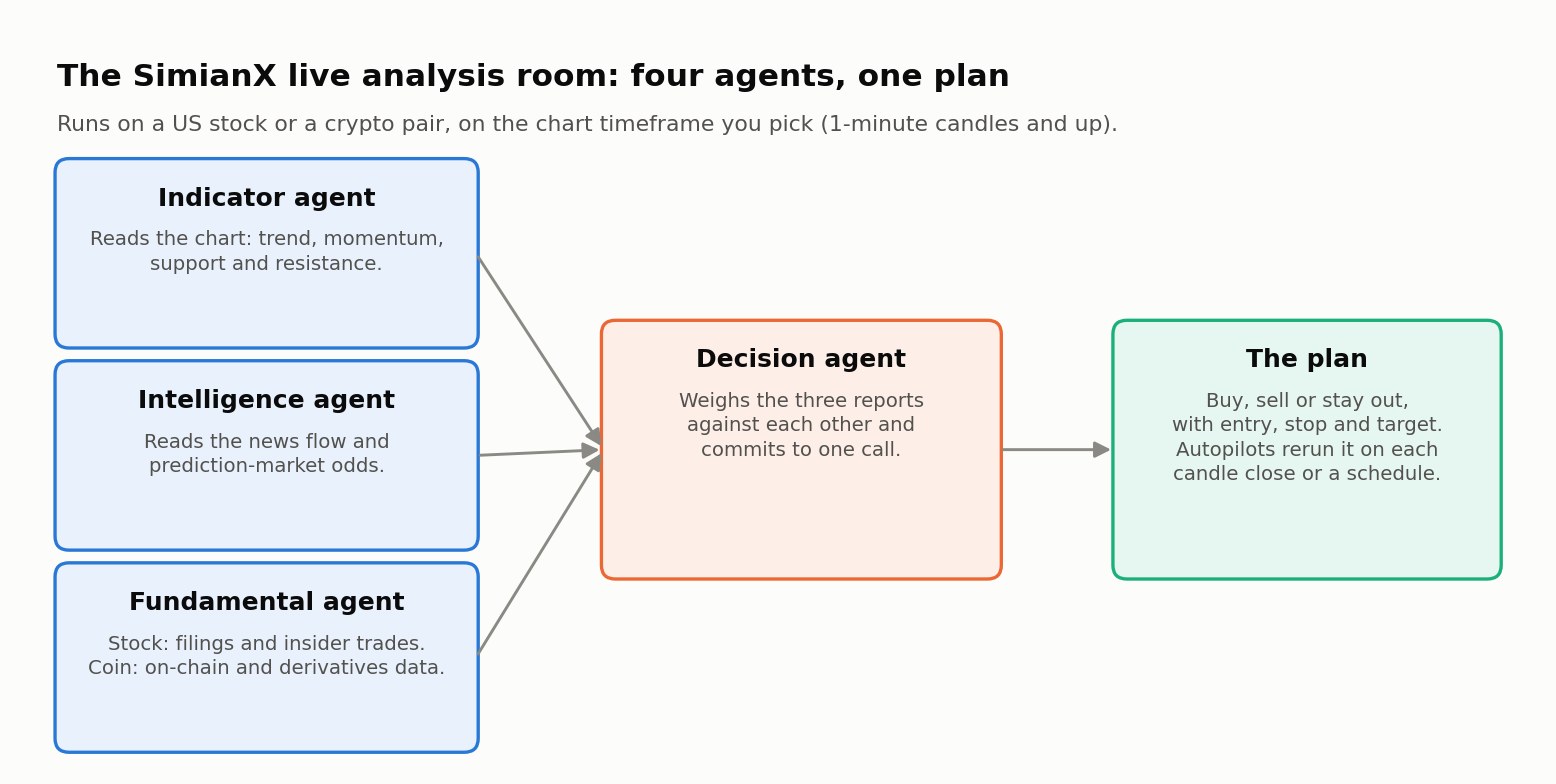
- 指標智能體。判讀圖表:趨勢、動能、支撐與壓力,使用 RSI、MACD 與 ATR 等標準指標。
- 情報智能體。判讀該標的的新聞流,以及(若有的話)預測市場的賠率。
- 基本面智能體。股票看申報文件與內部人交易;幣種看鏈上資料與衍生性商品資料。
- 決策智能體。權衡另外三份報告並給出明確結論:買進、賣出或觀望,附上進場價、停損與目標價。
你可以替每個智能體選擇背後的模型。這一點對前面提到的獨立性很關鍵:在不同席位上運行不同模型,是少數幾種能確保智能體不會共享同一個模型習慣的方法之一。如果你希望分析室持續盯盤,自動駕駛儀會在每根 K 線收盤時,或依你設定的排程,運行同樣的四個智能體。
即時分析室為速度而生:一張圖、一個週期、一份計畫。它不安排辯論。要辯論,就得用委員會。
深度研究委員會:八個席位,四個階段
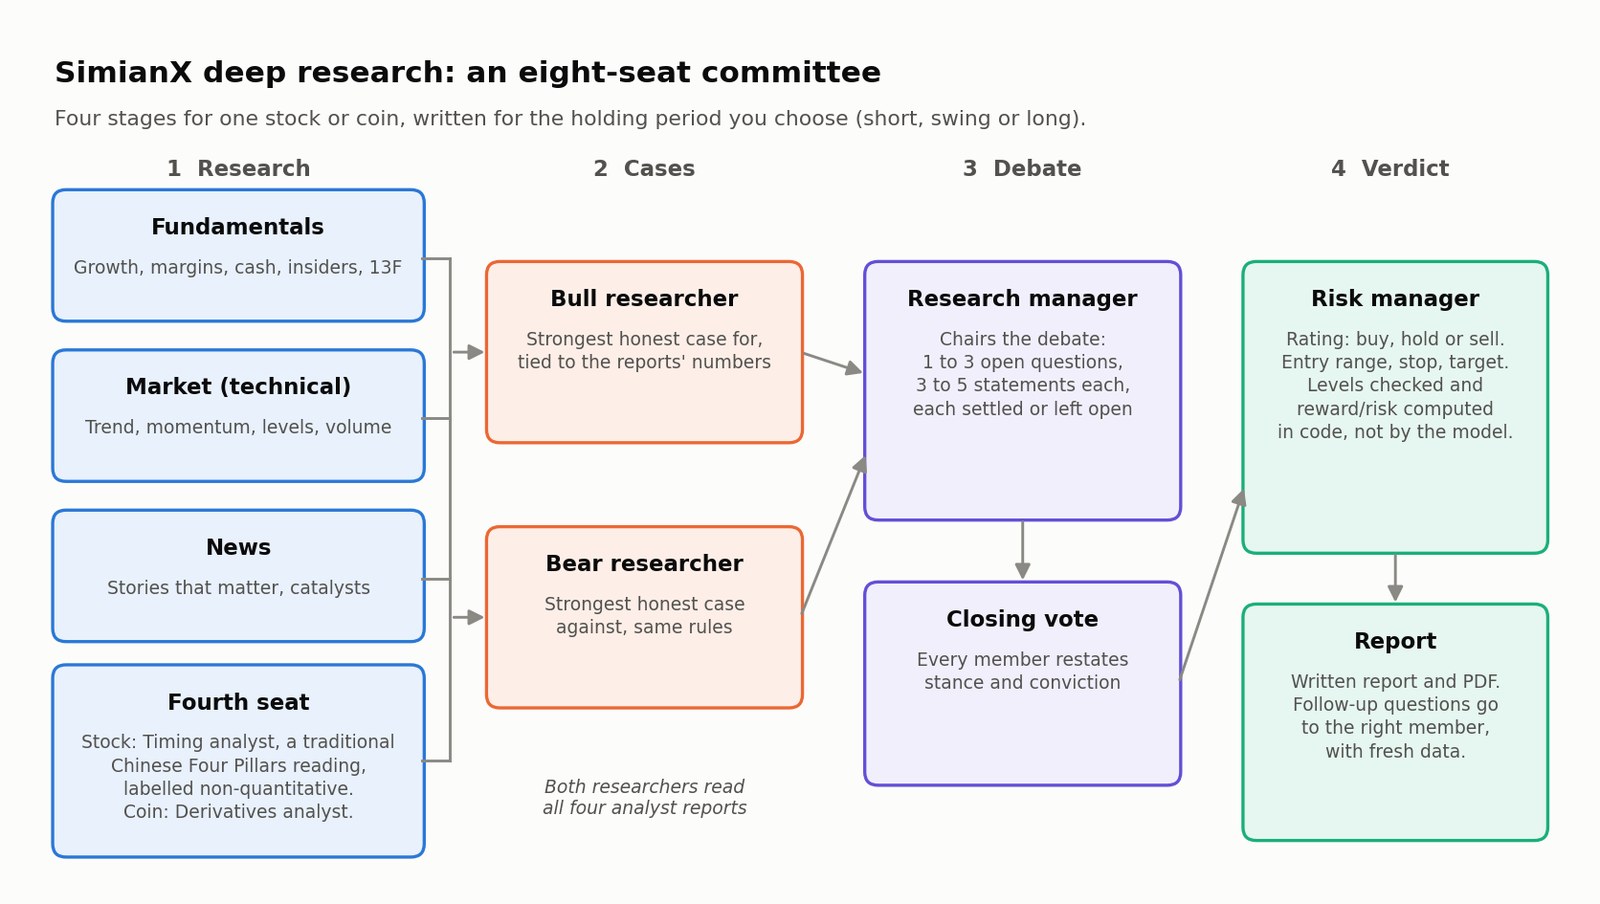
深度研究模式讓八個智能體圍繞一檔股票或一個幣種入座,分四個階段運行。開始之前,你要選擇持有期間:短線(幾天到大約兩週)、波段(兩到八週)或長線(六到十二個月甚至更久)。每位成員都依這個期間撰寫,所以長線投資人不會拿到當沖交易者的停損位。
| 席位 | 讀取什麼 | 交出什麼 |
|---|---|---|
| 基本面分析師 | 營收與利潤率趨勢、自由現金流、現金與負債、內部人買賣、每季 13F 機構持股 | 在持有期間內最關鍵的那一項基本面事實 |
| 市場(技術)分析師 | 均線所呈現的趨勢、RSI、MACD、近期漲跌幅、支撐與壓力、成交量 | 一個方向判斷與能推翻它的價位,外加一個交易設定,或說明為什麼沒有 |
| 新聞分析師 | 真正重要的三到五則新聞(逐則註明日期與來源),以及即將到來的催化事件 | 新聞流是順風、逆風還是中性 |
| 第四席(股票):擇時分析師 | 依中國四柱八字傳統解讀公司的成立日期 | 一個擇時觀點,提示詞要求它明確標示為傳統、非量化的視角 |
| 第四席(幣種):衍生性商品分析師 | 期貨與永續合約、未平倉量、資金費率、多空部位結構、選擇權資金流 | 槓桿集中在哪裡,以及什麼會讓它平倉瓦解 |
| 多頭研究員 | 全部四份分析師報告 | 最有力且誠實的看多理由,以數字支撐,並給出信心分數 |
| 空頭研究員 | 全部四份分析師報告 | 最有力且誠實的看空理由,遵守同樣規則 |
| 研究經理 | 所有報告以及兩位研究員的論點 | 主持辯論:挑出一到三個懸而未決的問題,逐一做出裁定或保留為未決 |
| 風險經理 | 以上全部內容,在辯論結束之後 | 最終裁定:買進、持有或賣出,附帶信心水準、進場區間、停損與目標價 |
關於股票委員會的第四席需要說明:它是刻意引入的外部視角,不是隱藏的訊號。它自己的指令要求它直截了當地說明這是非量化的方法,而且不得捏造任何財務事實。請把它當作一種不同的觀點來讀,永遠不要把它當成證據。
第一階段:四份獨立的解讀
四位分析師同時作業,彼此看不到對方的草稿。獨立性正是來自這裡。如果基本面看起來很強、圖表卻已經破線,這個分歧現在由兩個不同的智能體分別寫下,而不是被揉進同一段話裡。
第二階段:雙方各自最有力的論點
多頭與空頭研究員會閱讀全部四份報告。每位研究員都被要求:替己方建立最有力且誠實的論點,把每條論據都對應到報告中的某個數字,回應對方最危險的兩個論點,並說明什麼會讓自己改變想法。這等於內建一位唱反調的人,是對付團體迷思的標準做法。
第三階段:有主持人的辯論與收尾投票
研究經理不會把觀點直接取平均。它會挑出最重要的一到三個分歧,排進議程。每個問題有三到五輪發言,成員可以調取最新資料來支撐論點,最後由主持人對問題做出裁定,或記錄為未解決。最後一個問題結束後,每位成員重新表態自己的立場與信心,你可以看到誰改變了看法、誰沒有。
第四階段:數字經過核驗的最終裁定
風險經理在辯論之後才做決定,而不是之前。它給出一個評等(買進、持有或賣出)、一個信心水準、一句標題式結論、一個進場區間、一個停損與一個目標價。有兩道保障位於模型之外:價位由程式檢查(做多時停損必須低於進場價、目標價必須高於進場價);風險報酬比由程式依進場區間內最差的成交價計算,而不是由模型寫出來。接著,這次運行會產生一份完整報告與一份 PDF,你還可以繼續發問;每個追問都會交給最適合回答的那位成員,並附上最新資料。
如果想逐一畫面看一次真實運行的全過程,請閱讀AI股票分析全面重構:8智能體委員會辯論表決,還能隨時追問。
交叉檢核如何運作:一個示例
下面的例子僅供說明,並非某次真實運行的紀錄。它呈現一個分歧在委員會中走過的路徑。
- 市場分析師看到股價帶量突破壓力位,傾向看多。
- 基本面分析師發現營業利益率已連續三季收窄,而且內部人一直在淨賣出。
- 空頭研究員以利潤率趨勢為核心建立論點;多頭研究員則主張這次突破反映了新一輪產品週期。
- 研究經理把一個問題排進議程:利潤率下滑是暫時的還是結構性的?雙方都拿數字展開論證。
- 這個問題仍未解決。在收尾投票中,市場分析師下調了自己的信心。
- 風險經理給出「持有」評等,並明確寫出條件:等待更好的進場點,或者等到某一季顯示利潤率回升。
拿到同樣資料的單一模型,可能會寫出「突破強勁,有些利潤率壓力,溫和看多」。委員會則把衝突寫下來,點出決定結論的那個問題,並告訴你該關注什麼。這就是結構的實際價值。
即時分析室與深度研究:什麼時候用哪一個?
| 即時分析室 | 深度研究委員會 | |
|---|---|---|
| 智能體 | 4 個(指標、情報、基本面、決策) | 8 個(四位分析師、多頭、空頭、研究經理、風險經理) |
| 市場 | 美股與 ETF、加密貨幣交易對 | 美股、幣種 |
| 時間維度 | 你選定的圖表週期,最短 1 分鐘 | 一個持有期間:短線、波段或長線 |
| 辯論 | 無;由決策智能體權衡三份報告 | 由主持人主導一到三個問題的辯論,接著投票 |
| 輸出 | 買進、賣出或觀望,附進場價、停損、目標價 | 買進、持有或賣出,附進場區間、停損、目標價、報告與 PDF |
| 最適合 | 在你正在看的圖上掌握交易時機 | 判斷一個部位到底值不值得建立 |
證據能說明什麼,不能說明什麼
本文的早期版本曾引用一些我們無法核實的準確率提升、客戶數量與案例研究。這些內容已全數刪除。以下是可以誠實說出的內容。
- 研究支持的是方法,而不是某個報酬數字。已發表的研究顯示,多智能體辯論能在基準測試中改善推理與事實準確性,文獻中也有委員會式的交易框架。但兩者都無法告訴你某個特定產品在你的帳戶裡表現如何。
- 即時智能體的表現是公開衡量的。即時加密貨幣工作階段開倉與平倉的部位,加上在相同決策時點上的回放交易,共同構成 SimianX 加密貨幣 AI 排行榜的資料,該榜單依每筆交易的平均 R 值替模型排名。截至 2026 年 10 月 15 日,共有 39 個模型進入排名,平均值從 +0.59R 到 −0.33R 不等。這只涵蓋加密貨幣,衡量的是模型,而不是八席委員會。如何解讀這個榜單,請參閱哪個 AI 模型最會交易?
- 委員會目前還沒有公開的成績單。我們沒有發布深度研究裁定的命中率。請把每次裁定當作一份結構化的第二意見,而不是一個準確率已知的預測。
需要牢記的局限
- 共同的盲點。如果所有席位都由同一個模型擔任,它的習慣與知識空白會出現在每一份報告裡。免費運行的所有席位都使用同一個預設模型;付費使用者可以替每個席位分別選擇模型。
- 共同的資料。智能體只能根據提供給它們的資料推理。一份缺漏的申報文件或一個過時的價格,會影響下游的所有成員。
- 辯論不等於真相。論證充分的觀點依然可能是錯的,委員會也可能說服自己達成虛假的共識。收尾投票呈現的是觀點如何變化,並不能證明哪一方是對的。
- 速度與成本。一次委員會運行需要幾分鐘,呼叫模型的次數比單一回答多,因此會消耗你所屬方案更多的點數。
- 有一個視角是傳統方法。股票委員會的擇時席位明確屬於非量化方法。
- 市場會變。無論單一模型還是多智能體,任何架構都無法消除虧損風險。
常見問題
八個 AI 智能體一定比一個好嗎?不一定。它們更擅長把分歧攤開,並記錄一個決策是怎麼得出的。如果每個智能體都使用同一個模型與同一份資料,它們的錯誤仍可能疊加在一起。
這些智能體使用不同的 AI 模型嗎?可以。在即時分析室中,你可以替每個智能體選擇背後的模型。在深度研究中,免費運行的每個席位都使用同一個預設模型,付費使用者可以替每個席位分別設定模型。
最終裁定包含哪些內容?一個評等(買進、持有或賣出)、一個信心水準、一個進場區間、一個停損、一個目標價、一個由程式計算的風險報酬比、一份書面報告與一份 PDF。
它能替我交易嗎?深度研究給出的是建議,不是下單指令。自動駕駛儀可以依排程重新運行四個即時智能體,並管理一個模擬部位。
SimianX 會公布準確率嗎?深度研究不會。即時加密貨幣智能體在模型層面的交易成績公開在排行榜上。
這和直接問通用聊天機器人相比如何?請參閱多智能體 AI 與 ChatGPT 的 NVDA 訊號比較以及GPT、Gemini 與 Claude 的 AI 股票分析比較指南。
結論
更多的智能體並不代表更多的智慧,而是代表更多的檢核:獨立的初步解讀、強制的反方論證、一位點出懸而未決問題的主持人,以及一個數字在模型之外核驗過的最終決策。這就是委員會可能比單一回答更有用的原因,也是它依然值得你像對待任何分析師一樣保持懷疑的原因。你可以在即時分析室裡試看一張圖,對正在考慮的標的跑一次完整的深度研究,或透過 agent 使用把四個即時智能體接入你自己的程式開發智能體。
風險提示:SimianX 僅提供多智能體市場研究與教育性分析,不構成投資建議。AI 輸出可能出錯。過往績效不代表未來結果,交易股票或加密貨幣可能造成虧損。
延伸閱讀
- 什麼是 AI 代理?一次看懂多代理系統原理、類型與交易實例
- AI股票分析全面重構:8智能體委員會辯論表決,還能隨時追問
- 哪個 AI 模型最會交易?依平均R排名的加密貨幣AI排行榜
- GPT與Gemini與Claude:AI股票分析2026指南
- 多智能體AI對比ChatGPT:NVDA訊號2026深度對比
- 美股即時分析:AI 多代理即時覆蓋每一隻美股的行情與訊號
- 對沖基金深度研究的多智能體AI管線:機構級架構方案完整詳解