Agentes de IA explicados: de un modelo en bucle a un equipo de especialistas
Un agente de IA es un sistema de software que usa un modelo de inteligencia artificial para perseguir un objetivo por su cuenta: lee la situación, decide el siguiente paso, actúa mediante herramientas como la búsqueda web, el código o una API, y comprueba el resultado antes de continuar. Un sistema multiagente reparte ese trabajo entre varios agentes especializados que comparten lo que encuentran, se cuestionan unos a otros donde discrepan y entregan una respuesta combinada a un agente que toma la decisión final.
Esa definición de dos frases cubre casi todo lo que el término significa en 2026, desde los asistentes de programación que corrigen errores en todo un repositorio hasta las herramientas de investigación que leen cientos de páginas antes de redactar un informe. También oculta lo difícil. Los agentes cuestan más que una respuesta de chat, tardan más, y un pequeño error al principio de una tarea larga puede arruinar el resultado sin que nadie lo note.
En SimianX construimos y operamos sistemas multiagente todos los días. Cuatro agentes analizan en vivo una acción o un par de criptomonedas en nuestra sala de análisis en vivo, un comité de ocho agentes debate sobre una sola acción o moneda en la investigación a fondo, y una clasificación cripto pública puntúa a más de 30 modelos de IA en cada operación que cierran. Esta guía usa ese sistema como ejemplo práctico, junto con descripciones neutrales de los productos de agentes y de la investigación que definen el campo.
Puntos clave
- Un agente es un modelo más herramientas, memoria y un bucle que el propio modelo controla. Si cada paso está fijado en el código, es un flujo de trabajo, no un agente.
- Los sistemas multiagente ayudan cuando una tarea se divide en partes independientes, o cuando necesita puntos de vista que deben formarse antes de que nadie compare notas. También consumen muchísimos más tokens.
- La mayoría de los fallos de los agentes provienen de errores que se acumulan, herramientas poco fiables, una evaluación débil y costes descontrolados, no de que el modelo "no sea lo bastante inteligente".
- Juzga un agente por sus resultados repetidos en tus propias tareas: tasa de éxito, coherencia entre ejecuciones, coste por tarea terminada y un registro completo de lo que hizo.
¿Qué es un agente de IA? Una definición práctica
La idea es más antigua que los grandes modelos de lenguaje. El manual de referencia en inteligencia artificial, Artificial Intelligence: A Modern Approach de Stuart Russell y Peter Norvig, define un agente como cualquier cosa que percibe su entorno mediante sensores y actúa sobre ese entorno mediante actuadores. Un termostato cumple la definición. Un programa de ajedrez, también.
Lo que cambió después de 2022 es que un modelo de lenguaje puede ahora servir como núcleo de razonamiento. En lugar de seguir reglas escritas a mano, el modelo lee la situación en lenguaje natural, redacta un plan y elige qué herramienta llamar a continuación. La guía de Anthropic Building Effective Agents, citada con frecuencia, traza la línea que hoy usan la mayoría de los ingenieros: los flujos de trabajo son sistemas en los que los modelos y las herramientas se orquestan mediante rutas de código predefinidas, mientras que los agentes son sistemas en los que el modelo dirige de forma dinámica su propio proceso y el uso de herramientas.
En la práctica, un agente de IA moderno tiene cinco partes:
- Un objetivo. "Arregla esta prueba que falla", "resume qué movió a Nvidia hoy", "decide si abrir una posición en esta vela de 15 minutos".
- Un modelo que razona sobre el objetivo y el estado actual.
- Herramientas a las que puede llamar: búsqueda, un intérprete de código, una consulta a una base de datos, una API de datos de mercado, un navegador.
- Memoria o estado: lo que ya ha intentado, lo que devolvieron las herramientas y lo que todavía se desconoce.
- Un bucle con una regla de parada: sigue trabajando hasta que se cumple el objetivo, se agota un presupuesto o una persona tiene que aprobar el siguiente paso.
Quita el bucle y tendrás un chatbot. Fija cada paso de antemano y tendrás un flujo de trabajo. El bucle que controla el propio modelo es lo que lo convierte en un agente.
Agente de IA vs chatbot vs flujo de trabajo
Los tres términos se confunden constantemente, en parte porque "agente" vende. Gartner tiene un nombre para la práctica de rebautizar chatbots y automatización robótica de procesos como agentes, el "lavado de agentes" (agent washing), y estimó en junio de 2025 que solo unos 130 de los miles de proveedores que venden IA agéntica ofrecen algo real. Esta tabla es la forma más rápida de distinguir los tres.
| Chatbot | Flujo de trabajo (canalización) | Agente de IA | |
|---|---|---|---|
| Quién decide el siguiente paso | El usuario, mensaje a mensaje | El desarrollador, en código escrito de antemano | El modelo, en tiempo de ejecución |
| Usa herramientas | A veces, una llamada por respuesta | Sí, en un orden fijo | Sí, elegidas y repetidas según haga falta |
| Sigue trabajando sin una nueva instrucción | No | Sí, por una ruta fija | Sí, hasta alcanzar el objetivo o agotar un presupuesto |
| Resultado típico | Una respuesta | Un resultado predecible de un proceso conocido | Una tarea terminada: un cambio de código, un informe, una decisión |
| Coste y velocidad | Barato, segundos | De barato a moderado, predecible | Más alto y variable, de segundos a horas |
| Fallo típico | Una respuesta errónea que se ve | Se rompe ante entradas que nadie previó | Se desvía, entra en bucle o construye sobre un pequeño error inicial |
| Ideal para | Preguntas y borradores | Procesos repetibles con pasos conocidos | Tareas abiertas cuyo camino no se puede guionizar |
Una regla útil de la misma guía de Anthropic: empieza por la opción más sencilla que funcione y añade autonomía solo cuando mejore claramente los resultados. Muchas tareas que se comercializan como agentes son mejores, más baratas y más seguras como flujos de trabajo.
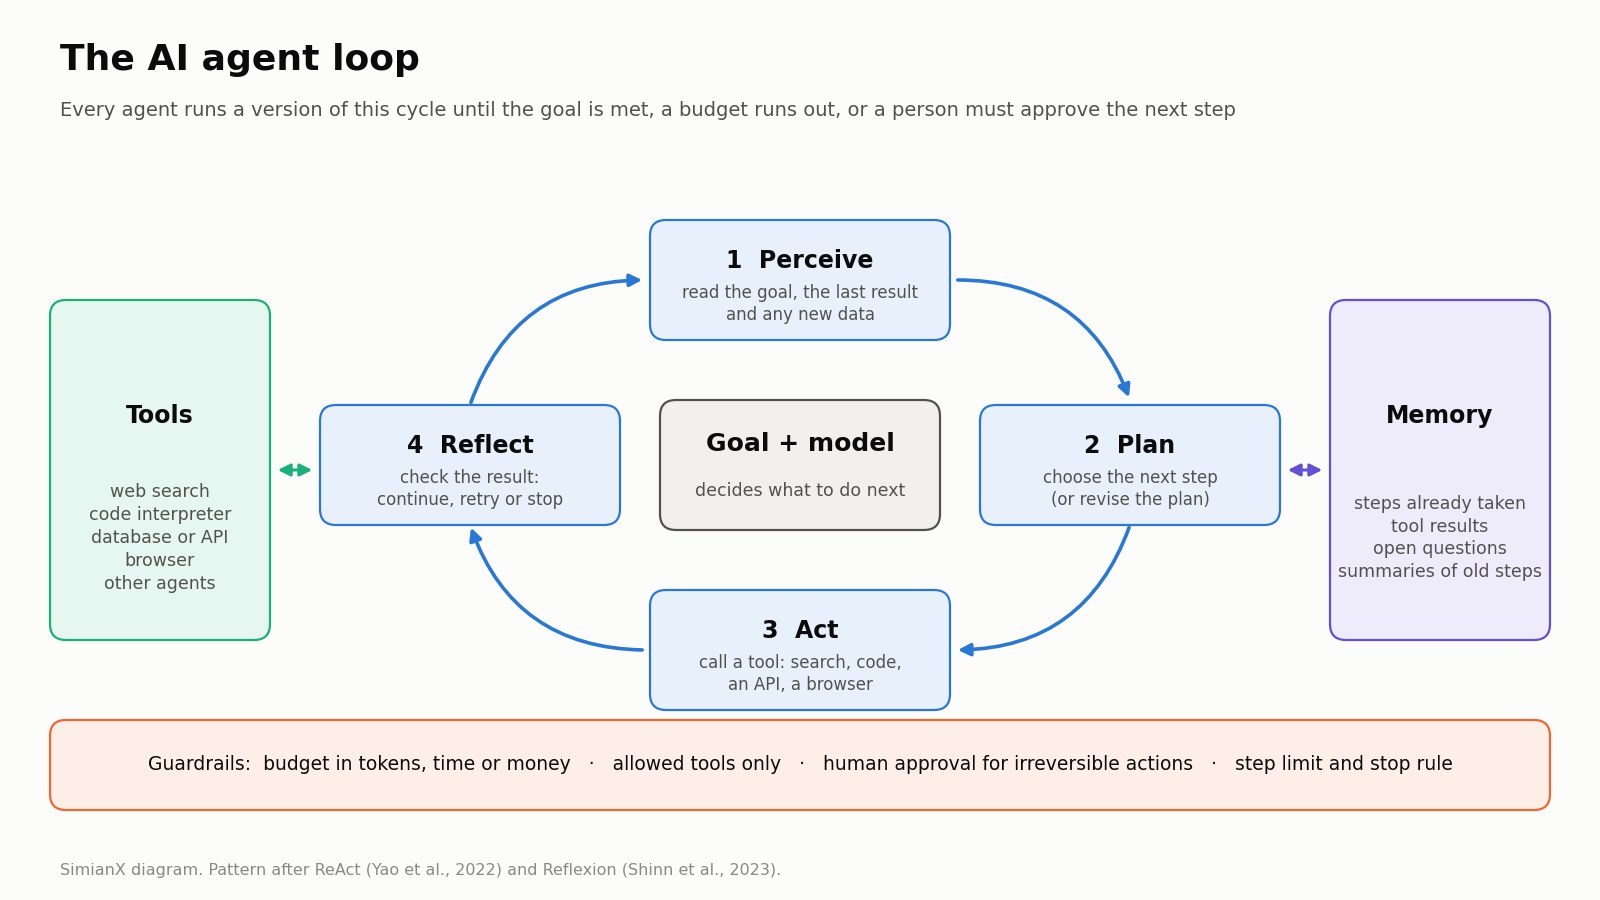
Cómo funcionan los agentes de IA: el bucle percibir, planificar, actuar, reflexionar
Todo agente, se venda con la marca que se venda, ejecuta alguna versión de un mismo bucle.
Percibir
El agente reúne su situación actual: el objetivo del usuario, el resultado de su última acción, el contenido de un archivo, una página de resultados de búsqueda, la última vela de un gráfico. Todo lo que sabe tiene que caber en la ventana de contexto del modelo, así que los buenos agentes son selectivos. Resumen los pasos antiguos, conservan los datos en bruto que volverán a necesitar y descartan el resto.
Planificar
El modelo decide qué hacer a continuación. A veces es un plan completo escrito de entrada; más a menudo es solo el siguiente paso, elegido tras ver el último resultado. El influyente artículo ReAct (Yao et al., 2022) demostró que intercalar breves notas de razonamiento con acciones permite a un modelo reunir información y corregir el rumbo, y superó a las referencias que solo actuaban o solo razonaban en varias tareas. La mayoría de los marcos de agentes siguen ese patrón.
Actuar
El agente llama a una herramienta. Los modelos modernos emiten una petición estructurada, por ejemplo "busca X" o "ejecuta esta consulta con estos parámetros", y el software que los rodea la ejecuta y devuelve el resultado. Ya existen estándares para esta fontanería. El Model Context Protocol (MCP), presentado por Anthropic en noviembre de 2024 y donado a la Agentic AI Foundation de la Linux Foundation en diciembre de 2025, define cómo se conecta un agente a herramientas y fuentes de datos. El protocolo Agent2Agent (A2A) de Google, también proyecto de la Linux Foundation, cubre cómo se comunican entre sí agentes creados por distintos proveedores.
Reflexionar
El agente compara el resultado con el objetivo. ¿Pasó la prueba? ¿Coincide la cifra con una segunda fuente? ¿Sigue teniendo sentido el plan? Investigaciones como Reflexion (Shinn et al., 2023) mostraron que dejar que un agente anote qué salió mal y lo intente de nuevo mejora los resultados en tareas de programación y razonamiento. La reflexión es también el momento en que un agente debe decidir detenerse: porque se cumplió el objetivo, porque está atascado o porque una persona tiene que aprobar algo arriesgado.
Alrededor del bucle están las salvaguardas: un presupuesto en tokens, tiempo o dinero, una lista de herramientas que el agente puede usar y los puntos en los que una persona debe dar el visto bueno. En el contexto de las operaciones en los mercados eso significa, como mínimo, un límite al tamaño de la posición, un stop de pérdidas en cada operación y una línea clara entre las operaciones simuladas y el dinero real.
Agente único vs sistemas multiagente
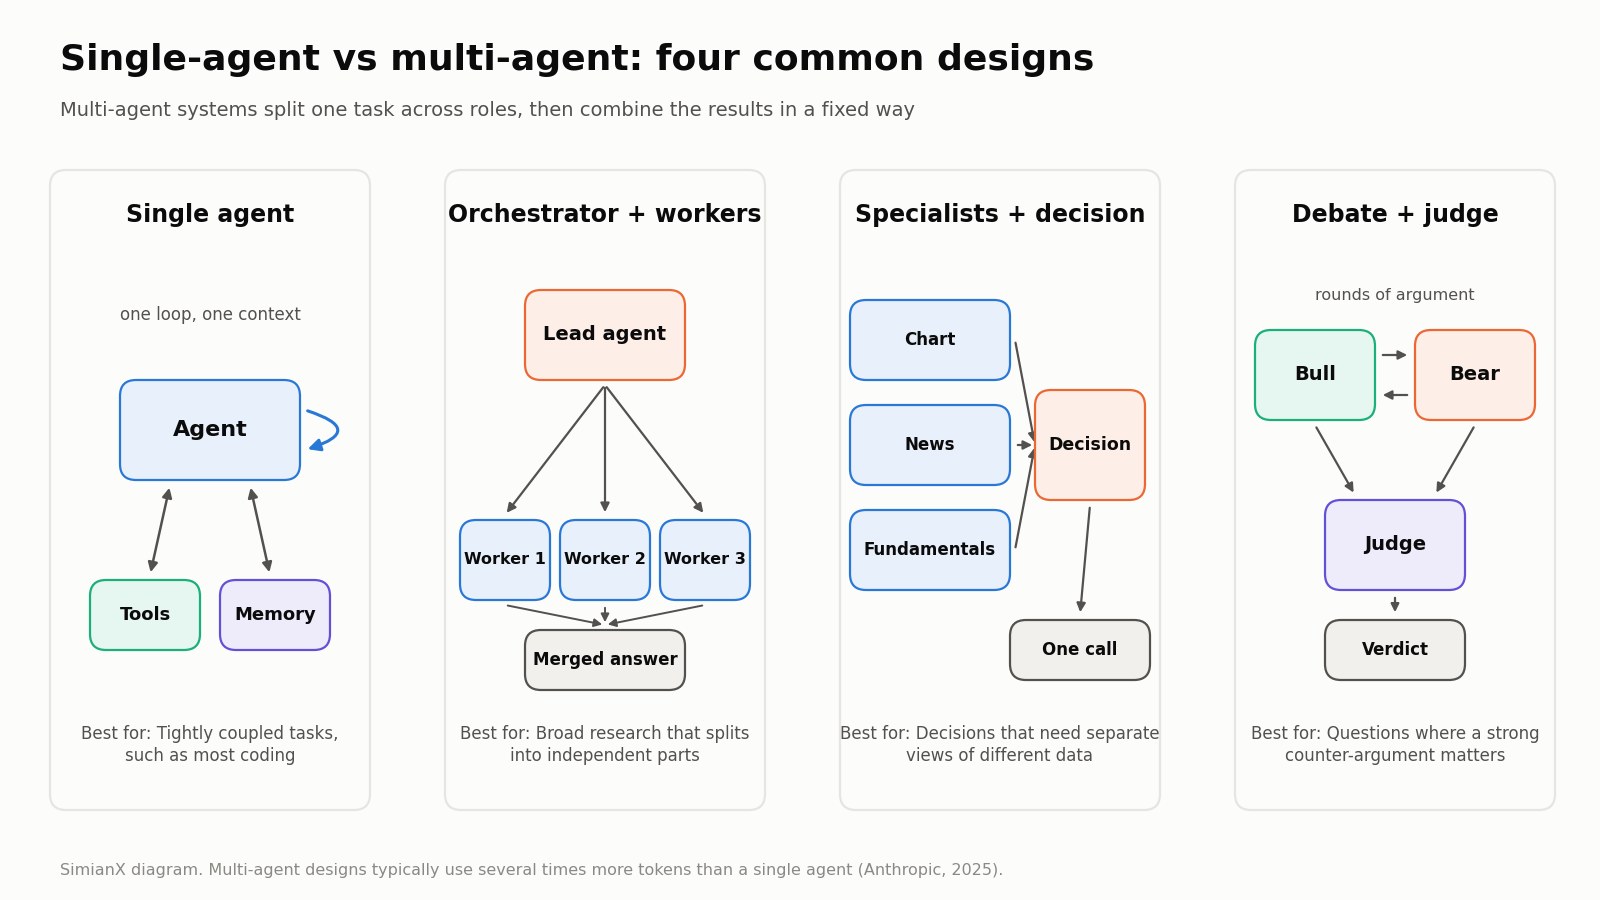
Un agente único ejecuta el bucle en solitario. Un sistema multiagente asigna distintas partes del trabajo a distintos agentes, cada uno con sus propias instrucciones, herramientas y contexto, y después combina lo que producen. Hay cuatro diseños habituales:
- Orquestador y trabajadores. Un agente principal divide la tarea en partes, envía cada parte a un agente trabajador y fusiona los resultados. Los asistentes de investigación suelen funcionar así.
- Especialistas que alimentan a quien decide. Cada agente cubre un ámbito, como los gráficos, las noticias o los estados financieros, y un agente final sopesa sus opiniones. Es la estructura de nuestra sala de análisis en vivo, descrita más abajo.
- Debate. Los agentes defienden posturas opuestas antes de que un juez decida. Du et al. (2023) comprobaron que varias instancias de un modelo debatiendo durante unas pocas rondas mejoraban la exactitud factual y el razonamiento frente a un único modelo respondiendo solo.
- Votación o conjuntos. Varios agentes, o varios modelos, responden a la misma pregunta de forma independiente y las respuestas se agregan.
La evidencia a favor de los sistemas multiagente es real, pero condicional. Anthropic informó en junio de 2025 de que, en su sistema de investigación multiagente, un agente principal Claude Opus 4 que dirigía subagentes Claude Sonnet 4 superó en un 90,2% a un único agente Claude Opus 4 en su evaluación interna de investigación. El mismo informe es franco sobre el precio: los agentes usaron unas cuatro veces más tokens que un chat, y los sistemas multiagente unas quince veces más. También señala que la mayoría de las tareas de programación tienen menos partes realmente paralelas que la investigación, lo que las hace menos adecuadas.
| Agente único | Sistema multiagente | |
|---|---|---|
| Configuración y depuración | Más sencilla: una instrucción, un registro | Más difícil: varias instrucciones, traspasos y un registro combinado |
| Coste por tarea | Menor | A menudo varias veces mayor |
| Velocidad | Secuencial | Las partes en paralelo terminan antes; la coordinación añade carga |
| Amplitud | Limitada por una sola ventana de contexto | Cada agente recibe un contexto nuevo para su parte |
| Detección de errores | Debe detectar sus propios errores | Los agentes pueden cuestionarse entre sí y el desacuerdo es visible |
| Fallo típico | Visión de túnel sobre una primera idea equivocada | Malentendidos, trabajo duplicado o una fusión final débil |
| Ideal para | Tareas muy acopladas, como la mayor parte de la programación | Investigación amplia y decisiones que necesitan puntos de vista independientes |
Nuestra regla práctica: usa más de un agente cuando quieras opiniones que se formen de manera independiente antes de que nadie compare notas. La lectura de un gráfico no debería teñirse con el titular que acaba de leer el agente de noticias, y el argumento bajista debería escribirlo un agente cuyo único trabajo sea encontrar los problemas.
Dónde fallan los agentes de IA
Los agentes fallan de formas predecibles, y cualquier guía honesta tiene que dedicarles tiempo. Un estudio de 2025, Why Do Multi-Agent LLM Systems Fail? (Cemri et al.), anotó más de 1.600 registros de ejecución de siete marcos multiagente populares y encontró 14 modos de fallo distintos agrupados en tres categorías: problemas en el diseño del sistema, desalineación entre agentes y una verificación débil del resultado final.
Errores que se acumulan
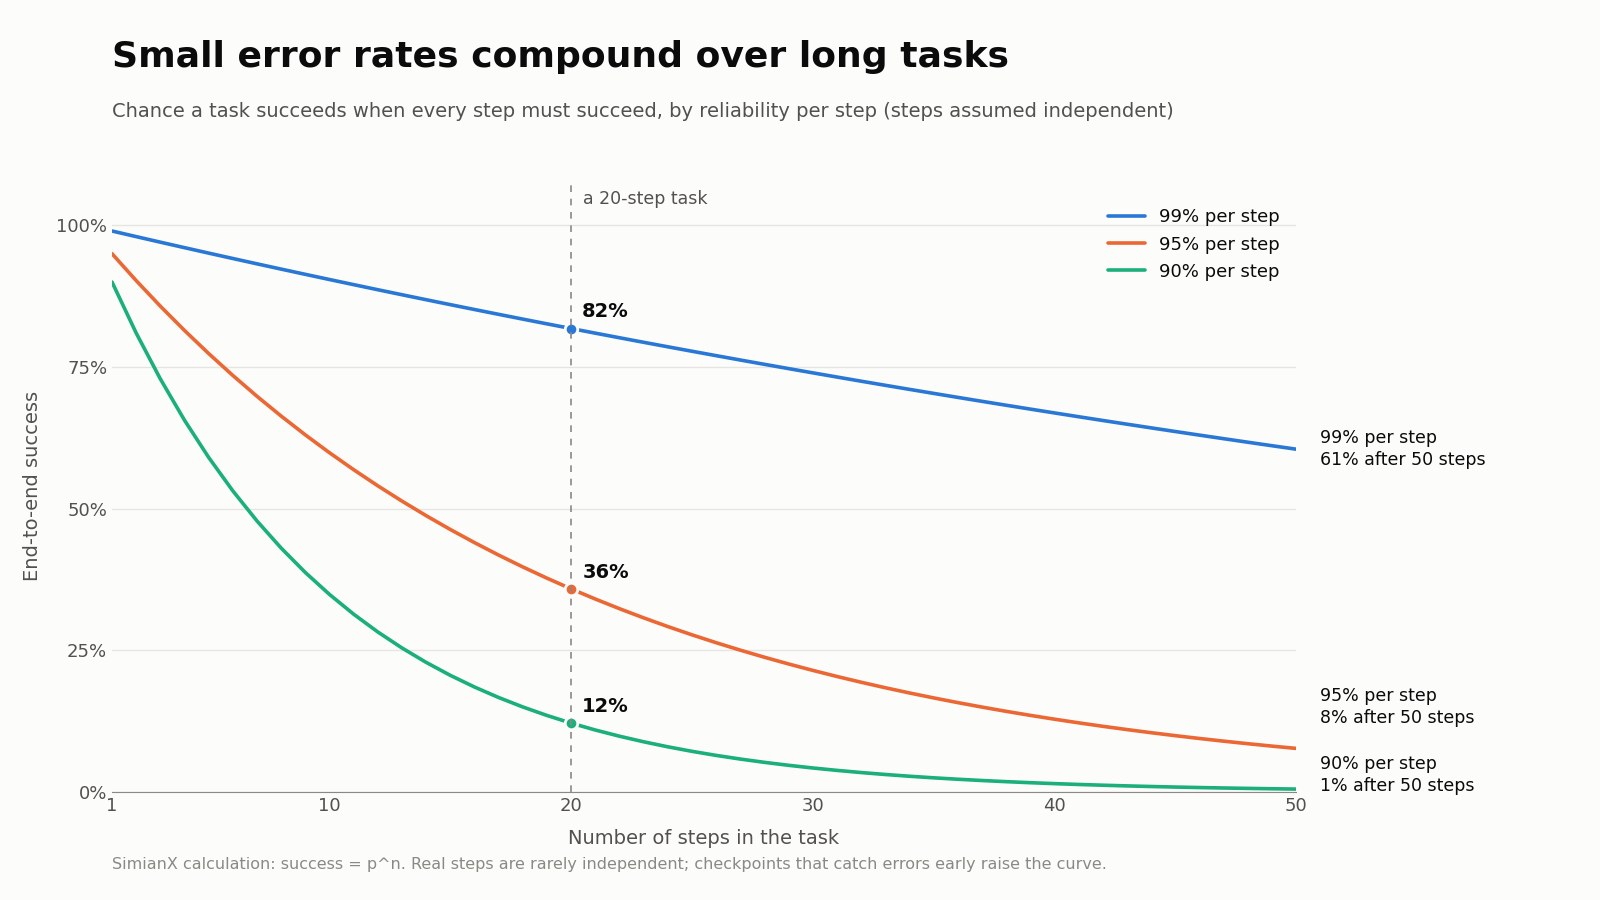
Las tareas largas multiplican las pequeñas tasas de error. Si cada paso de una tarea sale bien el 95% de las veces y los pasos son independientes, una tarea de 20 pasos solo sale bien alrededor del 36% de las veces (0,95 elevado a 20). Con un 99% por paso, la misma tarea sale bien cerca del 82% de las veces. Por eso la fiabilidad de cada paso importa más que la brillantez en un paso concreto, y por eso los agentes necesitan puntos de control que detecten un error antes de que el siguiente paso se construya sobre él.
Alucinaciones y herramientas mal interpretadas
Un modelo puede inventarse un dato, malinterpretar el resultado de una herramienta o arrastrar una cifra desactualizada como si fuera actual. Los agentes lo empeoran, porque un valor inventado puede convertirse en la entrada de la siguiente acción. La solución es estructural: pasar los datos en bruto en lugar de paráfrasis, comprobar las cifras clave con código en vez de fiarse de la aritmética del modelo y exigir una fuente para cada afirmación importante.
Coste
Cada vuelta por el bucle es otra llamada al modelo, y el contexto crece a medida que avanza la tarea. Una tarea que parece barata en una demostración puede costar muchas veces más en producción cuando el agente reintenta, reflexiona y vuelve a leer. Fija presupuestos estrictos por tarea y mide el coste de una tarea terminada, no el de una sola llamada.
Latencia
Los agentes cambian velocidad por calidad. Una respuesta de chat tarda segundos; un agente de investigación puede tardar minutos, y un agente de programación que trabaja en un cambio grande puede estar en marcha mucho más tiempo. Nuestro propio comité de investigación a fondo de ocho agentes necesita varios minutos para una sola acción, porque los agentes investigan, debaten y votan antes de que se escriba nada.
Evaluación
Los agentes no son deterministas: la misma tarea puede salir bien en una ejecución y fallar en la siguiente. El banco de pruebas τ-bench introdujo una métrica llamada pass^k, la probabilidad de que un agente acierte en los k intentos de la misma tarea, y comprobó que incluso los agentes con llamada a funciones más potentes de la época acertaban en los ocho intentos menos del 25% de las veces en su ámbito de comercio minorista. Una sola ejecución impresionante dice poco. Los bancos de pruebas públicos como SWE-bench para programación y OSWorld para el uso del ordenador son útiles, pero no son tus tareas.
Seguridad y permisos
Un agente que lee páginas web o correos electrónicos puede ser manipulado mediante instrucciones ocultas en ellos, un ataque conocido como inyección de instrucciones (prompt injection), que encabeza la lista OWASP de riesgos para aplicaciones con LLM. Da a los agentes el mínimo acceso que necesiten, mantén los secretos fuera de su contexto y exige aprobación antes de cualquier acción irreversible, como mover dinero.
Estos problemas tienen consecuencias empresariales. En el mismo comunicado de junio de 2025, Gartner predijo que más del 40% de los proyectos de IA agéntica se cancelarán antes de finales de 2027, por costes crecientes, un valor de negocio poco claro y controles de riesgo inadecuados.
Un ejemplo práctico: cómo reparten los agentes de SimianX una decisión de inversión
Operar en los mercados es una prueba exigente para los agentes. Los datos llegan de forma continua, la respuesta correcta se desconoce en el momento de decidir y, tarde o temprano, el mercado puntúa cada decisión. Así es como nuestro sistema divide el trabajo.
Análisis en vivo: tres especialistas y un agente de decisión
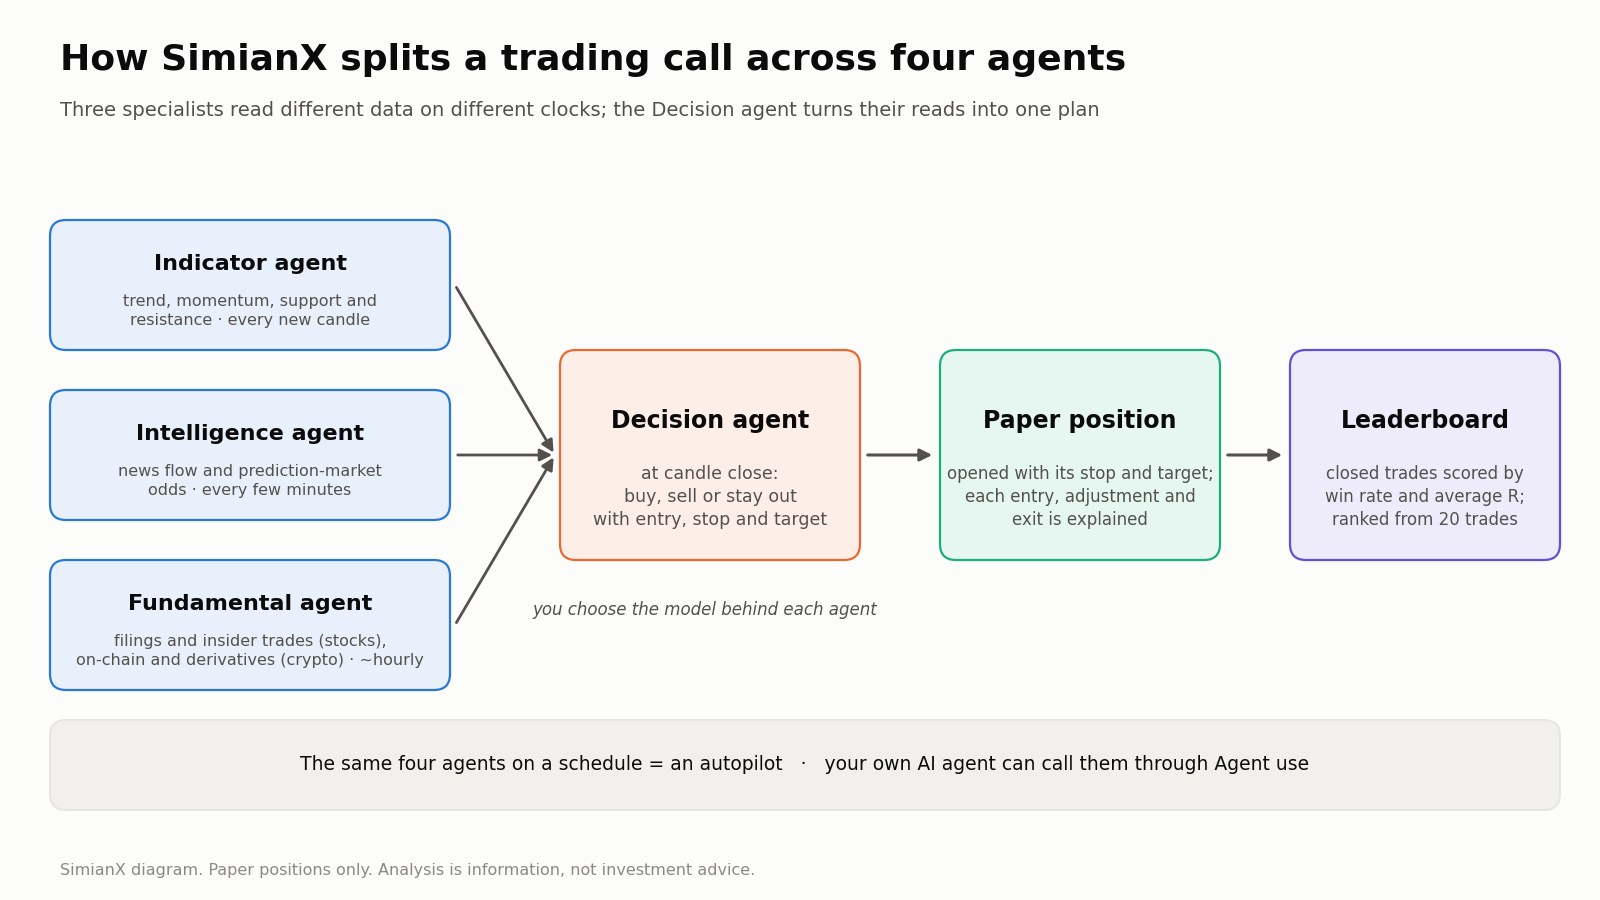
Cuando abres una acción estadounidense o un par de criptomonedas en la sala de análisis en vivo y eliges una temporalidad, cuatro agentes se ponen a trabajar. La cobertura abarca más de 13.000 acciones y ETF de EE. UU. y más de 4.000 pares de criptomonedas, desde velas de 1 minuto en adelante.
- El agente de Indicadores lee el gráfico: tendencia, impulso, soportes y resistencias. Se ejecuta con cada vela nueva.
- El agente de Inteligencia lee el flujo de noticias del símbolo y, cuando existen, las probabilidades de los mercados de predicción. Se actualiza cada pocos minutos.
- El agente Fundamental lee los informes regulatorios y las operaciones de directivos en el caso de una acción, o los datos en cadena (on-chain) y de derivados en el caso de una moneda. Estos cambian despacio, así que por defecto se actualiza aproximadamente una vez por hora.
- El agente de Decisión sopesa a los otros tres cuando cierra una vela y dice qué hacer: comprar, vender o quedarse fuera, con una entrada, un stop y un objetivo.
Cuando aparece una oportunidad, el sistema abre una posición simulada con ese stop y ese objetivo, y después explica cada entrada, ajuste y salida a medida que se desarrolla la operación. Tú eliges el modelo que hay detrás de cada agente. Los mismos cuatro agentes también pueden funcionar de forma programada como piloto automático, y el flujo de noticias puntuadas del que se nutre el agente de Inteligencia es el mismo que alimenta Pulso del Mercado.
¿Por qué dividir el trabajo así? Los tres especialistas funcionan a ritmos distintos, así que separarlos permite que la lectura del gráfico se actualice con cada vela sin pagar por volver a leer un informe que no ha cambiado. Mantiene el contexto de cada agente pequeño y centrado. Y hace visible el desacuerdo: cuando el gráfico dice "ruptura" y el agente de noticias advierte de que mañana se publican resultados, el agente de Decisión tiene que resolver el conflicto en lugar de promediarlo.
Investigación a fondo: un comité de ocho agentes
Para una visión más pausada y profunda de una acción o una moneda, la investigación a fondo sienta a un comité de ocho. Cuatro analistas investigan en paralelo: los fundamentales, el gráfico, las noticias y un cuarto puesto que aporta una lectura del momento oportuno para las acciones y un analista de derivados para las criptomonedas. Después, un investigador alcista y un investigador bajista construyen el argumento más sólido de cada lado. Un director de investigación modera un debate sobre los mayores desacuerdos, cada miembro reafirma su postura en una votación final y un gestor de riesgos redacta la decisión con niveles de precio verificados. Nuestro recorrido por el comité renovado sigue una ejecución completa pantalla a pantalla.
Es el patrón de debate de la literatura científica, llevado a producción. El bajista existe porque un comité de analistas complacientes es, en realidad, una sola opinión repetida cuatro veces.
Cómo mide los resultados la clasificación
Un agente que toma decisiones de inversión tiene que ser evaluado por los resultados, no por lo convincente que suene su razonamiento. La clasificación cripto puntúa a los modelos de IA que están detrás de estas posiciones simuladas, y solo cuentan las operaciones cerradas, liquidadas a precios reales de mercado. Actualmente cubre más de 30 modelos de varios laboratorios de IA y mide a cada uno de dos maneras:
- Tasa de acierto: la proporción de operaciones cerradas que terminaron con beneficio.
- R medio: el beneficio por operación medido en unidades del riesgo asumido al entrar. Una posición larga en 100 con el stop en 98 arriesga 2 por unidad; cerrar en 104 es +2R, y que salte el stop completo es −1R.
Un modelo solo entra en la clasificación tras 20 operaciones cerradas con los filtros actuales, de modo que un puñado de operaciones afortunadas no puede llevarlo a lo más alto, y se puede filtrar por periodo, temporalidad y dirección. Leer ambas cifras juntas importa: una tasa de acierto alta con un R bajo puede ocultar unas pocas pérdidas grandes, mientras que una tasa de acierto modesta con un R alto puede significar ganancias menos frecuentes pero mayores. Comparamos los modelos de la clasificación en ¿Qué Modelo de IA Opera Mejor? 30 LLMs por P&L Real y en nuestra guía GPT vs Gemini vs Claude.
Conectar tu propio agente
El mismo sistema está abierto a agentes externos. La página Uso con agentes explica cómo dar a Claude Code, Codex, Cursor u otro agente la skill de SimianX y una clave de API, para que pueda iniciar un análisis en vivo con cuatro agentes sobre cualquier símbolo, seguir el flujo de noticias puntuadas o lanzar una investigación a fondo. Tu agente recibe su propia clave con el presupuesto que tú fijes. Nunca obtiene tu acceso al sitio web, y cada posición que gestiona es una posición simulada.
Aviso de riesgo: Todo lo anterior describe software que produce análisis y operaciones simuladas. Es información, no asesoramiento de inversión. Los modelos de IA se equivocan, los resultados de la clasificación describen operaciones pasadas y no predicen rentabilidades futuras, y ningún modelo ni comité elimina el riesgo de mercado. Nunca operes con dinero que no puedas permitirte perder basándote en la recomendación de una IA.
Tipos de agentes de IA en 2026
La clasificación de los manuales
Los manuales clasifican a los agentes según cómo deciden, y esas categorías siguen ayudando a entender los sistemas modernos:
| Tipo | Cómo decide | Ejemplo |
|---|---|---|
| Agente reactivo simple | Reglas fijas de condición y acción sobre la entrada actual | Un termostato; una alerta de precio |
| Agente reactivo basado en modelos | Reglas más una representación interna de lo que no puede observar directamente | Un filtro de correo no deseado que registra el historial de un remitente |
| Agente basado en objetivos | Busca acciones que alcancen un objetivo fijado | Un planificador de rutas |
| Agente basado en utilidad | Elige la acción con el mejor equilibrio esperado | Un agente de inversión que sopesa beneficio frente a riesgo |
| Agente que aprende | Mejora su comportamiento a partir de la retroalimentación | Un sistema de recomendaciones que se ajusta con los clics |
Los agentes basados en modelos de lenguaje mezclan estos tipos. Están basados en objetivos en lo que persiguen, en la utilidad cuando sopesan opciones, y aprenden dentro de una tarea al reflexionar sobre los resultados.
Las categorías de productos
Agrupados por lo que realmente hacen, los agentes que la gente usa en 2026 se dividen en cinco grandes categorías. Los productos citados son ejemplos, no recomendaciones, y sus capacidades cambian rápidamente.
Agentes de programación. Un agente de IA para programar lee un repositorio de código, edita archivos, ejecuta las pruebas y propone un cambio, a menudo como solicitud de incorporación de cambios (pull request). Algunos ejemplos son Claude Code de Anthropic, Codex de OpenAI, el agente de programación de GitHub Copilot, Cursor y Devin de Cognition. Suelen compararse en SWE-bench, que les pide resolver incidencias reales de proyectos de código abierto. Una investigación de METR sugiere que la duración de las tareas de software que los agentes punteros pueden completar con un 50% de fiabilidad se ha duplicado aproximadamente cada siete meses desde 2019.
Agentes de investigación. Buscan en la web o en una colección de documentos, leen muchas fuentes y redactan un informe con citas. Google lanzó Gemini Deep Research en diciembre de 2024, y OpenAI lanzó deep research en ChatGPT en febrero de 2025. Su punto débil es la calidad de las fuentes: un informe bien escrito puede apoyarse en una fuente deficiente.
Agentes de navegador y de uso del ordenador. Manejan un navegador o un escritorio completo mirando la pantalla, haciendo clic y escribiendo. Anthropic lanzó computer use en octubre de 2024. Operator, de OpenAI, lanzado en enero de 2025, se integró en ChatGPT agent en julio de 2025, y Google cuenta con Project Mariner. Son más lentos y menos fiables que los agentes que trabajan mediante API, por lo que suelen reservarse para sitios que no ofrecen ninguna API.
Agentes de propósito general. Reciben un objetivo amplio y combinan navegación, código y archivos para completarlo. Manus, lanzado en marzo de 2025, es el ejemplo más conocido. Meta acordó adquirir la empresa en diciembre de 2025; en abril de 2026, la Comisión Nacional de Desarrollo y Reforma de China ordenó deshacer la operación.
Agentes de inversión y análisis de mercado. Leen datos de mercado, noticias e informes regulatorios, y elaboran planes de operación o gestionan posiciones. Marcos académicos como TradingAgents (Xiao et al., 2024) modelan una firma de inversión con funciones de analista, investigador, operador y gestión de riesgos, y productos como SimianX ejecutan comités similares con datos en vivo. Los mercados son adversos y ruidosos, así que esta es la categoría en la que más importa un historial público, operación por operación.
Cómo evaluar un agente de IA: lista de comprobación
Tanto si eliges un agente de programación como una herramienta de investigación o un asistente de inversión, las mismas preguntas separan a los agentes útiles de las demostraciones.
| Pregunta | Qué es buena señal | Señal de alarma |
|---|---|---|
| ¿Es realmente un agente? | Elige sus propios pasos y herramientas | Un guion fijo con la etiqueta "agente" |
| ¿Funciona en tus tareas? | Probado con 10–20 tareas reales de tu propio trabajo | Solo demostraciones del proveedor y puntuaciones de bancos de pruebas |
| ¿Es coherente? | Resultados similares cuando la misma tarea se ejecuta varias veces | Una ejecución brillante y luego fallos |
| ¿Cuánto cuesta una tarea terminada? | El coste por tarea completada se mide y se limita | Solo se citan precios por llamada |
| ¿Cuánto tarda? | La velocidad se ajusta al trabajo | Minutos de espera para una respuesta de una línea |
| ¿Puedes ver lo que hizo? | Un registro completo de pasos, llamadas a herramientas y fuentes | Una respuesta final sin rastro |
| ¿A qué puede acceder? | Acceso mínimo imprescindible, entorno aislado o modo simulado, aprobación para acciones irreversibles | Credenciales amplias y ningún paso de aprobación |
| ¿Cómo se detiene? | Presupuestos, límites de pasos y una regla de parada clara | Sigue en bucle hasta que alguien se da cuenta |
| ¿Qué tan recientes son sus datos? | Una marca de tiempo en cada dato | Cifras desactualizadas presentadas como actuales |
| Para agentes de inversión: ¿cuál es su historial? | Operaciones cerradas a precios reales, tamaño de la muestra visible, tanto tasa de acierto como rentabilidad ajustada al riesgo | Solo pruebas retrospectivas, o una tasa de acierto sin número de operaciones |
Preguntas frecuentes
¿Qué es un agente de IA, en pocas palabras?
Un agente de IA es un programa que usa un modelo de inteligencia artificial para alcanzar un objetivo por sí mismo. Observa la situación, decide un paso, usa una herramienta como la búsqueda o el código para llevarlo a cabo, comprueba el resultado y repite hasta terminar el trabajo o hasta que necesita a una persona.
¿Qué diferencia hay entre un agente de IA y un chatbot?
Un chatbot responde a un mensaje cada vez y luego te espera. Un agente sigue trabajando hacia un objetivo a lo largo de muchos pasos, elige qué herramientas usar y puede terminar una tarea, como corregir código o redactar un informe, sin una nueva instrucción para cada paso.
¿Qué es un sistema multiagente?
Un sistema multiagente es un grupo de agentes de IA con funciones distintas que trabajan en una misma tarea. Pueden repartirse el trabajo, debatir posturas opuestas o votar, y un agente final o una regla fija combina su resultado. En tareas amplias suelen superar a un agente único, con un coste mucho mayor.
¿Qué es un agente de IA para programar?
Un agente de IA para programar trabaja dentro de un proyecto de software: lee el código, edita archivos, ejecuta pruebas y propone cambios. Algunos ejemplos son Claude Code, OpenAI Codex, el agente de programación de GitHub Copilot, Cursor y Devin.
¿Qué es Manus AI?
Manus es un agente de IA de propósito general, lanzado en marzo de 2025, que recibe un objetivo amplio y usa navegación, código y archivos para completarlo. Meta acordó comprar la empresa en diciembre de 2025, y en abril de 2026 los reguladores chinos ordenaron deshacer la operación.
¿Pueden los agentes de IA operar con acciones o criptomonedas?
Pueden analizar mercados y gestionar posiciones, y algunos productos, entre ellos SimianX, permiten a los agentes llevar posiciones simuladas con stops y objetivos. Los resultados varían mucho según el modelo y el mercado, así que juzga cualquier agente de inversión por su historial de operaciones cerradas y trata lo que produce como información, no como asesoramiento.
¿Cómo puedo conectar mi propio agente de IA al análisis de mercado en vivo?
La página Uso con agentes de SimianX explica cómo instalar la skill de SimianX en Claude Code, Codex, Cursor y otros agentes. Tu agente recibe su propia clave de API con un presupuesto que tú controlas, y puede iniciar análisis multiagente en vivo, seguir el flujo de noticias puntuadas y lanzar investigaciones a fondo.
Lectura Relacionada
- Análisis de acciones con IA: un comité de 8 agentes responde
- 8 Analistas IA vs 1: +37% Acierto, −41% Riesgo Real
- ¿Qué Modelo de IA Opera Mejor? 30 LLMs por P&L Real
- 30+ Modelos IA, 6 Proveedores: Ranking Cripto Live
- GPT vs Gemini vs Claude: Análisis de Acciones con IA 2026
- IA Multi-Agente vs ChatGPT para NVDA: Comparativa 2026
- Cómo los autopilotos de IA operan cripto 24/7 (Guía 2026)
- Análisis Bursátil en Vivo: Agentes IA Cubren Acciones US
- Invertir con Agentic AI: Guía Inicial para Mercados
Referencias
- Russell y Norvig — Artificial Intelligence: A Modern Approach
- Anthropic — Building Effective Agents (diciembre de 2024)
- Anthropic — How we built our multi-agent research system (junio de 2025)
- Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du et al. — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri et al. — Why Do Multi-Agent LLM Systems Fail?
- Yao et al. — τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao et al. — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — documentación oficial
- Protocolo Agent2Agent (A2A) — sitio oficial
- Gartner — Más del 40% de los proyectos de IA agéntica se cancelarán antes de finales de 2027 (junio de 2025)
- TechCrunch — China bloquea la compra de Manus por Meta por 2.000 millones de dólares (abril de 2026)
- IBM — ¿Qué son los agentes de IA?
- OWASP — Top 10 de riesgos para aplicaciones con grandes modelos de lenguaje