AI एजेंट की पूरी व्याख्या: चक्र में चलते एक मॉडल से विशेषज्ञों की टीम तक
AI एजेंट एक सॉफ़्टवेयर सिस्टम है जो किसी AI मॉडल की मदद से खुद एक लक्ष्य की ओर काम करता है: वह स्थिति को पढ़ता है, अगला कदम तय करता है, वेब खोज, कोड या API जैसे टूल के ज़रिए कार्रवाई करता है, और आगे बढ़ने से पहले नतीजे की जाँच करता है। मल्टी-एजेंट सिस्टम यही काम कई विशेषज्ञ एजेंटों में बाँट देता है, जो अपनी खोज एक-दूसरे से साझा करते हैं, जहाँ असहमति हो वहाँ एक-दूसरे को चुनौती देते हैं, और मिला-जुला जवाब उस एक एजेंट को सौंपते हैं जो अंतिम फ़ैसला करता है।
दो वाक्यों की यह परिभाषा 2026 में इस शब्द के ज़्यादातर अर्थों को समेट लेती है, पूरे कोड भंडार में गड़बड़ियाँ ठीक करने वाले कोडिंग सहायकों से लेकर रिपोर्ट लिखने से पहले सैकड़ों पन्ने पढ़ने वाले शोध टूल तक। लेकिन यह मुश्किल हिस्सों को छिपा भी देती है। एजेंट एक चैट जवाब से ज़्यादा महँगे होते हैं, ज़्यादा समय लेते हैं, और लंबे काम की शुरुआत में हुई एक छोटी-सी ग़लती चुपचाप पूरे नतीजे को बिगाड़ सकती है।
SimianX में हम हर दिन मल्टी-एजेंट सिस्टम बनाते और चलाते हैं। हमारे लाइव विश्लेषण कक्ष में चार एजेंट किसी शेयर या क्रिप्टो जोड़ी का लाइव विश्लेषण करते हैं, गहन शोध में आठ एजेंटों की एक समिति किसी एक शेयर या कॉइन पर बहस करती है, और सार्वजनिक क्रिप्टो लीडरबोर्ड 30 से ज़्यादा AI मॉडलों को उनके हर बंद हुए सौदे के आधार पर अंक देता है। यह गाइड उसी सिस्टम को एक व्यावहारिक उदाहरण की तरह इस्तेमाल करती है, और साथ ही उन एजेंट उत्पादों और शोध का तटस्थ विवरण भी देती है जो इस क्षेत्र को परिभाषित करते हैं।
मुख्य बातें
- एजेंट यानी मॉडल के साथ टूल, मेमोरी और एक ऐसा चक्र जिसे मॉडल खुद नियंत्रित करता है। अगर हर कदम कोड में पहले से तय है, तो वह एजेंट नहीं, वर्कफ़्लो है।
- मल्टी-एजेंट सिस्टम तब काम आते हैं जब कोई काम स्वतंत्र हिस्सों में बँट सके, या जब ऐसे दृष्टिकोण चाहिए जो किसी के आपस में मिलान करने से पहले अपने-आप बनें। लेकिन ये कहीं ज़्यादा टोकन खर्च करते हैं।
- एजेंट की ज़्यादातर विफलताएँ चक्रवृद्धि ग़लतियों, अविश्वसनीय टूल, कमज़ोर मूल्यांकन और बेकाबू लागत से आती हैं, इस वजह से नहीं कि मॉडल "पर्याप्त समझदार नहीं" है।
- किसी एजेंट को अपने ही कामों पर बार-बार मिले नतीजों से परखें: सफलता दर, अलग-अलग दौर में एकरूपता, हर पूरे हुए काम की लागत, और उसने क्या-क्या किया इसका पूरा ब्योरा।
AI एजेंट क्या है? एक व्यावहारिक परिभाषा
यह विचार बड़े भाषा मॉडलों से पुराना है। मानक AI पाठ्यपुस्तक, स्टुअर्ट रसेल और पीटर नॉरविग की आर्टिफ़िशियल इंटेलिजेंस: अ मॉडर्न अप्रोच (Artificial Intelligence: A Modern Approach), एजेंट को ऐसी किसी भी चीज़ के रूप में परिभाषित करती है जो सेंसर के ज़रिए अपने परिवेश को महसूस करती है और एक्चुएटर के ज़रिए उस परिवेश पर कार्य करती है। थर्मोस्टैट इसमें आता है। शतरंज का प्रोग्राम भी।
2022 के बाद जो बदला, वह यह कि अब एक भाषा मॉडल तर्क के केंद्र की भूमिका निभा सकता है। हाथ से लिखे नियमों का पालन करने के बजाय, मॉडल स्थिति को सरल भाषा में पढ़ता है, योजना लिखता है और चुनता है कि अगला कौन-सा टूल बुलाना है। Anthropic की व्यापक रूप से उद्धृत गाइड Building Effective Agents (प्रभावी एजेंट बनाना) वह रेखा खींचती है जिसे आज ज़्यादातर इंजीनियर इस्तेमाल करते हैं: वर्कफ़्लो ऐसे सिस्टम हैं जिनमें मॉडल और टूल पहले से तय कोड-मार्गों के ज़रिए संचालित होते हैं, जबकि एजेंट ऐसे सिस्टम हैं जिनमें मॉडल अपनी प्रक्रिया और टूल के उपयोग को काम के दौरान खुद दिशा देता है।
व्यवहार में, आधुनिक AI एजेंट के पाँच हिस्से होते हैं:
- एक लक्ष्य। "इस विफल हो रहे परीक्षण को ठीक करो", "आज Nvidia के शेयर को किस चीज़ ने हिलाया, उसका सारांश दो", "तय करो कि इस 15-मिनट की कैंडल पर पोज़िशन खोलनी है या नहीं"।
- एक मॉडल जो लक्ष्य और मौजूदा स्थिति पर तर्क करता है।
- टूल जिन्हें वह बुला सकता है: खोज, कोड चलाने वाला टूल, डेटाबेस से पूछताछ, बाज़ार-डेटा API, ब्राउज़र।
- मेमोरी या स्थिति: वह पहले क्या आज़मा चुका है, टूल ने क्या लौटाया, और क्या अब भी अज्ञात है।
- रुकने के नियम वाला चक्र: वह तब तक चलता रहता है जब तक लक्ष्य पूरा न हो जाए, बजट ख़त्म न हो जाए, या अगले कदम के लिए किसी इंसान की मंज़ूरी ज़रूरी न हो जाए।
चक्र हटा दें तो आपके पास चैटबॉट बचता है। हर कदम पहले से तय कर दें तो वर्कफ़्लो। वह चक्र जिसे मॉडल खुद नियंत्रित करता है, उसी से वह एजेंट बनता है।
AI एजेंट बनाम चैटबॉट बनाम वर्कफ़्लो
ये तीनों शब्द लगातार आपस में गड्डमड्ड होते रहते हैं, कुछ हद तक इसलिए कि "एजेंट" शब्द बिकता है। Gartner ने चैटबॉट और रोबोटिक प्रोसेस ऑटोमेशन (RPA) पर एजेंट का नया लेबल चिपकाने की प्रवृत्ति को एक नाम दिया है, "एजेंट वॉशिंग" (agent washing), और जून 2025 में अनुमान लगाया कि एजेंटिक AI बेचने वाले हज़ारों विक्रेताओं में से सिर्फ़ लगभग 130 ही असली चीज़ देते हैं। यह तालिका तीनों में फ़र्क़ करने का सबसे तेज़ तरीका है।
| चैटबॉट | वर्कफ़्लो (पाइपलाइन) | AI एजेंट | |
|---|---|---|---|
| अगला कदम कौन तय करता है | उपयोगकर्ता, एक बार में एक संदेश | डेवलपर, पहले से लिखे कोड में | मॉडल, चलते समय |
| टूल का उपयोग | कभी-कभी, हर जवाब में एक बार | हाँ, तय क्रम में | हाँ, ज़रूरत के हिसाब से चुनकर और दोहराकर |
| नए निर्देश के बिना काम जारी रखता है | नहीं | हाँ, तय रास्ते पर | हाँ, लक्ष्य या बजट तक पहुँचने तक |
| आम परिणाम | एक जवाब | ज्ञात प्रक्रिया से अनुमानित नतीजा | पूरा हुआ काम: कोड में बदलाव, रिपोर्ट, फ़ैसला |
| लागत और गति | सस्ता, कुछ सेकंड | सस्ते से मध्यम, अनुमानित | ज़्यादा और अनिश्चित, कुछ सेकंड से घंटों तक |
| आम विफलता | ग़लत जवाब जो दिख जाता है | ऐसी स्थितियों पर टूट जाता है जिनकी किसी ने योजना नहीं बनाई थी | भटक जाता है, चक्कर में फँस जाता है, या शुरुआती छोटी ग़लती पर आगे बढ़ता रहता है |
| किसके लिए बेहतर | सवाल-जवाब और मसौदा लेखन | ज्ञात चरणों वाली दोहराई जाने वाली प्रक्रियाएँ | खुले कार्य जिनका रास्ता पहले से लिखा नहीं जा सकता |
उसी Anthropic गाइड का एक उपयोगी नियम है: सबसे सरल विकल्प से शुरू करें जो काम करता हो, और स्वायत्तता तभी जोड़ें जब वह नतीजों को साफ़ तौर पर बेहतर बनाए। एजेंट के नाम पर बेचे जाने वाले कई काम वर्कफ़्लो के रूप में बेहतर, सस्ते और ज़्यादा सुरक्षित होते हैं।
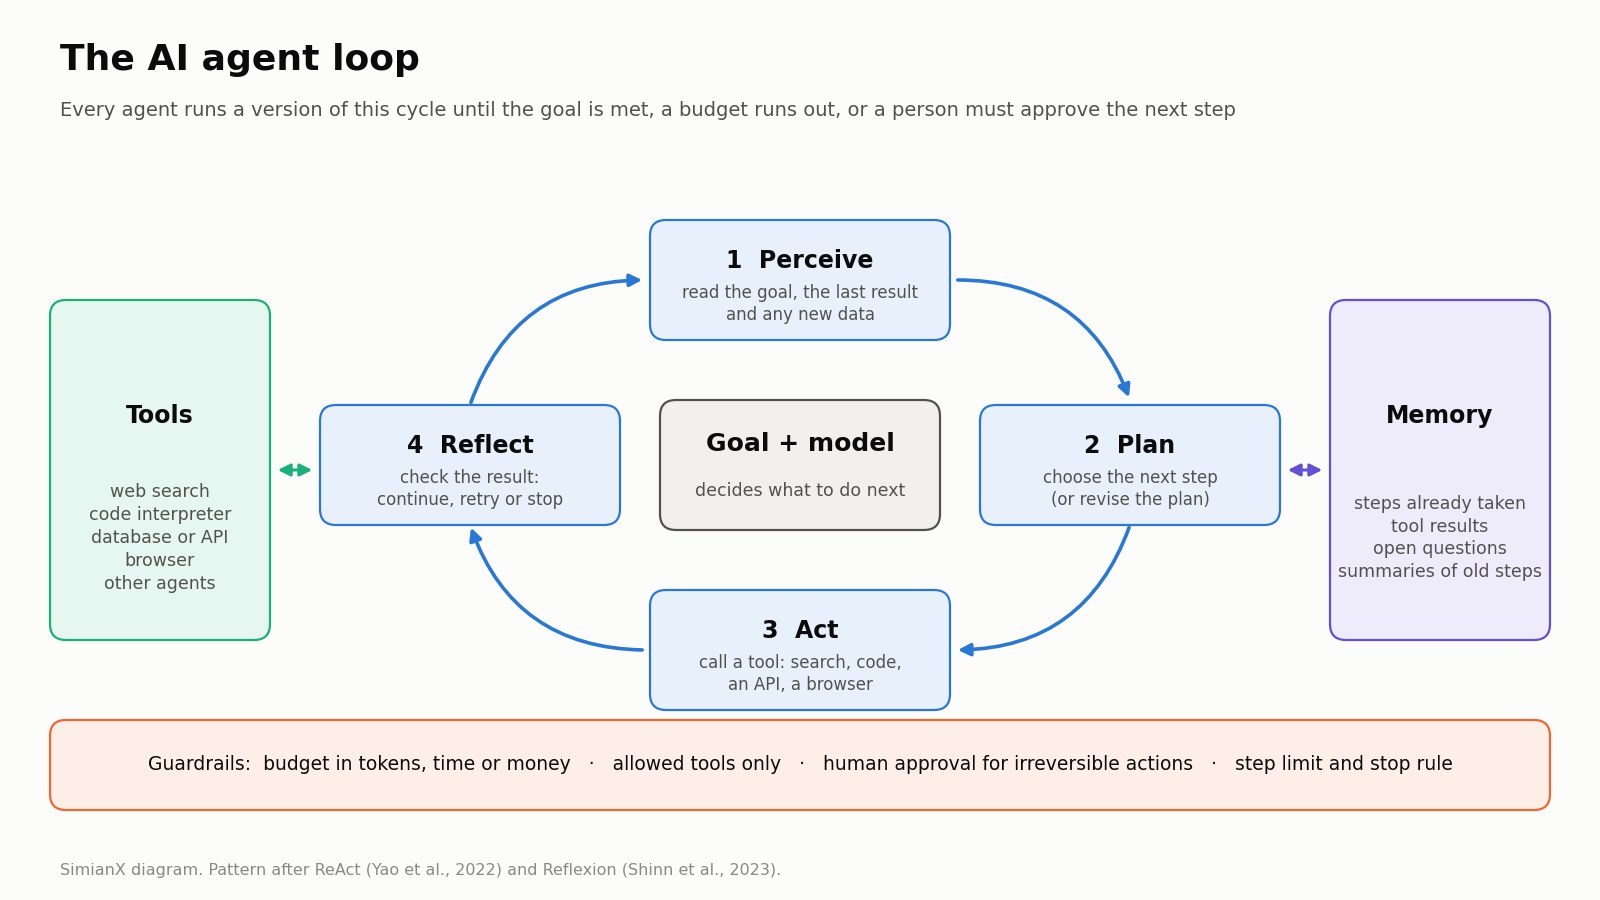
AI एजेंट कैसे काम करते हैं: धारणा, योजना, क्रिया और समीक्षा का चक्र
हर एजेंट, चाहे उस पर कोई भी ब्रांड लगा हो, इसी एक चक्र का कोई न कोई रूप चलाता है।
धारणा
एजेंट अपनी मौजूदा स्थिति इकट्ठा करता है: उपयोगकर्ता का लक्ष्य, पिछली कार्रवाई का नतीजा, किसी फ़ाइल की सामग्री, खोज नतीजों का एक पन्ना, चार्ट पर सबसे नई कैंडल। उसे जो कुछ पता है, वह सब मॉडल की संदर्भ-विंडो में समाना चाहिए, इसलिए अच्छे एजेंट चुनिंदा होते हैं। वे पुराने कदमों का सारांश बनाते हैं, जिस कच्चे डेटा की फिर ज़रूरत पड़ेगी उसे रखते हैं, और बाक़ी छोड़ देते हैं।
योजना
मॉडल तय करता है कि आगे क्या करना है। कभी-कभी यह शुरू में ही लिखी गई पूरी योजना होती है; ज़्यादातर यह सिर्फ़ अगला एक कदम होता है, जिसे पिछला नतीजा देखकर चुना जाता है। प्रभावशाली ReAct शोधपत्र (Yao व अन्य, 2022) ने दिखाया कि छोटे-छोटे तर्क-नोट्स और कार्रवाइयों को बारी-बारी से करने पर मॉडल जानकारी जुटा पाता है और अपनी दिशा सुधार पाता है, और कई कार्यों में इसने केवल कार्रवाई करने और केवल तर्क करने वाले, दोनों तरीकों को पीछे छोड़ा। ज़्यादातर एजेंट ढाँचे आज भी इसी तरीके पर चलते हैं।
क्रिया
एजेंट किसी टूल को बुलाता है। आधुनिक मॉडल एक संरचित अनुरोध भेजते हैं, जैसे "X खोजो" या "इन मानों के साथ यह डेटाबेस पूछताछ चलाओ", और आसपास का सॉफ़्टवेयर उसे चलाकर नतीजा लौटाता है। इस बुनियादी जोड़-तोड़ के लिए अब मानक मौजूद हैं। Model Context Protocol (MCP), जिसे Anthropic ने नवंबर 2024 में पेश किया और दिसंबर 2025 में लिनक्स फ़ाउंडेशन के Agentic AI Foundation को दान कर दिया, यह तय करता है कि एजेंट टूल और डेटा स्रोतों से कैसे जुड़ता है। Google का Agent2Agent प्रोटोकॉल (A2A), जो अब लिनक्स फ़ाउंडेशन की ही एक परियोजना है, यह तय करता है कि अलग-अलग कंपनियों के बनाए एजेंट आपस में कैसे बात करें।
समीक्षा
एजेंट नतीजे को लक्ष्य से मिलाकर जाँचता है। क्या परीक्षण सफल हुआ? क्या संख्या किसी दूसरे स्रोत से मेल खाती है? क्या योजना अब भी समझदारी भरी है? Reflexion (Shinn व अन्य, 2023) जैसे शोध ने दिखाया कि एजेंट को यह लिखने देना कि क्या ग़लत हुआ और फिर दोबारा कोशिश करने देना, कोडिंग और तर्क वाले कार्यों में नतीजे सुधारता है। समीक्षा वह जगह भी है जहाँ एजेंट को रुकने का फ़ैसला करना चाहिए: क्योंकि लक्ष्य पूरा हो गया, क्योंकि वह अटक गया है, या क्योंकि किसी जोखिम भरे काम के लिए इंसान की मंज़ूरी चाहिए।
चक्र के चारों ओर सुरक्षा-बाड़ होती है: टोकन, समय या पैसे में तय बजट, उन टूल की सूची जिन्हें एजेंट इस्तेमाल कर सकता है, और वे बिंदु जहाँ इंसान को हाँ कहना ही होगा। कारोबार के संदर्भ में इसका मतलब है कम से कम पोज़िशन के आकार की सीमा, हर सौदे पर स्टॉप-लॉस, और काग़ज़ी कारोबार (पेपर ट्रेडिंग) और असली पैसे के बीच साफ़ रेखा।
एकल एजेंट बनाम मल्टी-एजेंट सिस्टम
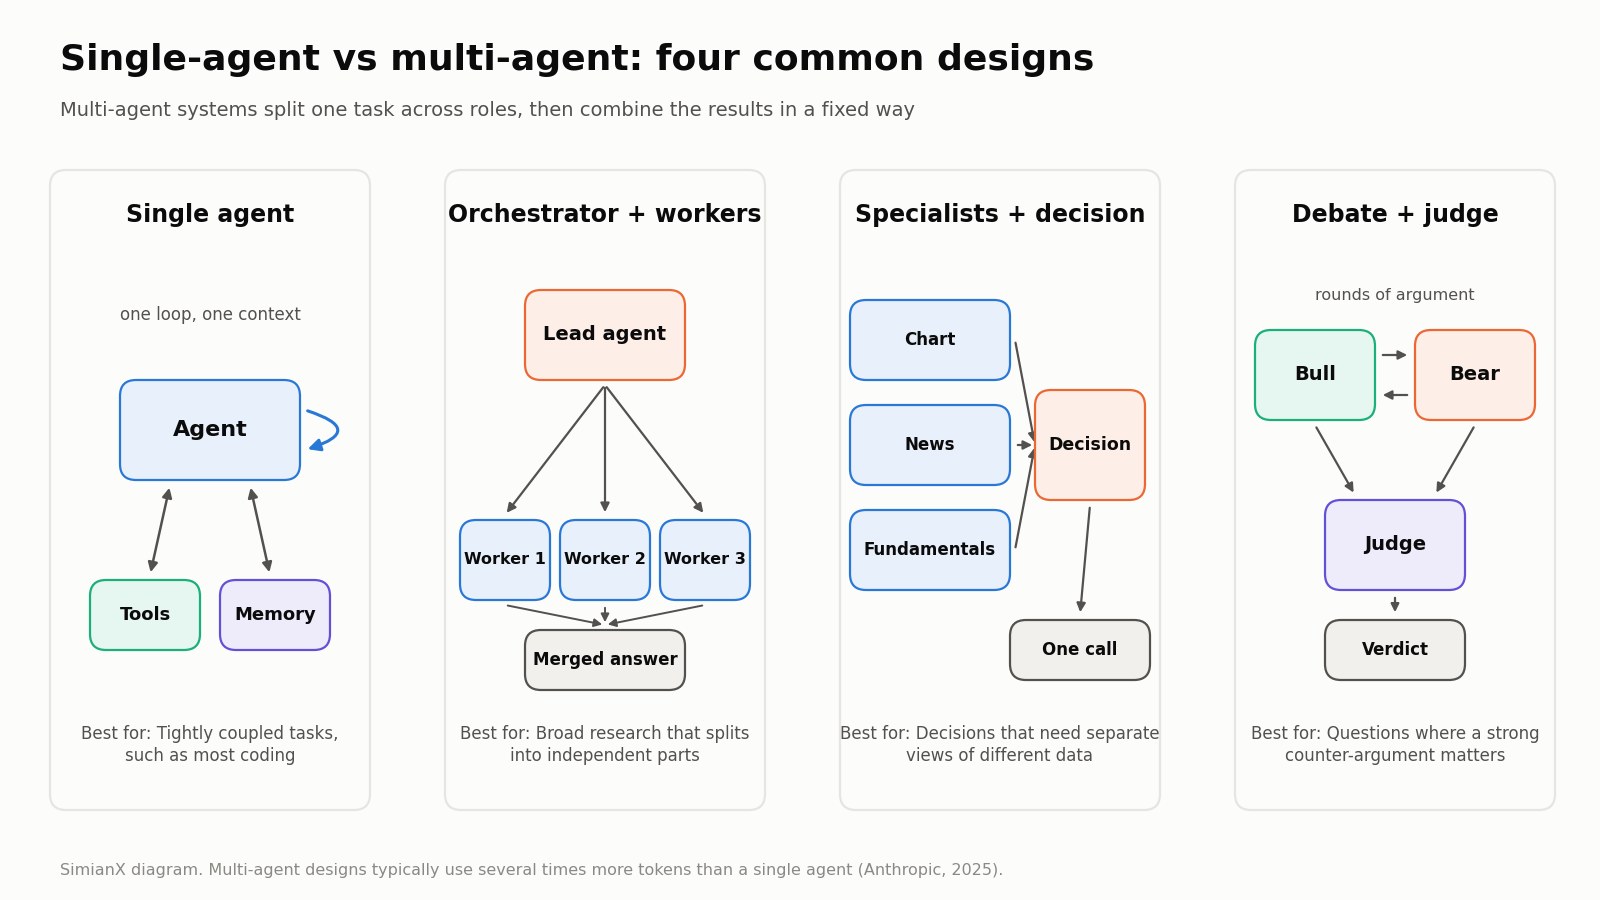
एकल एजेंट चक्र को अकेले चलाता है। मल्टी-एजेंट सिस्टम काम के अलग-अलग हिस्से अलग-अलग एजेंटों को देता है, हर एक के अपने निर्देश, टूल और संदर्भ होते हैं, और फिर उनके नतीजों को जोड़ता है। चार आम डिज़ाइन हैं:
- संचालक और कार्यकर्ता। एक मुख्य एजेंट काम को हिस्सों में तोड़ता है, हर हिस्सा एक कार्यकर्ता एजेंट को भेजता है, और नतीजों को मिलाता है। शोध सहायक अक्सर इसी तरह काम करते हैं।
- फ़ैसला लेने वाले को राय देने वाले विशेषज्ञ। हर एजेंट एक क्षेत्र संभालता है, जैसे चार्ट, ख़बरें या वित्तीय आँकड़े, और अंतिम एजेंट उनकी रायों को तौलता है। यही हमारे लाइव विश्लेषण कक्ष की संरचना है, जिसका वर्णन नीचे है।
- बहस। एजेंट विरोधी पक्षों से तर्क करते हैं, फिर एक निर्णायक फ़ैसला करता है। Du व अन्य (2023) ने पाया कि कई मॉडल-प्रतियों के कुछ दौर तक बहस करने से, एक मॉडल के अकेले जवाब देने की तुलना में तथ्यात्मक सटीकता और तर्क दोनों बेहतर हुए।
- मतदान या समूह। कई एजेंट, या कई मॉडल, एक ही सवाल का स्वतंत्र रूप से जवाब देते हैं, और फिर जवाबों को जोड़ा जाता है।
मल्टी-एजेंट सिस्टम के पक्ष में सबूत असली हैं, पर शर्तों के साथ। Anthropic ने जून 2025 में बताया कि उसके मल्टी-एजेंट शोध सिस्टम में, Claude Sonnet 4 उप-एजेंटों को निर्देश देने वाले एक मुख्य Claude Opus 4 एजेंट ने आंतरिक शोध मूल्यांकन में अकेले Claude Opus 4 एजेंट से 90.2% बेहतर प्रदर्शन किया। वही लेख कीमत को लेकर भी साफ़गोई बरतता है: एजेंटों ने चैट की तुलना में लगभग चार गुना टोकन इस्तेमाल किए, और मल्टी-एजेंट सिस्टम ने लगभग पंद्रह गुना। लेख यह भी कहता है कि ज़्यादातर कोडिंग कार्यों में शोध की तुलना में सचमुच समानांतर चल सकने वाले हिस्से कम होते हैं, इसलिए वे इस तरीके के लिए कम उपयुक्त हैं।
| एकल एजेंट | मल्टी-एजेंट सिस्टम | |
|---|---|---|
| सेटअप और गड़बड़ी सुधार | आसान: एक निर्देश-पाठ, एक कार्य-रिकॉर्ड | कठिन: कई निर्देश-पाठ, हस्तांतरण और एक संयुक्त कार्य-रिकॉर्ड |
| हर काम की लागत | कम | अक्सर कई गुना ज़्यादा |
| गति | एक के बाद एक | समानांतर हिस्से जल्दी पूरे होते हैं; तालमेल में अतिरिक्त समय लगता है |
| दायरा | एक संदर्भ-विंडो तक सीमित | हर एजेंट को अपने हिस्से के लिए नया संदर्भ मिलता है |
| ग़लती की जाँच | अपनी ग़लतियाँ खुद पकड़नी पड़ती हैं | एजेंट एक-दूसरे को चुनौती दे सकते हैं, और असहमति दिखाई देती है |
| आम विफलता | ग़लत पहले विचार पर अटकी संकीर्ण दृष्टि | ग़लत संवाद, दोहराया गया काम या कमज़ोर अंतिम मिलान |
| सबसे उपयुक्त | आपस में कसकर जुड़े काम, जैसे ज़्यादातर कोडिंग | व्यापक शोध, और ऐसे फ़ैसले जिन्हें स्वतंत्र दृष्टिकोण चाहिए |
हमारा अनुभव-सिद्ध नियम: एक से ज़्यादा एजेंट तब लगाएँ जब आपको ऐसी राय चाहिए जो किसी के आपस में मिलान करने से पहले स्वतंत्र रूप से बने। चार्ट की व्याख्या पर उस सुर्ख़ी का रंग नहीं चढ़ना चाहिए जो ख़बर वाले एजेंट ने अभी-अभी पढ़ी है, और मंदी का पक्ष ऐसा एजेंट लिखे जिसका इकलौता काम कमियाँ ढूँढना हो।
AI एजेंट कहाँ विफल होते हैं
एजेंट अनुमानित तरीकों से विफल होते हैं, और किसी भी ईमानदार गाइड को इन पर समय देना चाहिए। 2025 के एक अध्ययन, Why Do Multi-Agent LLM Systems Fail? (मल्टी-एजेंट LLM सिस्टम क्यों विफल होते हैं?) (Cemri व अन्य), ने सात लोकप्रिय मल्टी-एजेंट ढाँचों के 1,600 से ज़्यादा निष्पादन-रिकॉर्ड पर टिप्पणियाँ दर्ज कीं और तीन समूहों में 14 अलग-अलग विफलता-प्रकार पाए: सिस्टम के डिज़ाइन की समस्याएँ, एजेंटों के बीच तालमेल की कमी, और अंतिम नतीजे की कमज़ोर जाँच।
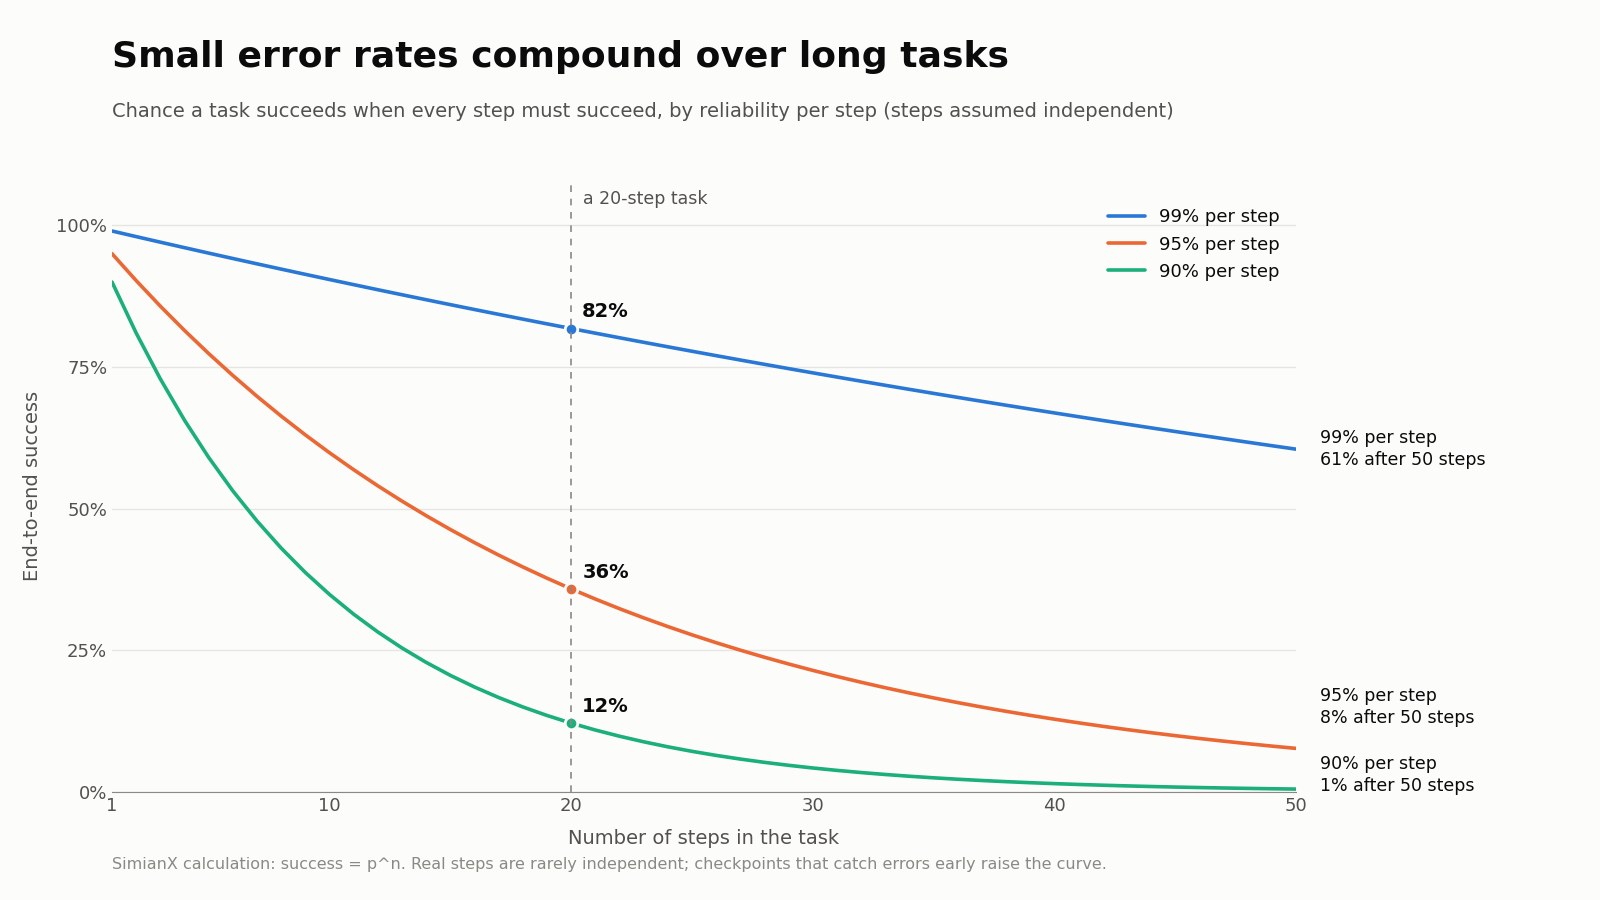
चक्रवृद्धि ग़लतियाँ
लंबे काम छोटी-छोटी ग़लती दरों को गुणा करते जाते हैं। अगर किसी काम का हर कदम 95% बार सफल होता है और कदम एक-दूसरे से स्वतंत्र हैं, तो 20 कदमों वाला काम सिर्फ़ लगभग 36% बार सफल होता है (0.95 की 20वीं घात)। हर कदम पर 99% सफलता हो, तो वही काम लगभग 82% बार सफल होता है। इसीलिए किसी एक कदम पर चमक दिखाने से ज़्यादा ज़रूरी है हर कदम की विश्वसनीयता, और इसीलिए एजेंटों को ऐसे जाँच-बिंदु चाहिए जो अगले कदम के उस पर खड़े होने से पहले ही ग़लती पकड़ लें।
मनगढ़ंत तथ्य और टूल के नतीजों की ग़लत व्याख्या
मॉडल कोई तथ्य गढ़ सकता है, टूल के नतीजे को ग़लत पढ़ सकता है, या किसी पुरानी संख्या को ऐसे आगे ले जा सकता है जैसे वह मौजूदा हो। एजेंट इस समस्या को और बढ़ा देते हैं, क्योंकि गढ़ा हुआ मान अगली कार्रवाई का आधार बन सकता है। इलाज संरचनात्मक है: अपने शब्दों में दोहराने के बजाय कच्चा डेटा आगे बढ़ाएँ, मॉडल के हिसाब-किताब पर भरोसा करने के बजाय मुख्य संख्याओं को कोड से जाँचें, और हर अहम दावे के लिए स्रोत माँगें।
लागत
चक्र का हर चक्कर मॉडल को भेजा गया एक और अनुरोध है, और काम आगे बढ़ने के साथ संदर्भ बढ़ता जाता है। प्रदर्शन में सस्ता दिखने वाला काम असली इस्तेमाल में कई गुना महँगा पड़ सकता है, जब एजेंट दोबारा कोशिश करता है, समीक्षा करता है और फिर से पढ़ता है। हर काम के लिए सख़्त बजट तय करें, और एक अनुरोध की नहीं, बल्कि एक पूरे हुए काम की लागत मापें।
विलंब
एजेंट गुणवत्ता के बदले गति छोड़ते हैं। चैट का जवाब कुछ सेकंड में आता है; एक शोध एजेंट को कई मिनट लग सकते हैं, और किसी बड़े बदलाव पर काम कर रहा कोडिंग एजेंट इससे कहीं ज़्यादा देर चल सकता है। हमारी अपनी आठ-एजेंट गहन शोध समिति को भी एक शेयर के लिए कई मिनट लगते हैं, क्योंकि कुछ भी लिखने से पहले एजेंट शोध करते हैं, बहस करते हैं और मतदान करते हैं।
मूल्यांकन
एजेंट अनिश्चित व्यवहार वाले होते हैं: एक ही काम एक दौर में सफल और अगले में विफल हो सकता है। tau-bench मानक परीक्षण ने pass^k नाम का एक पैमाना पेश किया, यानी इस बात की संभावना कि एजेंट एक ही काम की सभी k कोशिशों में सफल हो, और पाया कि उस समय के मज़बूत फ़ंक्शन बुलाने वाले एजेंट भी अपने खुदरा क्षेत्र में आठों कोशिशों में 25% से कम बार सफल हुए। एक प्रभावशाली दौर आपको बहुत कम बताता है। कोडिंग के लिए SWE-bench और कंप्यूटर उपयोग के लिए OSWorld जैसे सार्वजनिक मानक परीक्षण उपयोगी हैं, लेकिन वे आपके काम नहीं हैं।
सुरक्षा और अनुमतियाँ
वेब पेज या ईमेल पढ़ने वाले एजेंट को उनमें छिपे निर्देशों से बहकाया जा सकता है। इस हमले को निर्देश-घुसपैठ (प्रॉम्प्ट इंजेक्शन) कहते हैं, और यह LLM एप्लिकेशन के जोखिमों की OWASP सूची में सबसे ऊपर है। एजेंटों को उतनी ही पहुँच दें जितनी ज़रूरी है, गोपनीय जानकारी को उनके संदर्भ से बाहर रखें, और पैसे भेजने जैसे किसी भी अपरिवर्तनीय काम से पहले मंज़ूरी अनिवार्य करें।
इन समस्याओं के कारोबारी नतीजे भी होते हैं। उसी जून 2025 की घोषणा में Gartner ने अनुमान लगाया कि बढ़ती लागत, अस्पष्ट कारोबारी मूल्य और अपर्याप्त जोखिम नियंत्रण के चलते 2027 के अंत तक 40% से ज़्यादा एजेंटिक AI परियोजनाएँ रद्द कर दी जाएँगी।
एक व्यावहारिक उदाहरण: SimianX के एजेंट सौदे का फ़ैसला कैसे बाँटते हैं
कारोबार एजेंटों के लिए कठिन परीक्षा है। डेटा लगातार आता रहता है, फ़ैसले के समय सही जवाब किसी को पता नहीं होता, और हर फ़ैसले को अंततः बाज़ार अंक देता है। हमारा सिस्टम काम इस तरह बाँटता है।
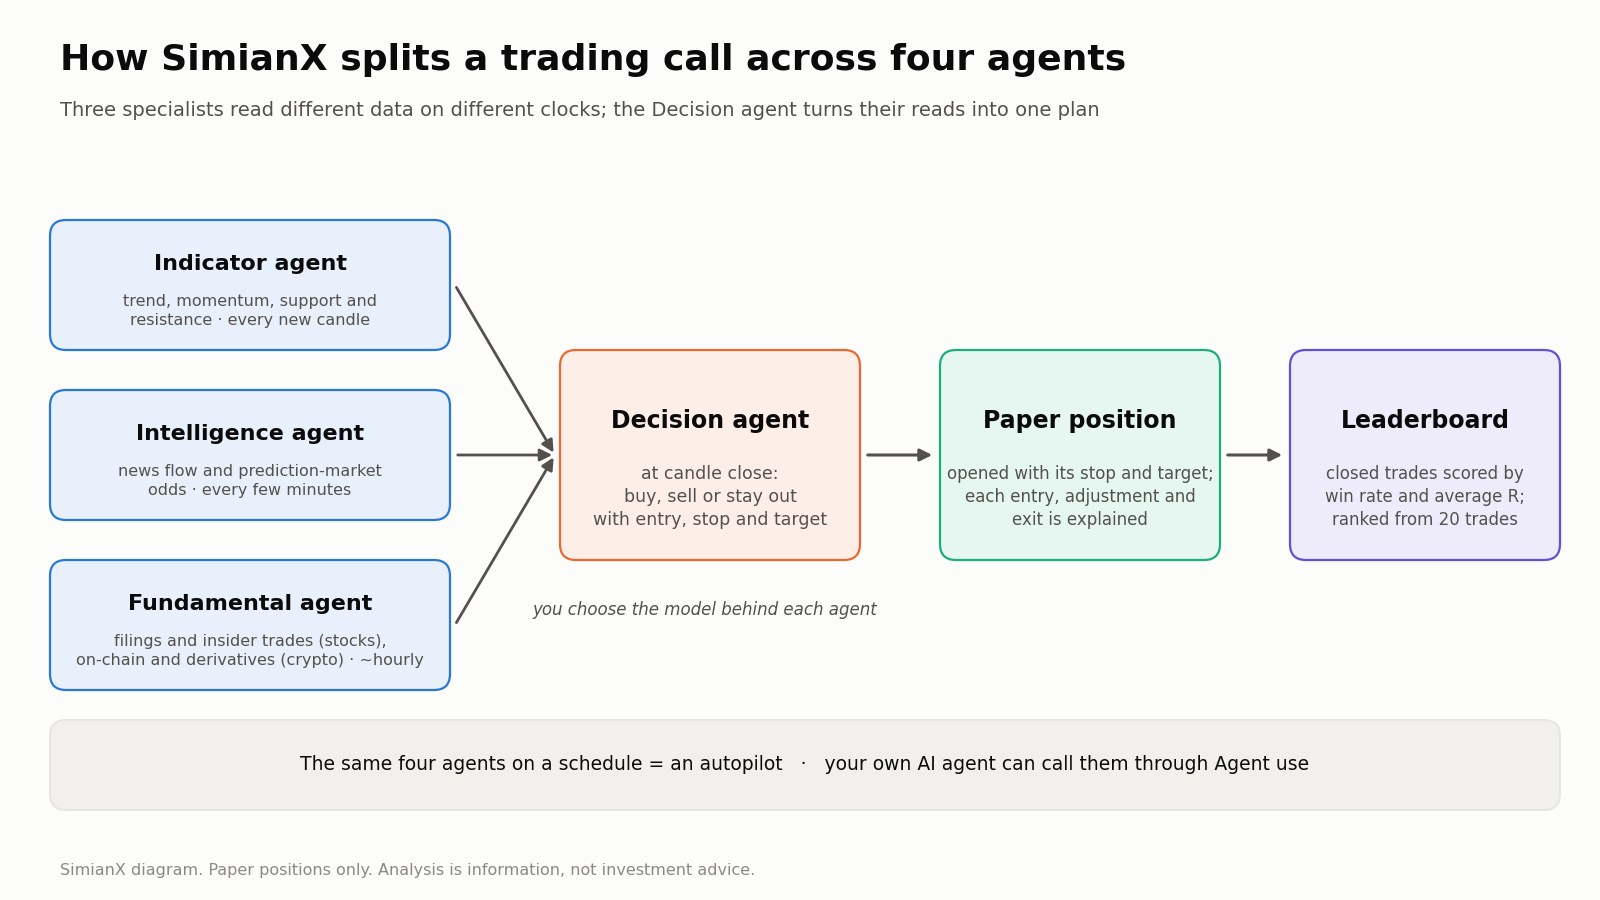
लाइव विश्लेषण: तीन विशेषज्ञ और एक फ़ैसला एजेंट
जब आप लाइव विश्लेषण कक्ष में कोई अमेरिकी शेयर या क्रिप्टो जोड़ी खोलते हैं और समय-सीमा चुनते हैं, तो चार एजेंट काम में जुट जाते हैं। इसका दायरा 13,000 से ज़्यादा अमेरिकी शेयरों और ETF तथा 4,000 से ज़्यादा क्रिप्टो जोड़ियों तक फैला है, 1-मिनट की कैंडल से लेकर ऊपर तक।
- संकेतक एजेंट चार्ट पढ़ता है: रुझान, गति, समर्थन और प्रतिरोध स्तर। यह हर नई कैंडल पर चलता है।
- सूचना एजेंट उस शेयर या कॉइन की ख़बरों का प्रवाह पढ़ता है और, जहाँ उपलब्ध हों, भविष्यवाणी बाज़ारों की संभावनाएँ भी। यह हर कुछ मिनट में ताज़ा होता है।
- बुनियादी विश्लेषण एजेंट शेयर के लिए नियामकीय दस्तावेज़ और कंपनी के भीतरी लोगों (इनसाइडर) के सौदे पढ़ता है, या कॉइन के लिए ब्लॉकचेन पर दर्ज डेटा और डेरिवेटिव डेटा। ये धीरे बदलते हैं, इसलिए मानक सेटिंग में यह लगभग हर घंटे एक बार ताज़ा होता है।
- फ़ैसला एजेंट कैंडल बंद होने पर बाक़ी तीनों की राय तौलता है और बताता है कि क्या करना है: ख़रीदें, बेचें या बाहर रहें, साथ में प्रवेश स्तर, स्टॉप-लॉस और लक्ष्य।
जब कोई मौक़ा बनता है, तो सिस्टम उसी स्टॉप-लॉस और लक्ष्य के साथ एक काग़ज़ी पोज़िशन खोलता है, फिर सौदा आगे बढ़ने के साथ हर प्रवेश, बदलाव और निकास को समझाता है। हर एजेंट के पीछे कौन-सा मॉडल होगा, यह आप चुनते हैं। यही चार एजेंट एक स्वचालित पायलट के रूप में तय समय-सारणी पर भी चल सकते हैं, और सूचना एजेंट अंक दी गई ख़बरों की जिस धारा का इस्तेमाल करता है, वही धारा मार्केट पल्स को भी चलाती है।
काम इस तरह क्यों बाँटा गया? तीनों विशेषज्ञ अलग-अलग घड़ियों पर चलते हैं, इसलिए उन्हें अलग रखने से चार्ट की व्याख्या हर कैंडल पर ताज़ा हो जाती है, बिना किसी ऐसे दस्तावेज़ को दोबारा पढ़ने की कीमत चुकाए जो बदला ही नहीं। इससे हर एजेंट का संदर्भ छोटा और केंद्रित रहता है। और असहमति दिखाई देने लगती है: जब चार्ट कहे "प्रतिरोध टूट गया" और ख़बर वाला एजेंट कल आने वाले तिमाही नतीजों की चेतावनी दे, तो फ़ैसला एजेंट को उस टकराव से सीधे निपटना पड़ता है, न कि उसका औसत निकालकर उसे ग़ायब कर देना।
गहन शोध: आठ एजेंटों की समिति
किसी एक शेयर या कॉइन को धीमे और गहराई से देखने के लिए गहन शोध आठ एजेंटों की एक समिति बिठाता है। चार विश्लेषक साथ-साथ शोध करते हैं: बुनियादी आँकड़े, चार्ट, ख़बरें, और चौथी सीट, जो शेयरों के लिए समय (टाइमिंग) का दृष्टिकोण और क्रिप्टो के लिए डेरिवेटिव विश्लेषक होती है। फिर एक तेज़ी वाला शोधकर्ता और एक मंदी वाला शोधकर्ता दोनों पक्षों का सबसे मज़बूत मामला तैयार करते हैं। एक शोध प्रबंधक सबसे बड़ी असहमतियों पर बहस की अध्यक्षता करता है, हर सदस्य समापन मतदान में अपना रुख़ दोहराता है, और एक जोखिम प्रबंधक जाँचे हुए मूल्य-स्तरों के साथ फ़ैसला लिखता है। नई बनी समिति पर हमारा पूरा दौरा एक असली दौर को स्क्रीन-दर-स्क्रीन दिखाता है।
यह शोध-साहित्य का बहस वाला तरीका है, जिसे असल उत्पाद में उतारा गया है। मंदी वाला शोधकर्ता इसलिए है क्योंकि हाँ में हाँ मिलाने वाले विश्लेषकों की समिति असल में एक ही राय को चार बार दोहराना भर है।
लीडरबोर्ड नतीजों को कैसे मापता है
सौदे के फ़ैसले लेने वाले एजेंट को इस आधार पर अंक मिलने चाहिए कि नतीजा क्या रहा, इस आधार पर नहीं कि उसका तर्क कितना विश्वसनीय लगता है। क्रिप्टो लीडरबोर्ड इन काग़ज़ी पोज़िशनों के पीछे के AI मॉडलों को अंक देता है, और इसमें सिर्फ़ वही बंद सौदे गिने जाते हैं जिनका निपटारा असली बाज़ार भाव पर हुआ हो। फ़िलहाल इसमें कई AI प्रयोगशालाओं के 30 से ज़्यादा मॉडल शामिल हैं, और यह हर मॉडल को दो तरह से मापता है:
- जीत दर: बंद हुए सौदों में मुनाफ़े पर ख़त्म हुए सौदों का हिस्सा।
- औसत R: प्रवेश के समय उठाए गए जोखिम की इकाइयों में मापा गया प्रति सौदा मुनाफ़ा। 100 पर ख़रीद की पोज़िशन और 98 पर स्टॉप-लॉस का मतलब है प्रति इकाई 2 का जोखिम; 104 पर बंद करना +2R है, और पूरा स्टॉप-लॉस लगना −1R।
किसी मॉडल को मौजूदा छँटनी शर्तों में 20 बंद सौदों के बाद ही क्रम में जगह मिलती है, ताकि गिने-चुने भाग्यशाली सौदे उसे शीर्ष पर न पहुँचा सकें, और आप अवधि, समय-सीमा और पक्ष (ख़रीद या बिक्री) के हिसाब से छाँट सकते हैं। दोनों संख्याओं को साथ पढ़ना ज़रूरी है: ऊँची जीत दर के साथ कम R कुछ बड़े घाटों को छिपा सकता है, जबकि औसत जीत दर के साथ ऊँचा R कम लेकिन बड़े मुनाफ़ों का संकेत हो सकता है। बोर्ड के पीछे के मॉडलों की तुलना हमने कौन सा AI मॉडल सबसे बेहतर ट्रेडर है? में और अपनी GPT बनाम Gemini बनाम Claude गाइड में की है।
अपना एजेंट जोड़ें
यही सिस्टम बाहरी एजेंटों के लिए भी खुला है। एजेंट से इस्तेमाल पेज बताता है कि Claude Code, Codex, Cursor या किसी दूसरे एजेंट को SimianX कौशल-पैकेज (स्किल) और एक API कुंजी कैसे दें, ताकि वह किसी भी शेयर या कॉइन पर चार एजेंटों वाला लाइव विश्लेषण शुरू कर सके, अंक दी गई ख़बरों की धारा पर नज़र रख सके, या गहन शोध चला सके। आपके एजेंट को आपकी तय की गई बजट-सीमा वाली अपनी अलग कुंजी मिलती है। उसे आपकी वेबसाइट का लॉगिन विवरण कभी नहीं मिलता, और वह जो भी पोज़िशन संभालता है वह काग़ज़ी पोज़िशन होती है।
जोखिम सूचना: ऊपर लिखी हर बात ऐसे सॉफ़्टवेयर का वर्णन है जो विश्लेषण और काग़ज़ी सौदे तैयार करता है। यह जानकारी है, निवेश सलाह नहीं। AI मॉडल ग़लतियाँ करते हैं, लीडरबोर्ड के नतीजे पिछले सौदों का ब्योरा हैं और भविष्य के प्रतिफल की भविष्यवाणी नहीं करते, और कोई भी मॉडल या समिति बाज़ार का जोखिम ख़त्म नहीं करती। किसी AI के फ़ैसले के भरोसे कभी ऐसा पैसा दाँव पर न लगाएँ जिसे खोना आप सह न सकें।
2026 में AI एजेंटों के प्रकार
पाठ्यपुस्तक वाला वर्गीकरण
पाठ्यपुस्तकें एजेंटों को इस आधार पर वर्गीकृत करती हैं कि वे फ़ैसला कैसे लेते हैं, और ये श्रेणियाँ आज भी आधुनिक सिस्टम को समझने में मदद करती हैं:
| प्रकार | फ़ैसला कैसे लेता है | उदाहरण |
|---|---|---|
| सरल प्रतिवर्ती एजेंट | मौजूदा संकेत पर तय शर्त-क्रिया नियम | थर्मोस्टैट; कीमत की चेतावनी |
| मॉडल-आधारित प्रतिवर्ती एजेंट | नियमों के साथ उन चीज़ों की आंतरिक तस्वीर जिन्हें वह सीधे नहीं देख सकता | स्पैम फ़िल्टर जो भेजने वाले का इतिहास याद रखता है |
| लक्ष्य-आधारित एजेंट | तय लक्ष्य तक पहुँचाने वाली क्रियाएँ खोजता है | मार्ग-योजक |
| उपयोगिता-आधारित एजेंट | सबसे अच्छे अपेक्षित संतुलन वाली क्रिया चुनता है | इनाम और जोखिम को तौलने वाला कारोबारी एजेंट |
| सीखने वाला एजेंट | प्रतिक्रिया से अपना व्यवहार सुधारता है | क्लिक के हिसाब से बदलने वाला सुझाव सिस्टम |
भाषा-मॉडल वाले एजेंट इन प्रकारों को मिला देते हैं। वे जो लक्ष्य साधते हैं उसमें लक्ष्य-आधारित हैं, विकल्पों को तौलते समय उपयोगिता-आधारित, और नतीजों की समीक्षा करके एक ही काम के भीतर सीखते हैं।
उत्पाद श्रेणियाँ
असल में वे क्या करते हैं, इसके आधार पर बाँटें तो 2026 में लोग जिन एजेंटों का इस्तेमाल करते हैं वे पाँच व्यापक श्रेणियों में आते हैं। यहाँ नामित उत्पाद केवल उदाहरण हैं, सिफ़ारिश नहीं, और उनकी क्षमताएँ तेज़ी से बदलती हैं।
कोडिंग एजेंट। AI कोडिंग एजेंट कोड भंडार को पढ़ता है, फ़ाइलें संपादित करता है, परीक्षण चलाता है और बदलाव का प्रस्ताव देता है, अक्सर एक बदलाव-अनुरोध (पुल रिक्वेस्ट) के रूप में। उदाहरणों में Anthropic का Claude Code, OpenAI का Codex, GitHub Copilot का कोडिंग एजेंट, Cursor और Cognition का Devin शामिल हैं। इनकी तुलना आम तौर पर SWE-bench पर की जाती है, जो उनसे मुक्त स्रोत (ओपन-सोर्स) परियोजनाओं की असली समस्याएँ सुलझाने को कहता है। METR के शोध के अनुसार, अग्रणी एजेंट 50% विश्वसनीयता के साथ जितने लंबे सॉफ़्टवेयर कार्य पूरे कर सकते हैं, उनकी लंबाई 2019 से लगभग हर सात महीने में दोगुनी हुई है।
शोध एजेंट। ये वेब या दस्तावेज़ों के संग्रह में खोज करते हैं, कई स्रोत पढ़ते हैं और स्रोत-सहित रिपोर्ट लिखते हैं। Google ने दिसंबर 2024 में Gemini Deep Research पेश किया, और OpenAI ने फ़रवरी 2025 में ChatGPT में गहन शोध (deep research) पेश किया। इनकी कमज़ोरी स्रोतों की गुणवत्ता है: अच्छी तरह लिखी गई रिपोर्ट भी किसी कमज़ोर स्रोत पर टिकी हो सकती है।
ब्राउज़र और कंप्यूटर-उपयोग एजेंट। ये स्क्रीन देखकर, क्लिक और टाइप करके ब्राउज़र या पूरे डेस्कटॉप को चलाते हैं। Anthropic ने अक्टूबर 2024 में कंप्यूटर उपयोग (computer use) जारी किया। जनवरी 2025 में पेश हुआ OpenAI का Operator जुलाई 2025 में ChatGPT agent में मिला दिया गया, और Google के पास Project Mariner है। ये API के ज़रिए काम करने वाले एजेंटों से धीमे और कम विश्वसनीय हैं, इसलिए इन्हें आम तौर पर उन्हीं साइटों के लिए रखा जाता है जो कोई API नहीं देतीं।
सामान्य-उद्देश्य एजेंट। ये एक व्यापक लक्ष्य लेते हैं और उसे पूरा करने के लिए वेब ब्राउज़िंग, कोड और फ़ाइलों को जोड़ते हैं। मार्च 2025 में पेश हुआ Manus इसका सबसे जाना-माना उदाहरण है। Meta दिसंबर 2025 में इस कंपनी के अधिग्रहण पर सहमत हुई; अप्रैल 2026 में चीन के राष्ट्रीय विकास और सुधार आयोग ने सौदे को रद्द करने का आदेश दिया।
कारोबार और बाज़ार-विश्लेषण एजेंट। ये बाज़ार डेटा, ख़बरें और नियामकीय दस्तावेज़ पढ़ते हैं, और सौदों की योजना बनाते हैं या पोज़िशन संभालते हैं। TradingAgents (Xiao व अन्य, 2024) जैसे अकादमिक ढाँचे विश्लेषक, शोधकर्ता, सौदा करने वाले (ट्रेडर) और जोखिम-प्रबंधन भूमिकाओं वाली एक कारोबारी फ़र्म का मॉडल बनाते हैं, और SimianX जैसे उत्पाद लाइव डेटा पर इसी तरह की समितियाँ चलाते हैं। बाज़ार प्रतिकूल और शोर-भरे होते हैं, इसलिए यही वह श्रेणी है जहाँ सार्वजनिक, सौदा-दर-सौदा प्रदर्शन रिकॉर्ड सबसे ज़्यादा मायने रखता है।
AI एजेंट का मूल्यांकन कैसे करें: एक जाँच-सूची
चाहे आप कोडिंग एजेंट चुन रहे हों, शोध टूल या कारोबारी सहायक, यही सवाल उपयोगी एजेंटों को महज़ प्रदर्शन वाले नमूनों से अलग करते हैं।
| सवाल | अच्छा कैसा दिखता है | ख़तरे का संकेत |
|---|---|---|
| क्या यह सच में एजेंट है? | अपने कदम और टूल खुद चुनता है | "एजेंट" का लेबल लगी एक तय स्क्रिप्ट |
| क्या यह आपके कामों पर चलता है? | आपके अपने काम से लिए गए 10–20 असली कार्यों पर परखा गया | सिर्फ़ विक्रेता के प्रदर्शन और मानक परीक्षणों के अंक |
| क्या यह एकरूप है? | एक ही काम कई बार चलाने पर मिलते-जुलते नतीजे | एक बार शानदार, फिर विफलताएँ |
| एक पूरे हुए काम की लागत क्या है? | हर पूरे हुए काम की लागत मापी और सीमित की जाती है | सिर्फ़ प्रति अनुरोध कीमत बताई जाती है |
| इसमें कितना समय लगता है? | गति काम के अनुरूप है | एक पंक्ति के जवाब के लिए मिनटों का इंतज़ार |
| क्या आप देख सकते हैं कि इसने क्या किया? | कदमों, टूल के इस्तेमाल और स्रोतों का पूरा ब्योरा | बिना किसी निशान के सिर्फ़ अंतिम जवाब |
| यह किन चीज़ों को छू सकता है? | न्यूनतम ज़रूरी पहुँच, अलग-थलग परिवेश (सैंडबॉक्स) या काग़ज़ी मोड, अपरिवर्तनीय कामों के लिए मंज़ूरी | व्यापक पहुँच-अधिकार और कोई मंज़ूरी-चरण नहीं |
| यह रुकता कैसे है? | बजट, कदमों की सीमा और साफ़ रुकने का नियम | तब तक चक्कर लगाता है जब तक किसी का ध्यान न जाए |
| इसका डेटा कितना ताज़ा है? | हर डेटा बिंदु पर समय-मुहर | पुरानी संख्याएँ मौजूदा बताकर पेश की जाती हैं |
| कारोबारी एजेंटों के लिए: प्रदर्शन रिकॉर्ड क्या है? | असली भाव पर बंद सौदे, नमूने का आकार दिखाया गया, जीत दर और जोखिम-समायोजित प्रतिफल दोनों | सिर्फ़ पुराने आँकड़ों पर परीक्षण (बैकटेस्ट), या सौदों की गिनती के बिना जीत दर |
अक्सर पूछे जाने वाले सवाल
आसान शब्दों में AI एजेंट क्या है?
AI एजेंट एक प्रोग्राम है जो AI मॉडल का इस्तेमाल करके खुद किसी लक्ष्य तक पहुँचता है। वह स्थिति देखता है, एक कदम तय करता है, उसे पूरा करने के लिए खोज या कोड जैसे टूल का इस्तेमाल करता है, नतीजा जाँचता है और तब तक दोहराता है जब तक काम पूरा न हो जाए या उसे किसी इंसान की ज़रूरत न पड़े।
AI एजेंट और चैटबॉट में क्या अंतर है?
चैटबॉट एक बार में एक संदेश का जवाब देता है और फिर आपका इंतज़ार करता है। एजेंट कई कदमों में लक्ष्य की ओर काम करता रहता है, तय करता है कि कौन-से टूल इस्तेमाल करने हैं, और हर कदम के लिए नए निर्देश के बिना कोई काम पूरा कर सकता है, जैसे कोड ठीक करना या रिपोर्ट लिखना।
मल्टी-एजेंट सिस्टम क्या है?
मल्टी-एजेंट सिस्टम अलग-अलग भूमिकाओं वाले AI एजेंटों का एक समूह है जो एक ही काम पर लगा होता है। वे काम बाँट सकते हैं, विरोधी पक्षों से बहस कर सकते हैं या मतदान कर सकते हैं, और एक अंतिम एजेंट या तय नियम उनके नतीजों को जोड़ता है। व्यापक कामों में ये अक्सर एकल एजेंट से बेहतर करते हैं, लेकिन कहीं ज़्यादा लागत पर।
AI कोडिंग एजेंट क्या है?
AI कोडिंग एजेंट किसी सॉफ़्टवेयर परियोजना के भीतर काम करता है: वह कोड पढ़ता है, फ़ाइलें संपादित करता है, परीक्षण चलाता है और बदलावों का प्रस्ताव देता है। उदाहरणों में Claude Code, OpenAI Codex, GitHub Copilot का कोडिंग एजेंट, Cursor और Devin शामिल हैं।
Manus AI क्या है?
Manus मार्च 2025 में पेश हुआ एक सामान्य-उद्देश्य AI एजेंट है, जो एक व्यापक लक्ष्य लेकर उसे पूरा करने के लिए वेब ब्राउज़िंग, कोड और फ़ाइलों का इस्तेमाल करता है। Meta दिसंबर 2025 में इस कंपनी को ख़रीदने पर सहमत हुई, और अप्रैल 2026 में चीनी नियामकों ने इस सौदे को रद्द करने का आदेश दिया।
क्या AI एजेंट शेयर या क्रिप्टो का कारोबार कर सकते हैं?
वे बाज़ारों का विश्लेषण कर सकते हैं और पोज़िशन संभाल सकते हैं, और SimianX समेत कुछ उत्पाद एजेंटों को स्टॉप-लॉस और लक्ष्य के साथ काग़ज़ी पोज़िशन चलाने देते हैं। नतीजे मॉडल और बाज़ार के हिसाब से बहुत अलग होते हैं, इसलिए किसी भी कारोबारी एजेंट को उसके बंद सौदों के रिकॉर्ड से परखें, और उसके नतीजों को सलाह नहीं, जानकारी मानें।
मैं अपने AI एजेंट को लाइव बाज़ार विश्लेषण से कैसे जोड़ूँ?
SimianX का एजेंट से इस्तेमाल पेज दिखाता है कि Claude Code, Codex, Cursor और दूसरे एजेंटों में SimianX कौशल-पैकेज कैसे इंस्टॉल करें। आपके एजेंट को आपकी नियंत्रित बजट-सीमा वाली अपनी API कुंजी मिलती है, और वह मल्टी-एजेंट लाइव विश्लेषण शुरू कर सकता है, अंक दी गई ख़बरों की धारा पर नज़र रख सकता है और गहन शोध चला सकता है।
संबंधित लेख
- AI स्टॉक विश्लेषण का नया रूप: 8 एजेंटों की समिति से सवाल पूछें
- 8 AI एनालिस्ट vs 1: +37% सटीकता, −41% जोखिम का पूरा सच यहाँ
- कौन सा AI मॉडल सबसे बेहतर ट्रेडर है? 30 LLM, असली P&L पर
- 30+ AI मॉडल, 6 प्रदाता: क्रिप्टो लाइव ट्रेड रैंकिंग गाइड
- GPT बनाम Gemini बनाम Claude: AI स्टॉक विश्लेषण गाइड 2026
- मल्टी-एजेंट AI बनाम ChatGPT: NVDA सिग्नल 2026 की पूरी तुलना
- AI क्रिप्टो ऑटोपायलट 24/7 कैसे काम करते हैं (2026 पूर्ण गाइड)
- स्टॉक लाइव विश्लेषण: AI एजेंट US स्टॉक्स रियल-टाइम में कवर
- Agentic AI निवेश: अगली पीढ़ी के मार्केट के लिए शुरुआती गाइड
संदर्भ
- रसेल और नॉरविग — आर्टिफ़िशियल इंटेलिजेंस: अ मॉडर्न अप्रोच (Artificial Intelligence: A Modern Approach)
- Anthropic — Building Effective Agents (दिसंबर 2024)
- Anthropic — How we built our multi-agent research system (जून 2025)
- Yao व अन्य — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn व अन्य — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du व अन्य — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri व अन्य — Why Do Multi-Agent LLM Systems Fail?
- Yao व अन्य — tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao व अन्य — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — आधिकारिक दस्तावेज़
- Agent2Agent (A2A) प्रोटोकॉल — आधिकारिक साइट
- Gartner — 2027 के अंत तक 40% से ज़्यादा एजेंटिक AI परियोजनाएँ रद्द होंगी (जून 2025)
- TechCrunch — चीन ने Meta का 2 अरब डॉलर का Manus सौदा रोका (अप्रैल 2026)
- IBM — AI एजेंट क्या हैं?
- OWASP — बड़े भाषा मॉडल एप्लिकेशन के 10 प्रमुख जोखिम