GPT vs Gemini vs Claude para Análise de Ações com IA: Guia 2026
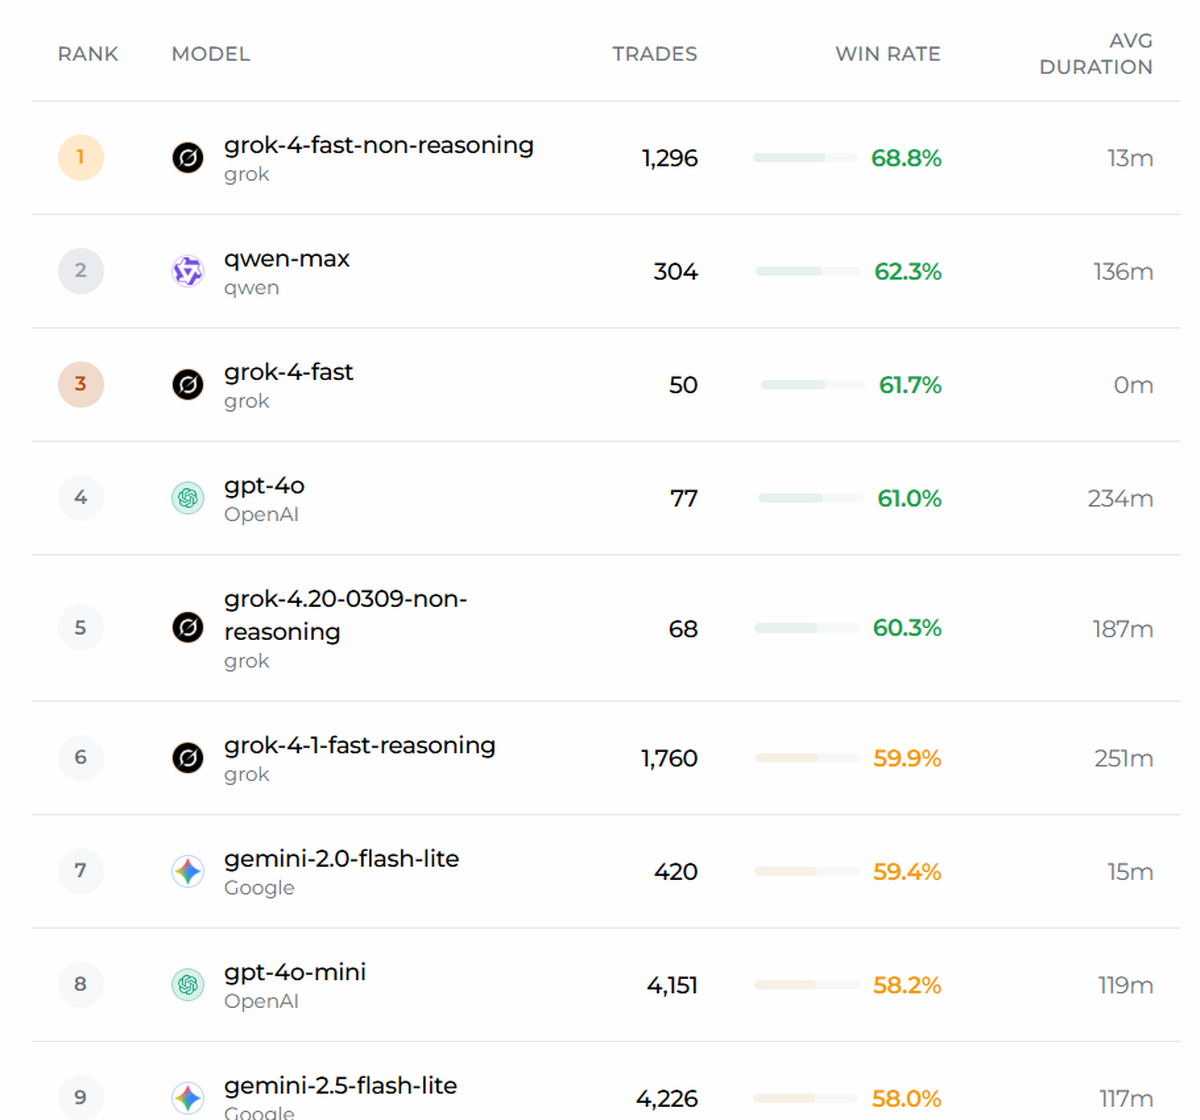
GPT vs Gemini vs Claude para análise de ações com IA não é mais uma simples questão de “qual chatbot dá a resposta mais inteligente?” Em 2026, investidores sérios precisam de um fluxo de trabalho que possa ler documentos, analisar chamadas de resultados, inspecionar gráficos, comparar avaliações, acompanhar notícias ao vivo, explicar incertezas e produzir uma nota de pesquisa pronta para decisão. É por isso que este guia vai além da hype dos modelos e compara GPT, Gemini, Claude e a abordagem multi-agente usada pela SimianX AI para pesquisa de mercado prática. Ele também testa as três famílias contra 4.992 posições geridas por IA ao vivo da nossa própria sala de comando, porque a comparação mais reveladora não é qual modelo parece mais inteligente, e sim como o treinamento de cada laboratório aparece quando uma posição está perdendo dinheiro.
Por que a Análise de Ações com IA Precisa de Mais de Um Modelo Inteligente
Uma decisão de pesquisa de ações não é apenas um problema de linguagem. É um problema de raciocínio multi-sinal. Um modelo pode resumir bem um 10-K, mas perder um catalisador ao vivo. Outro pode ser excelente na leitura de longo prazo, mas mais fraco na análise de sensibilidade estilo planilha. Um terceiro pode escrever memorandos de investimento polidos, mas depender fortemente da qualidade dos dados conectados.
Para pesquisa de ações com IA, o sistema mais útil deve responder a perguntas como:
- O que mudou na última chamada de resultados?
- Os múltiplos de avaliação estão se expandindo mais rápido do que a receita ou o fluxo de caixa livre?
- O momentum é suportado pelo volume, ou a ação do preço é frágil?
- O sentimento das notícias contradiz os fundamentos?
- Quais suposições impulsionam os casos de alta e baixa?
- O que tornaria a tese errada?
Principais conclusões: A melhor IA para análise de ações geralmente não é um único modelo. É um fluxo de trabalho que combina dados frescos, raciocínio especializado, citações transparentes, verificações de risco e revisão humana.
Este é o ponto onde a análise de ações com múltiplos agentes se torna importante. O SimianX AI utiliza uma abordagem de múltiplos agentes para ajudar os investidores a comparar fundamentos, estrutura de mercado, sinais técnicos, sentimento e risco de uma maneira mais estruturada do que uma única resposta de chatbot.
GPT vs Gemini vs Claude para Análise de Ações com IA: Veredicto Rápido
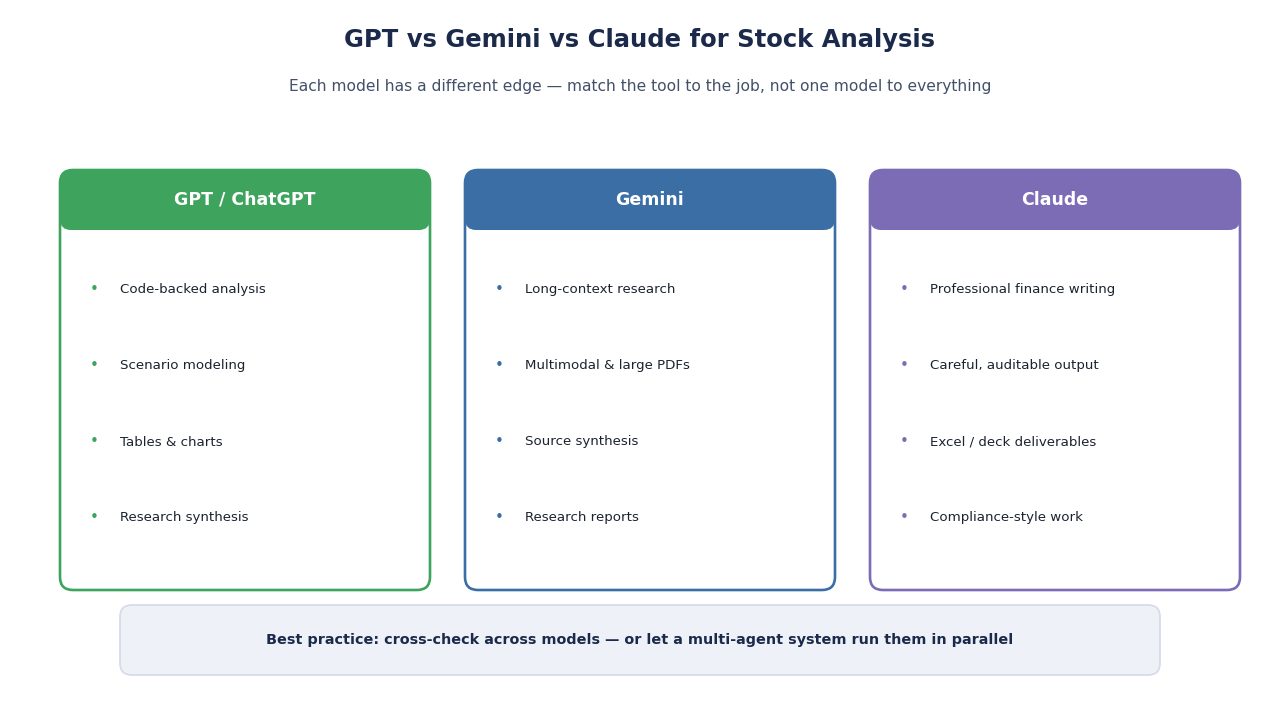
Cada família de modelos tem um “melhor uso” diferente na pesquisa de ações. A resposta prática depende de se você precisa de análise de dados, pesquisa de longo prazo, integração de fluxo de trabalho financeiro ou debate de múltiplos agentes.
| Plataforma | Caso de uso mais forte para análise de ações | Cuidados | Melhor combinado com |
|---|---|---|---|
| GPT / ChatGPT | Análise apoiada por código, modelagem de cenários, tabelas, gráficos, síntese de pesquisa | Necessita de fontes verificadas e design cuidadoso de prompts | Verificações de dados estilo Python, documentos, modelos de avaliação |
| Gemini | Pesquisa de longo prazo, multimodal, PDFs grandes, relatórios de pesquisa, gráficos | A qualidade da saída depende da seleção de fontes e configuração | Conjuntos de documentos grandes, mapas de mercado, síntese de notas de analistas |
| Claude | Fluxos de trabalho financeiros profissionais, escrita cuidadosa, entregas estilo Excel/PowerPoint | Recursos financeiros empresariais podem depender de acesso/conectores pagos | Memorandos de investimento, pitchbooks, revisão de modelos, fluxos de trabalho de conformidade |
| SimianX AI | Análise de ações com múltiplos agentes com camadas técnicas, fundamentais, de notícias e debate | Ainda requer julgamento do investidor; nenhuma IA pode garantir retornos | Traders e pesquisadores que desejam diversidade de modelos em um único fluxo de trabalho |
Os modelos GPT da OpenAI são frequentemente úteis para raciocínio financeiro estruturado, análise de dados personalizada e modelagem de cenários. O Google Gemini é atraente para pesquisas amplas e pesadas em documentos, especialmente ao comparar arquivos, relatórios, imagens e contextos longos. O Claude é forte quando a saída precisa parecer um memorando financeiro profissional, esboço de pitchbook ou resumo de comitê de investimentos.
GPT para Análise de Ações: Melhor para Trabalho de Dados e Modelagem de Cenários
GPT é especialmente útil quando a tarefa de pesquisa envolve transformar dados financeiros desordenados em análises estruturadas. Em um fluxo de trabalho de pesquisa de ações, isso pode significar inspecionar arquivos enviados, criar tabelas e gráficos, calcular taxas de crescimento e explicar suposições em linguagem simples. O GPT pode ajudar a analisar o histórico de preços exportados, limpar um CSV de métricas trimestrais ou construir um modelo simples de fluxo de caixa descontado a partir de suposições fornecidas pelo usuário.
Por exemplo, um fluxo de trabalho de ações com GPT pode parecer assim:
- Faça o upload de uma planilha de receita, margem bruta, lucro operacional, fluxo de caixa livre e contagem de ações.
- Peça ao GPT para calcular o crescimento composto, tendências de margem e conversão de fluxo de caixa livre.
- Pergunte sobre suposições de cenário otimista, base e pessimista.
- Gere uma tabela de avaliação usando
EV/Vendas,EV/EBITDAouP/L. - Compare a saída com os registros reais e dados de mercado.
A maior vantagem do GPT é o raciocínio flexível com análise apoiada por código. Ele é muito bom em transformar entradas brutas em cálculos, gráficos e explicações escritas. Para investidores que já possuem dados de registros da SEC, APIs financeiras ou uma planilha, o GPT pode se tornar um poderoso assistente de pesquisa.
No entanto, o GPT não é automaticamente um selecionador de ações confiável. Se você perguntar: “Devo comprar NVDA hoje?” sem fornecer um horizonte de tempo, tolerância ao risco, contexto de portfólio ou fonte de dados ao vivo, a resposta pode soar confiante, mas ainda assim ser incompleta. Use o GPT para construção de análises, não para execução de negociações cegas.
Quando você deve usar o GPT para pesquisa no mercado de ações?
Use GPT quando você precisar modelar, calcular, explicar e documentar. Funciona bem para telas personalizadas, análise de cenários, modelos de resumo de lucros, tabelas de exposição de portfólio e explicações em linguagem simples de razões complexas. Também é útil para verificar se sua própria tese tem suposições faltantes.
Um forte prompt GPT para análise de ações pode ser:
Analise os últimos 12 trimestres de receita, margem bruta, margem operacional, fluxo de caixa livre, dívida e número de ações desta empresa. Identifique quebras de tendência, calcule faixas de avaliação de alta/base/baixa e liste as cinco suposições mais propensas a estar erradas.
Esse prompt funciona porque pede uma análise estruturada, cálculos e incerteza, não apenas uma resposta de compra/venda.
Gemini para Análise de Ações: Melhor para Pesquisa de Longo Prazo e Síntese de Fontes
A principal vantagem do Gemini é pesquisa multimodal de longo contexto. Para análise de ações, isso é importante porque a pesquisa de empresas públicas muitas vezes abrange relatórios anuais, documentos trimestrais, transcrições, vídeos de produtos, PDFs regulatórios, comentários de analistas e documentos macro. Um modelo que pode processar grandes janelas de contexto pode comparar muito mais material de origem em um único fluxo de trabalho.
Isso torna o Gemini útil para perguntas como:
- “Compare os últimos três relatórios anuais da
AAPL,MSFTeGOOGLem relação à linguagem de capex de IA.”
- “Resuma cada mudança de fator de risco ao longo de dois anos de documentos.”
- “Crie um mapa de mercado da exposição da cadeia de suprimentos de semicondutores.”
- “Extraia e compare o tom da gestão de cinco transcrições de chamadas de lucros.”
- “Construa um resumo de pesquisa amigável para gráficos a partir de múltiplos PDFs.”
O Gemini é mais forte quando a tarefa é ampla, rica em documentos e multimodal. Pode ajudar investidores a encontrar padrões em grandes corpora de pesquisa que seriam tediosos de inspecionar manualmente.
A atenção é que a capacidade de contexto amplo não significa automaticamente um melhor julgamento de investimento. Se as fontes estão desatualizadas, tendenciosas, promocionais ou incompletas, a saída ainda pode ser falha. Na pesquisa de ações, a seleção de fontes é parte da análise. O Gemini é poderoso quando você o alimenta com documentos de alta qualidade, transcrições, dados de mercado e fontes de pesquisa.
Claude para Análise de Ações com IA: Melhor para Fluxos de Trabalho Financeiros Profissionais
A vantagem do Claude é a disciplina de fluxo de trabalho. O Claude é frequentemente útil quando a pesquisa financeira deve se tornar um entregável escrito polido, como um memorando de investimento, resumo de lucros, atualização de portfólio ou nota de due diligence. Seu estilo de escrita pode ser cuidadoso, equilibrado e fácil de adaptar para leitores profissionais.
Isso torna o Claude valioso para:
- Redigir memorandos de investimento com raciocínio equilibrado
- Revisar metodologia de avaliação
- Construir ou verificar modelos financeiros
- Preparar saídas no estilo de pitchbook
- Resumir transcrições de lucros
- Criar comentários prontos para o conselho ou clientes
- Testar uma tese antes de uma reunião do comitê de investimento
A limitação do Claude é o acesso prático. Os fluxos de trabalho mais específicos de finanças podem depender de conectores disponíveis, recursos pagos ou uploads manuais. Para um investidor individual, o Claude ainda pode ser excelente para raciocínio e escrita, mas o pipeline de dados pode exigir ferramentas externas.
Qual é a Melhor Maneira de Comparar GPT vs Gemini vs Claude para Análise de Ações com IA?
A melhor maneira de comparar esses modelos não é pedindo a cada um deles uma escolha de ações. Um teste melhor é dar a cada modelo a mesma tarefa de pesquisa e avaliar a saída com base em evidências, cálculos, consciência de risco e utilidade.
Use esta estrutura de avaliação:
| Fator de avaliação | O que verificar | Por que isso importa |
|---|---|---|
| Atualização de dados | Ele usa registros, notícias e preços atuais? | Dados antigos podem quebrar uma tese de negociação |
| Qualidade da fonte | As citações são de registros, comunicados da empresa, dados financeiros confiáveis ou notícias respeitáveis? | Fontes fracas criam conclusões fracas |
| Precisão numérica | As razões, taxas de crescimento e tabelas de avaliação estão corretas? | Pequenos erros de cálculo podem mudar a tese |
| Análise de risco | Ele explica pontos de desvantagem, incerteza e invalidação? | Boa pesquisa não é apenas evidência otimista |
| Transparência | Você pode rastrear por que o modelo chegou à sua conclusão? | Auditabilidade ajuda a prevenir confiança cega |
| Ação | Ele fornece próximos passos, não apenas um resumo? | Investidores precisam de decisões, listas de observação e gatilhos |
Um teste de comparação simples:
- Escolha um ticker, como
TSLA,NVDAouAAPL. - Colete o mesmo pacote de fontes: último 10-K/10-Q, transcrição de lucros recente, um ano de dados de preços, notícias recentes e métricas de avaliação chave.
- Pergunte ao GPT, Gemini e Claude para produzir a mesma saída: tese, principais fatores, riscos, faixa de avaliação e o que mudaria a conclusão.
- Verifique cada número contra o pacote de fontes.
- Compare qual saída é mais útil para seu processo de investimento real.
O modelo que soa mais confiante nem sempre é o modelo mais correto. Para análise de ações, o vencedor é o sistema que é mais fácil de verificar.
O que 4.992 operações reais de IA revelam sobre como cada laboratório treina
Tudo acima é o argumento qualitativo. A pergunta difícil é se essas diferenças realmente aparecem nos resultados — então fomos aos nossos próprios registros.
A SimianX opera uma sala de comando ao vivo na qual modelos de IA assumem posições reais e monitoradas, com entradas, stop-loss e alvos definidos. Entre 22 de janeiro e 28 de agosto de 2026, esse sistema encerrou 4.992 posições, gerando 20.016 registros modelo-posição de 35 modelos e 6 provedores.
Leia esta seção corretamente: medimos o estilo da casa, não a habilidade de operar
Duas ressalvas determinam como você deve usar esses números, e ambas importam mais do que os próprios números.
Primeira: nenhum laboratório entrega hoje um modelo treinado especificamente para operar. GPT, Gemini, Claude, Grok, DeepSeek e Qwen são sistemas de propósito geral aos quais se pede um trabalho para o qual nenhum deles foi otimizado. Portanto, uma tabela de taxas de acerto não é um ranking de habilidade de negociação. O que ela realmente expõe é o temperamento de cada casa: a maneira como as escolhas de treinamento e alinhamento de uma organização fazem seus modelos se comportarem quando são forçados a agir sob incerteza e com consequências reais. Com que rapidez ele admite que errou? O quanto ele hesita? Ele se compromete com um número? Essa disposição é uma impressão digital do laboratório, e não da versão do modelo — por isso ela tende a persistir entre lançamentos, e por isso é um guia mais confiável sobre como o próximo modelo daquele laboratório vai se comportar do que qualquer pontuação de benchmark.
Segunda: essas são posições de criptomoedas, não de ações. Publicamos isso em um guia de pesquisa de ações porque a propriedade que está sendo medida — a postura de raciocínio sob incerteza — pertence ao modelo, não ao ativo. Criptomoedas negociam 24/7, o que produz uma amostra utilizável em meses em vez de anos. Trate a direção dessas conclusões como transferível para a pesquisa de ações, e os percentuais absolutos como específicos de cripto. O ranking completo é público no Leaderboard Cripto da SimianX, e detalhamos a metodologia em Qual Modelo de IA Negocia Melhor? 30 LLMs por P&L Real.
Notas de método: "decisivas" exclui posições encerradas no zero a zero. Uma mesma posição pode envolver vários modelos em funções de agente diferentes, então ela pode ser contada para mais de um provedor — a mesma convenção usada pelo nosso leaderboard público. Os modelos não foram atribuídos aleatoriamente; os usuários os escolheram, de modo que a mistura de prazos e instrumentos difere conforme o modelo. Esse fator de confusão acaba sendo a descoberta mais importante de todo o conjunto de dados.
Descoberta 1 — Em precisão bruta, as famílias líderes são indistinguíveis
| Modelo | Posições encerradas | Taxa de acerto | P&L médio por posição |
|---|---|---|---|
gpt-4o-mini | 4.340 | 59,0% | +0,075% |
gemini-2.5-flash-lite | 4.458 | 58,8% | +0,080% |
grok-4-1-fast-non-reasoning | 2.647 | 57,1% | +0,085% |
No nível do provedor o quadro é idêntico: OpenAI 58,7%, xAI 58,6%, Google 58,3% — cada um sobre cerca de 4.500 posições decisivas. Uma diferença de 0,4 ponto em amostras desse tamanho é ruído, não vantagem.
Se você veio procurando "qual modelo ganha", essa é a resposta, e ela é decepcionante: no nível dos resultados realizados, trocar GPT por Gemini quase não muda nada.
Descoberta 2 — A configuração importa cerca de 25x mais do que o modelo
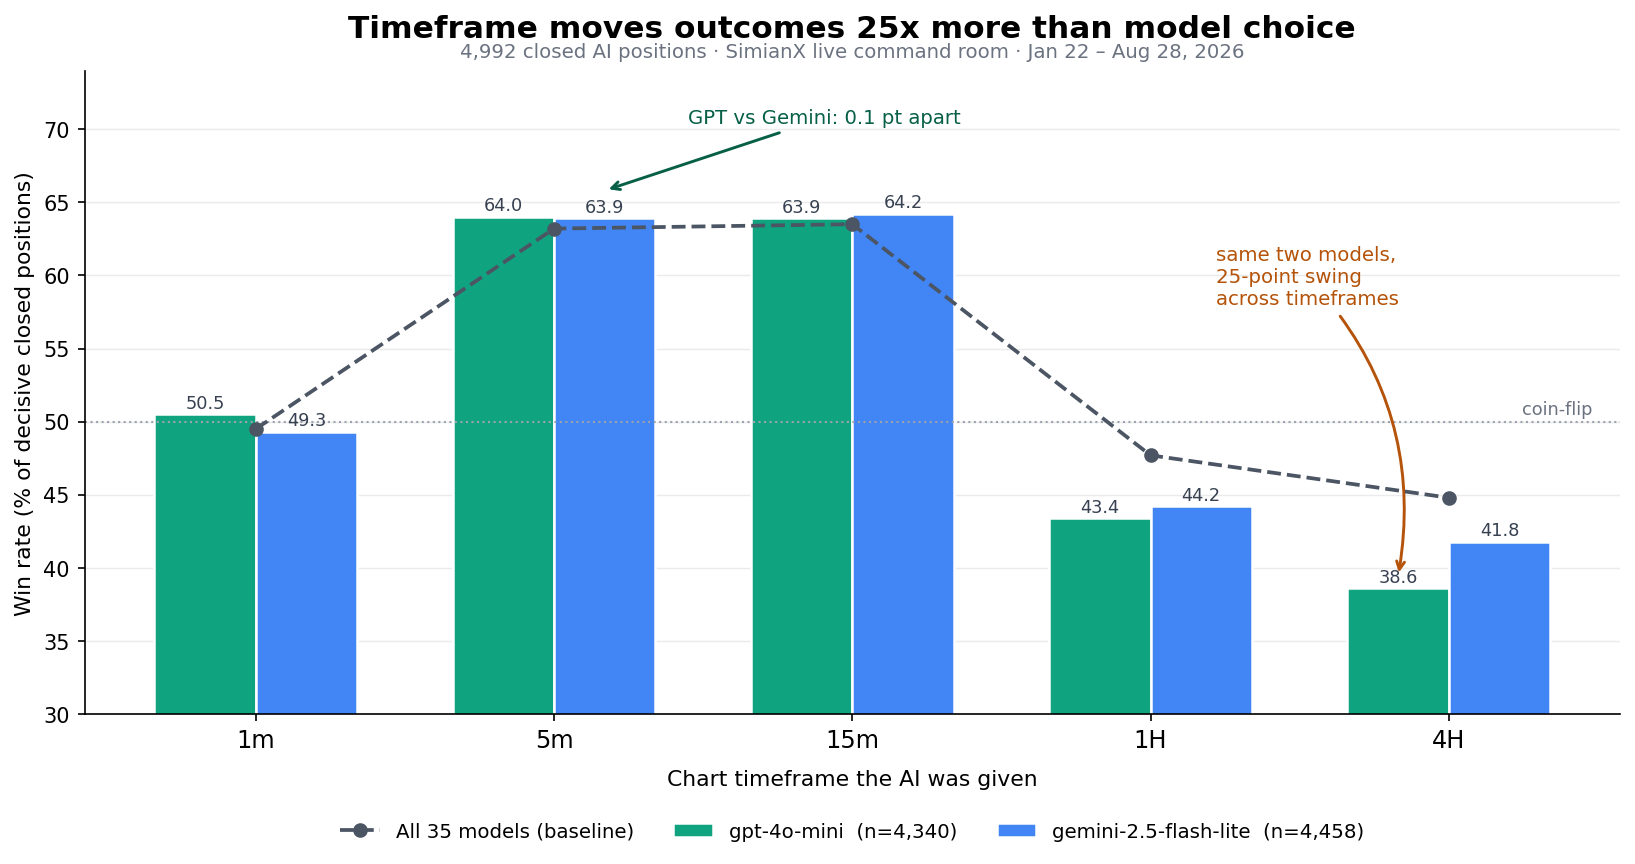
Os mesmos dois modelos, organizados pelo prazo do gráfico que receberam:
| Prazo | gpt-4o-mini | gemini-2.5-flash-lite | Todos os 35 modelos |
|---|---|---|---|
| 1m | 50,5% | 49,3% | 49,5% |
| 5m | 64,0% | 63,9% | 63,2% |
| 15m | 63,9% | 64,2% | 63,5% |
| 1H | 43,4% | 44,2% | 47,7% |
| 4H | 38,6% | 41,8% | 44,8% |
Os dois modelos acompanham um ao outro dentro de aproximadamente um ponto em cada célula. O mesmo modelo oscila 25 pontos entre seu melhor prazo e o pior.
Essa é a coisa mais útil do conjunto de dados, e ela se transfere diretamente para a pesquisa de ações: antes de culpar o modelo, verifique a configuração. Uma resposta fraca é muito mais frequentemente uma pergunta mal formulada — horizonte errado, pacote de evidências errado, contexto errado — do que um modelo fraco.
Descoberta 3 — Os números de manchete mentem até você controlar a configuração
Claude é o exemplo prático. O claude-haiku-4-5 registra uma taxa de acerto de manchete de 52,4%, o que se lê como uma derrota clara para GPT e Gemini. Mas 66% de suas posições rodaram no gráfico de 1 minuto — o pior prazo do conjunto de dados para todos os modelos testados. Compare o comparável e o Claude marca 52,8% no 1m contra uma base de 49,5% de todos os modelos: acima da média na configuração que ele efetivamente recebeu.
Nada na tabela bruta era falso. Era simplesmente uma comparação não pareada. Qualquer artigo do tipo "nós testamos os modelos" que não controle a tarefa está relatando a mistura, não a capacidade.
Descoberta 4 — Mesma precisão, temperamento completamente diferente
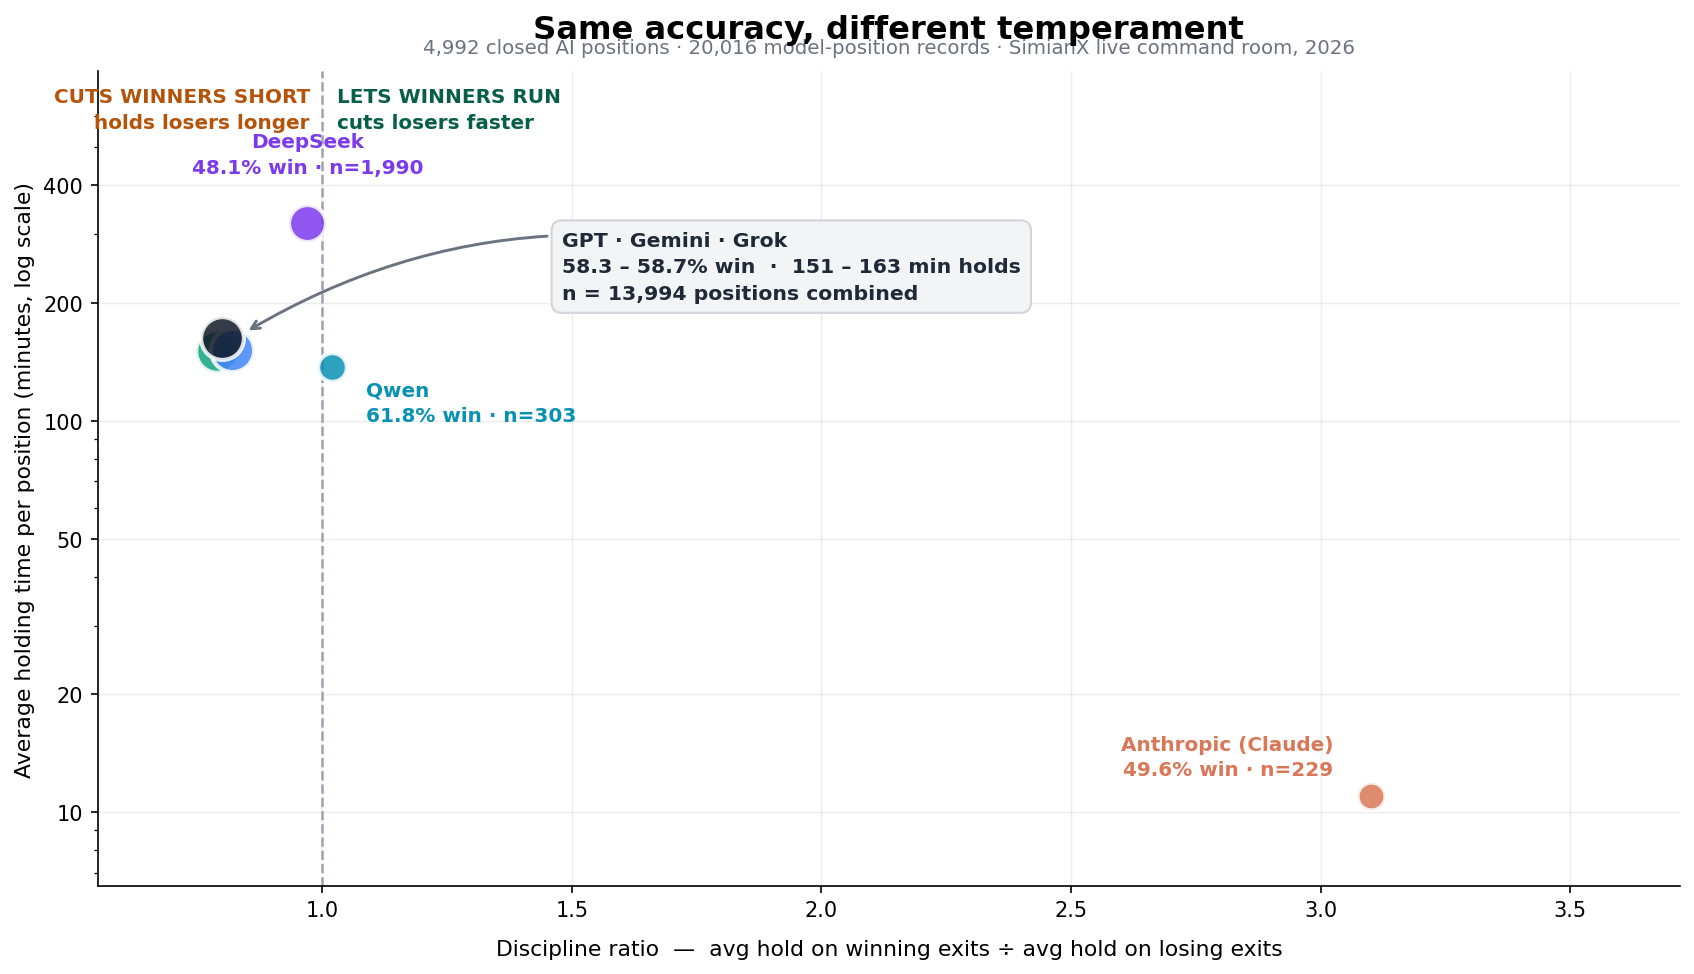
Onde as famílias realmente se separam é no comportamento.
| Família | Tempo médio | Stop acionado | Confiança média | Marca "risco alto" | Índice de disciplina* |
|---|---|---|---|---|---|
| OpenAI (GPT) | 151 min | 22,7% | 0,604 | 3% | 0,79 |
| Google (Gemini) | 152 min | 23,5% | 0,682 | 9% | 0,82 |
| xAI (Grok) | 163 min | 22,5% | 0,678 | <1% | 0,80 |
| Anthropic (Claude) | 11 min | 32,3% | 0,677 | 0% | 3,10 |
| DeepSeek | 320 min | 21,5% | 0,645 | 1% | 0,97 |
| Qwen | 137 min | 38,3% | 0,684 | 2% | 1,02 |
*Índice de disciplina = tempo médio de permanência nas saídas vencedoras ÷ tempo médio nas saídas perdedoras. Abaixo de 1,0 significa que o modelo ficou mais tempo com os prejuízos do que com os lucros.
Três coisas se destacam.
GPT, Gemini e Grok herdam o pior hábito do investidor de varejo. Cada um segura posições perdedoras por mais tempo do que as vencedoras — 68 minutos contra 54 na OpenAI, 64 contra 52 no Google. Esse é o efeito disposição, a mesma relutância em realizar um prejuízo que custa dinheiro a operadores humanos, reproduzida por modelos treinados majoritariamente em escrita humana.
A Anthropic é a exceção, e na direção certa. O Claude corta uma posição perdedora em média em 7 minutos e segura uma vencedora por 21 — um índice de disciplina de 3,10, gestão de risco de manual. É também a família mais disposta a errar rápido, o que aparece como uma taxa elevada de stops acionados. Sua taxa de acerto de manchete mais baixa não é descuido: é a aritmética de assumir muitos prejuízos pequenos e rápidos nas configurações mais difíceis.
A OpenAI é a mais bem calibrada. O GPT reporta uma confiança média de 0,604 contra cerca de 0,68 de todos os outros — a família com menor probabilidade de dizer que tem certeza. Para trabalho de pesquisa, isso é uma virtude, não uma fraqueza.
O Gemini é o mais disposto a levantar a mão: ele marca uma configuração como "risco alto" em 9% das decisões — três vezes mais que a OpenAI, e infinitamente mais que o Claude, que não usou o rótulo nenhuma vez nesta amostra.
Mais um resultado válido para todo o sistema: nas seis famílias, os alvos de realização de lucro foram atingidos em apenas 1,5-2,8% das posições. Os modelos de todos os laboratórios gerenciam as saídas de forma esmagadora por julgamento ao vivo, em vez de deixar um alvo pré-definido fazer o trabalho. Se isso é disciplina ou interferência é exatamente o tipo de pergunta que uma revisão com múltiplos agentes foi feita para revelar, e examinamos a versão dessa questão em cenários de colapso em Modelos de IA vendem em pânico numa queda?.
Aviso sobre tamanho de amostra: Anthropic (229 posições) e Qwen (303) têm amostras muito menores que as dos três grandes (mais de 4.500 cada). Leia essas duas linhas como indicativas, não como definitivas.
Descoberta 5 — Modos de raciocínio não ajudaram em horizontes curtos
Mantendo o laboratório constante e variando apenas o modo de raciocínio:
| Modelo | Posições | Taxa de acerto | Tempo médio |
|---|---|---|---|
grok-4-fast-non-reasoning | 1.356 | 68,4% | 13 min |
grok-4-1-fast-reasoning | 1.733 | 61,5% | 240 min |
deepseek-chat | 1.486 | 49,1% | 205 min |
deepseek-reasoner | 389 | 44,4% | 766 min |
Nos dois laboratórios, a variante de raciocínio estendido se saiu pior em decisões de horizonte curto do que sua irmã mais rápida. Deliberação mais longa produziu posições mais longas e mais tempo para a tese se deteriorar — não entradas melhores. Para pesquisa de ações lenta e cheia de documentos, o equilíbrio muito provavelmente se inverte, mas não presuma que um modelo de raciocínio seja automaticamente o melhor instrumento para uma decisão sensível ao tempo.
Descoberta 6 — Cada laboratório tem uma assinatura de escrita reconhecível
Em 1.581 registros de decisão nos quais o modelo decisor é atribuível, a própria prosa entrega cada laboratório.
O GPT hesita. Cerca de metade de suas justificativas se apoia em formulações brandas, e ele raramente se compromete com um preço:
"A análise sugere uma posição comprada devido a possíveis reversões de alta no curto prazo, apoiadas pelo RSI e pelo sentimento das notícias, apesar da tendência de baixa geral. A configuração oferece uma relação risco-retorno razoável."
O Gemini se compromete com números. Ele nomeia um nível específico em 12% das justificativas, cerca do dobro da maioria dos rivais:
"Vender a descoberto com base no gráfico de 15 minutos, que mostra tendência de baixa e indicadores técnicos de baixa. O alvo de lucro está em 89.120,00."
O Claude é o mais específico tecnicamente e o menos hesitante — apenas 32% de suas justificativas usam linguagem de ressalva, contra 51-63% de todas as outras famílias:
"A análise sugere uma posição vendida devido a um ponto de rompimento com evidência estrutural de baixa, como topos descendentes, retomadas fracassadas da EMA50 e volume declinante. É necessária confirmação antes da entrada."
O Grok delimita suas previsões no tempo. Ele anexa uma janela explícita a 11% das decisões, contra 2-6% dos demais:
"Posição vendida recomendada devido a sinais de baixa, resistência em 9,0 e potencial de queda do preço até 8,93 nos próximos 45-95 minutos."
Repare no que essas coisas são: disposições estilísticas, não capacidades. Elas refletem o que o pós-treinamento de cada laboratório recompensou — cautela na OpenAI, decisão e sinalização explícita de risco no Google, precisão estrutural e admissão rápida de prejuízo na Anthropic, e enquadramento comprometido e delimitado no tempo na xAI. Essas preferências são propriedades estáveis da casa. E como nenhum deles foi ajustado para mercados, elas são a coisa mais próxima de uma previsão de como o próximo modelo de cada laboratório vai se comportar quando você o apontar para uma ação.
O cartão de pontuação de 6 eixos: transforme a estrutura em um número
Pontue o resultado de pesquisa de qualquer modelo nos seis fatores da estrutura de avaliação acima, de 1 a 5 cada, e depois pondere-os pelo estrago que uma falha naquele eixo realmente causa:
| Eixo | Peso | Pontua 1 | Pontua 5 |
|---|---|---|---|
| Atualização de dados | 25% | Afirmações sem data | Cada número datado e com fonte |
| Precisão numérica | 25% | Os números não batem com o registro | Cada número fecha |
| Qualidade da fonte | 15% | Sem atribuição ou nível de blog | Registros primários e comunicados da empresa |
| Análise de risco | 15% | Apenas o cenário otimista | Níveis de invalidação explícitos |
| Transparência | 10% | Conclusão sem cadeia visível | Cada passo rastreável |
| Ação | 10% | Apenas um resumo | Gatilhos, níveis e cadência de acompanhamento |
Some o total ponderado sobre 5. Qualquer coisa abaixo de 3,5 volta para outra rodada. Qualquer coisa acima de 4,5 que ainda não tenha um ponto de invalidação nomeado costuma ser excesso de confiança, e não excelência. Rode o mesmo ticker por duas famílias e pontue as duas — com base nos dados acima, espere que as pontuações fiquem próximas e que o estilo da falha seja diferente.
O que isso realmente significa para sua pesquisa de ações
- Pare de procurar o melhor modelo; comece a consertar a configuração. Um efeito de 25 pontos vindo do prazo contra um efeito de 0,4 ponto vindo do modelo é todo o argumento a favor de investir em fluxo de trabalho em vez de seleção de modelo.
- Combine o laboratório com a tarefa por temperamento, não por benchmark. Quer uma segunda opinião que avise quando está insegura? Use a família mais bem calibrada. Quer um relatório que se comprometa com níveis? Use a que nomeia números. Quer um revisor de risco que admita que a tese quebrou? Use a que corta prejuízos em sete minutos.
- Espere que o estilo da casa persista. Como nenhum laboratório treina especificamente para esta tarefa, o que você observa é disposição geral — e ela vai se transferir para o próximo lançamento deles.
- Use mais de um, e faça-os discordar às claras. As famílias falham de maneiras diferentes, e é exatamente por isso que um debate entre elas revela mais do que qualquer resposta isolada.
Por que a SimianX AI adota uma abordagem de múltiplos agentes
Um único modelo pode resumir, calcular e escrever. Mas a análise de ações muitas vezes se beneficia do desacordo de especialistas. Um sinal técnico pode parecer otimista enquanto a avaliação parece esticada. O sentimento das notícias pode melhorar enquanto a venda de ações por insiders levanta questões. Um modelo que mistura tudo em uma única resposta muito rapidamente pode esconder esses conflitos.
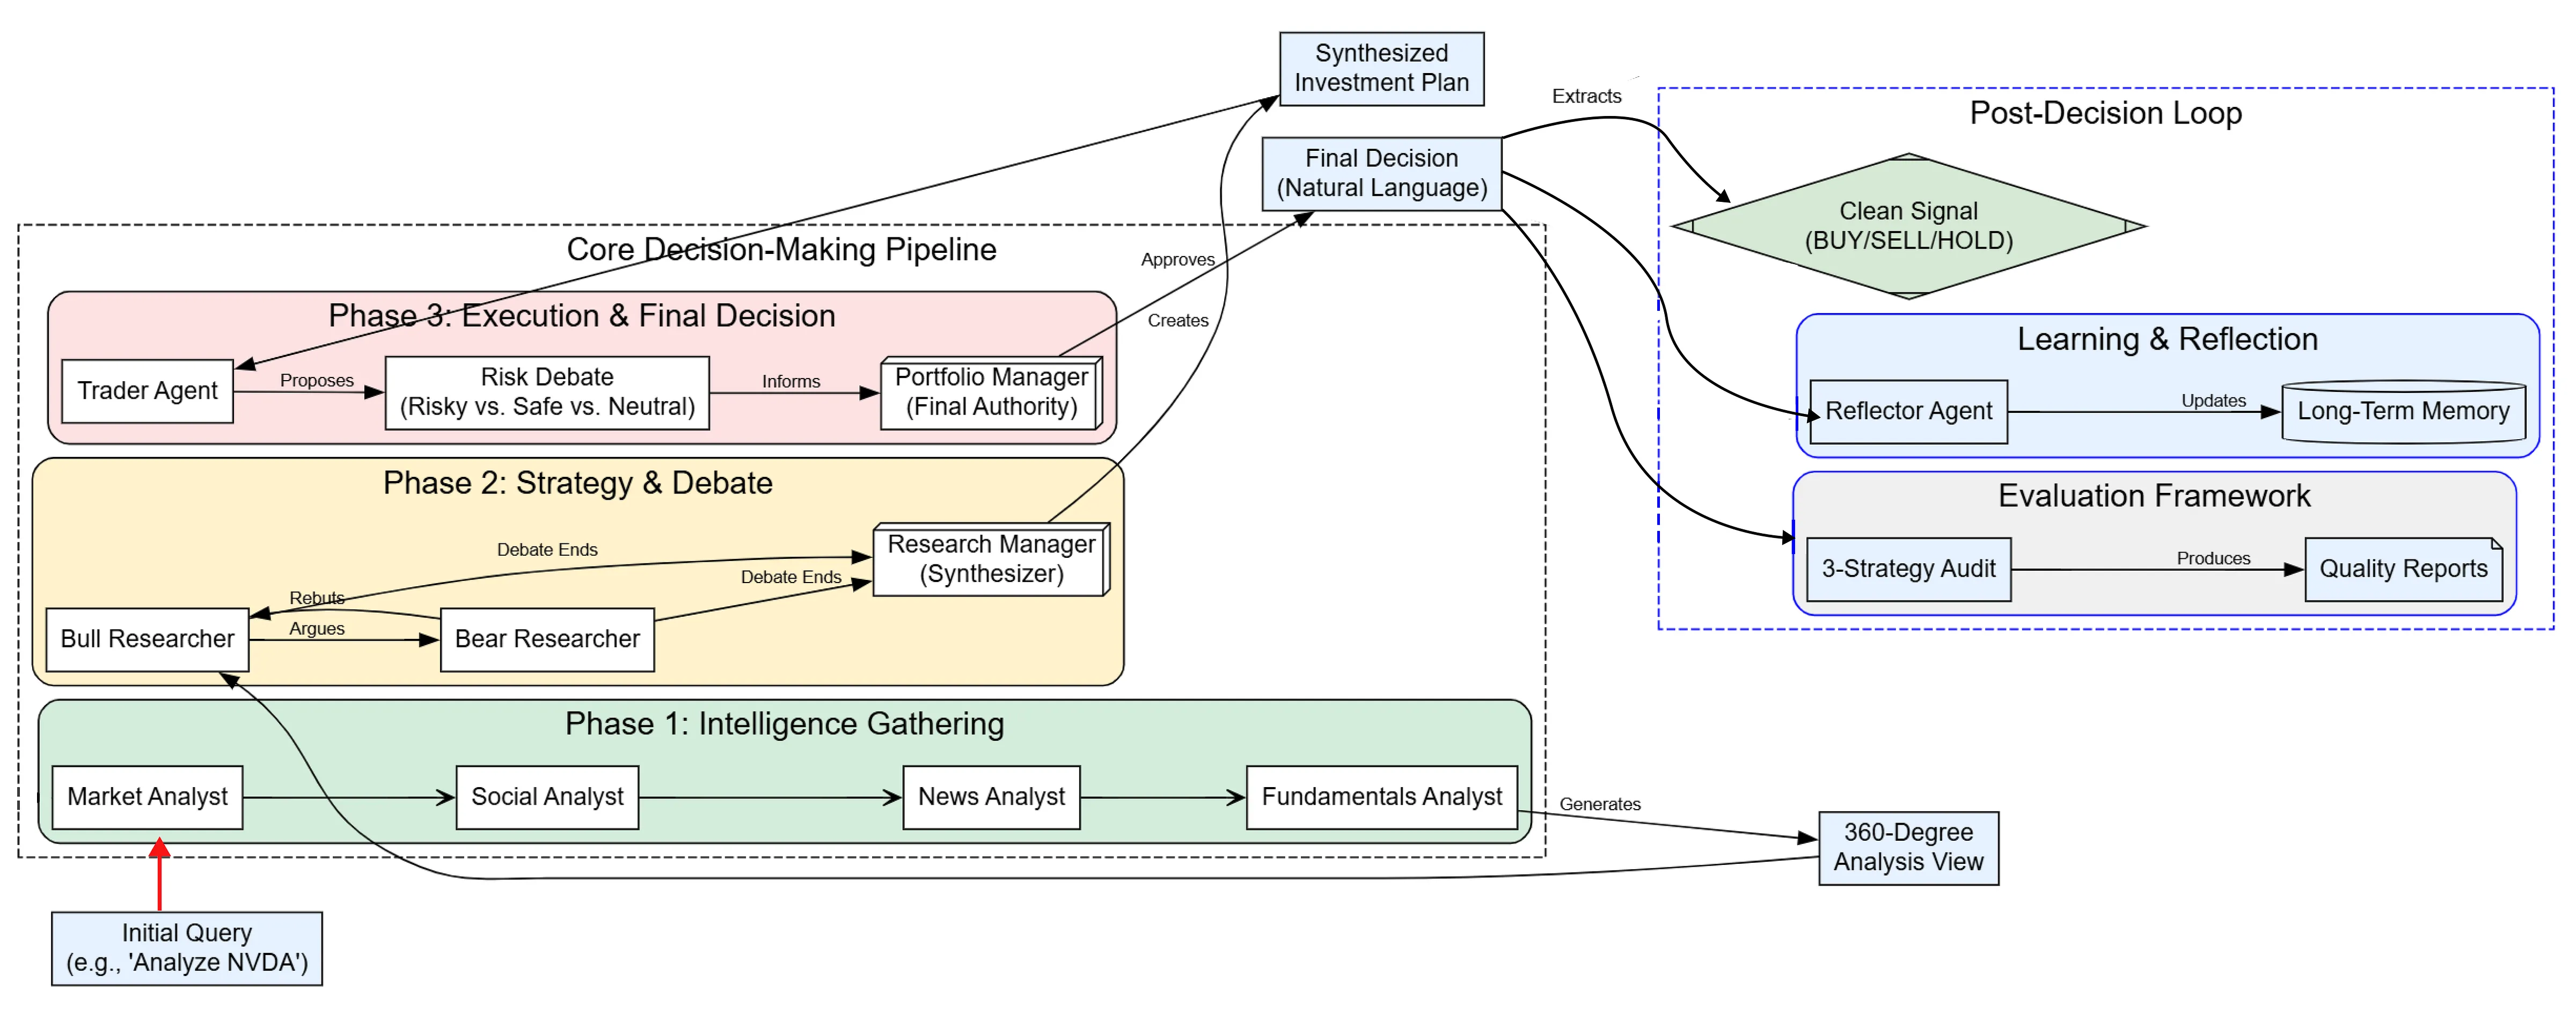
SimianX AI foca na análise de mercado com múltiplos agentes em vez de uma única resposta de chatbot. Seu valor é o design de fluxo de trabalho: agentes especializados podem examinar fundamentos, técnicos, sentimento, notícias e risco, e então comparar suas descobertas antes que um relatório final seja produzido.
Isso é importante porque o melhor fluxo de trabalho de análise de ações com IA deve separar funções:
- Agente fundamental: crescimento da receita, margens, fluxo de caixa livre, alavancagem, avaliação
- Agente técnico:
RSI,MACD, médias móveis, volatilidade, suporte/resistência
- Agente de notícias: catalisadores, atualizações de analistas, registros da SEC, mudanças na gestão
- Agente de risco: quebra de teses, risco de drawdown, preocupações com dimensionamento de posição
- Agente de decisão: integra as evidências em uma linguagem de pesquisa de compra/manutenção/venda
Isso não significa que SimianX AI, GPT, Gemini, Claude ou qualquer plataforma de IA possa garantir retornos. A análise de ações sempre envolve incerteza. A IA deve apoiar uma pesquisa melhor, não substituir a gestão de risco, o dimensionamento de posição ou o julgamento do investidor.
Fluxo de Trabalho Prático de Pesquisa de Ações com IA que Você Pode Usar Hoje
Aqui está um fluxo de trabalho repetível para usar GPT, Gemini, Claude ou SimianX AI sem transformar a IA em um selecionador de ações de caixa-preta.
Passo 1: Comece com a pergunta de investimento
Prompt ruim:
Esta ação é uma compra?
Prompt melhor:
Avalie se a AAPL é atraente para uma operação de swing de 6 a 12 meses com base nos lucros recentes, avaliação, tendência técnica, catalisadores de notícias e risco de queda. Mostre suposições e cite fontes.
O segundo prompt define o ticker, o horizonte de tempo, as dimensões de pesquisa e as evidências necessárias.
Passo 2: Separe fatos da interpretação
Peça à IA para produzir duas seções:
- Fatos: números, datas, registros, declarações da gestão, níveis de preço
- Interpretação: o que esses fatos podem implicar para a tese
Isso reduz o risco de alucinação porque você pode verificar a camada factual antes de ler a camada de opinião.
Passo 3: Forçar um cenário pessimista
Toda análise de ações de IA deve incluir um cenário pessimista sério. Pergunte:
Que evidências tornariam essa tese errada, e quais dados devo monitorar semanalmente?
É aqui que os modelos muitas vezes se tornam mais úteis. Eles ajudam você a converter riscos vagos em pontos de monitoramento concretos.
Passo 4: Usar múltiplos modelos ou agentes
Um fluxo de trabalho robusto pode usar:
- Gemini para digerir um grande pacote de documentos, transcrições e relatórios de mercado.
- GPT para calcular cenários de avaliação e construir tabelas.
- Claude para redigir um memorando de investimento polido e criticar suposições.
- SimianX AI para realizar uma revisão multi-agente e comparar perspectivas técnicas, fundamentais, de notícias e de risco em uma única plataforma.
Passo 5: Verificar antes de agir
A pesquisa de mercado gerada por IA deve sempre ser verificada contra fontes confiáveis. Verifique documentos, dados de mercado, datas de notícias e cálculos antes de tomar qualquer decisão de investimento.
Nunca trate uma recomendação de ações gerada por IA como definitiva. Verifique as fontes, confira os números, entenda os riscos e considere consultar um profissional financeiro licenciado para obter aconselhamento adaptado à sua situação.
GPT vs Gemini vs Claude: Qual deles os investidores devem escolher?
Escolha GPT se você quiser um analista flexível para limpeza de dados, cálculos, explicações de gráficos, tabelas de avaliação e modelagem de cenários. É especialmente útil quando você pode fornecer dados estruturados e deseja raciocínio apoiado por código.
Escolha Gemini se você precisar processar conjuntos de documentos muito grandes, comparar muitos PDFs, sintetizar longos pacotes de pesquisa ou gerar relatórios de pesquisa citados a partir de material de fonte ampla.
Escolha Claude se seu trabalho se parecer com documentação financeira profissional: memorandos de investimento, pitchbooks, revisões de modelos, resumos de lucros e relatórios internos polidos.
Escolha SimianX AI se você quiser que a comparação em si se torne um fluxo de trabalho: múltiplos agentes examinando o mesmo ticker de diferentes perspectivas, debatendo as evidências e produzindo uma saída de pesquisa mais clara.
A resposta mais forte não é “GPT supera Gemini” ou “Claude supera GPT.” A resposta mais forte é:
Use o modelo certo para o trabalho de pesquisa certo, depois combine as saídas por meio de um processo transparente, multi-agente e revisado por humanos.
FAQ Sobre GPT vs Gemini vs Claude para Análise de Ações com IA
O GPT é mais preciso que o Gemini para análise de ações?
Não de forma mensurável. Em 4.992 posições geridas por IA ao vivo, o gpt-4o-mini encerrou com taxa de acerto de 59,0% e o gemini-2.5-flash-lite com 58,8% — uma diferença de 0,2 ponto sobre cerca de 4.300 posições cada, o que é ruído estatístico. Controlando pelo prazo do gráfico, os dois acompanharam um ao outro dentro de aproximadamente um ponto em cada faixa. O que difere é o temperamento, não a precisão: o prazo que você entrega a um modelo moveu os resultados cerca de 25 vezes mais do que a escolha do modelo.
Qual é a melhor IA para pesquisa no mercado de ações em 2026?
Não há um vencedor universal. O GPT é forte para cálculos e análise de dados flexível, o Gemini é forte para pesquisas de longo contexto e síntese de fontes multimodais, e o Claude é forte para fluxos de trabalho financeiros profissionais e entregas polidas. Para muitos investidores, a melhor configuração é uma plataforma multi-agente como o SimianX AI que combina diferentes papéis analíticos.
Como usar IA para pesquisa de ações sem alucinações?
Use pacotes de fontes de alta qualidade, exija citações, separe fatos de interpretações e verifique todos os números em relação a documentos ou dados financeiros confiáveis. Peça ao modelo para mostrar suposições, incertezas e o cenário pessimista. Evite solicitações que peçam previsões “garantidas” sem suporte.
O GPT, Gemini ou Claude podem prever preços de ações com precisão?
Eles podem ajudar a analisar fatores que influenciam o preço, mas nenhum modelo de IA pode prever preços de ações com certeza de forma confiável. Os mercados reagem a lucros, liquidez, choques macroeconômicos, regulamentação, posicionamento e notícias inesperadas. A IA é melhor utilizada para aceleração de pesquisa, não para previsões garantidas.
O SimianX AI é melhor do que usar ChatGPT, Gemini ou Claude sozinhos?
SimianX AI é diferente porque se concentra na análise de mercado de múltiplos agentes em vez de uma única resposta de chatbot. Sua vantagem é o design de fluxo de trabalho: agentes especializados podem examinar fundamentos, técnicos, notícias e riscos, e então comparar as conclusões. Isso pode ser mais prático para investidores que desejam uma pesquisa de ações estruturada e auditável.
Qual modelo de IA é o melhor para analisar documentos da SEC?
Gemini é atraente para conjuntos de documentos muito grandes, GPT é útil para extrair métricas e construir tabelas, e Claude é forte para transformar a análise de documentos em memorandos profissionais. A melhor abordagem é combinar extração, cálculo e síntese escrita, e então verificar cada figura em relação ao documento original.
Conclusão
O debate GPT vs Gemini vs Claude para análise de ações com IA é realmente sobre a qualidade do fluxo de trabalho. GPT é excelente para análise de dados e modelagem de cenários. Gemini é poderoso para pesquisa de longo contexto e síntese de grandes fontes. Claude é forte para redação no estilo financeiro, criação de documentos e resultados de pesquisa profissional. Mas a análise de ações é um problema de múltiplos sinais, o que significa que a melhor resposta muitas vezes vem da combinação de modelos, fontes e perspectivas especializadas.
Esse é o valor central do SimianX AI: ele transforma a pesquisa de ações com IA em um processo de múltiplos agentes onde sinais técnicos, fundamentos, notícias, sentimento e risco podem ser revisados juntos em vez de estarem ocultos dentro de uma única resposta de chatbot. Explore SimianX AI para construir uma abordagem mais transparente, disciplinada e pronta para pesquisa na análise de ações impulsionada por IA.
Leitura Relacionada
- SimianX AI: Plataforma Multi-Agente de Análise de Ações
- 8 Analistas IA vs 1: +37% Acerto, −41% Risco em Bolsa
- Pipelines AI Multi-Agente para Pesquisa Hedge Fund
- Qual Modelo de IA Negocia Melhor? 30 LLMs por P&L Real
- 30+ Modelos IA, 6 Provedores: Live Leaderboard Cripto
- Modelos de IA vendem em pânico numa queda? 31 bots revelam
- IA Multi-Agente vs ChatGPT para NVDA: Comparativo 2026