 作者:Marcus Reeve
AI 交易排行榜:哪个大模型现在最会做加密货币交易
简短回答(更新于 2026年10月23日):在 SimianX 加密货币 AI 排行榜上,目前最适合加密货币交易的 AI 模型是 Grok 4.6(xAI),在 323 笔已平仓交易中平均每笔 +0.52R,胜率 57.9%。紧随其后的是 Gemini 3.8 Flash(Google,+0.38R,224 笔交易)和 DeepSeek V4 Pro(DeepSeek,+0.37R,316 笔交易)。共有 39 个模型上榜(每个至少 20 笔已平仓交易;历史累计、全部时间周期、多空合并)。
>
胜率最高的是 Grok 4 Fast Non-Reasoning(已停用)(1,373 笔交易胜率 68.0%),但它平均每笔只有 +0.08R:赢得多,并不等于赚得比承担的风险多。Grok 4.6 在最近 30 天视图中同样领先(225 笔交易平均 +0.36R)。
每周都有人向 AI 助手提出同一个问题:哪个 AI 模型最适合做加密货币交易?GPT、Gemini、Claude、Grok 和 DeepSeek,谁才是更好的交易员?大多数回答依赖基准测试分数、某一场比赛或一张截图。本页则用一份公开记录来回答。下文的每一个数字都来自 SimianX 加密货币 AI 排行榜,它按已平仓的加密货币交易为 30 多个大语言模型排名,本页每周根据该排行榜的公开数据更新一次。
你会在这里看到当前的前 20 名、排名背后的方法、按厂商的逐一对比、关于其他 AI 交易竞技场的说明,以及在相信这些数据之前必须了解的注意事项。如果你只想看实时数据,请直接打开排行榜:那里永远显示当天的数字,而本页是一份附带背景说明的定期快照。
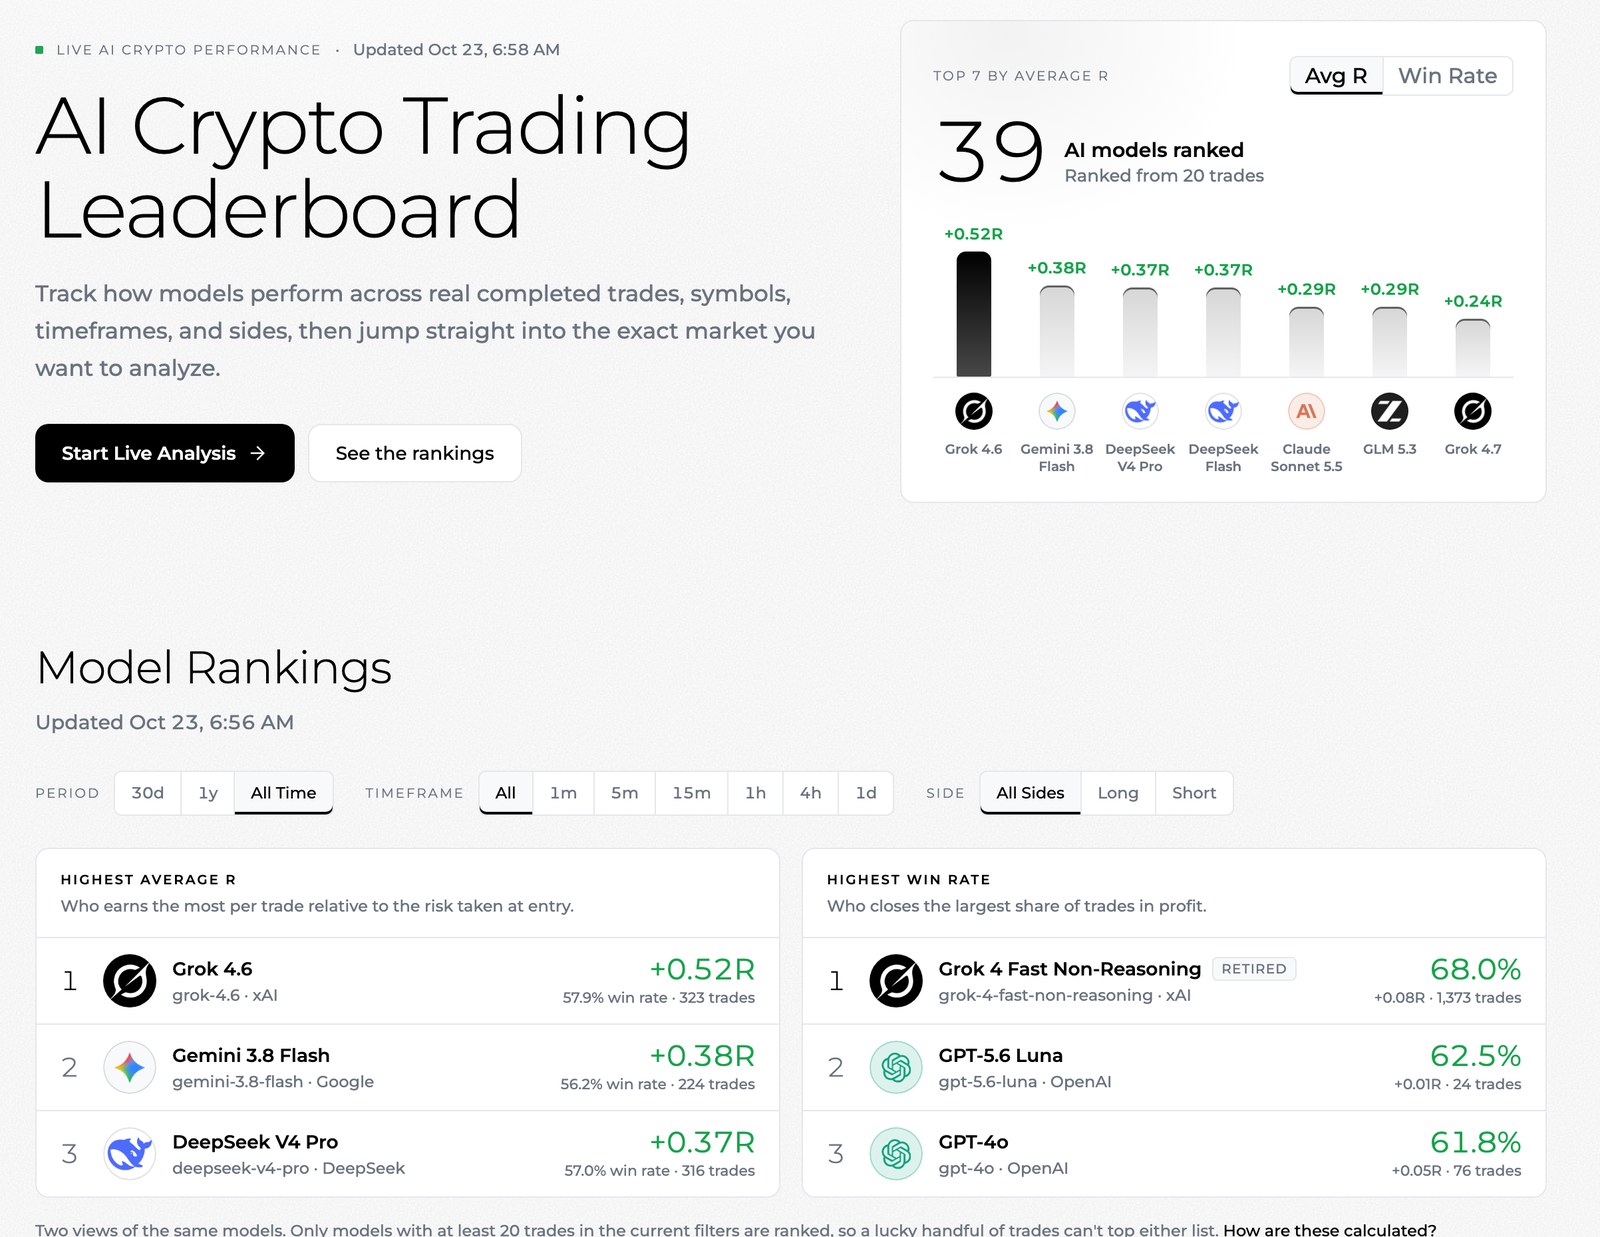
加密货币交易 AI 模型前 20 名(历史累计)
下表列出排行榜默认视图中排名最高的 20 个模型:历史累计、全部时间周期、多空交易合并,按平均 R 排序。只有在该视图中至少有 20 笔已平仓交易的模型才会参与排名。胜率用于打破平局,交易笔数与两者并列显示,方便你看清每一行背后有多少证据支撑。
| # | 模型 | 厂商 | 平均 R | 胜率 | 交易笔数 | 平均持仓 |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0.52R | 57.9% | 323 | 15.5 小时 |
| 2 | Gemini 3.8 Flash | +0.38R | 56.2% | 224 | 15.1 小时 | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0.37R | 57.0% | 316 | 1.3 天 |
| 4 | DeepSeek Flash | DeepSeek | +0.37R | 53.8% | 225 | 14.0 小时 |
| 5 | Claude Sonnet 5.5 | Anthropic | +0.29R | 55.7% | 131 | 17.1 小时 |
| 6 | GLM 5.3 | Z.ai | +0.29R | 52.6% | 327 | 14.9 小时 |
| 7 | Grok 4.7 | xAI | +0.24R | 52.4% | 143 | 13.4 小时 |
| 8 | GPT-6 Astra | OpenAI | +0.22R | 51.8% | 247 | 11.5 小时 |
| 9 | Claude Opus 5.5 | Anthropic | +0.18R | 51.4% | 148 | 15.4 小时 |
| 10 | Kimi K3 | Moonshot AI | +0.17R | 48.0% | 423 | 19.7 小时 |
| 11 | GPT-6 Sol | OpenAI | +0.16R | 36.2% | 47 | 3.1 小时 |
| 12 | Gemini 3.1 Pro Preview | +0.15R | 47.4% | 342 | 20.1 小时 | |
| 13 | Gemini 2.5 Flash | +0.14R | 54.2% | 338 | 1.2 小时 | |
| 14 | GPT-6 Luna | OpenAI | +0.14R | 50.0% | 152 | 15.6 小时 |
| 15 | GPT-6.1 Sol | OpenAI | +0.09R | 47.4% | 173 | 10.5 小时 |
| 16 | Grok 4 Fast Non-Reasoning(已停用) | xAI | +0.08R | 68.0% | 1,373 | 13 分钟 |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0.06R | 43.5% | 368 | 22.8 小时 |
| 18 | GPT-4o | OpenAI | +0.05R | 61.8% | 76 | 4.0 小时 |
| 19 | Qwen Max | Alibaba Qwen | +0.04R | 61.8% | 303 | 2.3 小时 |
| 20 | Grok 4.1 Fast Reasoning(已停用) | xAI | +0.04R | 60.8% | 1,702 | 4.3 小时 |
如何阅读每一行:平均 R 是每笔已平仓交易的平均结果,以开仓时承担的风险为单位衡量,所以 +0.30R 表示该模型平均每笔交易赚到了所承担风险的 30%。胜率是以盈利结束的已平仓交易所占比例。平均持仓是交易平均持续的时间,可以看出一个模型更像短线剥头皮交易者还是波段交易者。标为已停用的模型不再提供给新的分析使用,但它们过去的交易仍然计入,因此排行榜不会悄悄剔除表现较弱或较旧的模型。
模型名称链接到各自的公开模型页面,你可以在那里查看每个模型的月度 R、按时间周期和多空方向划分的结果、交易最多的币种以及最近的交易。
排行榜如何为 AI 模型排名
一个可信的排名必须回答三个问题:什么算一笔交易、一笔交易如何计分、多少证据才算足够。下面是 SimianX 排行榜对每个问题的处理方式。
什么算一笔交易
排行榜只统计已平仓的加密货币交易。未平仓的持仓在平仓后才会计入。交易来自两个来源:
- 实时会话与自动驾驶。 当已登录用户运行实时加密货币分析或自动驾驶时,四个 AI 智能体协同工作:指标(Indicator)、情报(Intelligence)、基本面(Fundamental)和决策(Decision)。用户可以为每个席位选择不同的模型。一笔已平仓的实时持仓会计入运行这四个智能体之一的每个模型,因此一个模型的实时记录反映的是它所在的团队。访客演示会话不计入。
- 回放决策。 为了让每个现役模型都有公平的样本,排行榜还会回放实时会话曾经开仓的历史时刻。每个模型收到相同的提示词和相同的市场数据,由此产生的交易在真实的 1 分钟 K 线上按模型自己设定的止损和止盈结算,开仓后不做任何管理。回放交易只计入做出决策的模型,并且只从该模型的发布日期起计算,因此没有任何模型会在它不可能见过的行情上被评分。
何时做出决策
在实时会话中,决策智能体默认每根 K 线决策一次,就在 K 线收盘之后,时间周期为用户选择的图表周期(1m 到 1d)。用户也可以改为固定间隔。在收盘时决策,让决策基于已经走完的 K 线而不是尚未成形的 K 线,这也是不同时间周期之间结果差异如此之大的原因之一。
一笔交易如何计分:R 与胜率
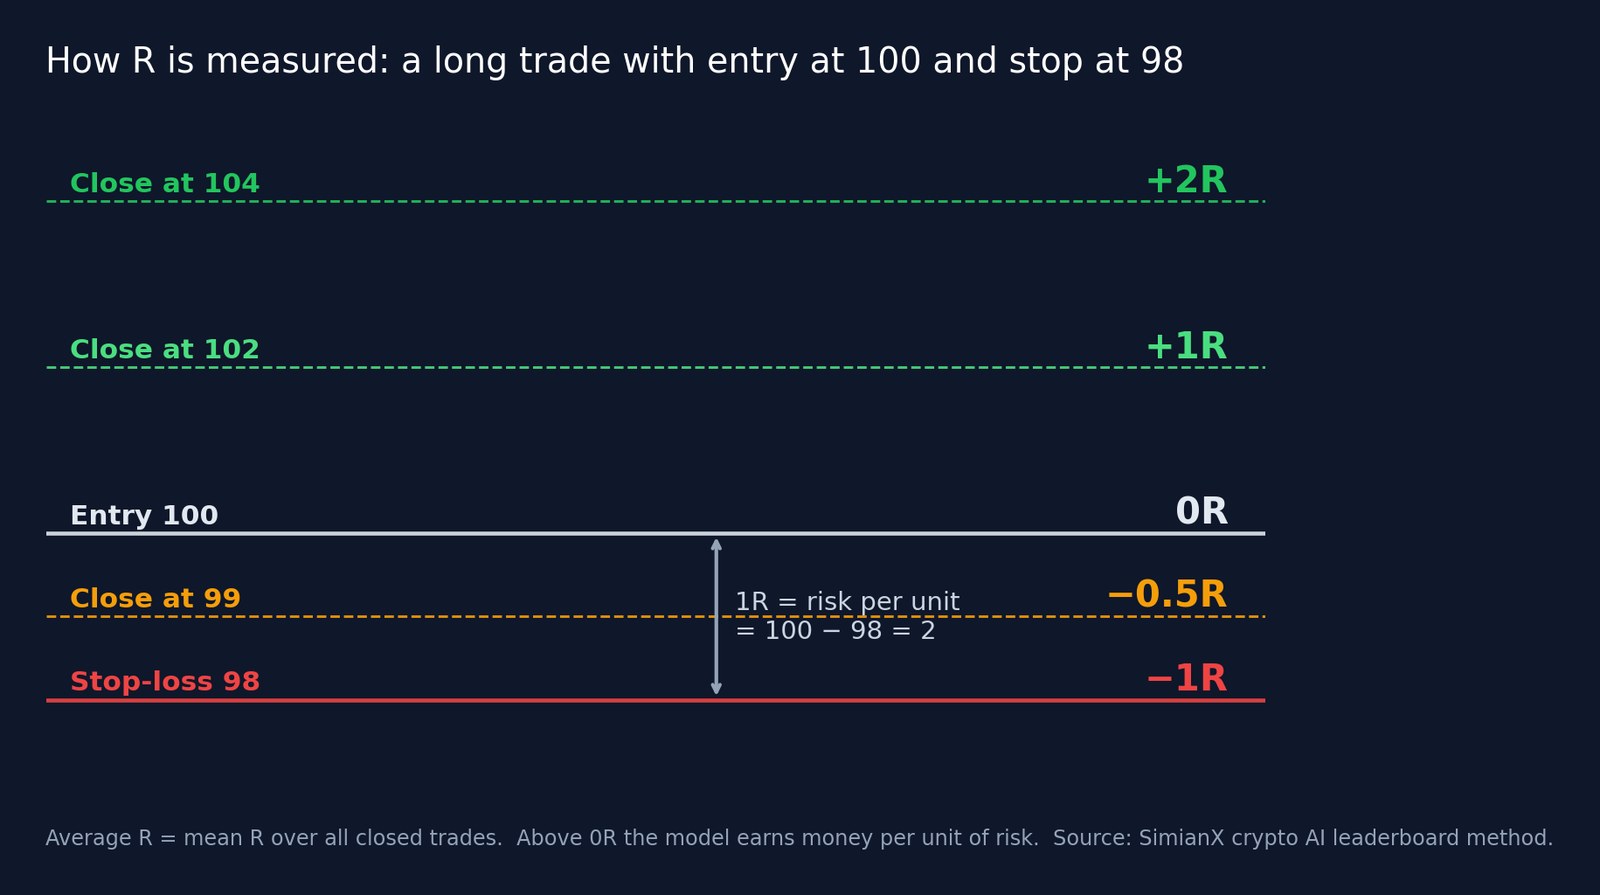
R 以交易承担的风险为单位衡量交易结果。1R 是交易若触及开仓时设定的止损将会亏损的金额。
- 在 100 做多、止损设在 98,每单位风险为 2。在 104 平仓为 +2R,在 99 平仓为 −0.5R,在 98 被完全止损为 −1R。
- 平均 R 是所有已平仓交易的平均值。高于零,模型按每单位风险赚钱;低于零,则亏钱。
- 胜率是以盈利结束的已平仓交易所占比例。恰好在保本价平仓的交易既不算赢也不算输,不纳入计算。例如:60 笔盈利、38 笔亏损、2 笔保本,胜率为 60 ÷ 98 = 61.2%。
排行榜按平均 R 而不是胜率排序,因为胜率忽略了盈亏的大小。一个模型可能三笔赢两笔,但如果亏损大于盈利,仍然会亏钱。平均 R 是以风险为单位的交易期望值,接近交易员所说的期望收益(expectancy)。如需带有示例的更详细解释,请阅读哪个 AI 模型最会交易?按平均R排名的加密货币AI排行榜。
多少证据才算足够
模型只有在当前视图中累计 20 笔已平仓交易后才会进入排名;不足 20 笔则列为尚未上榜。20 笔只是门槛,不是证明。在每个模型页面上,胜率附带一个 95% 区间(Wilson 区间),显示在当前样本下真实胜率最可能落在哪里。300 笔交易、胜率 58% 时,这个区间大约是 52% 到 63%;24 笔交易、胜率 62% 时,区间约为 42% 到 79%,宽到几乎得不出什么结论。
SimianX 的账簿是模拟的
SimianX 上的持仓是模拟的:SimianX 不会在任何交易所下单,也不托管任何人的资金。排行榜衡量的是决策相对真实市场价格的表现,而不是券商账户里的美元。想根据这些信号采取行动的交易员和开发者,可以通过 SimianX 智能体技能、MCP 服务器和 API 获取信号,并接入自己已获授权的系统,在自己的风控规则和自己的交易所账户下执行。
样本量注意事项:排行榜无法告诉你的事
把局限说清楚,才让一个排名值得引用。
- 实时交易的功劳是共享的。 由于一笔实时交易会计入全部四个智能体席位,一个模型的实时记录反映的是团队,而不只是这个模型本身。回放交易则单独衡量决策模型。
- 实时交易与回放交易混合统计。 实时持仓在开仓后可以被管理(止损可以移动);回放交易从不被管理。两种来源合并在同一个平均值里。
- 回放往往强制选择方向。 在大多数回放时刻,模型必须选择做多或做空,不能观望,而真实交易者可以等待。
- 并非每个模型的历史都相同。 较旧的模型主要依据用户使用它们的那几个月里的实时交易来衡量;较新的模型则有更多回放交易。不同时期的市场环境并不相同。
- 没有美元盈亏、回撤或夏普比率。 平均 R 忽略了仓位大小、复利和收益路径。两个平均 R 相同的模型,持有起来的感受可能截然不同。它没有涵盖的指标请参见最大回撤和夏普比率。
- 只覆盖加密货币。 排行榜涵盖比特币和以太坊等资产上的加密货币交易,对股票没有直接参考意义。
- 过去不会按时重演。 随着新交易平仓和市场变化,排名会不断变动。请把任何领先者视为这一样本中的领先者,而不是预测。
GPT vs Gemini vs Claude vs Grok vs DeepSeek:按厂商比较结果
“ChatGPT 和 Gemini 哪个更适合交易?”这个问题,其实是在问模型家族。下表按厂商对已上榜模型进行分组,使用与前 20 名相同的历史累计视图。
| 厂商 | 上榜模型数 | 最佳模型 | 最佳平均 R(交易笔数) | 平均 R 中位数 | 平均 R ≥ +0.10R 的模型数 |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0.52R(323 笔) | +0.04R | 2 |
| 8 | Gemini 3.8 Flash | +0.38R(224 笔) | +0.03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0.37R(316 笔) | +0.04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0.29R(131 笔) | +0.18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0.29R(327 笔) | +0.29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0.22R(247 笔) | +0.04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0.17R(423 笔) | +0.10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0.06R(368 笔) | +0.05R | 0 |
在排行榜上的各家厂商之间,有三条结论站得住脚:
- 选模型,而不是选品牌。 大多数大型厂商既有排在前列的模型,也有平均 R 接近零的模型。同一家族内部的差距通常比家族之间的差距更大,所以“GPT 还是 Claude”远不如“哪一个 GPT、在哪个时间周期”有用。
- 更新不等于更好。 好几款最新发布的模型表现接近零,而一些更小或更快的模型反而交易得不错。一个模型的推理基准成绩,几乎无法说明它交易得怎么样。
- 样本量会改变结论。 有些厂商只有一两个上榜模型、几百笔交易;另一些则有十个。一家厂商的最佳模型有多可信,取决于它的交易笔数。GPT、Gemini与Claude:AI股票分析2026指南从研究质量而非交易结果的角度比较了同样的模型家族。
按时间段和时间周期统计的交易
下面的合计把排行榜上每一笔已平仓交易只计算一次,不论由哪个模型完成。它们显示排名背后有多少数据支撑,以及结果如何随图表时间周期变化。
| 视图 | 已平仓交易 | 胜率 |
|---|---|---|
| 最近 30 天 | 2,372 | 50.0% |
| 最近 12 个月 | 9,113 | 54.3% |
| 1m 图表 | 1,893 | 51.0% |
| 5m 图表 | 2,388 | 60.1% |
| 15m 图表 | 3,036 | 55.4% |
| 1h 图表 | 1,099 | 47.8% |
| 4h 图表 | 611 | 47.0% |
| 1d 图表 | 86 | 69.4% |
短周期会产生大量波动较小的交易;1 小时和 4 小时图上的交易更少,也更难赢。在比较模型之前,请先把排行榜筛选到你实际交易的时间周期。想了解各个模型在急跌行情中的表现,请参阅AI模型会在加密崩盘中恐慌抛售吗?31个交易机器人揭晓真相。
其他 AI 交易竞技场和排行榜
把语言模型放到市场面前的公开实验并不只有 SimianX 一家。其他项目回答的问题略有不同,值得对照阅读。
- Nof1 的 Alpha Arena。 最知名的比赛。在 2025 年 10 月 18 日至 11 月 3 日的第一季中,六个模型各自用 10,000 美元真金白银、以相同的提示词在 Hyperliquid 上交易加密货币永续合约。据《南华早报》报道,Qwen3 Max 以约 12,231 美元(+22.3%)夺得第一,DeepSeek Chat V3.1 也以盈利收官,其余四个模型均出现亏损。它的优势是真实资金,以及每个模型持仓的完全透明;它的局限是参赛模型少、赛季短,使排名容易受少数几笔大额交易左右。alpha-arena.io 上也提供了第一季看板的一份副本。
- TradeRank。 以赛季形式运行,20 多个模型各用 10,000 美元在主要加密货币和美国大盘股上进行模拟交易,每天 16:00 UTC 做出一次决策,并设有跨赛季的历史总榜。每日决策让它成为对较慢、偏持仓型判断的检验。
- TradingArena。 一个模拟交易竞技场,用户用 100,000 美元模拟资金,在实时行情上与 Claude、Grok 和 GPT 等 AI 模型对战。它围绕人与 AI 的比拼而设计,而不是只给模型排名。
SimianX 的不同之处:它为更多模型(30 多个)排名,基于数千笔已平仓交易,覆盖从 1 分钟到 1 天的六个图表时间周期,并以模型自己设定的止损为基准,用 R 为每一笔交易计分。这种广度的代价是,如上文所述,它的账簿是模拟的,实时交易的功劳在各智能体席位之间共享。没有哪个竞技场,包括我们自己,能证明某个模型明天一定赚钱。
如何使用这些结果
- 先看足够交易笔数下的平均 R,再查看模型页面上的胜率和 95% 区间。
- 筛选到你的时间周期和方向。 在 15 分钟图上领先的模型,到了 4 小时图上可能落后,做多和做空的结果也常常不同。
- 关注持仓时间。 持仓 15 分钟的模型和持仓一整天的模型,做的是不同的工作。
- 在不同席位上混用模型。 在实时分析室里,你可以为四个智能体各选一个不同的模型,让它们真正产生分歧;8位AI分析师对比单一模型:多智能体投资委员会如何分工运作解释了独立观点为何有帮助。
- 先测试,再自动化。 先让模型在模拟的自动驾驶上运行。2026最佳AI加密交易机器人:多智能体与MCP实测完整指南介绍了 AI 智能体与网格机器人、定投(DCA)机器人的比较。
本页如何更新
本页每周更新一次。一个脚本会重新读取排行榜的公开数据(即排行榜页面本身使用的同一个公开接口:历史累计、最多 50 个模型,外加 30 天视图和汇总合计),并在全部 16 种语言中重写答案框、前 20 名表格、厂商表格和合计表格。方法部分只会在排行榜规则变化时更改。没有任何人工挑选:模型的排名与排行榜完全一致,已停用的模型也包括在内。
答案框中的“更新”日期就是数据被拉取的时刻。如果它已超过一周,或者你需要筛选后的视图,请以实时排行榜为准。
常见问题
现在哪个 AI 模型最适合做加密货币交易?
截至 2026年10月23日,Grok 4.6(xAI)在 SimianX 加密货币 AI 排行榜上领先,323 笔已平仓交易平均每笔 +0.52R,胜率 57.9%,领先于 Gemini 3.8 Flash(+0.38R)和 DeepSeek V4 Pro(+0.37R)。排名会随着交易平仓而变化,请查看实时排行榜了解最新顺序。
ChatGPT(GPT)适合做加密货币交易吗?
OpenAI 是排行榜上模型阵容最大的厂商之一,其模型的平均 R 从明显为正到明显为负都有。“GPT”不是单一的交易员:要看是哪一个 GPT 模型、在哪个时间周期、基于多少笔交易。上方的厂商表格列出了该家族的最佳模型及其中位数。
Claude、Gemini 和 Grok 哪个更适合交易?
这更多取决于具体模型和时间周期,而不是品牌。Grok、Gemini 和 Claude 的模型都出现在排行榜的上半部分,也都有接近零的模型。请在前 20 名表格和排行榜上比较具体模型。
这些是真实资金交易吗?
不是。SimianX 上的持仓是模拟的,并以真实市场价格计分。实时交易来自已登录用户的会话和自动驾驶;回放交易在真实的历史 1 分钟 K 线上结算。SimianX 不会在交易所下单。想根据信号采取行动的用户,可以把 API 接入自己已获授权的系统。
为什么按平均 R 而不是胜率排名?
因为胜率忽略了每笔盈亏的大小。一个模型可能赢下大部分交易,但按每单位风险几乎赚不到钱。平均 R 同时反映了频率和幅度。
一个模型需要多少笔交易才能上榜?
在当前视图中至少有 20 笔已平仓交易。不足这个数的模型会列为尚未上榜。
这和 Alpha Arena 有什么不同?
Alpha Arena 在一个交易场所、一个短赛季里给少数几个模型真实资金。SimianX 基于数千笔模拟交易、覆盖六个时间周期为 30 多个模型排名,并用 R 为每笔交易计分。两者衡量的东西不同,都有参考价值。
本页多久更新一次?
每周一次,依据排行榜的公开数据。实时排行榜则随着交易平仓持续更新。
结论
最适合加密货币交易的 AI 模型,是在你实际交易的时间周期上、在足够多的交易中、按每单位风险赚得最多的那一个。页首的答案框给出了当前的领先者;表格显示了它背后有多少证据支撑。打开加密货币 AI 排行榜,设置筛选条件,然后先在比特币的实时分析中试用你选中的模型,再决定是否把重要的事情交给它。
风险提示: SimianX 仅提供 AI 市场研究和教育性分析,不构成投资建议。AI 输出可能出错。过往表现不代表未来结果,加密货币交易可能造成亏损。
延伸阅读
- 哪个 AI 模型最会交易?按平均R排名的加密货币AI排行榜
- 30+款主流AI模型同台竞技:加密货币实盘胜率与多空排行榜
- AI模型会在加密崩盘中恐慌抛售吗?31个交易机器人揭晓真相
- 2026最佳AI加密交易机器人:多智能体与MCP实测完整指南
- GPT、Gemini与Claude:AI股票分析2026指南
- 什么是 AI 智能体?一文看懂多智能体系统原理、类型与交易实例
- MCP是什么?AI智能体炒股与股票数据MCP接入完整指南
- AI 自动驾驶如何 24/7 交易加密货币(2026 完整指南)