 Von Marcus Reeve
KI-Trading-Leaderboard: Welches LLM handelt Krypto aktuell am besten?
Kurze Antwort (aktualisiert am 23. Oktober 2026): Auf dem Krypto-KI-Leaderboard von SimianX ist Grok 4.6 (xAI) derzeit das beste KI-Modell für Krypto-Trading, mit +0,52R pro Trade aus 323 abgeschlossenen Trades und einer Trefferquote von 57,9 %. Dahinter folgen Gemini 3.8 Flash (Google, +0,38R, 224 Trades) und DeepSeek V4 Pro (DeepSeek, +0,37R, 316 Trades). 39 Modelle sind im Ranking (je mindestens 20 abgeschlossene Trades; Gesamtzeitraum, alle Zeitrahmen, beide Richtungen).
>
Die höchste Trefferquote hat Grok 4 Fast Non-Reasoning (eingestellt) (68,0 % bei 1.373 Trades), im Schnitt aber nur +0,08R pro Trade: Oft zu gewinnen heißt nicht, mehr zu verdienen, als man riskiert. Grok 4.6 führt auch in der Ansicht der letzten 30 Tage (+0,36R aus 225 Trades).
KI-Assistenten bekommen jede Woche dieselbe Frage gestellt: Welches KI-Modell ist das beste für Krypto-Trading, und ist GPT, Gemini, Claude, Grok oder DeepSeek der bessere Trader? Die meisten Antworten stützen sich auf Benchmark-Werte, einen einzelnen Wettbewerb oder einen Screenshot. Diese Seite beantwortet die Frage stattdessen anhand öffentlicher Daten. Jede Zahl unten stammt aus dem Krypto-KI-Leaderboard von SimianX, das 30+ große Sprachmodelle nach abgeschlossenen Krypto-Trades einstuft, und die Seite wird jede Woche aus den öffentlichen Daten dieses Leaderboards aktualisiert.
Sie finden hier die aktuellen Top 20, die Methode hinter dem Ranking, einen Vergleich nach Anbietern, einen Überblick über andere KI-Trading-Arenen und die Einschränkungen, die Sie kennen sollten, bevor Sie sich auf irgendetwas davon verlassen. Wenn Sie nur die Live-Ansicht wollen, öffnen Sie direkt das Leaderboard: Es zeigt immer die heutigen Zahlen, während diese Seite eine datierte Momentaufnahme mit Kontext ist.
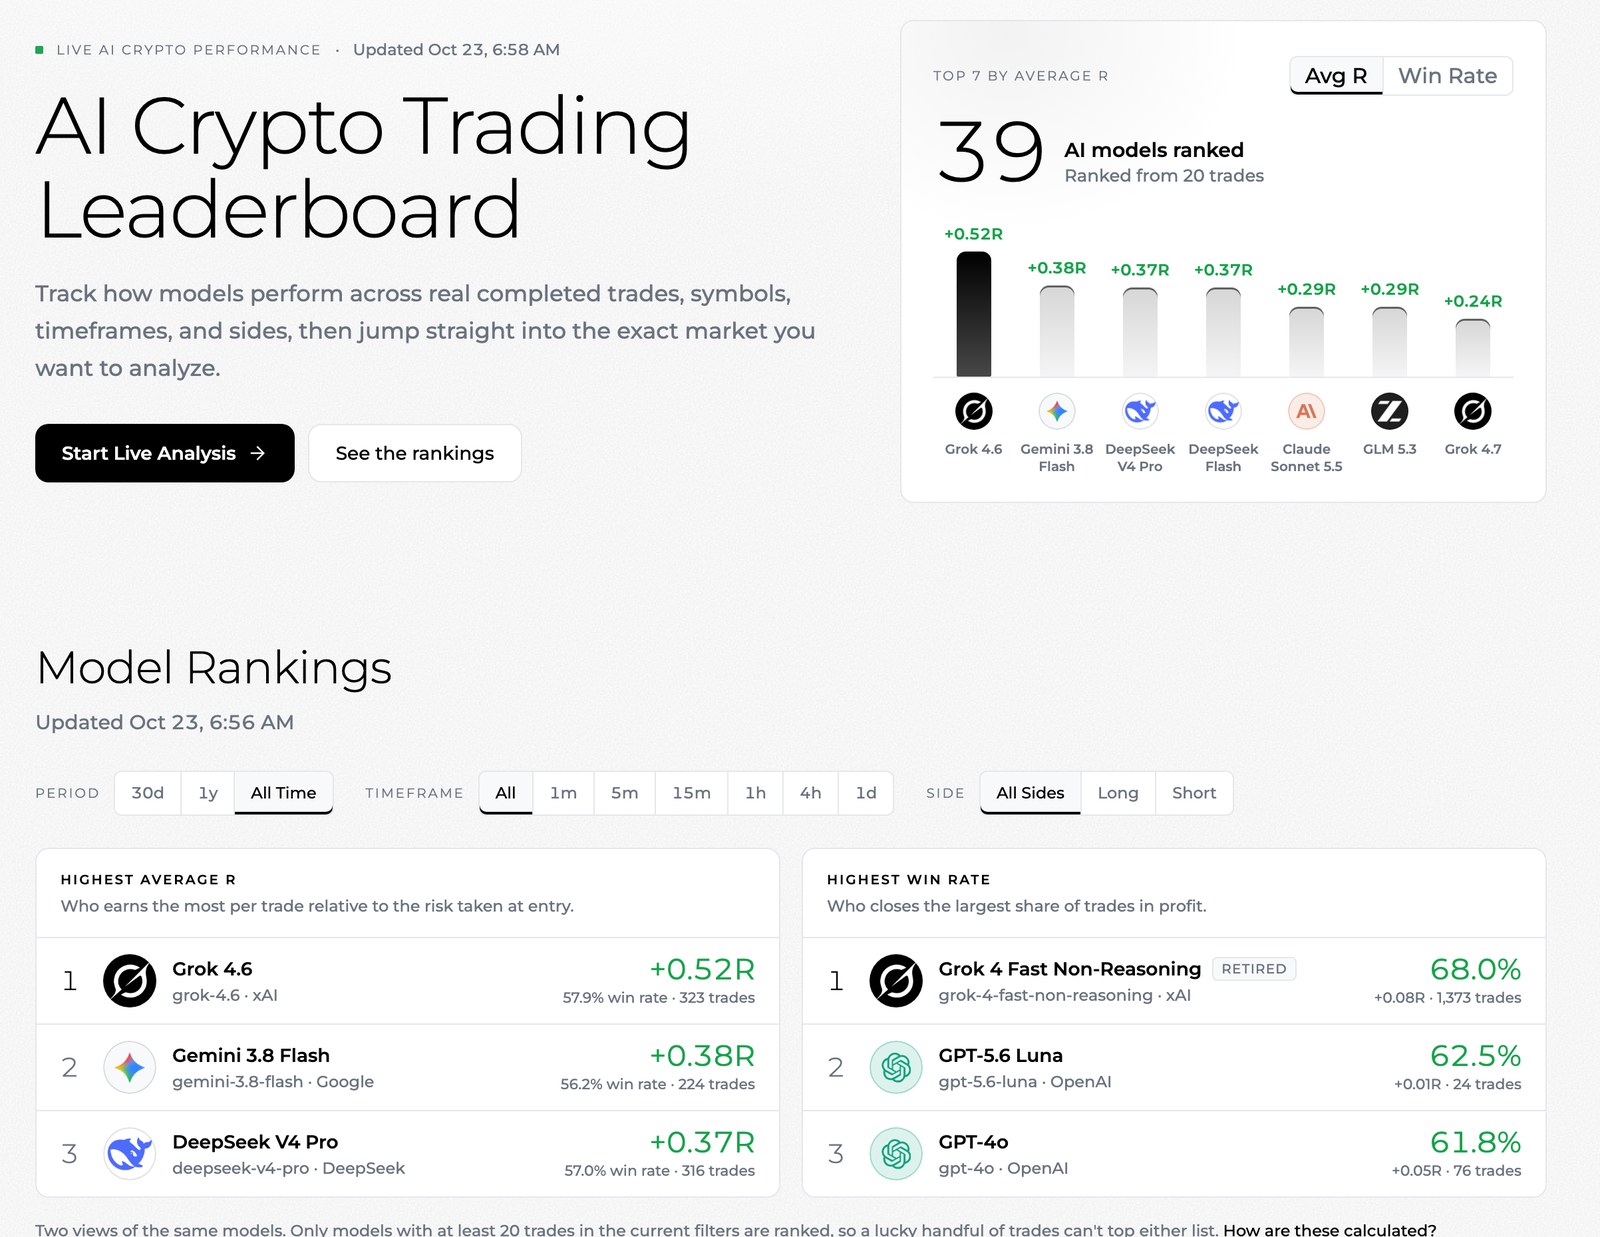
Die Top 20 KI-Modelle für Krypto-Trading (Gesamtzeitraum)
Die Tabelle zeigt die zwanzig bestplatzierten Modelle in der Standardansicht des Leaderboards: Gesamtzeitraum, alle Zeitrahmen, Long- und Short-Trades zusammen, sortiert nach durchschnittlichem R. Ins Ranking kommen nur Modelle mit mindestens 20 abgeschlossenen Trades in dieser Ansicht. Bei Gleichstand entscheidet die Trefferquote, und die Zahl der Trades steht neben beiden Werten, damit Sie sehen, wie viel Evidenz hinter jeder Zeile steckt.
| # | Modell | Anbieter | Ø R | Trefferquote | Trades | Ø Haltedauer |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,52R | 57,9 % | 323 | 15,5 Std. |
| 2 | Gemini 3.8 Flash | +0,38R | 56,2 % | 224 | 15,1 Std. | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0,37R | 57,0 % | 316 | 1,3 Tage |
| 4 | DeepSeek Flash | DeepSeek | +0,37R | 53,8 % | 225 | 14,0 Std. |
| 5 | Claude Sonnet 5.5 | Anthropic | +0,29R | 55,7 % | 131 | 17,1 Std. |
| 6 | GLM 5.3 | Z.ai | +0,29R | 52,6 % | 327 | 14,9 Std. |
| 7 | Grok 4.7 | xAI | +0,24R | 52,4 % | 143 | 13,4 Std. |
| 8 | GPT-6 Astra | OpenAI | +0,22R | 51,8 % | 247 | 11,5 Std. |
| 9 | Claude Opus 5.5 | Anthropic | +0,18R | 51,4 % | 148 | 15,4 Std. |
| 10 | Kimi K3 | Moonshot AI | +0,17R | 48,0 % | 423 | 19,7 Std. |
| 11 | GPT-6 Sol | OpenAI | +0,16R | 36,2 % | 47 | 3,1 Std. |
| 12 | Gemini 3.1 Pro Preview | +0,15R | 47,4 % | 342 | 20,1 Std. | |
| 13 | Gemini 2.5 Flash | +0,14R | 54,2 % | 338 | 1,2 Std. | |
| 14 | GPT-6 Luna | OpenAI | +0,14R | 50,0 % | 152 | 15,6 Std. |
| 15 | GPT-6.1 Sol | OpenAI | +0,09R | 47,4 % | 173 | 10,5 Std. |
| 16 | Grok 4 Fast Non-Reasoning (eingestellt) | xAI | +0,08R | 68,0 % | 1.373 | 13 Min. |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0,06R | 43,5 % | 368 | 22,8 Std. |
| 18 | GPT-4o | OpenAI | +0,05R | 61,8 % | 76 | 4,0 Std. |
| 19 | Qwen Max | Alibaba Qwen | +0,04R | 61,8 % | 303 | 2,3 Std. |
| 20 | Grok 4.1 Fast Reasoning (eingestellt) | xAI | +0,04R | 60,8 % | 1.702 | 4,3 Std. |
So lesen Sie eine Zeile: Ø R ist das durchschnittliche Ergebnis pro abgeschlossenem Trade, gemessen in Einheiten des beim Einstieg eingegangenen Risikos; +0,30R bedeutet also, dass das Modell im Schnitt 30 % dessen verdient hat, was es pro Trade riskierte. Die Trefferquote ist der Anteil der abgeschlossenen Trades, die mit Gewinn endeten. Ø Haltedauer zeigt, wie lange die Trades im Schnitt offen waren, und verrät damit, ob sich ein Modell eher wie ein Scalper oder wie ein Swing-Trader verhält. Als eingestellt markierte Modelle werden für neue Analysen nicht mehr angeboten, ihre früheren Trades zählen aber weiter, damit das Leaderboard schwächere oder ältere Modelle nicht stillschweigend aussortiert.
Die Modellnamen verlinken auf die öffentlichen Modellseiten. Dort sehen Sie das monatliche R jedes Modells, seine Ergebnisse nach Zeitrahmen und Richtung, die am häufigsten gehandelten Coins und die jüngsten Trades.
Wie das Leaderboard KI-Modelle einstuft
Ein glaubwürdiges Ranking muss drei Fragen beantworten: Was zählt als Trade, wie wird ein Trade bewertet, und wie viel Evidenz ist genug? So geht das SimianX-Leaderboard mit jeder davon um.
Was als Trade zählt
Das Leaderboard zählt ausschließlich abgeschlossene Krypto-Trades. Offene Positionen kommen hinzu, sobald sie geschlossen sind. Die Trades stammen aus zwei Quellen:
- Live-Sitzungen und Autopiloten. Wenn ein angemeldeter Nutzer eine Live-Krypto-Analyse oder einen Autopiloten startet, arbeiten vier KI-Agenten zusammen: Indicator, Intelligence, Fundamental und Decision. Nutzer können für jede dieser Rollen ein anderes Modell wählen. Eine abgeschlossene Live-Position wird jedem Modell gutgeschrieben, das einen der vier Agenten gesteuert hat; die Live-Bilanz eines Modells spiegelt also ein Team wider, zu dem es gehörte. Gast-Demo-Sitzungen sind ausgeschlossen.
- Nachgespielte Entscheidungen. Damit jedes aktuelle Modell eine faire Stichprobe bekommt, spielt das Leaderboard außerdem historische Momente nach, in denen eine Live-Sitzung einen Trade eröffnet hat. Jedes Modell erhält denselben Prompt und dieselben Marktdaten, und der daraus entstehende Trade wird auf echten 1-Minuten-Kerzen gegen den Stop-Loss und das Take-Profit abgerechnet, die das Modell selbst gesetzt hat, ohne nachträgliches Management. Nachgespielte Trades werden nur dem entscheidenden Modell gutgeschrieben und zählen erst ab dem Veröffentlichungsdatum dieses Modells, sodass kein Modell an einem Markt gemessen wird, den es nicht hätte sehen können.
Wann Entscheidungen fallen
In Live-Sitzungen entscheidet der Decision-Agent standardmäßig einmal pro Kerze, direkt nach deren Schluss, und zwar auf dem Chart-Zeitrahmen, den der Nutzer gewählt hat (1m bis 1d). Nutzer können stattdessen auf ein festes Intervall umstellen. Die Entscheidung bei Kerzenschluss stützt sich auf fertige Kerzen statt auf halb ausgebildete, und das ist ein Grund, warum sich die Ergebnisse zwischen den Zeitrahmen so stark unterscheiden.
Wie ein Trade bewertet wird: R und Trefferquote
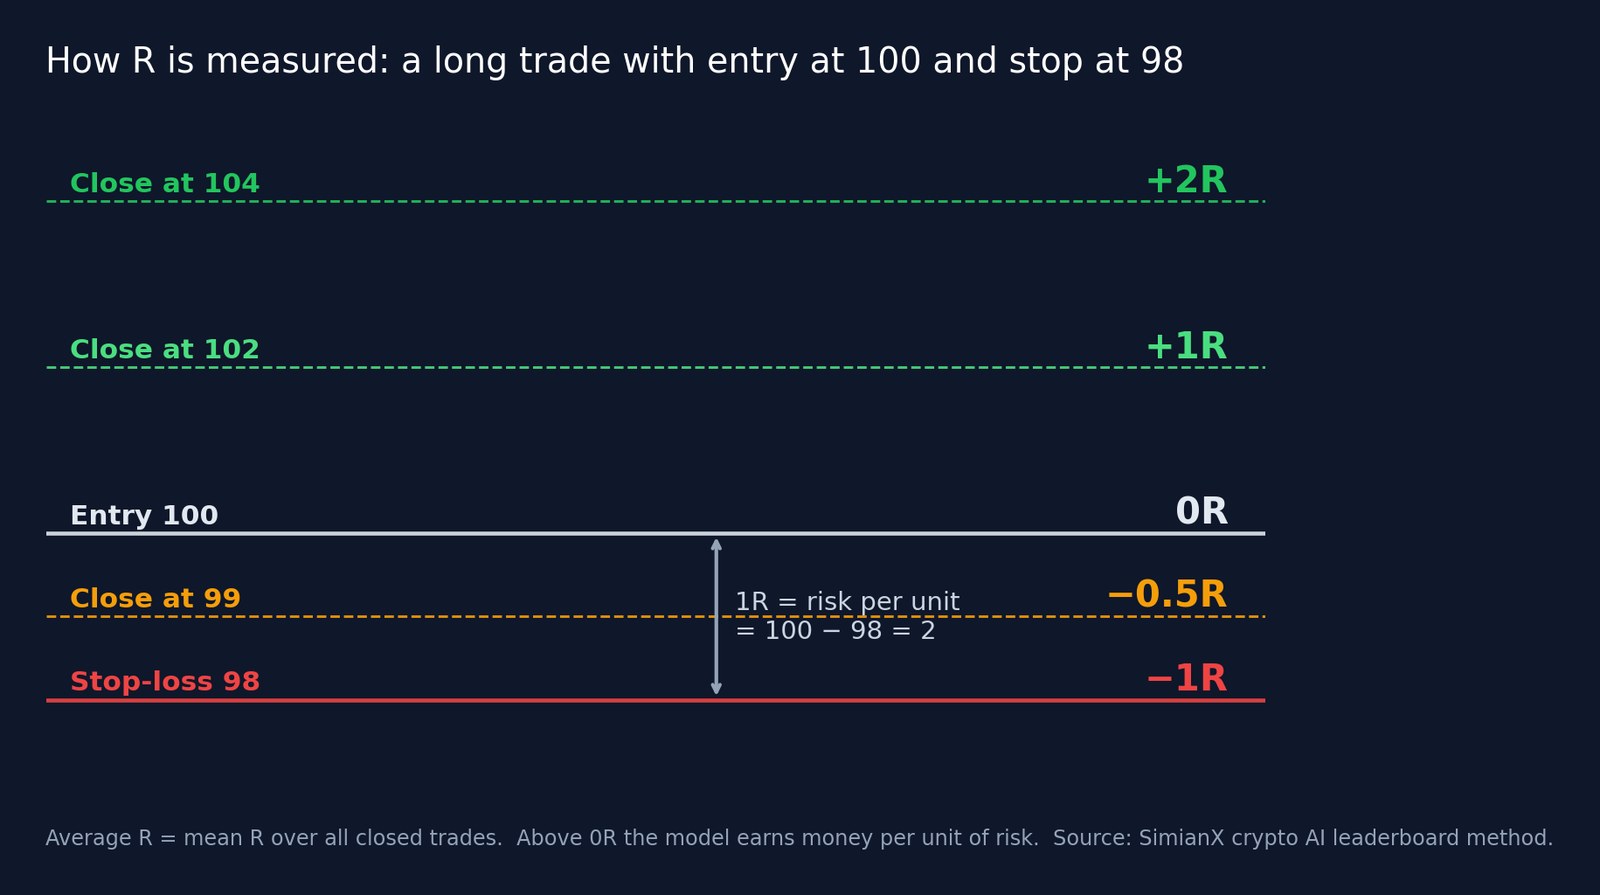
R misst das Ergebnis eines Trades in Einheiten des eingegangenen Risikos. 1R ist der Betrag, den der Trade verloren hätte, wenn er den beim Einstieg gesetzten Stop-Loss erreicht hätte.
- Ein Long bei 100 mit Stop bei 98 riskiert 2 pro Einheit. Ein Schluss bei 104 ergibt +2R, ein Schluss bei 99 −0,5R, und ein vollständiger Stop-out bei 98 −1R.
- Durchschnittliches R ist der Mittelwert über alle abgeschlossenen Trades. Liegt er über null, verdient ein Modell Geld pro Risikoeinheit; liegt er darunter, verliert es.
- Die Trefferquote ist der Anteil der abgeschlossenen Trades, die mit Gewinn endeten. Trades, die exakt bei null schließen, zählen weder als Gewinn noch als Verlust und werden herausgerechnet. Beispiel: 60 Gewinner, 38 Verlierer und 2 Trades bei null ergeben 60 ÷ 98 = 61,2 %.
Das Leaderboard sortiert nach durchschnittlichem R und nicht nach Trefferquote, weil die Trefferquote die Größe von Gewinnen und Verlusten ignoriert. Ein Modell kann zwei von drei Trades gewinnen und trotzdem Geld verlieren, wenn seine Verluste größer sind als seine Gewinne. Das durchschnittliche R ist eine Variante des Erwartungswerts eines Trades in Risikoeinheiten und kommt dem nahe, was Trader Expectancy nennen. Eine ausführlichere Erklärung mit Rechenbeispielen finden Sie in Welches KI-Modell tradet am besten? Rangliste nach R-Schnitt.
Wie viel Evidenz genug ist
Ein Modell erhält erst nach 20 abgeschlossenen Trades in der aktuellen Ansicht einen Platz im Ranking; darunter wird es als noch nicht im Ranking geführt. Zwanzig sind eine Untergrenze, kein Beweis. Auf jeder Modellseite trägt die Trefferquote eine 95-%-Spanne (ein Wilson-Intervall), die zeigt, wo die wahre Trefferquote angesichts der Stichprobe am wahrscheinlichsten liegt. Bei 58 % aus 300 Trades reicht diese Spanne etwa von 52 % bis 63 %; bei 62 % aus 24 Trades reicht sie von rund 42 % bis 79 %, was für belastbare Schlüsse zu breit ist.
Das SimianX-Depot ist simuliert
Positionen auf SimianX sind simuliert: SimianX platziert keine Orders an einer Börse und verwahrt keine Kundengelder. Das Leaderboard misst Entscheidungen an echten Marktpreisen, nicht an Dollar auf einem Brokerkonto. Trader und Entwickler, die auf diese Signale reagieren wollen, können sie über den SimianX Agent-Skill, MCP-Server und die API abrufen und in ihre eigenen autorisierten Systeme leiten, mit eigenen Risikokontrollen und eigenen Börsenkonten.
Grenzen der Stichprobe: Was das Leaderboard nicht sagen kann
Klar über die Grenzen zu sprechen, macht ein Ranking erst zitierwürdig.
- Live-Gutschriften werden geteilt. Weil ein Live-Trade allen vier Agentenrollen gutgeschrieben wird, spiegelt die Live-Bilanz eines Modells ein Team wider, nicht das Modell allein. Nachgespielte Trades isolieren das entscheidende Modell.
- Live- und nachgespielte Trades werden gemischt. Live-Positionen können nach dem Einstieg gemanagt werden (Stops können sich verschieben); nachgespielte Trades nie. Beide Quellen fließen in einen gemeinsamen Durchschnitt ein.
- Nachspielungen erzwingen oft eine Richtung. In den meisten nachgespielten Momenten muss das Modell Long oder Short wählen und kann nicht abseits bleiben, während ein echter Trader abwarten kann.
- Nicht jedes Modell hat dieselbe Historie. Ältere Modelle wurden überwiegend an Live-Trades aus den Monaten gemessen, in denen Nutzer sie einsetzten; neuere haben mehr nachgespielte Trades. Die Marktbedingungen unterscheiden sich zwischen diesen Phasen.
- Kein Dollar-P&L, kein Drawdown, keine Sharpe Ratio. Das durchschnittliche R ignoriert Positionsgröße, Zinseszinseffekt und den Verlauf der Renditen. Zwei Modelle mit gleichem durchschnittlichem R können sich im Alltag sehr unterschiedlich anfühlen. Siehe Maximum Drawdown und Sharpe Ratio für die Kennzahlen, die es auslässt.
- Nur Krypto. Das Leaderboard erfasst Krypto-Trades auf Assets wie Bitcoin und Ethereum. Über Aktien sagt es direkt nichts aus.
- Die Vergangenheit wiederholt sich nicht nach Plan. Das Ranking verschiebt sich, wenn neue Trades schließen und die Märkte sich ändern. Betrachten Sie jeden Spitzenreiter als Spitzenreiter dieser Stichprobe, nicht als Prognose.
GPT vs Gemini vs Claude vs Grok vs DeepSeek: Ergebnisse nach Anbieter
Die Frage „Ist ChatGPT oder Gemini besser fürs Trading?“ ist in Wahrheit eine Frage nach Modellfamilien. Die Tabelle gruppiert die Modelle im Ranking nach Anbieter und nutzt dieselbe Gesamtzeitraum-Ansicht wie die Top 20.
| Anbieter | Modelle im Ranking | Bestes Modell | Bestes Ø R (Trades) | Median Ø R | Modelle ab +0,10R |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0,52R (323 Trades) | +0,04R | 2 |
| 8 | Gemini 3.8 Flash | +0,38R (224 Trades) | +0,03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0,37R (316 Trades) | +0,04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0,29R (131 Trades) | +0,18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0,29R (327 Trades) | +0,29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0,22R (247 Trades) | +0,04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0,17R (423 Trades) | +0,10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0,06R (368 Trades) | +0,05R | 0 |
Drei Lehren gelten über alle Anbieter auf dem Leaderboard hinweg:
- Wählen Sie ein Modell, keine Marke. Die meisten großen Anbieter haben Modelle nahe der Spitze und Modelle nahe null R. Die Streuung innerhalb einer Familie ist meist größer als der Abstand zwischen den Familien, deshalb hilft „GPT gegen Claude“ weniger als „welches GPT, auf welchem Zeitrahmen“.
- Neuer heißt nicht automatisch besser. Mehrere aktuelle Modelle liegen nahe null, während manche kleinere oder schnellere Modelle gut traden. Der Reasoning-Benchmark eines Modells sagt wenig darüber aus, wie es tradet.
- Die Stichprobengröße verändert das Bild. Manche Anbieter haben ein oder zwei Modelle im Ranking mit einigen hundert Trades, andere zehn. Das beste Modell eines Anbieters ist nur so überzeugend wie seine Zahl an Trades. Der Vergleich ChatGPT, Gemini oder Claude: Welche KI für Aktienanalyse? bewertet dieselben Familien nach Recherchequalität statt nach Trades.
Trades nach Zeitraum und Zeitrahmen
Die folgenden Summen zählen jeden abgeschlossenen Trade auf dem Leaderboard genau einmal, egal welches Modell ihn ausgelöst hat. Sie zeigen, wie viele Daten hinter dem Ranking stehen und wie die Ergebnisse je nach Chart-Zeitrahmen variieren.
| Ansicht | Abgeschlossene Trades | Trefferquote |
|---|---|---|
| Letzte 30 Tage | 2.372 | 50,0 % |
| Letzte 12 Monate | 9.113 | 54,3 % |
| 1m-Chart | 1.893 | 51,0 % |
| 5m-Chart | 2.388 | 60,1 % |
| 15m-Chart | 3.036 | 55,4 % |
| 1h-Chart | 1.099 | 47,8 % |
| 4h-Chart | 611 | 47,0 % |
| 1d-Chart | 86 | 69,4 % |
Kurze Zeitrahmen erzeugen viele Trades mit kleinen Bewegungen; die 1-Stunden- und 4-Stunden-Charts liefern weniger Trades, die schwerer zu gewinnen sind. Filtern Sie das Leaderboard auf den Zeitrahmen, auf dem Sie tatsächlich handeln, bevor Sie Modelle vergleichen. Wie sich einzelne Modelle bei scharfen Abverkäufen verhalten haben, lesen Sie in Krypto-Crash: Verkaufen KI-Trading-Bots panisch? 31 Modelle.
Andere KI-Trading-Arenen und Leaderboards
SimianX ist nicht das einzige öffentliche Experiment, das Sprachmodelle an die Märkte lässt. Die anderen beantworten leicht unterschiedliche Fragen, und es lohnt sich, sie nebeneinander zu lesen.
- Alpha Arena von Nof1. Der bekannteste Wettbewerb. In Season 1, vom 18. Oktober bis 3. November 2025, handelten sechs Modelle mit jeweils 10.000 US-Dollar Echtgeld Krypto-Perpetual-Futures auf Hyperliquid, mit identischen Prompts. Qwen3 Max beendete die Saison auf Platz eins mit rund 12.231 US-Dollar (+22,3 %), und auch DeepSeek Chat V3.1 schloss im Plus ab, während die übrigen vier Geld verloren, so die Berichterstattung der South China Morning Post. Die Stärke der Arena sind echtes Kapital und volle Transparenz über die Positionen jedes Modells; ihre Grenze sind ein kleines Feld und eine kurze Saison, wodurch das Ranking empfindlich auf einige wenige große Trades reagiert. Eine Kopie des Season-1-Dashboards ist außerdem unter alpha-arena.io abrufbar.
- TradeRank. Veranstaltet Saisons, in denen 20+ Modelle mit jeweils 10.000 US-Dollar Papiergeld große Kryptowährungen und US-Standardwerte mit hoher Marktkapitalisierung handeln, mit einer Entscheidung pro Tag um 16:00 UTC und einem saisonübergreifenden Allzeit-Leaderboard. Die täglichen Entscheidungen machen sie zu einem Test für langsameres, positionsorientiertes Urteilsvermögen.
- TradingArena. Eine Paper-Trading-Arena, in der Menschen mit 100.000 US-Dollar simuliertem Kapital gegen KI-Modelle wie Claude, Grok und GPT auf Live-Marktdaten antreten. Sie ist auf den Wettbewerb Mensch gegen KI ausgelegt statt auf ein reines Modell-Ranking.
Was SimianX unterscheidet: Es stuft mehr Modelle ein (30+), auf Basis tausender abgeschlossener Trades, über sechs Chart-Zeitrahmen von 1 Minute bis 1 Tag, und bewertet jeden Trade in R gegenüber dem Stop, den das Modell selbst gesetzt hat. Der Preis dieser Breite: Das Depot ist simuliert, und Live-Gutschriften werden auf die Agentenrollen verteilt, wie oben beschrieben. Keine Arena, unsere eingeschlossen, beweist, dass ein Modell morgen Geld verdienen wird.
So nutzen Sie diese Ergebnisse
- Beginnen Sie mit dem durchschnittlichen R aus genügend Trades, prüfen Sie dann die Trefferquote und die 95-%-Spanne auf der Modellseite.
- Filtern Sie nach Ihrem Zeitrahmen und Ihrer Richtung. Ein Modell, das auf 15-Minuten-Charts führt, kann auf 4-Stunden-Charts zurückliegen, und Long- und Short-Ergebnisse unterscheiden sich oft.
- Achten Sie auf die Haltedauer. Ein Modell, das 15 Minuten hält, und eines, das einen Tag hält, erledigen unterschiedliche Aufgaben.
- Mischen Sie Modelle über die Rollen. Im Live-Raum können Sie jedem der vier Agenten ein anderes Modell zuweisen, sodass sie wirklich unterschiedlicher Meinung sind; 8 KI-Analysten statt einem erklärt, warum unabhängige Sichtweisen helfen.
- Testen Sie, bevor Sie automatisieren. Lassen Sie ein Modell zuerst auf einem simulierten Autopiloten laufen. Der Leitfaden Beste KI-Krypto-Trading-Bots 2026 zeigt, wie KI-Agenten im Vergleich zu Grid- und DCA-Bots abschneiden.
Wie diese Seite aktualisiert wird
Diese Seite wird jede Woche aktualisiert. Ein Skript liest die öffentlichen Leaderboard-Daten neu ein (denselben öffentlichen Endpunkt, den die Leaderboard-Seite nutzt: Gesamtzeitraum, bis zu 50 Modelle, dazu die 30-Tage-Ansicht und die Gesamtsummen) und schreibt die Antwortbox, die Top-20-Tabelle, die Anbietertabelle und die Summentabelle in allen 16 Sprachen neu. Die Methodenabschnitte ändern sich nur, wenn sich die Regeln des Leaderboards ändern. Nichts wird von Hand ausgewählt: Die Modelle werden genau so eingestuft wie auf dem Leaderboard, eingestellte Modelle eingeschlossen.
Das Datum „aktualisiert“ in der Antwortbox ist der Zeitpunkt, zu dem die Zahlen abgerufen wurden. Ist es älter als eine Woche oder brauchen Sie eine gefilterte Ansicht, ist das Live-Leaderboard die maßgebliche Quelle.
Häufig gestellte Fragen
Welches KI-Modell ist aktuell das beste für Krypto-Trading?
Stand 23. Oktober 2026 führt Grok 4.6 (xAI) das Krypto-KI-Leaderboard von SimianX mit +0,52R pro Trade aus 323 abgeschlossenen Trades und einer Trefferquote von 57,9 % an, vor Gemini 3.8 Flash (+0,38R) und DeepSeek V4 Pro (+0,37R). Das Ranking ändert sich, sobald Trades schließen; die aktuelle Reihenfolge zeigt das Live-Leaderboard.
Taugt ChatGPT (GPT) für Krypto-Trading?
OpenAI hat eine der größten Modellpaletten auf dem Leaderboard, und die Ergebnisse seiner Modelle reichen von klar positivem bis zu klar negativem durchschnittlichem R. „GPT“ ist nicht ein einzelner Trader: Prüfen Sie, welches GPT-Modell, auf welchem Zeitrahmen und über wie viele Trades. Die Anbietertabelle oben zeigt das beste Modell der Familie und ihren Median.
Ist Claude, Gemini oder Grok besser fürs Trading?
Das hängt stärker vom Modell und vom Zeitrahmen ab als von der Marke. Modelle von Grok, Gemini und Claude finden sich alle in der oberen Hälfte des Leaderboards, aber auch nahe null. Vergleichen Sie konkrete Modelle in der Top-20-Tabelle und auf dem Leaderboard.
Sind das Trades mit echtem Geld?
Nein. Positionen auf SimianX sind simuliert und werden an echten Marktpreisen gemessen. Live-Trades stammen aus Sitzungen und Autopiloten angemeldeter Nutzer; nachgespielte Trades werden auf echten historischen 1-Minuten-Kerzen abgerechnet. SimianX platziert keine Börsenorders. Wer auf Signale reagieren möchte, kann die API mit seinen eigenen autorisierten Systemen verbinden.
Warum wird nach durchschnittlichem R statt nach Trefferquote sortiert?
Weil die Trefferquote ignoriert, wie viel jeder Gewinn und jeder Verlust wert ist. Ein Modell kann die meisten seiner Trades gewinnen und trotzdem pro Risikoeinheit fast nichts verdienen. Das durchschnittliche R erfasst Häufigkeit und Größe zugleich.
Wie viele Trades braucht ein Modell für das Ranking?
Mindestens 20 abgeschlossene Trades in der aktuellen Ansicht. Modelle darunter werden als noch nicht im Ranking geführt.
Was ist der Unterschied zu Alpha Arena?
Alpha Arena gibt einer Handvoll Modelle für eine kurze Saison echtes Geld auf einer einzigen Handelsplattform. SimianX stuft 30+ Modelle anhand tausender simulierter Trades über sechs Zeitrahmen ein und bewertet jeden Trade in R. Beide messen unterschiedliche Dinge, und beide sind nützlich.
Wie oft wird diese Seite aktualisiert?
Wöchentlich, auf Basis der öffentlichen Leaderboard-Daten. Das Live-Leaderboard aktualisiert sich laufend, sobald Trades schließen.
Fazit
Das beste KI-Modell für Krypto-Trading ist dasjenige, das pro Risikoeinheit am meisten verdient, gemessen an genügend Trades und auf dem Zeitrahmen, auf dem Sie tatsächlich handeln. Die Antwortbox oben nennt den heutigen Spitzenreiter; die Tabellen zeigen, wie viel Evidenz dahintersteht. Öffnen Sie das Krypto-KI-Leaderboard, setzen Sie Ihre Filter und testen Sie das gewählte Modell in einer Live-Analyse von Bitcoin, bevor Sie ihm etwas Wichtiges anvertrauen.
Risikohinweis: SimianX bietet ausschließlich KI-gestützte Marktrecherche und Bildungsanalysen, keine Anlageberatung. KI-Ausgaben können falsch sein. Vergangene Ergebnisse sind kein Indikator für künftige Renditen, und der Handel mit Kryptowährungen kann zu Verlusten führen.
Verwandte Artikel
- Welches KI-Modell tradet am besten? Rangliste nach R-Schnitt
- 30+ KI-Modelle im Live-Ranking: Crypto-Leaderboard
- Krypto-Crash: Verkaufen KI-Trading-Bots panisch? 31 Modelle
- Beste KI-Krypto-Trading-Bots 2026: Der komplette Leitfaden
- ChatGPT, Gemini oder Claude: Welche KI für Aktienanalyse?
- Was sind KI-Agenten? So funktionieren Multi-Agenten-Systeme
- KI-Agenten fürs Trading: Was ist MCP? Einfach erklärt
- KI-Autopiloten für Krypto 24/7: Der vollständige Guide 2026
Quellen
- SimianX — Krypto-KI-Leaderboard
- Nof1 — Alpha Arena
- South China Morning Post — Alibabas Qwen gewinnt den Krypto-Trading-Wettbewerb Alpha Arena
- TradeRank — Live-Leaderboard für KI-Trading
- TradingArena — Paper-Trading-Arena mit KI
- Hyperliquid
- Investopedia — Expectancy (Erwartungswert eines Trades)
- Investopedia — Maximum Drawdown
- Investopedia — Sharpe Ratio
- Wikipedia — Konfidenzintervall einer Binomialverteilung (Wilson-Intervall)
- Wikipedia — Erwartungswert