KI-Agenten erklärt: Vom einzelnen Modell in der Schleife zum Team aus Spezialisten
Ein KI-Agent ist ein Softwaresystem, das mit einem KI-Modell selbstständig ein Ziel verfolgt: Es erfasst die Lage, entscheidet über den nächsten Schritt, handelt über Werkzeuge wie Websuche, Code oder eine API und prüft das Ergebnis, bevor es weitermacht. Ein Multi-Agenten-System verteilt diese Arbeit auf mehrere spezialisierte Agenten, die ihre Erkenntnisse teilen, einander dort widersprechen, wo sie uneins sind, und eine gemeinsame Antwort an einen Agenten übergeben, der die endgültige Entscheidung trifft.
Diese Definition in zwei Sätzen deckt das meiste ab, was der Begriff im Jahr 2026 bedeutet – von Programmierassistenten, die Fehler in einem ganzen Quellcode-Archiv beheben, bis zu Recherchewerkzeugen, die Hunderte Seiten lesen, bevor sie einen Bericht schreiben. Sie verschweigt aber auch die schwierigen Teile. Agenten kosten mehr als eine Chat-Antwort, sie brauchen länger, und ein kleiner Fehler früh in einer langen Aufgabe kann das Ergebnis unbemerkt ruinieren.
Wir bauen und betreiben bei SimianX jeden Tag Multi-Agenten-Systeme. Vier Agenten analysieren eine Aktie oder ein Krypto-Paar in Echtzeit in unserem Echtzeit-Analyseraum, ein Komitee aus acht Agenten debattiert in der Tiefenanalyse über eine einzelne Aktie oder Kryptowährung, und eine öffentliche Krypto-Rangliste bewertet mehr als 30 KI-Modelle bei jedem Handelsgeschäft, das sie abschließen. Dieser Leitfaden nutzt dieses System als Praxisbeispiel, ergänzt um neutrale Beschreibungen der Agentenprodukte und der Forschung, die das Feld prägen.
Das Wichtigste in Kürze
- Ein Agent ist ein Modell plus Werkzeuge, Gedächtnis und eine Schleife, die das Modell selbst steuert. Ist jeder Schritt im Code festgelegt, handelt es sich um einen Arbeitsablauf, nicht um einen Agenten.
- Multi-Agenten-Systeme helfen, wenn sich eine Aufgabe in unabhängige Teile zerlegen lässt oder wenn sie Sichtweisen braucht, die sich bilden sollen, bevor jemand Notizen vergleicht. Sie verbrauchen außerdem weit mehr Token.
- Die meisten Fehlschläge von Agenten gehen auf sich aufschaukelnde Fehler, unzuverlässige Werkzeuge, schwache Bewertung und ausufernde Kosten zurück – nicht darauf, dass das Modell „nicht klug genug“ wäre.
- Beurteilen Sie einen Agenten nach wiederholten Ergebnissen bei Ihren eigenen Aufgaben: Erfolgsquote, Beständigkeit über mehrere Durchläufe, Kosten pro erledigter Aufgabe und ein vollständiges Protokoll dessen, was er getan hat.
Was ist ein KI-Agent? Eine praxistaugliche Definition
Die Idee ist älter als große Sprachmodelle. Das Standardlehrbuch der künstlichen Intelligenz, Artificial Intelligence: A Modern Approach von Stuart Russell und Peter Norvig, definiert einen Agenten als alles, was seine Umgebung über Sensoren wahrnimmt und über Aktoren auf diese Umgebung einwirkt. Ein Thermostat erfüllt diese Definition. Ein Schachprogramm ebenfalls.
Was sich nach 2022 geändert hat: Ein Sprachmodell kann nun als Denkkern dienen. Statt handgeschriebenen Regeln zu folgen, liest das Modell die Lage in natürlicher Sprache, schreibt einen Plan und wählt, welches Werkzeug es als Nächstes aufruft. Anthropics vielzitierter Leitfaden Building Effective Agents zieht die Grenze, die die meisten Entwickler heute verwenden: Arbeitsabläufe sind Systeme, in denen Modelle und Werkzeuge über vordefinierte Codepfade gesteuert werden, während Agenten Systeme sind, in denen das Modell seinen eigenen Ablauf und seinen Werkzeugeinsatz dynamisch selbst lenkt.
In der Praxis besteht ein moderner KI-Agent aus fünf Teilen:
- Ein Ziel. „Behebe diesen fehlschlagenden Test“, „fasse zusammen, was Nvidia heute bewegt hat“, „entscheide, ob auf dieser 15-Minuten-Kerze eine Position eröffnet werden soll“.
- Ein Modell, das über das Ziel und den aktuellen Zustand nachdenkt.
- Werkzeuge, die es aufrufen kann: Suche, einen Code-Interpreter, eine Datenbankabfrage, eine Marktdaten-API, einen Browser.
- Gedächtnis oder Zustand: was es bereits versucht hat, was die Werkzeuge zurückgegeben haben und was noch unbekannt ist.
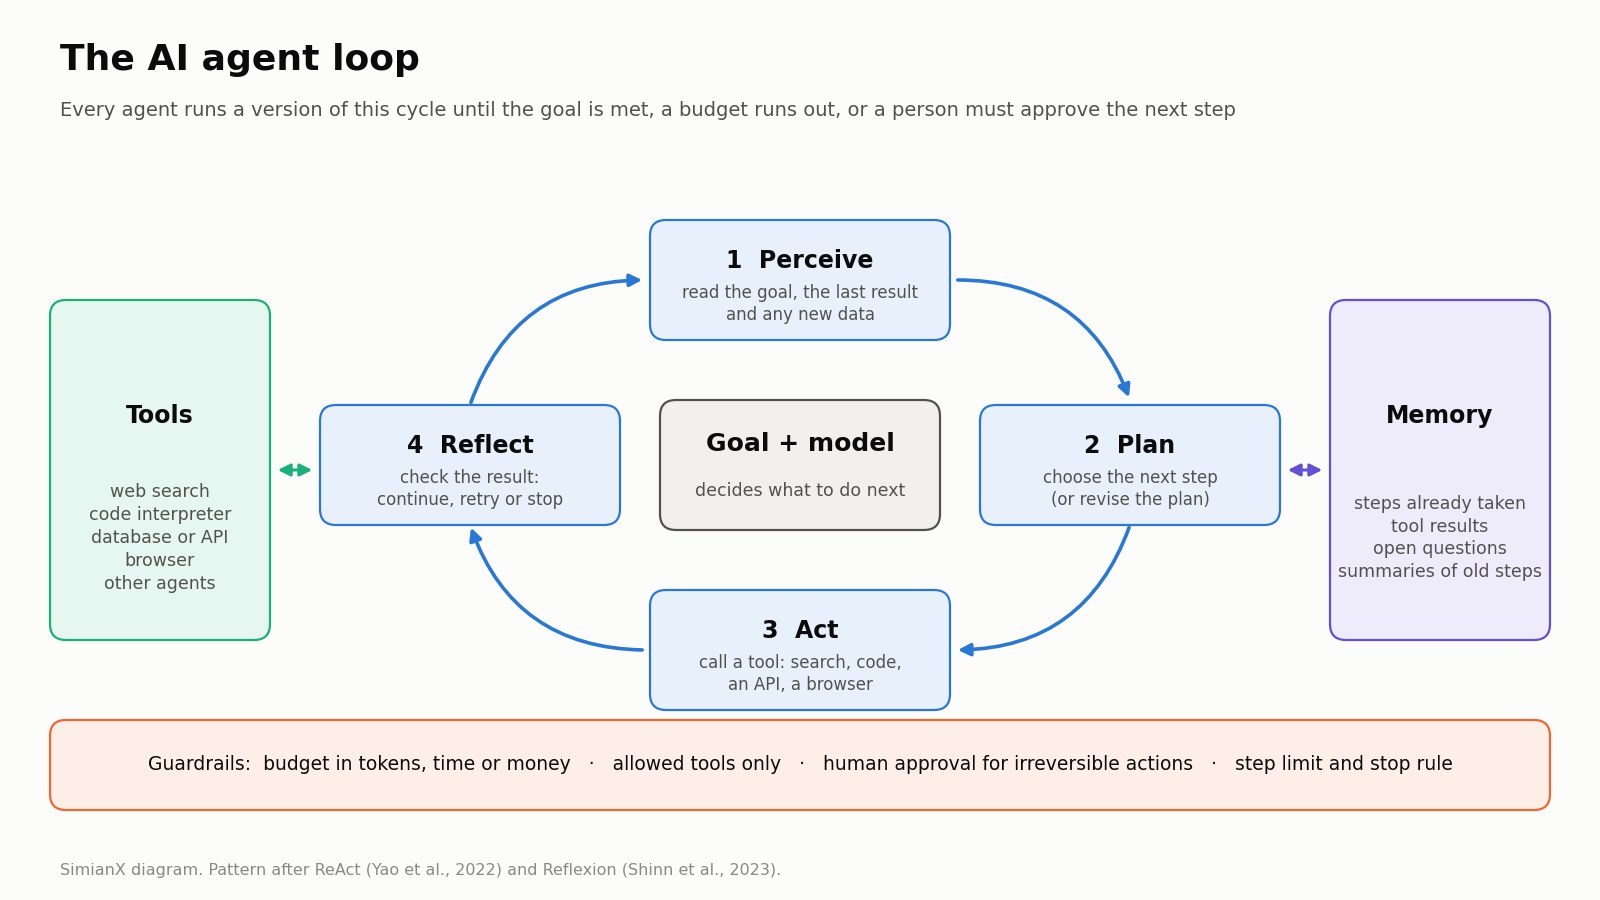
- Eine Schleife mit Abbruchregel: Es macht weiter, bis das Ziel erreicht ist, ein Budget aufgebraucht ist oder ein Mensch den nächsten Schritt freigeben muss.
Entfernt man die Schleife, hat man einen Chatbot. Legt man jeden Schritt im Voraus fest, hat man einen Arbeitsablauf. Erst die Schleife, die das Modell selbst steuert, macht daraus einen Agenten.
KI-Agent vs. Chatbot vs. Arbeitsablauf
Die drei Begriffe werden ständig verwechselt, auch weil sich „Agent“ gut verkauft. Gartner hat einen Namen dafür, Chatbots und robotergestützte Prozessautomatisierung als Agenten umzuetikettieren – „Agenten-Etikettenschwindel“ (Agent Washing) – und schätzte im Juni 2025, dass nur etwa 130 der Tausenden Anbieter, die agentische KI verkaufen, das Echte bieten. Diese Tabelle ist der schnellste Weg, die drei auseinanderzuhalten.
| Chatbot | Arbeitsablauf (Prozesskette) | KI-Agent | |
|---|---|---|---|
| Wer entscheidet über den nächsten Schritt | Der Nutzer, Nachricht für Nachricht | Der Entwickler, in vorab geschriebenem Code | Das Modell, zur Laufzeit |
| Nutzt Werkzeuge | Manchmal, ein Aufruf pro Antwort | Ja, in fester Reihenfolge | Ja, nach Bedarf gewählt und wiederholt |
| Arbeitet ohne neue Eingabe weiter | Nein | Ja, entlang eines festen Pfads | Ja, bis das Ziel oder ein Budget erreicht ist |
| Typisches Ergebnis | Eine Antwort | Ein vorhersehbares Ergebnis aus einem bekannten Prozess | Eine erledigte Aufgabe: eine Codeänderung, ein Bericht, eine Entscheidung |
| Kosten und Tempo | Günstig, Sekunden | Günstig bis mittel, vorhersehbar | Höher und schwankend, Sekunden bis Stunden |
| Typischer Fehler | Eine falsche Antwort, die man sieht | Scheitert an Eingaben, die niemand eingeplant hat | Driftet ab, dreht sich im Kreis oder baut auf einem kleinen frühen Fehler auf |
| Am besten für | Fragen und Entwürfe | Wiederholbare Prozesse mit bekannten Schritten | Offene Aufgaben, deren Weg sich nicht vorab festlegen lässt |
Eine nützliche Regel aus demselben Anthropic-Leitfaden: Beginnen Sie mit der einfachsten Lösung, die funktioniert, und fügen Sie Autonomie nur hinzu, wenn sie die Ergebnisse klar verbessert. Viele Aufgaben, die als Agenten vermarktet werden, sind als Arbeitsabläufe besser, günstiger und sicherer gelöst.
So funktionieren KI-Agenten: die Schleife aus Wahrnehmen, Planen, Handeln und Reflektieren
Jeder Agent, wie auch immer er vermarktet wird, durchläuft eine Version derselben Schleife.
Wahrnehmen
Der Agent erfasst seine aktuelle Lage: das Ziel des Nutzers, das Ergebnis seiner letzten Aktion, den Inhalt einer Datei, eine Seite mit Suchergebnissen, die jüngste Kerze in einem Kursdiagramm. Alles, was er weiß, muss in das Kontextfenster des Modells passen, deshalb sind gute Agenten wählerisch. Sie fassen alte Schritte zusammen, behalten die Rohdaten, die sie noch einmal brauchen werden, und verwerfen den Rest.
Planen
Das Modell entscheidet, was als Nächstes zu tun ist. Manchmal ist das ein vollständiger Plan, der im Voraus geschrieben wird; häufiger ist es der einzelne nächste Schritt, gewählt nach dem letzten Ergebnis. Der einflussreiche Fachartikel ReAct (Yao et al., 2022) zeigte, dass ein Modell, das kurze Denknotizen mit Aktionen verzahnt, Informationen sammeln und seinen Kurs korrigieren kann; bei mehreren Aufgaben schlug es Vergleichsverfahren, die nur handeln oder nur nachdenken. Die meisten Agenten-Rahmenwerke folgen bis heute diesem Muster.
Handeln
Der Agent ruft ein Werkzeug auf. Moderne Modelle geben eine strukturierte Anfrage aus, etwa „suche nach X“ oder „führe diese Abfrage mit diesen Parametern aus“, und die umgebende Software führt sie aus und liefert das Ergebnis zurück. Für diese technische Verkabelung gibt es inzwischen Standards. Das Model Context Protocol (MCP), von Anthropic im November 2024 vorgestellt und im Dezember 2025 an die Agentic AI Foundation der Linux Foundation übergeben, legt fest, wie sich ein Agent mit Werkzeugen und Datenquellen verbindet. Googles Agent2Agent-Protokoll (A2A), inzwischen ebenfalls ein Projekt der Linux Foundation, regelt, wie Agenten verschiedener Anbieter miteinander kommunizieren.
Reflektieren
Der Agent prüft das Ergebnis am Ziel. Ist der Test bestanden? Stimmt die Zahl mit einer zweiten Quelle überein? Ist der Plan noch sinnvoll? Forschungsarbeiten wie Reflexion (Shinn et al., 2023) zeigten, dass es die Ergebnisse bei Programmier- und Denkaufgaben verbessert, wenn ein Agent aufschreiben darf, was schiefgelaufen ist, und es dann erneut versucht. Beim Reflektieren sollte ein Agent auch entscheiden, aufzuhören: weil das Ziel erreicht ist, weil er feststeckt oder weil ein Mensch etwas Riskantes freigeben muss.
Um die Schleife herum liegen die Leitplanken: ein Budget an Token, Zeit oder Geld, eine Liste der Werkzeuge, die der Agent nutzen darf, und die Stellen, an denen ein Mensch zustimmen muss. Im Handelskontext bedeutet das mindestens eine Obergrenze für die Positionsgröße, einen Stopp-Kurs für jedes Geschäft und eine klare Trennlinie zwischen Papierhandel und echtem Geld.
Einzelagent vs. Multi-Agenten-System
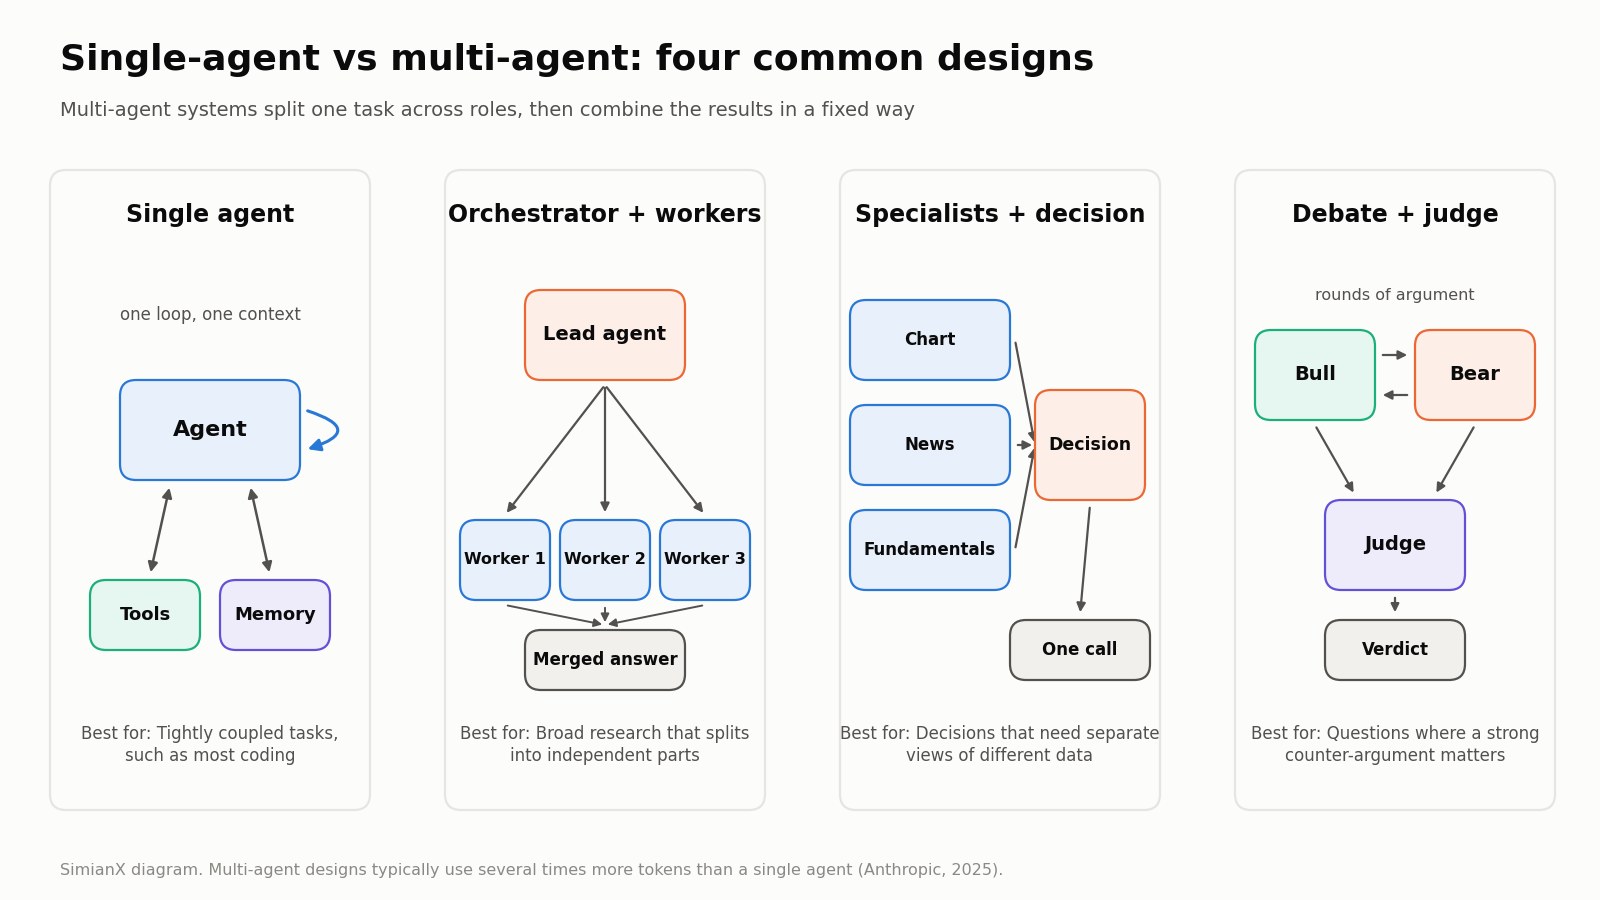
Ein Einzelagent durchläuft die Schleife allein. Ein Multi-Agenten-System vergibt verschiedene Teile der Arbeit an verschiedene Agenten, jeden mit eigenen Anweisungen, Werkzeugen und eigenem Kontext, und führt dann zusammen, was sie liefern. Es gibt vier gängige Architekturen:
- Koordinator und Arbeitsagenten. Ein leitender Agent zerlegt die Aufgabe in Teile, schickt jeden Teil an einen Arbeitsagenten und führt die Ergebnisse zusammen. Rechercheassistenten arbeiten oft so.
- Spezialisten, die einen Entscheider speisen. Jeder Agent deckt einen Bereich ab, etwa Kursdiagramme, Nachrichten oder Finanzkennzahlen, und ein letzter Agent wägt ihre Einschätzungen ab. So ist unser Echtzeit-Analyseraum aufgebaut, wie unten beschrieben.
- Debatte. Agenten vertreten gegensätzliche Positionen, bevor ein Richter entscheidet. Du et al. (2023) stellten fest, dass mehrere Modellinstanzen, die über einige Runden debattieren, die sachliche Richtigkeit und das logische Schließen im Vergleich zu einem einzelnen Modell verbesserten, das allein antwortet.
- Abstimmung oder Ensembles. Mehrere Agenten oder mehrere Modelle beantworten dieselbe Frage unabhängig voneinander, und die Antworten werden zusammengefasst.
Die Belege für Multi-Agenten-Systeme sind real, aber an Bedingungen geknüpft. Anthropic berichtete im Juni 2025, dass in seinem Multi-Agenten-Recherchesystem ein leitender Claude-Opus-4-Agent, der Claude-Sonnet-4-Unteragenten steuerte, einen einzelnen Claude-Opus-4-Agenten in der internen Recherche-Bewertung um 90,2 % übertraf. Derselbe Bericht spricht offen über den Preis: Agenten verbrauchten etwa viermal so viele Token wie ein Chat, Multi-Agenten-Systeme etwa fünfzehnmal so viele. Er hält außerdem fest, dass die meisten Programmieraufgaben weniger wirklich parallelisierbare Teile haben als Recherche, was sie weniger geeignet macht.
| Einzelagent | Multi-Agenten-System | |
|---|---|---|
| Aufbau und Fehlersuche | Einfacher: eine Anweisung, ein Protokoll | Schwieriger: mehrere Anweisungen, Übergaben und ein zusammengeführtes Protokoll |
| Kosten pro Aufgabe | Niedriger | Oft ein Mehrfaches höher |
| Tempo | Nacheinander | Parallele Teile sind früher fertig; die Koordination kostet zusätzlich Zeit |
| Breite | Begrenzt durch ein Kontextfenster | Jeder Agent erhält für seinen Teil einen frischen Kontext |
| Fehlerprüfung | Muss die eigenen Fehler selbst finden | Agenten können einander widersprechen, und Uneinigkeit wird sichtbar |
| Typischer Fehler | Tunnelblick auf eine falsche erste Idee | Missverständnisse, doppelte Arbeit oder eine schwache Zusammenführung am Ende |
| Am besten geeignet | Eng verzahnte Aufgaben, etwa die meisten Programmieraufgaben | Breite Recherche und Entscheidungen, die unabhängige Sichtweisen brauchen |
Unsere Faustregel: Setzen Sie mehr als einen Agenten ein, wenn Sie Einschätzungen wollen, die sich unabhängig bilden, bevor jemand Notizen vergleicht. Eine Chartanalyse sollte nicht von der Schlagzeile gefärbt sein, die der Nachrichtenagent gerade gelesen hat, und ein Bärenszenario sollte ein Agent schreiben, dessen einzige Aufgabe es ist, die Probleme zu finden.
Wo KI-Agenten scheitern
Agenten scheitern auf vorhersehbare Weise, und jeder ehrliche Leitfaden muss sich damit befassen. Eine Studie aus dem Jahr 2025, Why Do Multi-Agent LLM Systems Fail? (Cemri et al.), hat mehr als 1.600 Ausführungsprotokolle aus sieben verbreiteten Multi-Agenten-Rahmenwerken ausgewertet und 14 verschiedene Fehlermuster in drei Gruppen gefunden: Probleme im Aufbau des Systems, mangelnde Abstimmung zwischen den Agenten und schwache Überprüfung des Endergebnisses.
Sich aufschaukelnde Fehler
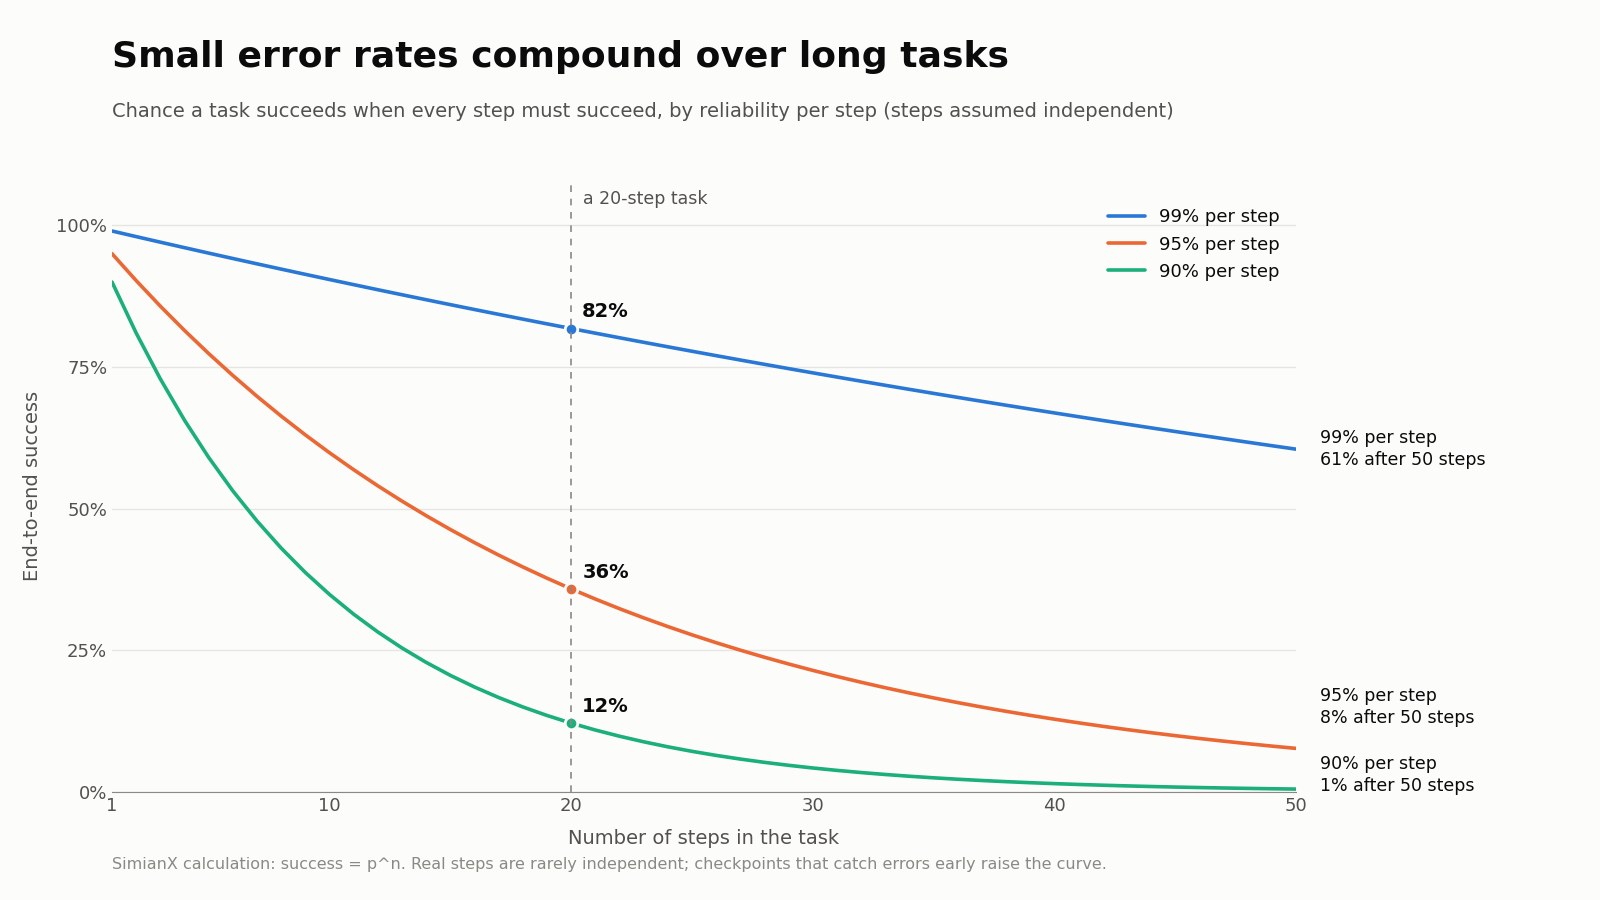
Lange Aufgaben vervielfachen kleine Fehlerquoten. Gelingt jeder Schritt einer Aufgabe in 95 % der Fälle und sind die Schritte voneinander unabhängig, gelingt eine Aufgabe mit 20 Schritten nur in etwa 36 % der Fälle (0,95 hoch 20). Bei 99 % pro Schritt gelingt dieselbe Aufgabe in etwa 82 % der Fälle. Deshalb zählt die Zuverlässigkeit pro Schritt mehr als Brillanz bei einem einzelnen Schritt, und deshalb brauchen Agenten Kontrollpunkte, die einen Fehler abfangen, bevor der nächste Schritt darauf aufbaut.
Halluzinationen und falsch gelesene Werkzeugergebnisse
Ein Modell kann eine Tatsache erfinden, ein Werkzeugergebnis falsch lesen oder eine veraltete Zahl weitertragen, als wäre sie aktuell. Agenten verschärfen das, weil ein erfundener Wert zur Eingabe der nächsten Aktion werden kann. Die Abhilfe ist struktureller Art: Rohdaten statt Umschreibungen weitergeben, wichtige Zahlen im Code prüfen, statt der Rechenkunst des Modells zu vertrauen, und für jede Behauptung, auf die es ankommt, eine Quelle verlangen.
Kosten
Jeder Durchlauf der Schleife ist ein weiterer Modellaufruf, und der Kontext wächst im Lauf der Aufgabe. Eine Aufgabe, die in einer Vorführung günstig aussieht, kann im Produktivbetrieb ein Vielfaches kosten, sobald der Agent erneut ansetzt, reflektiert und noch einmal liest. Legen Sie feste Budgets pro Aufgabe fest und messen Sie die Kosten einer erledigten Aufgabe, nicht die eines einzelnen Aufrufs.
Latenz
Agenten tauschen Tempo gegen Qualität. Eine Chat-Antwort dauert Sekunden; ein Rechercheagent kann Minuten brauchen, und ein Programmieragent, der eine große Änderung durcharbeitet, kann weit länger laufen. Unser eigenes Tiefenanalyse-Komitee aus acht Agenten braucht für eine Aktie mehrere Minuten, weil die Agenten recherchieren, debattieren und abstimmen, bevor etwas geschrieben wird.
Bewertung
Agenten arbeiten nicht deterministisch: Dieselbe Aufgabe kann in einem Durchlauf gelingen und im nächsten scheitern. Der Vergleichstest τ-bench führte eine Kennzahl namens pass^k ein – die Wahrscheinlichkeit, dass ein Agent bei allen k Versuchen derselben Aufgabe erfolgreich ist – und stellte fest, dass selbst starke Agenten mit Funktionsaufrufen aus jener Zeit in seinem Einzelhandelsszenario seltener als in 25 % der Fälle alle acht Versuche schafften. Ein einzelner beeindruckender Durchlauf sagt wenig aus. Öffentliche Vergleichstests wie SWE-bench für das Programmieren und OSWorld für die Computerbedienung sind nützlich, aber es sind nicht Ihre Aufgaben.
Sicherheit und Berechtigungen
Ein Agent, der Webseiten oder E-Mails liest, kann durch darin versteckte Anweisungen manipuliert werden – ein Angriff, der als Prompt-Injektion bekannt ist und die OWASP-Liste der Risiken für LLM-Anwendungen anführt. Geben Sie Agenten nur die Zugriffe, die sie wirklich brauchen, halten Sie Geheimnisse aus ihrem Kontext heraus und verlangen Sie vor allem Unumkehrbaren eine Freigabe, etwa bevor Geld bewegt wird.
Diese Probleme haben geschäftliche Folgen. In derselben Mitteilung vom Juni 2025 sagte Gartner voraus, dass mehr als 40 % der Projekte mit agentischer KI bis Ende 2027 eingestellt werden, und nannte steigende Kosten, unklaren Geschäftsnutzen und unzureichende Risikokontrollen als Gründe.
Ein Praxisbeispiel: Wie SimianX-Agenten eine Handelsentscheidung aufteilen
Der Handel ist ein anspruchsvoller Test für Agenten. Daten treffen ununterbrochen ein, die richtige Antwort ist zum Zeitpunkt der Entscheidung unbekannt, und jede Einschätzung wird am Ende vom Markt bewertet. So teilt unser System die Arbeit auf.
Echtzeitanalyse: drei Spezialisten und ein Entscheidungsagent
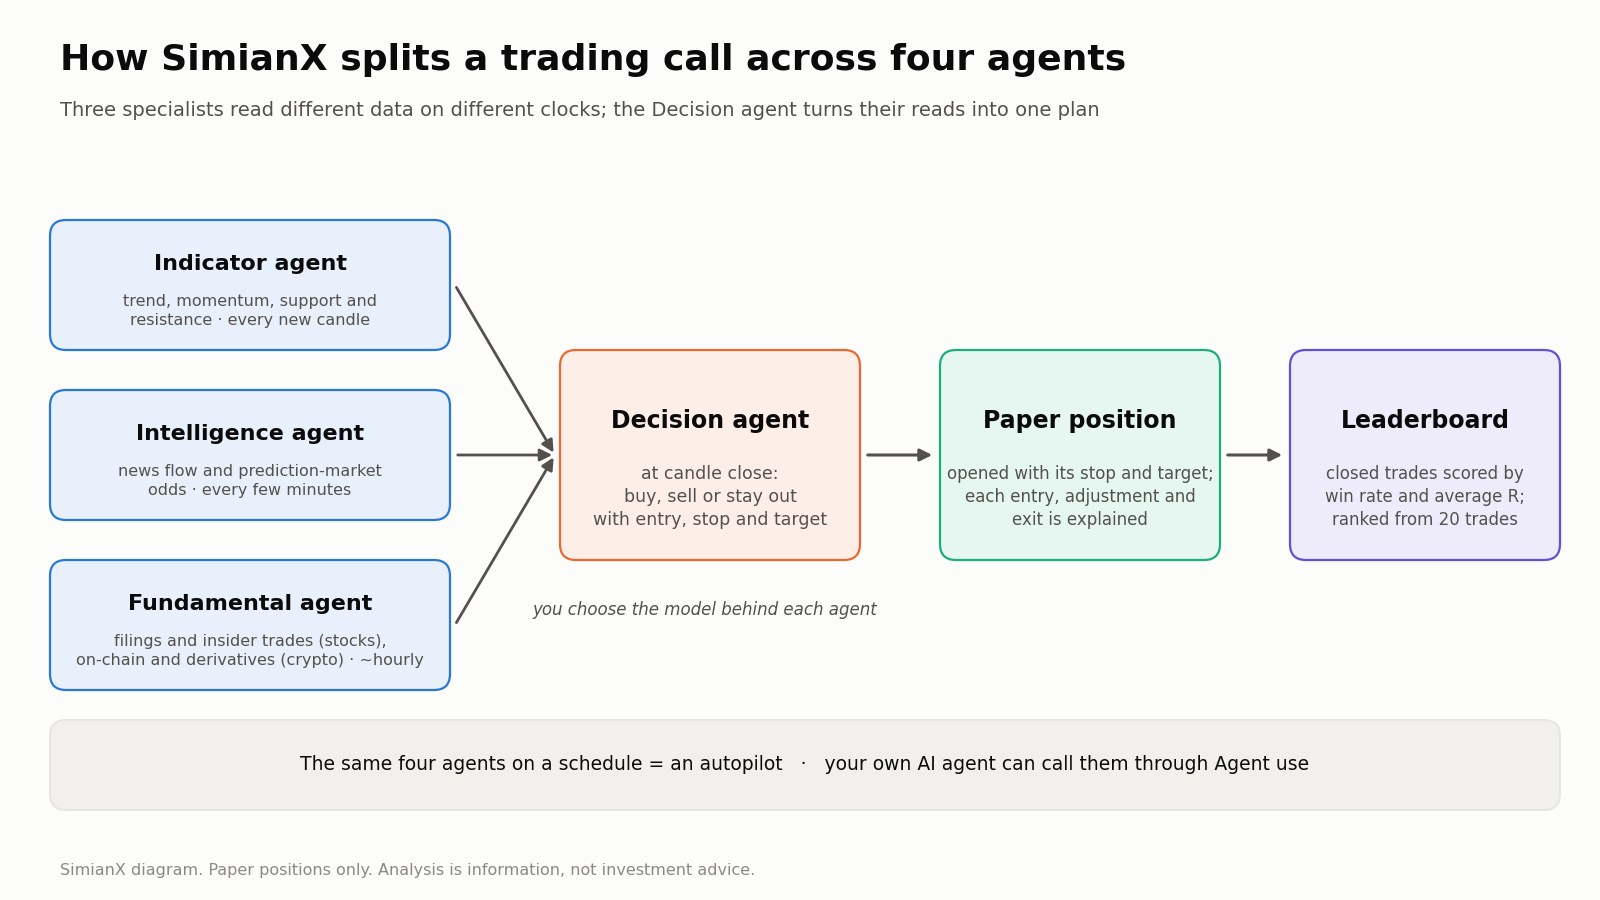
Wenn Sie im Echtzeit-Analyseraum eine US-Aktie oder ein Krypto-Paar öffnen und einen Zeitrahmen wählen, machen sich vier Agenten an die Arbeit. Abgedeckt sind mehr als 13.000 US-Aktien und ETFs sowie mehr als 4.000 Krypto-Paare, von 1-Minuten-Kerzen aufwärts.
- Der Indikator-Agent liest das Kursdiagramm: Trend, Dynamik, Unterstützung und Widerstand. Er läuft bei jeder neuen Kerze.
- Der Informations-Agent liest den Nachrichtenfluss zum jeweiligen Wert und, wo es sie gibt, die Quoten von Prognosemärkten. Er aktualisiert sich alle paar Minuten.
- Der Fundamental-Agent liest Pflichtveröffentlichungen und Insidergeschäfte bei einer Aktie oder Blockchain- und Derivatedaten bei einer Kryptowährung. Diese ändern sich langsam, deshalb aktualisiert er sich standardmäßig etwa einmal pro Stunde.
- Der Entscheidungsagent wägt bei Kerzenschluss die anderen drei ab und sagt, was zu tun ist: kaufen, verkaufen oder abwarten – mit Einstieg, Stopp-Kurs und Kursziel.
Sobald sich eine Gelegenheit abzeichnet, eröffnet das System eine simulierte Position mit diesem Stopp-Kurs und Kursziel und erklärt dann jeden Einstieg, jede Anpassung und jeden Ausstieg, während sich das Geschäft entwickelt. Sie wählen das Modell hinter jedem Agenten. Dieselben vier Agenten können auch nach Zeitplan als Autopilot laufen, und der bewertete Nachrichtenstrom, auf den der Informations-Agent zugreift, ist derselbe Datenstrom, der den Marktpuls speist.
Warum die Arbeit so aufteilen? Die drei Spezialisten laufen in unterschiedlichen Takten. Getrennt kann die Chartanalyse bei jeder Kerze aktualisiert werden, ohne dafür zu bezahlen, eine unveränderte Pflichtveröffentlichung erneut zu lesen. Das hält den Kontext jedes Agenten klein und fokussiert. Und es macht Uneinigkeit sichtbar: Wenn das Kursbild einen Ausbruch zeigt und der Informations-Agent auf einen Quartalsbericht am nächsten Tag hinweist, muss der Entscheidungsagent den Konflikt auflösen, statt ihn wegzumitteln.
Tiefenanalyse: ein Komitee aus acht Agenten
Für einen langsameren, tieferen Blick auf eine Aktie oder Kryptowährung setzt die Tiefenanalyse ein Komitee aus acht Mitgliedern ein. Vier Analysten recherchieren parallel: Fundamentaldaten, das Kursdiagramm, die Nachrichten und ein vierter Platz, der bei Aktien eine Einschätzung des Zeitpunkts liefert und bei Kryptowährungen mit einem Derivate-Analysten besetzt ist. Ein Bullen-Rechercheur und ein Bären-Rechercheur bauen danach für jede Seite das stärkste Argument auf. Ein Rechercheleiter moderiert eine Debatte über die größten Meinungsverschiedenheiten, jedes Mitglied bekräftigt seine Haltung in einer Schlussabstimmung, und ein Risikomanager schreibt die Entscheidung mit geprüften Kursniveaus. Unser Rundgang durch das neu gebaute Komitee begleitet einen vollständigen Durchlauf Bildschirm für Bildschirm.
Das ist das Debattenmuster aus der Forschungsliteratur, in den Produktivbetrieb übertragen. Den Bären gibt es, weil ein Komitee aus zustimmenden Analysten in Wahrheit eine einzige Meinung ist, viermal wiederholt.
Wie die Rangliste Ergebnisse misst
Ein Agent, der Handelsentscheidungen trifft, muss an Ergebnissen gemessen werden, nicht daran, wie überzeugend seine Begründung klingt. Die Krypto-Rangliste bewertet die KI-Modelle hinter diesen simulierten Positionen, und es zählen nur abgeschlossene Geschäfte, abgerechnet zu echten Marktpreisen. Sie umfasst derzeit mehr als 30 Modelle mehrerer KI-Labore und misst jedes davon auf zwei Arten:
- Trefferquote: der Anteil der abgeschlossenen Geschäfte, die mit Gewinn endeten.
- Durchschnittliches R: der Gewinn pro Geschäft, gemessen in Einheiten des beim Einstieg eingegangenen Risikos. Eine Kaufposition bei 100 mit Stopp-Kurs bei 98 riskiert 2 pro Einheit; ein Schluss bei 104 ergibt +2R, ein vollständiges Ausstoppen −1R.
Ein Modell wird erst nach 20 abgeschlossenen Geschäften in den aktuellen Filtern eingestuft, sodass eine glückliche Handvoll Geschäfte es nicht an die Spitze bringen kann, und Sie können nach Zeitraum, Zeitrahmen und Richtung filtern. Beide Zahlen zusammen zu lesen ist wichtig: Eine hohe Trefferquote mit niedrigem R kann einige große Verluste verbergen, während eine mäßige Trefferquote mit hohem R weniger, aber größere Gewinne bedeuten kann. Die Modelle hinter der Rangliste haben wir in Welches KI-Modell handelt am besten? und in unserem Leitfaden GPT vs. Gemini vs. Claude verglichen.
Den eigenen Agenten anbinden
Dasselbe System steht auch externen Agenten offen. Die Seite Nutzung mit Agenten erklärt, wie Sie Claude Code, Codex, Cursor oder einem anderen Agenten das SimianX-Skill-Paket und einen API-Schlüssel geben, damit er für jeden beliebigen Wert eine Echtzeitanalyse mit vier Agenten starten, dem bewerteten Nachrichtenstrom folgen oder eine Tiefenanalyse durchführen kann. Ihr Agent erhält einen eigenen Schlüssel mit einem Budget, das Sie festlegen. Er bekommt nie Ihre Website-Anmeldedaten, und jede Position, die er verwaltet, ist eine simulierte Position.
Risikohinweis: Alles oben Beschriebene ist Software, die Analysen und simulierte Geschäfte erzeugt. Es handelt sich um Informationen, nicht um Anlageberatung. KI-Modelle machen Fehler, Ranglistenergebnisse beschreiben vergangene Geschäfte und sagen keine künftigen Renditen voraus, und kein Modell und kein Komitee beseitigt das Marktrisiko. Handeln Sie niemals mit Geld, dessen Verlust Sie sich nicht leisten können, nur weil eine KI es nahelegt.
Arten von KI-Agenten im Jahr 2026
Die Einteilung aus dem Lehrbuch
Lehrbücher teilen Agenten danach ein, wie sie entscheiden, und diese Kategorien helfen noch immer, moderne Systeme zu verstehen:
| Typ | Wie er entscheidet | Beispiel |
|---|---|---|
| Einfacher Reflexagent | Feste Bedingungs-Aktions-Regeln auf die aktuelle Eingabe | Ein Thermostat; ein Kursalarm |
| Modellbasierter Reflexagent | Regeln plus ein inneres Bild dessen, was er nicht direkt beobachten kann | Ein Spamfilter, der die Vorgeschichte eines Absenders verfolgt |
| Zielbasierter Agent | Sucht nach Aktionen, die ein vorgegebenes Ziel erreichen | Ein Routenplaner |
| Nutzenbasierter Agent | Wählt die Aktion mit dem besten erwarteten Kompromiss | Ein Handelsagent, der Ertragschance gegen Risiko abwägt |
| Lernender Agent | Verbessert sein Verhalten anhand von Rückmeldungen | Ein Empfehlungssystem, das sich nach Klicks anpasst |
Sprachmodell-Agenten mischen diese Typen. Sie sind zielbasiert in dem, was sie verfolgen, nutzenbasiert, wenn sie Optionen abwägen, und sie lernen innerhalb einer Aufgabe, indem sie über Ergebnisse reflektieren.
Die Produktkategorien
Nach dem gruppiert, was sie tatsächlich tun, fallen die Agenten, die Menschen 2026 nutzen, in fünf grobe Kategorien. Die hier genannten Produkte sind Beispiele, keine Empfehlungen, und ihre Fähigkeiten ändern sich schnell.
Programmieragenten. Ein KI-Programmieragent liest ein Quellcode-Archiv, bearbeitet Dateien, führt die Tests aus und schlägt eine Änderung vor, oft als Änderungsanfrage (Pull-Request). Beispiele sind Claude Code von Anthropic, Codex von OpenAI, der Programmieragent in GitHub Copilot, Cursor und Devin von Cognition. Verglichen werden sie häufig mit SWE-bench, das von ihnen verlangt, echte gemeldete Probleme aus quelloffenen Projekten zu lösen. Forschung von METR legt nahe, dass sich die Länge der Softwareaufgaben, die führende Agenten mit 50 % Zuverlässigkeit bewältigen, seit 2019 ungefähr alle sieben Monate verdoppelt hat.
Rechercheagenten. Sie durchsuchen das Web oder eine Dokumentensammlung, lesen viele Quellen und schreiben einen Bericht mit Quellenangaben. Google brachte Gemini Deep Research im Dezember 2024 heraus, OpenAI führte im Februar 2025 die Funktion deep research in ChatGPT ein. Ihr Schwachpunkt ist die Qualität der Quellen: Ein gut geschriebener Bericht kann dennoch auf einer schlechten Quelle beruhen.
Browser- und Computerbedienungs-Agenten. Sie bedienen einen Browser oder eine ganze Arbeitsoberfläche, indem sie auf den Bildschirm schauen, klicken und tippen. Anthropic veröffentlichte die Funktion computer use im Oktober 2024. OpenAIs Operator, im Januar 2025 gestartet, ging im Juli 2025 in ChatGPT agent auf, und Google hat Project Mariner. Sie sind langsamer und weniger zuverlässig als Agenten, die über APIs arbeiten, weshalb man sie meist für Websites reserviert, die keine API anbieten.
Allzweck-Agenten. Sie nehmen ein breit gefasstes Ziel entgegen und kombinieren Surfen im Web, Code und Dateien, um es zu erreichen. Manus, im März 2025 gestartet, ist das bekannteste Beispiel. Meta vereinbarte im Dezember 2025 die Übernahme des Unternehmens; im April 2026 ordnete Chinas Nationale Entwicklungs- und Reformkommission die Rückabwicklung des Geschäfts an.
Handels- und Marktanalyse-Agenten. Sie lesen Marktdaten, Nachrichten und Pflichtveröffentlichungen und erstellen Handelspläne oder verwalten Positionen. Akademische Rahmenwerke wie TradingAgents (Xiao et al., 2024) bilden ein Handelshaus mit Rollen für Analyse, Recherche, Handel und Risikomanagement nach, und Produkte wie SimianX betreiben ähnliche Komitees mit Echtzeitdaten. Märkte sind ein Wettstreit gegen andere Teilnehmer und voller Rauschen, deshalb ist dies die Kategorie, in der eine öffentliche, Geschäft für Geschäft nachvollziehbare Erfolgsbilanz am meisten zählt.
So bewerten Sie einen KI-Agenten: eine Checkliste
Ob Sie einen Programmieragenten, ein Recherchewerkzeug oder einen Handelsassistenten auswählen: Dieselben Fragen trennen nützliche Agenten von bloßen Vorführungen.
| Frage | So sieht es gut aus | Warnsignal |
|---|---|---|
| Ist es wirklich ein Agent? | Er wählt seine Schritte und Werkzeuge selbst | Ein festes Skript mit „Agent“-Etikett |
| Funktioniert er bei Ihren Aufgaben? | Getestet an 10–20 echten Aufgaben aus Ihrer eigenen Arbeit | Nur Herstellervorführungen und Vergleichstest-Werte |
| Ist er beständig? | Ähnliche Ergebnisse, wenn dieselbe Aufgabe mehrfach läuft | Ein großartiger Durchlauf, danach Fehlschläge |
| Was kostet eine erledigte Aufgabe? | Die Kosten pro abgeschlossener Aufgabe werden gemessen und gedeckelt | Es werden nur Preise pro Aufruf genannt |
| Wie lange dauert es? | Das Tempo passt zur Aufgabe | Minutenlanges Warten auf eine einzeilige Antwort |
| Können Sie sehen, was er getan hat? | Ein vollständiges Protokoll der Schritte, Werkzeugaufrufe und Quellen | Eine Endantwort ohne nachvollziehbare Spur |
| Worauf darf er zugreifen? | Minimale Rechte, abgeschottete Testumgebung oder Simulationsmodus, Freigabe für unumkehrbare Aktionen | Weitreichende Zugangsdaten und kein Freigabeschritt |
| Wie hört er auf? | Budgets, Schrittgrenzen und eine klare Abbruchregel | Endlosschleifen, bis es jemand bemerkt |
| Wie aktuell sind seine Daten? | Ein Zeitstempel an jedem Datenpunkt | Veraltete Zahlen, die als aktuell ausgegeben werden |
| Bei Handelsagenten: Wie sieht die Erfolgsbilanz aus? | Abgeschlossene Geschäfte zu echten Preisen, Stichprobengröße angegeben, Trefferquote und risikobereinigte Rendite | Nur Rückrechnungen auf historischen Daten oder eine Trefferquote ohne Zahl der Geschäfte |
Häufig gestellte Fragen
Was ist ein KI-Agent, einfach erklärt?
Ein KI-Agent ist ein Programm, das mit einem KI-Modell selbstständig ein Ziel erreicht. Er betrachtet die Lage, entscheidet über einen Schritt, führt ihn mit einem Werkzeug wie Suche oder Code aus, prüft das Ergebnis und wiederholt das Ganze, bis die Aufgabe erledigt ist oder er einen Menschen braucht.
Was ist der Unterschied zwischen einem KI-Agenten und einem Chatbot?
Ein Chatbot beantwortet eine Nachricht nach der anderen und wartet dann auf Sie. Ein Agent arbeitet über viele Schritte auf ein Ziel hin, wählt selbst, welche Werkzeuge er nutzt, und kann eine Aufgabe – etwa Code reparieren oder einen Bericht schreiben – abschließen, ohne für jeden Schritt eine neue Eingabe zu brauchen.
Was ist ein Multi-Agenten-System?
Ein Multi-Agenten-System ist eine Gruppe von KI-Agenten mit unterschiedlichen Rollen, die gemeinsam an einer Aufgabe arbeiten. Sie können die Arbeit aufteilen, gegensätzliche Positionen debattieren oder abstimmen, und ein letzter Agent oder eine feste Regel führt ihre Ergebnisse zusammen. Bei breit angelegten Aufgaben schlagen sie oft einen Einzelagenten, allerdings zu deutlich höheren Kosten.
Was ist ein KI-Programmieragent?
Ein KI-Programmieragent arbeitet innerhalb eines Softwareprojekts: Er liest den Code, bearbeitet Dateien, führt Tests aus und schlägt Änderungen vor. Beispiele sind Claude Code, OpenAI Codex, der Programmieragent in GitHub Copilot, Cursor und Devin.
Was ist Manus AI?
Manus ist ein Allzweck-KI-Agent, im März 2025 gestartet, der ein breit gefasstes Ziel entgegennimmt und es mit Surfen im Web, Code und Dateien erledigt. Meta vereinbarte im Dezember 2025 den Kauf des Unternehmens, und im April 2026 ordneten chinesische Regulierungsbehörden die Rückabwicklung des Geschäfts an.
Können KI-Agenten mit Aktien oder Kryptowährungen handeln?
Sie können Märkte analysieren und Positionen verwalten, und manche Produkte, darunter SimianX, lassen Agenten simulierte Positionen mit Stopp-Kursen und Kurszielen führen. Die Ergebnisse unterscheiden sich je nach Modell und Markt stark. Beurteilen Sie einen Handelsagenten daher nach seiner Bilanz abgeschlossener Geschäfte und behandeln Sie seine Ausgaben als Information, nicht als Beratung.
Wie verbinde ich meinen eigenen KI-Agenten mit einer Echtzeit-Marktanalyse?
Die SimianX-Seite Nutzung mit Agenten zeigt, wie Sie das SimianX-Skill-Paket in Claude Code, Codex, Cursor und anderen Agenten installieren. Ihr Agent erhält einen eigenen API-Schlüssel mit einem Budget, das Sie steuern, und kann Echtzeitanalysen mit mehreren Agenten starten, dem bewerteten Nachrichtenstrom folgen und Tiefenanalysen durchführen.
Verwandte Artikel
- KI-Aktienanalyse neu gebaut: 8-Agenten-Komitee zum Befragen
- 8 KI-Analysten vs 1: +37% Genauigkeit, −41% Risiko
- Welches KI-Modell handelt am besten? 30 LLMs an echtem P&L
- 30+ KI-Modelle, 6 Anbieter: Crypto-Live-Leaderboard
- GPT vs Gemini vs Claude für KI-Aktienanalyse: 2026 Guide
- Multi-Agent KI vs ChatGPT für NVDA-Signale: 2026 Vergleich
- KI-Autopiloten für Krypto 24/7: Der vollständige Guide 2026
- Aktien-Analyse Live: KI-Agenten für US-Aktien in Echtzeit
- Agentic-KI-Investieren: Anfängerleitfaden Next-Gen
Quellen
- Russell & Norvig — Artificial Intelligence: A Modern Approach
- Anthropic — Building Effective Agents (Dezember 2024)
- Anthropic — How we built our multi-agent research system (Juni 2025)
- Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning
- Du et al. — Improving Factuality and Reasoning in Language Models through Multiagent Debate
- Cemri et al. — Why Do Multi-Agent LLM Systems Fail?
- Yao et al. — τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- METR — Measuring AI Ability to Complete Long Tasks
- Xiao et al. — TradingAgents: Multi-Agents LLM Financial Trading Framework
- Model Context Protocol — offizielle Dokumentation
- Agent2Agent (A2A) Protocol — offizielle Website
- Gartner — Über 40 % der Projekte mit agentischer KI werden bis Ende 2027 eingestellt (Juni 2025)
- TechCrunch — China blockiert Metas 2-Milliarden-Dollar-Übernahme von Manus (April 2026)
- IBM — Was sind KI-Agenten?
- OWASP — Top 10 für Anwendungen mit großen Sprachmodellen