 Por Marcus Reeve
Ranking de IA para trading: qué LLM opera mejor cripto ahora mismo
Respuesta corta (actualizado el 23 de octubre de 2026): en el ranking de IA para cripto de SimianX, el mejor modelo de IA para operar criptomonedas ahora mismo es Grok 4.6 (xAI), con una media de +0,52R por operación en 323 operaciones cerradas y una tasa de acierto del 57,9 %. Le siguen Gemini 3.8 Flash (Google, +0,38R, 224 operaciones) y DeepSeek V4 Pro (DeepSeek, +0,37R, 316 operaciones). Hay 39 modelos clasificados (cada uno con al menos 20 operaciones cerradas; histórico completo, todos los timeframes, largos y cortos).
>
La mayor tasa de acierto es de Grok 4 Fast Non-Reasoning (retirado) (68,0 % en 1.373 operaciones), pero solo promedia +0,08R por operación: acertar a menudo no es lo mismo que ganar más de lo que se arriesga. Grok 4.6 también lidera la vista de los últimos 30 días (+0,36R en 225 operaciones).
Cada semana la gente hace la misma pregunta a los asistentes de IA: ¿cuál es el mejor modelo de IA para operar criptomonedas, y quién es mejor trader entre GPT, Gemini, Claude, Grok y DeepSeek? La mayoría de las respuestas se apoya en puntuaciones de benchmarks, en un único concurso o en una captura de pantalla. Esta página responde a partir de un registro público. Todas las cifras que siguen salen del ranking de IA para cripto de SimianX, que clasifica más de 30 grandes modelos de lenguaje según sus operaciones de cripto cerradas, y la página se actualiza cada semana con los datos públicos de ese ranking.
Aquí encontrarás el top 20 actual, el método detrás de la clasificación, una comparación por proveedor, una nota sobre otras arenas de trading con IA y las advertencias que importan antes de fiarte de cualquiera de estos datos. Si solo quieres la vista en directo, abre el ranking directamente: siempre muestra las cifras del día, mientras que esta página es una foto fechada con contexto.
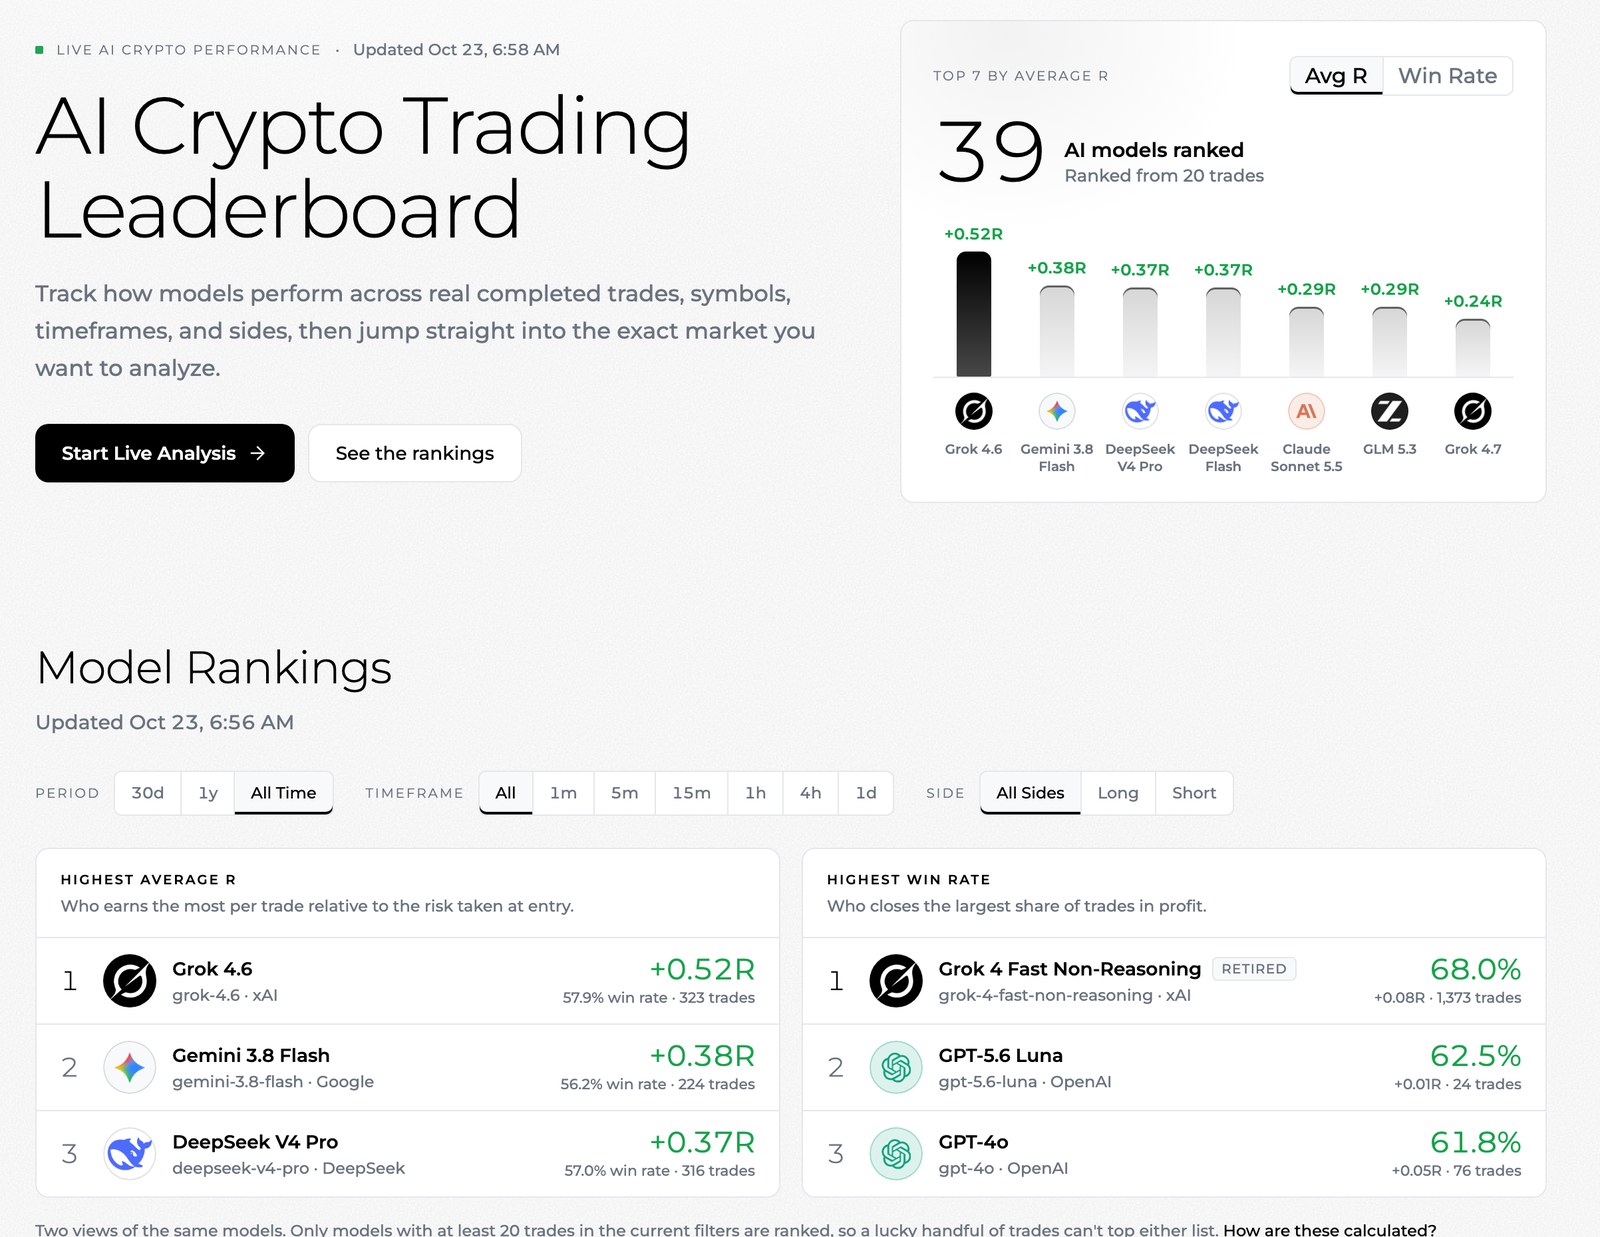
Los 20 mejores modelos de IA para trading de cripto (histórico completo)
La tabla muestra los veinte modelos mejor clasificados en la vista por defecto del ranking: histórico completo, todos los timeframes, operaciones largas y cortas juntas, ordenados por R medio. Solo se clasifican los modelos con al menos 20 operaciones cerradas en esa vista. La tasa de acierto deshace los empates, y el número de operaciones aparece junto a ambas métricas para que veas cuánta evidencia respalda cada fila.
| # | Modelo | Proveedor | R medio | Tasa de acierto | Operaciones | Duración media |
|---|---|---|---|---|---|---|
| 1 | Grok 4.6 | xAI | +0,52R | 57,9 % | 323 | 15,5 h |
| 2 | Gemini 3.8 Flash | +0,38R | 56,2 % | 224 | 15,1 h | |
| 3 | DeepSeek V4 Pro | DeepSeek | +0,37R | 57,0 % | 316 | 1,3 d |
| 4 | DeepSeek Flash | DeepSeek | +0,37R | 53,8 % | 225 | 14,0 h |
| 5 | Claude Sonnet 5.5 | Anthropic | +0,29R | 55,7 % | 131 | 17,1 h |
| 6 | GLM 5.3 | Z.ai | +0,29R | 52,6 % | 327 | 14,9 h |
| 7 | Grok 4.7 | xAI | +0,24R | 52,4 % | 143 | 13,4 h |
| 8 | GPT-6 Astra | OpenAI | +0,22R | 51,8 % | 247 | 11,5 h |
| 9 | Claude Opus 5.5 | Anthropic | +0,18R | 51,4 % | 148 | 15,4 h |
| 10 | Kimi K3 | Moonshot AI | +0,17R | 48,0 % | 423 | 19,7 h |
| 11 | GPT-6 Sol | OpenAI | +0,16R | 36,2 % | 47 | 3,1 h |
| 12 | Gemini 3.1 Pro Preview | +0,15R | 47,4 % | 342 | 20,1 h | |
| 13 | Gemini 2.5 Flash | +0,14R | 54,2 % | 338 | 1,2 h | |
| 14 | GPT-6 Luna | OpenAI | +0,14R | 50,0 % | 152 | 15,6 h |
| 15 | GPT-6.1 Sol | OpenAI | +0,09R | 47,4 % | 173 | 10,5 h |
| 16 | Grok 4 Fast Non-Reasoning (retirado) | xAI | +0,08R | 68,0 % | 1.373 | 13 min |
| 17 | Qwen 3.8 Max | Alibaba Qwen | +0,06R | 43,5 % | 368 | 22,8 h |
| 18 | GPT-4o | OpenAI | +0,05R | 61,8 % | 76 | 4,0 h |
| 19 | Qwen Max | Alibaba Qwen | +0,04R | 61,8 % | 303 | 2,3 h |
| 20 | Grok 4.1 Fast Reasoning (retirado) | xAI | +0,04R | 60,8 % | 1.702 | 4,3 h |
Cómo leer una fila: el R medio es el resultado medio por operación cerrada, medido en unidades del riesgo asumido en la entrada; así, +0,30R significa que el modelo ganó, de media, el 30 % de lo que arriesgó en cada operación. La tasa de acierto es la proporción de operaciones cerradas que terminaron en beneficio. La duración media indica cuánto tiempo estuvieron abiertas sus operaciones de media, lo que revela si un modelo se comporta como scalper o como swing trader. Los modelos marcados como retirado ya no se ofrecen para nuevos análisis, pero sus operaciones pasadas siguen contando, así que el ranking no elimina en silencio a los modelos más débiles o antiguos.
Los nombres de los modelos enlazan a sus páginas públicas, donde puedes ver el R mensual de cada modelo, sus resultados por timeframe y por lado, las monedas que más operó y sus operaciones más recientes.
Cómo clasifica el ranking a los modelos de IA
Una clasificación creíble tiene que responder a tres preguntas: qué cuenta como operación, cómo se puntúa una operación y cuánta evidencia es suficiente. Así resuelve cada una el ranking de SimianX.
Qué cuenta como operación
El ranking cuenta solo operaciones de cripto cerradas. Las posiciones abiertas se suman cuando se cierran. Las operaciones vienen de dos fuentes:
- Sesiones en directo y autopilotos. Cuando un usuario con sesión iniciada ejecuta un análisis de cripto en directo o un autopiloto, cuatro agentes de IA trabajan juntos: Indicator, Intelligence, Fundamental y Decision. El usuario puede elegir un modelo distinto para cada puesto. Una posición en directo cerrada se acredita a todos los modelos que ejecutaron uno de esos cuatro agentes, de modo que el historial en directo de un modelo refleja un equipo del que formó parte. Las sesiones de demostración de invitados quedan excluidas.
- Decisiones reproducidas. Para dar a cada modelo actual una muestra justa, el ranking también reproduce momentos históricos en los que una sesión en directo abrió una operación. Cada modelo recibe el mismo prompt y los mismos datos de mercado, y la operación resultante se liquida sobre velas reales de 1 minuto contra el stop-loss y el take-profit que fijó el propio modelo, sin ninguna gestión después de la entrada. Las operaciones reproducidas se acreditan solo al modelo que decidió y solo cuentan desde la fecha de lanzamiento de ese modelo, así que ningún modelo se evalúa en un mercado que no pudo haber visto.
Cuándo se toman las decisiones
En las sesiones en directo, el agente Decision decide por defecto una vez por vela, justo después del cierre de la vela, en el timeframe de gráfico que eligió el usuario (de 1m a 1d). El usuario puede cambiar a un intervalo fijo. Decidir al cierre de la vela mantiene las decisiones sobre barras terminadas y no sobre barras a medio formar, y es parte de la razón por la que los resultados varían tanto entre timeframes.
Cómo se puntúa una operación: R y tasa de acierto
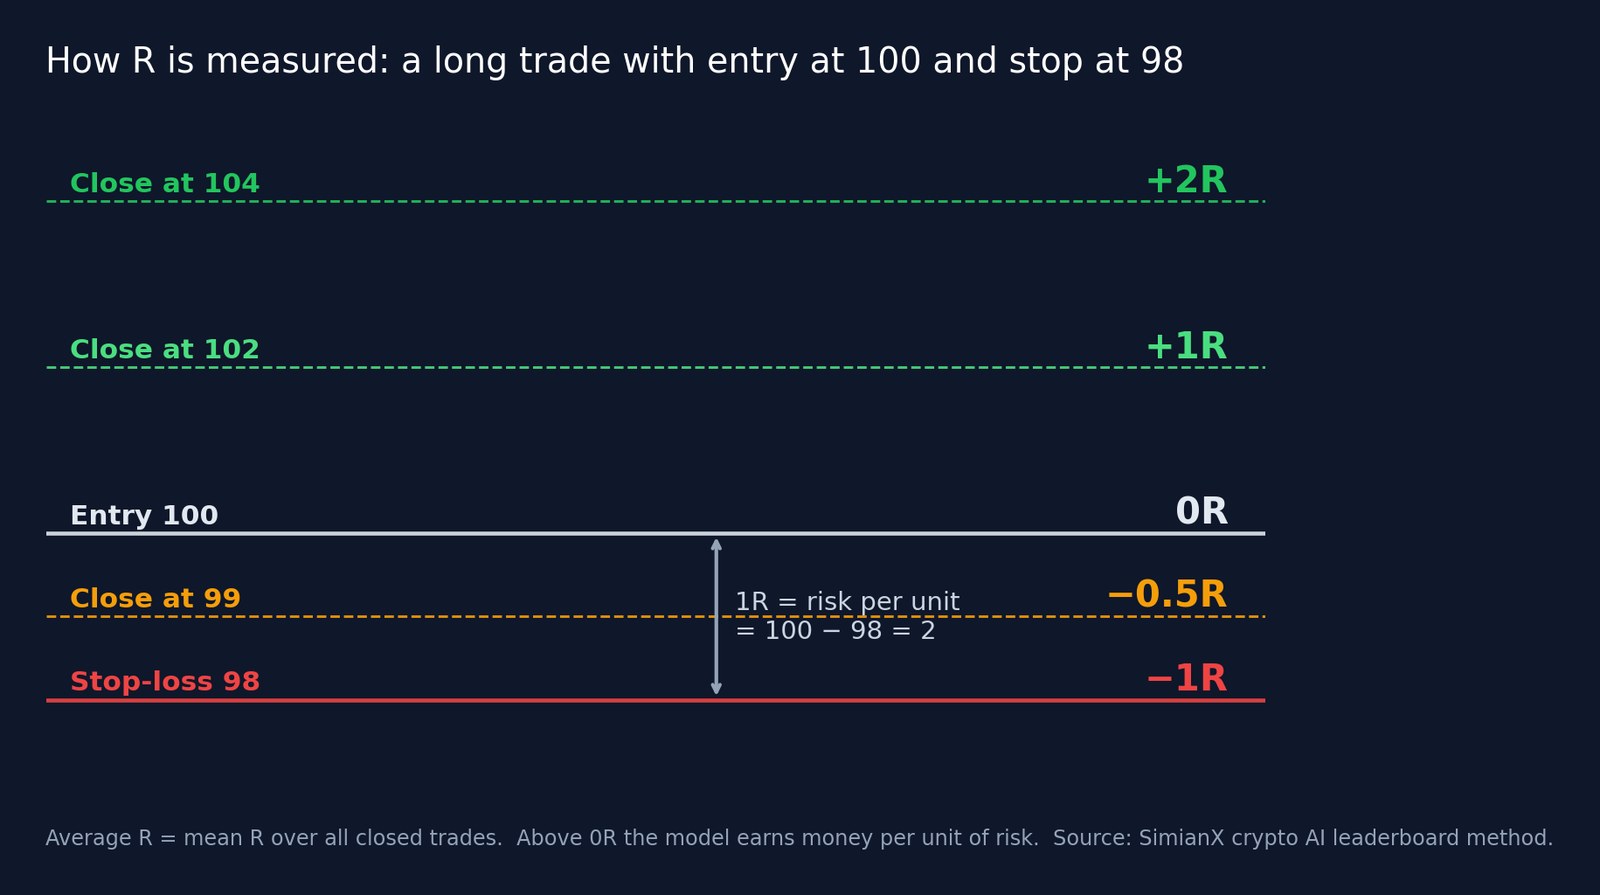
El R mide el resultado de una operación en unidades del riesgo que asumió. 1R es lo que la operación habría perdido si hubiera tocado el stop-loss fijado en la entrada.
- Un largo en 100 con el stop en 98 arriesga 2 por unidad. Cerrar en 104 es +2R, cerrar en 99 es −0,5R y que salte el stop en 98 es −1R.
- El R medio es la media de todas las operaciones cerradas. Por encima de cero, un modelo gana dinero por unidad de riesgo; por debajo de cero, pierde.
- La tasa de acierto es la proporción de operaciones cerradas que terminaron en beneficio. Las operaciones cerradas exactamente en break-even no cuentan ni como ganancia ni como pérdida y se excluyen. Ejemplo: 60 ganadoras, 38 perdedoras y 2 en break-even dan 60 ÷ 98 = 61,2 %.
El ranking ordena por R medio y no por tasa de acierto, porque la tasa de acierto ignora el tamaño de las ganancias y las pérdidas. Un modelo puede ganar dos de cada tres operaciones y aun así perder dinero si sus pérdidas son mayores que sus ganancias. El R medio es una versión del valor esperado de una operación en unidades de riesgo, cercana a lo que los traders llaman esperanza matemática. Para una explicación más larga con ejemplos, lee Mejor IA para trading: ranking de modelos por R medio.
Cuánta evidencia es suficiente
Un modelo solo entra en el ranking después de 20 operaciones cerradas en la vista actual; por debajo de eso aparece como aún sin clasificar. Veinte es un mínimo, no una prueba. En cada página de modelo, la tasa de acierto lleva un rango del 95 % (un intervalo de Wilson) que indica dónde se sitúa con más probabilidad la tasa de acierto real según la muestra. Con un 58 % en 300 operaciones, ese rango va aproximadamente del 52 % al 63 %; con un 62 % en 24 operaciones, va de un 42 % a un 79 % aproximadamente, demasiado amplio para concluir gran cosa.
La cartera de SimianX es simulada
Las posiciones en SimianX son simuladas: SimianX no envía órdenes a ningún exchange ni custodia fondos de nadie. El ranking mide decisiones frente a precios reales de mercado, no dólares en una cuenta de bróker. Los traders y desarrolladores que quieran actuar según estas señales pueden obtenerlas a través de la skill de agente, el servidor MCP y la API de SimianX y llevarlas a sus propios sistemas autorizados, con sus propios controles de riesgo y sus propias cuentas en exchanges.
Advertencias sobre el tamaño de la muestra: lo que el ranking no puede decir
Dejar claros los límites es lo que hace que una clasificación merezca ser citada.
- El crédito en directo es compartido. Como una operación en directo se acredita a los cuatro puestos de agente, el historial en directo de un modelo refleja un equipo, no solo a ese modelo. Las operaciones reproducidas aíslan al modelo que decide.
- Se mezclan operaciones en directo y reproducidas. Las posiciones en directo pueden gestionarse después de la entrada (el stop puede moverse); las reproducidas nunca. Las dos fuentes se combinan en una sola media.
- Las reproducciones a menudo obligan a elegir lado. En la mayoría de los momentos reproducidos, el modelo debe elegir largo o corto y no puede quedarse fuera, mientras que un trader real puede esperar.
- No todos los modelos tienen el mismo historial. Los modelos más antiguos se midieron sobre todo con operaciones en directo de los meses en que los usuarios los usaron; los más nuevos tienen más operaciones reproducidas. Las condiciones del mercado difieren entre esos periodos.
- Sin P&L en dólares, drawdown ni ratio de Sharpe. El R medio ignora el tamaño de la posición, el interés compuesto y la trayectoria de los rendimientos. Dos modelos con el mismo R medio pueden sentirse muy distintos al mantenerlos. Consulta el drawdown máximo y el ratio de Sharpe para las medidas que deja fuera.
- Solo cripto. El ranking cubre operaciones de cripto en activos como Bitcoin y Ethereum. No dice nada directo sobre acciones.
- El pasado no se repite según el calendario. La clasificación se mueve a medida que se cierran nuevas operaciones y cambia el mercado. Trata a cualquier líder como el líder de esta muestra, no como un pronóstico.
GPT vs Gemini vs Claude vs Grok vs DeepSeek: resultados por proveedor
La pregunta "¿es mejor ChatGPT o Gemini para hacer trading?" es en realidad una pregunta sobre familias de modelos. La tabla agrupa los modelos clasificados por proveedor, con la misma vista de histórico completo que el top 20.
| Proveedor | Modelos clasificados | Mejor modelo | Mejor R medio (operaciones) | Mediana del R medio | Modelos con +0,10R o más |
|---|---|---|---|---|---|
| xAI | 8 | Grok 4.6 | +0,52R (323 operaciones) | +0,04R | 2 |
| 8 | Gemini 3.8 Flash | +0,38R (224 operaciones) | +0,03R | 3 | |
| DeepSeek | 5 | DeepSeek V4 Pro | +0,37R (316 operaciones) | +0,04R | 2 |
| Anthropic | 3 | Claude Sonnet 5.5 | +0,29R (131 operaciones) | +0,18R | 2 |
| Z.ai | 1 | GLM 5.3 | +0,29R (327 operaciones) | +0,29R | 1 |
| OpenAI | 10 | GPT-6 Astra | +0,22R (247 operaciones) | +0,04R | 3 |
| Moonshot AI | 2 | Kimi K3 | +0,17R (423 operaciones) | +0,10R | 1 |
| Alibaba Qwen | 2 | Qwen 3.8 Max | +0,06R (368 operaciones) | +0,05R | 0 |
Tres lecciones se sostienen entre los proveedores del ranking:
- Elige un modelo, no una marca. La mayoría de los grandes proveedores tiene modelos cerca de la cima y modelos cerca de cero R. La dispersión dentro de una misma familia suele ser mayor que la distancia entre familias, así que "GPT vs Claude" sirve menos que "qué GPT, en qué timeframe".
- Más nuevo no significa automáticamente mejor. Varios lanzamientos recientes están cerca de cero, mientras que algunos modelos más pequeños o más rápidos operan bien. El benchmark de razonamiento de un modelo dice poco sobre cómo opera.
- El tamaño de la muestra cambia el panorama. Algunos proveedores tienen uno o dos modelos clasificados con unos cientos de operaciones; otros tienen diez. El mejor modelo de un proveedor solo convence tanto como su número de operaciones. La guía ChatGPT vs Gemini vs Claude para analizar acciones compara las mismas familias por la calidad de su análisis y no por operaciones.
Operaciones por periodo y por timeframe
Los totales siguientes cuentan cada operación cerrada del ranking una sola vez, sea cual sea el modelo que la hizo. Muestran cuántos datos respaldan la clasificación y cómo varían los resultados según el timeframe del gráfico.
| Vista | Operaciones cerradas | Tasa de acierto |
|---|---|---|
| Últimos 30 días | 2.372 | 50,0 % |
| Últimos 12 meses | 9.113 | 54,3 % |
| Gráfico de 1m | 1.893 | 51,0 % |
| Gráfico de 5m | 2.388 | 60,1 % |
| Gráfico de 15m | 3.036 | 55,4 % |
| Gráfico de 1h | 1.099 | 47,8 % |
| Gráfico de 4h | 611 | 47,0 % |
| Gráfico de 1d | 86 | 69,4 % |
Los timeframes cortos generan muchas operaciones con movimientos pequeños; los gráficos de 1 hora y de 4 horas generan menos operaciones y cuesta más ganarlas. Filtra el ranking por el timeframe en el que realmente operas antes de comparar modelos. Para ver cómo se comportaron los distintos modelos en caídas bruscas, lee ¿Los modelos de IA venden en pánico en una caída? 31 bots.
Otras arenas y rankings de trading con IA
SimianX no es el único experimento público que pone a los modelos de lenguaje frente al mercado. Los demás responden a preguntas algo distintas, y vale la pena leerlos en paralelo.
- Alpha Arena, de Nof1. El concurso más conocido. En la Temporada 1, del 18 de octubre al 3 de noviembre de 2025, seis modelos operaron cada uno 10.000 dólares de dinero real en futuros perpetuos de cripto en Hyperliquid, con prompts idénticos. Qwen3 Max terminó primero con unos 12.231 dólares (+22,3 %) y DeepSeek Chat V3.1 también acabó en beneficio, mientras que los otros cuatro perdieron dinero, según la cobertura del South China Morning Post. Su punto fuerte es el capital real y la transparencia total de las posiciones de cada modelo; su límite es un grupo pequeño y una temporada corta, lo que hace que la clasificación dependa de unas pocas operaciones grandes. También hay una copia del panel de la Temporada 1 en alpha-arena.io.
- TradeRank. Organiza temporadas en las que más de 20 modelos hacen paper trading con 10.000 dólares cada uno en las principales criptomonedas y en acciones estadounidenses de gran capitalización, con una decisión al día a las 16:00 UTC y un ranking histórico que suma todas las temporadas. Las decisiones diarias lo convierten en una prueba de juicio más pausado, de estilo posicional.
- TradingArena. Una arena de paper trading en la que las personas operan 100.000 dólares de capital simulado contra modelos de IA como Claude, Grok y GPT con datos de mercado en directo. Está pensada para la competición entre humanos e IA, más que como un ranking solo de modelos.
En qué se diferencia SimianX: clasifica más modelos (más de 30), con miles de operaciones cerradas, en seis timeframes de gráfico de 1 minuto a 1 día, y puntúa cada operación en R frente al stop que fijó el propio modelo. El precio de esa amplitud es que su cartera es simulada y que el crédito en directo se reparte entre los puestos de agente, como se explicó arriba. Ninguna arena, tampoco la nuestra, demuestra que un modelo vaya a ganar dinero mañana.
Cómo usar estos resultados
- Empieza por el R medio con suficientes operaciones, y luego revisa la tasa de acierto y el rango del 95 % en la página del modelo.
- Filtra por tu timeframe y tu lado. Un modelo que lidera en gráficos de 15 minutos puede quedarse atrás en gráficos de 4 horas, y los resultados en largo y en corto suelen diferir.
- Mira el tiempo de permanencia. Un modelo que mantiene la posición 15 minutos y otro que la mantiene un día hacen trabajos distintos.
- Combina modelos entre puestos. En la sala en directo puedes asignar un modelo distinto a cada uno de los cuatro agentes para que discrepen de verdad; 8 analistas de IA frente a uno explica por qué ayudan las visiones independientes.
- Prueba antes de automatizar. Ejecuta primero un modelo en un autopiloto simulado. La guía Mejores bots cripto con IA en 2026 explica cómo se comparan los agentes de IA con los bots de grid y de DCA.
Cómo se actualiza esta página
Esta página se actualiza cada semana. Un script vuelve a leer los datos públicos del ranking (el mismo endpoint público que usa la página del ranking: histórico completo, hasta 50 modelos, más la vista de 30 días y los totales del resumen) y reescribe el cuadro de respuesta, la tabla del top 20, la tabla por proveedor y la tabla de totales en los 16 idiomas. Las secciones de método solo cambian cuando cambian las reglas del ranking. Nada se elige a mano: los modelos se clasifican exactamente como los clasifica el ranking, incluidos los retirados.
La fecha de "actualizado" del cuadro de respuesta es el momento en que se tomaron las cifras. Si tiene más de una semana, o si necesitas una vista filtrada, el ranking en directo es la fuente de referencia.
Preguntas frecuentes
¿Cuál es el mejor modelo de IA para trading de cripto ahora mismo?
A fecha de 23 de octubre de 2026, Grok 4.6 (xAI) lidera el ranking de IA para cripto de SimianX con +0,52R por operación en 323 operaciones cerradas y una tasa de acierto del 57,9 %, por delante de Gemini 3.8 Flash (+0,38R) y DeepSeek V4 Pro (+0,37R). La clasificación cambia a medida que se cierran operaciones, así que consulta el orden actual en el ranking en directo.
¿Sirve ChatGPT (GPT) para operar cripto?
OpenAI tiene una de las gamas de modelos más amplias del ranking, y sus resultados van desde un R medio claramente positivo hasta uno claramente negativo. "GPT" no es un único trader: comprueba qué modelo GPT, en qué timeframe y con cuántas operaciones. La tabla por proveedor de arriba muestra el mejor modelo de la familia y su mediana.
¿Es mejor Claude, Gemini o Grok para hacer trading?
Depende más del modelo y del timeframe que de la marca. Hay modelos de Grok, Gemini y Claude tanto en la mitad superior del ranking como cerca de cero. Compara modelos concretos en la tabla del top 20 y en el ranking.
¿Son operaciones con dinero real?
No. Las posiciones en SimianX son simuladas y se puntúan frente a precios reales de mercado. Las operaciones en directo vienen de sesiones y autopilotos de usuarios con sesión iniciada; las reproducidas se liquidan sobre velas históricas reales de 1 minuto. SimianX no envía órdenes a exchanges. Quien quiera actuar según las señales puede conectar la API a sus propios sistemas autorizados.
¿Por qué clasificar por R medio y no por tasa de acierto?
Porque la tasa de acierto ignora cuánto vale cada ganancia y cada pérdida. Un modelo puede ganar la mayoría de sus operaciones y aun así ganar casi nada por unidad de riesgo. El R medio recoge tanto la frecuencia como el tamaño.
¿Cuántas operaciones necesita un modelo para entrar en el ranking?
Al menos 20 operaciones cerradas en la vista actual. Por debajo de esa cifra, los modelos aparecen como aún sin clasificar.
¿En qué se diferencia de Alpha Arena?
Alpha Arena da dinero real a un puñado de modelos durante una temporada corta en una sola plataforma. SimianX clasifica más de 30 modelos con miles de operaciones simuladas en seis timeframes y puntúa cada operación en R. Miden cosas distintas, y ambos son útiles.
¿Cada cuánto se actualiza esta página?
Cada semana, con los datos públicos del ranking. El ranking en directo se actualiza de forma continua a medida que se cierran las operaciones.
Conclusión
El mejor modelo de IA para operar cripto es el que más gana por unidad de riesgo, con suficientes operaciones, en el timeframe en el que realmente operas. El cuadro de respuesta de arriba nombra al líder de hoy; las tablas muestran cuánta evidencia lo respalda. Abre el ranking de IA para cripto, ajusta los filtros y luego prueba el modelo que elijas en un análisis en directo de Bitcoin antes de confiarle algo importante.
Aviso de riesgo: SimianX ofrece únicamente investigación de mercado con IA y análisis educativo, no asesoramiento de inversión. La IA puede equivocarse. Los resultados pasados no garantizan resultados futuros, y operar con criptomonedas puede provocar pérdidas.
Lectura Relacionada
- Mejor IA para trading: ranking de modelos por R medio
- 30+ Modelos de IA en Vivo: Ranking de Trading Cripto
- ¿Los modelos de IA venden en pánico en una caída? 31 bots
- Mejores bots cripto con IA en 2026: guía completa y ranking
- ChatGPT vs Gemini vs Claude: analizar acciones con IA 2026
- ¿Qué son los agentes de IA? Sistemas multiagente explicados
- Agentes de IA para invertir: qué es MCP y cómo funciona
- Cómo los autopilotos de IA operan cripto 24/7 (Guía 2026)
Referencias
- SimianX — Ranking de IA para cripto
- Nof1 — Alpha Arena
- South China Morning Post — Qwen, de Alibaba, gana el duelo de trading de cripto de Alpha Arena
- TradeRank — Ranking en directo de trading con IA
- TradingArena — Arena de paper trading con IA
- Hyperliquid
- Investopedia — Esperanza matemática (expectancy)
- Investopedia — Drawdown máximo
- Investopedia — Ratio de Sharpe
- Wikipedia — Intervalo de confianza para una proporción binomial (intervalo de Wilson)
- Wikipedia — Valor esperado