AIエージェント徹底解説:ループで動く1つのモデルから、専門家チームまで
AIエージェントとは、AIモデルを使って目標を自律的に追求するソフトウェアシステムです。状況を読み取り、次の一手を決め、ウェブ検索やコード、APIといったツールを通じて行動し、先へ進む前に結果を確認します。マルチエージェントシステムは、この作業を専門分野の異なる複数のエージェントに分担させる仕組みです。各エージェントは見つけた情報を共有し、意見が食い違う点では互いに異議を唱え、統合した答えを最終判断を下す1つのエージェントに渡します。
この2文の定義で、2026年時点でこの言葉が指すもののほとんどをカバーできます。リポジトリ全体にわたってバグを修正するコーディング支援ツールから、レポートを書く前に数百ページを読み込む調査ツールまでが含まれます。ただし、この定義は難しい部分を覆い隠してもいます。エージェントはチャットの返答よりもコストがかかり、時間も長くかかります。そして長いタスクの序盤で起きた小さなミスが、気づかないうちに最終結果を台無しにすることがあります。
SimianXでは、マルチエージェントシステムを毎日構築し、運用しています。ライブ分析ルームでは4つのエージェントが株式や暗号資産の取引ペアをリアルタイムで分析し、ディープ分析では8つのエージェントからなる委員会が1つの銘柄やコインについて議論します。さらに公開中の暗号資産リーダーボードでは、30を超えるAIモデルが決済したすべての取引を採点しています。本ガイドでは、このシステムを具体例として使いながら、この分野を形づくるエージェント製品と研究を中立的な立場で紹介します。
要点まとめ
- エージェントとは、モデルにツール、記憶、そしてモデル自身が制御するループを加えたものです。すべての手順がコードで固定されているなら、それはエージェントではなくワークフローです。
- マルチエージェントシステムが役立つのは、タスクを独立した部分に分割できる場合や、互いに照らし合わせる前にそれぞれが独立して見解を固めるべき場合です。その分、消費するトークンもはるかに多くなります。
- エージェントの失敗の多くは、誤差の累積、信頼性の低いツール、不十分な評価、そして際限なく膨らむコストから生じます。モデルが「賢くない」ことが原因ではありません。
- エージェントは、自分自身のタスクで繰り返し試した結果で判断しましょう。成功率、複数回実行したときの一貫性、完了したタスク1件あたりのコスト、そして何をしたのかを示す完全な記録が判断材料です。
AIエージェントとは?実用的な定義
この考え方は大規模言語モデルよりも古くからあります。AIの標準的な教科書であるスチュアート・ラッセル(Stuart Russell)とピーター・ノーヴィグ(Peter Norvig)の『エージェントアプローチ 人工知能』は、エージェントを「センサーを通じて環境を知覚し、アクチュエーターを通じてその環境に働きかけるもの」と定義しています。サーモスタットもこれに当たりますし、チェスのプログラムもそうです。
2022年以降に変わったのは、言語モデルが推論の中核を担えるようになったことです。人間が書いたルールに従う代わりに、モデルが自然な言葉で状況を読み取り、計画を立て、次に呼び出すツールを選びます。Anthropicが公開し広く引用されているガイド「効果的なエージェントの構築」は、現在多くのエンジニアが使っている線引きを示しています。ワークフローとは、あらかじめ定義されたコードの経路に沿ってモデルとツールを組み合わせるシステムであり、エージェントとは、モデルが自らのプロセスとツールの使い方を動的に決めるシステムです。
実際には、現代のAIエージェントは次の5つの要素で構成されます。
- 目標。「失敗しているこのテストを直す」「今日エヌビディアの株価を動かした要因をまとめる」「この15分足でポジションを持つかどうかを判断する」といったものです。
- モデル。目標と現在の状態について推論します。
- 呼び出せるツール。検索、コードインタープリター、データベースへの問い合わせ、相場データのAPI、ブラウザなどです。
- 記憶または状態。すでに試したこと、ツールが返した結果、まだわかっていないことを保持します。
- 停止ルールを備えたループ。目標を達成するか、予算を使い切るか、次の手順に人間の承認が必要になるまで動き続けます。
ループを取り除けばチャットボットになります。すべての手順を事前に固定すればワークフローになります。モデル自身が制御するループこそが、エージェントをエージェントたらしめているのです。
AIエージェント、チャットボット、ワークフローの違い
この3つの用語は、しょっちゅう混同されます。「エージェント」という言葉が売れるからという面もあります。Gartnerは、チャットボットやロボティック・プロセス・オートメーション(RPA)をエージェントとして売り直す行為を「エージェントウォッシング」と呼び、2025年6月の推計では、エージェント型AIを販売する数千社のうち本物を提供しているのは約130社にすぎないとしています。3つを見分けるには、次の表がいちばんの近道です。
| チャットボット | ワークフロー(パイプライン) | AIエージェント | |
|---|---|---|---|
| 次の手順を決めるのは誰か | ユーザー(1回に1メッセージ) | 開発者(事前に書いたコードで) | モデル(実行時に) |
| ツールを使うか | ときどき、1回の返答につき1回 | 使う、決まった順番で | 使う、必要に応じて選び繰り返す |
| 新しい指示なしで作業を続けるか | 続けない | 続ける、決まった経路に沿って | 続ける、目標か予算の上限に達するまで |
| 典型的な成果物 | 回答 | 既知のプロセスによる予測可能な結果 | 完了したタスク(コードの変更、レポート、判断) |
| コストと速度 | 安い、数秒 | 安価から中程度、予測可能 | 高めで変動、数秒から数時間 |
| 典型的な失敗 | 目に見える誤った回答 | 誰も想定していなかった入力で止まる | 脱線する、堂々巡りする、序盤の小さなミスの上に積み重ねる |
| 向いている用途 | 質問への回答と下書き | 手順が決まった反復的な業務 | 道筋を事前に書けない自由度の高いタスク |
同じAnthropicのガイドには役に立つ原則があります。うまくいく最もシンプルな方法から始め、自律性を高めると結果が明らかに良くなる場合にだけ自律性を加える、というものです。エージェントとして売り込まれている作業の多くは、ワークフローで実装したほうが、より良く、より安く、より安全です。
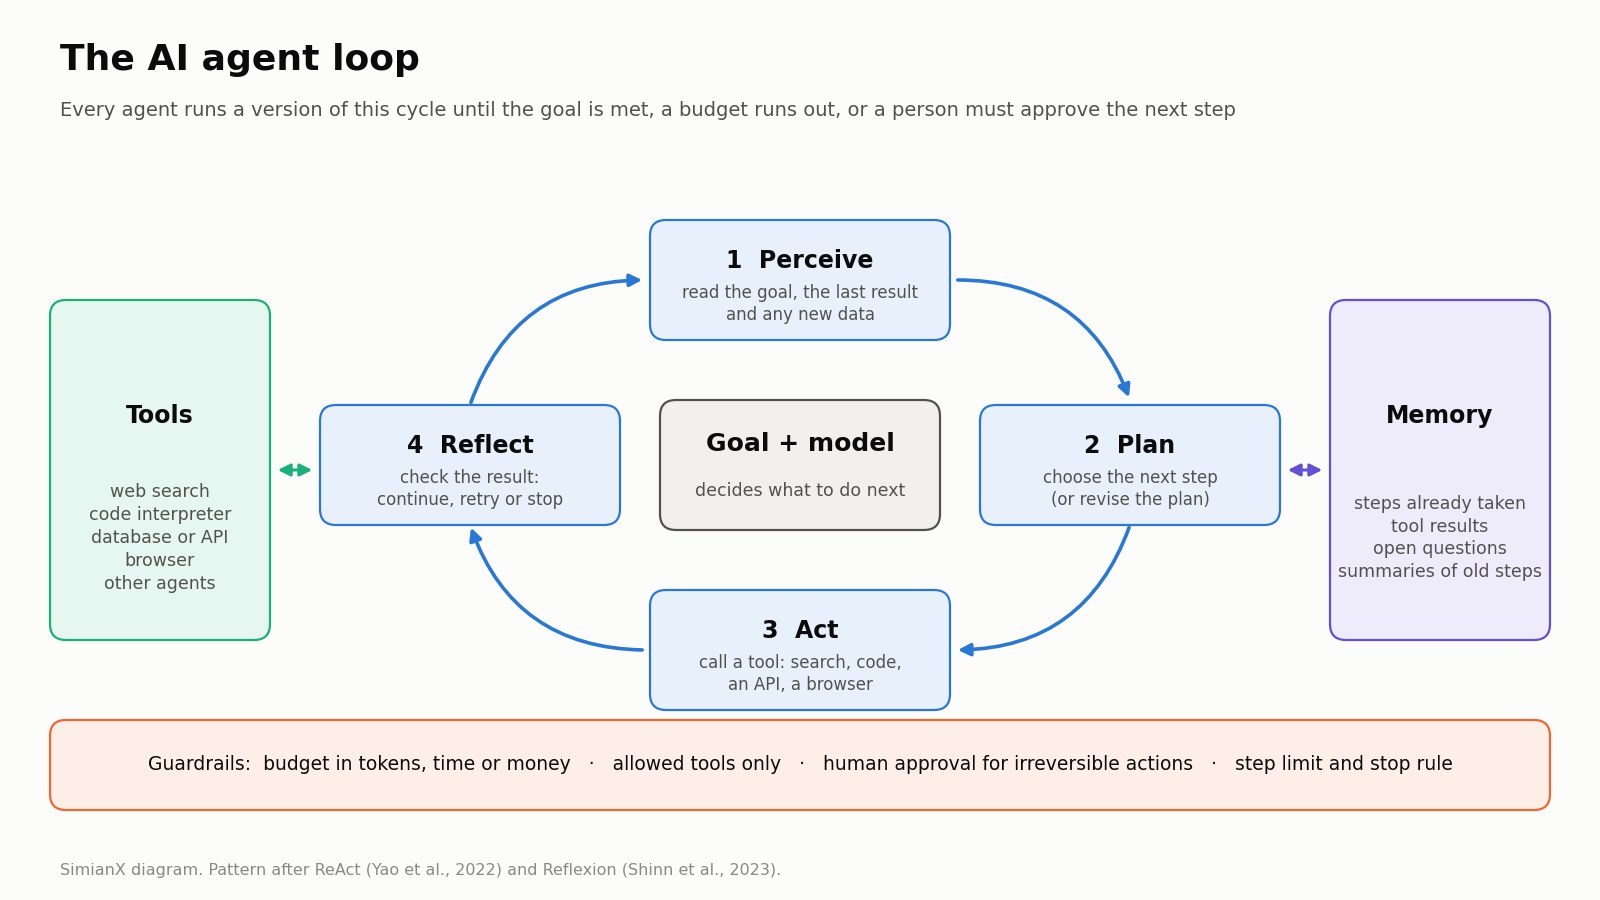
AIエージェントの仕組み:知覚・計画・行動・振り返りのループ
どんな名前で売られていても、すべてのエージェントはこのループの何らかの形を実行しています。
知覚
エージェントは現在の状況を集めます。ユーザーの目標、直前の行動の結果、ファイルの中身、検索結果のページ、チャート上の最新のローソク足などです。エージェントが知っていることはすべてモデルのコンテキストウィンドウに収まらなければならないため、優れたエージェントは取捨選択をします。古い手順は要約し、あとで再び必要になる生データは残し、それ以外は捨てます。
計画
モデルが次に何をするかを決めます。最初に完全な計画を立てることもありますが、多くの場合は直前の結果を見てから次の一手だけを選びます。影響力の大きいReActの論文(Yaoら、2022年)は、短い推論メモと行動を交互に行うことで、モデルが情報を集めながら軌道修正できるようになり、行動だけ、あるいは推論だけの手法を複数のタスクで上回ることを示しました。現在も多くのエージェントフレームワークがこのパターンを踏襲しています。
行動
エージェントがツールを呼び出します。現代のモデルは「Xを検索する」「このパラメーターでこのクエリを実行する」といった構造化されたリクエストを出し、周囲のソフトウェアがそれを実行して結果を返します。こうした配管部分には、すでに標準規格があります。Model Context Protocol(MCP)は、2024年11月にAnthropicが発表し、2025年12月にLinux Foundation傘下のAgentic AI Foundationへ寄贈されたもので、エージェントがツールやデータソースに接続する方法を定めています。GoogleのAgent2Agentプロトコル(A2A)も現在はLinux Foundationのプロジェクトで、異なるベンダーが作ったエージェント同士がやり取りする方法を定めています。
振り返り
エージェントは目標に照らして結果を確認します。テストは通ったか。その数字は2つ目の情報源と一致するか。計画はまだ妥当か。Reflexion(Shinnら、2023年)などの研究では、何がうまくいかなかったかをエージェント自身に書き出させてから再挑戦させると、コーディングや推論のタスクで成績が上がることが示されています。振り返りは、エージェントが止まるべきかを判断する場面でもあります。目標を達成したとき、行き詰まったとき、あるいはリスクのある操作に人間の承認が必要なときです。
ループの周りにはガードレールがあります。トークン、時間、お金で測る予算、エージェントが使ってよいツールの一覧、そして人間が「はい」と言わなければ先へ進めない関門です。トレードの文脈では、少なくともポジションサイズの上限、すべての取引に設定する損切り、そして仮想取引と実際のお金の間の明確な線引きが必要です。
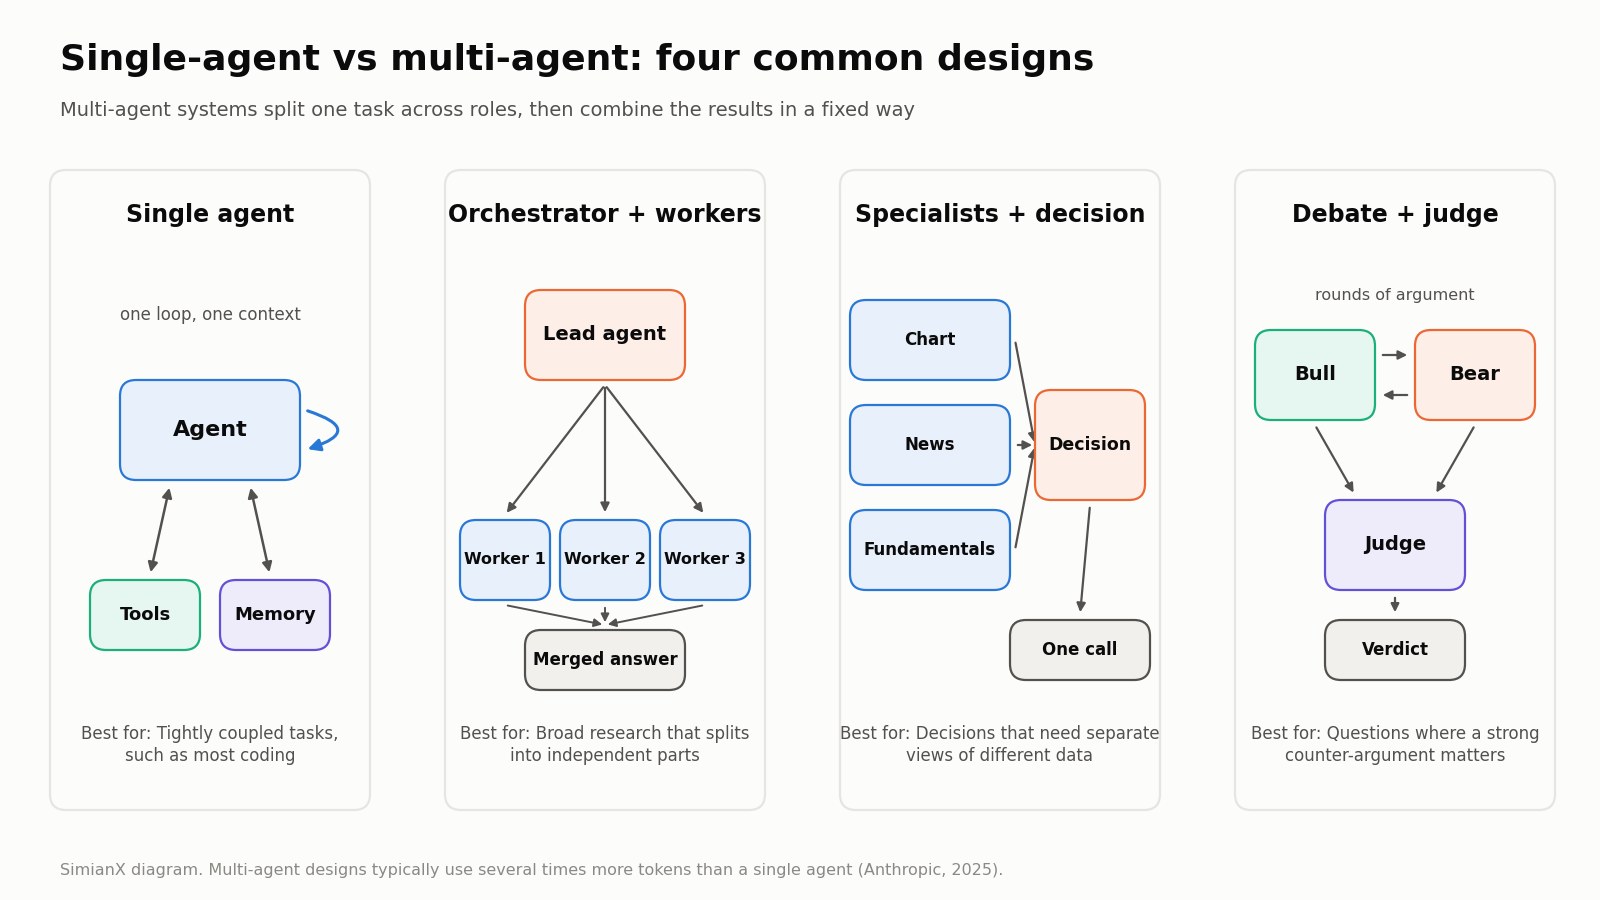
シングルエージェントとマルチエージェントシステム
シングルエージェントは1つでループを回します。マルチエージェントシステムは、仕事の異なる部分を別々のエージェントに任せ、それぞれに固有の指示、ツール、コンテキストを持たせてから、出てきた成果をまとめます。よく使われる設計は次の4つです。
- オーケストレーターとワーカー。リーダー役のエージェントがタスクを分割し、各部分をワーカーのエージェントに送り、結果を統合します。調査アシスタントはこの方式をよく採用しています。
- 専門家から意思決定者へ。チャート、ニュース、財務など、各エージェントが1つの分野を担当し、最後のエージェントがそれぞれの見解を比較検討します。後で詳しく紹介する当社のライブ分析ルームは、この構成です。
- 討論。ジャッジが判断を下す前に、エージェント同士が反対の立場から議論します。Duら(2023年)は、複数のモデルのインスタンスが数ラウンドにわたって討論すると、1つのモデルが単独で答える場合に比べて事実の正確さと推論力が向上することを確認しました。
- 投票またはアンサンブル。複数のエージェント、または複数のモデルが同じ質問に独立して答え、その答えを集約します。
マルチエージェントシステムを支持する証拠は本物ですが、条件付きです。Anthropicは2025年6月、自社のマルチエージェント型リサーチシステムで、Claude Opus 4のリーダーエージェントがClaude Sonnet 4のサブエージェントを指揮する構成が、社内のリサーチ評価において単独のClaude Opus 4エージェントを90.2%上回ったと報告しました。同じ記事は代償についても率直に述べています。エージェントはチャットの約4倍、マルチエージェントシステムは約15倍のトークンを使ったというのです。また、ほとんどのコーディングタスクはリサーチに比べて本当に並列化できる部分が少なく、この方式との相性はよくないとも指摘しています。
| シングルエージェント | マルチエージェントシステム | |
|---|---|---|
| 構築とデバッグ | 簡単:プロンプト1つ、記録1本 | 難しい:複数のプロンプト、受け渡し、統合された記録 |
| タスクあたりのコスト | 低い | 数倍になることが多い |
| 速度 | 逐次処理 | 並列部分は早く終わるが、調整のための負荷が増える |
| カバーできる範囲 | 1つのコンテキストウィンドウに制限される | 各エージェントが担当部分ごとに新しいコンテキストを使える |
| 誤りのチェック | 自分の誤りを自分で見つける必要がある | エージェント同士で異議を唱えられ、意見の相違が見える |
| 典型的な失敗 | 最初の誤った考えに固執する視野狭窄 | 伝達ミス、作業の重複、最終統合の弱さ |
| 向いている用途 | ほとんどのコーディングのような密結合のタスク | 幅広い調査や、独立した視点が必要な判断 |
当社の経験則はこうです。意見を照らし合わせる前に、それぞれの見方が独立して形成されることを望むなら、複数のエージェントを使う。チャートの読み取りが、ニュース担当のエージェントがたった今読んだ見出しに左右されるべきではありませんし、弱気シナリオは、問題点を探すことだけが仕事のエージェントが書くべきです。
AIエージェントはどこで失敗するのか
エージェントの失敗には予測できるパターンがあり、誠実なガイドならそこに紙幅を割くべきです。2025年の研究「マルチエージェントLLMシステムはなぜ失敗するのか」(Cemriら)は、広く使われている7つのマルチエージェントフレームワークから得た1,600件以上の実行記録に注釈を付け、3つのグループに分かれる14種類の失敗パターンを特定しました。システム設計の問題、エージェント間の認識のずれ、そして最終結果の検証の弱さです。
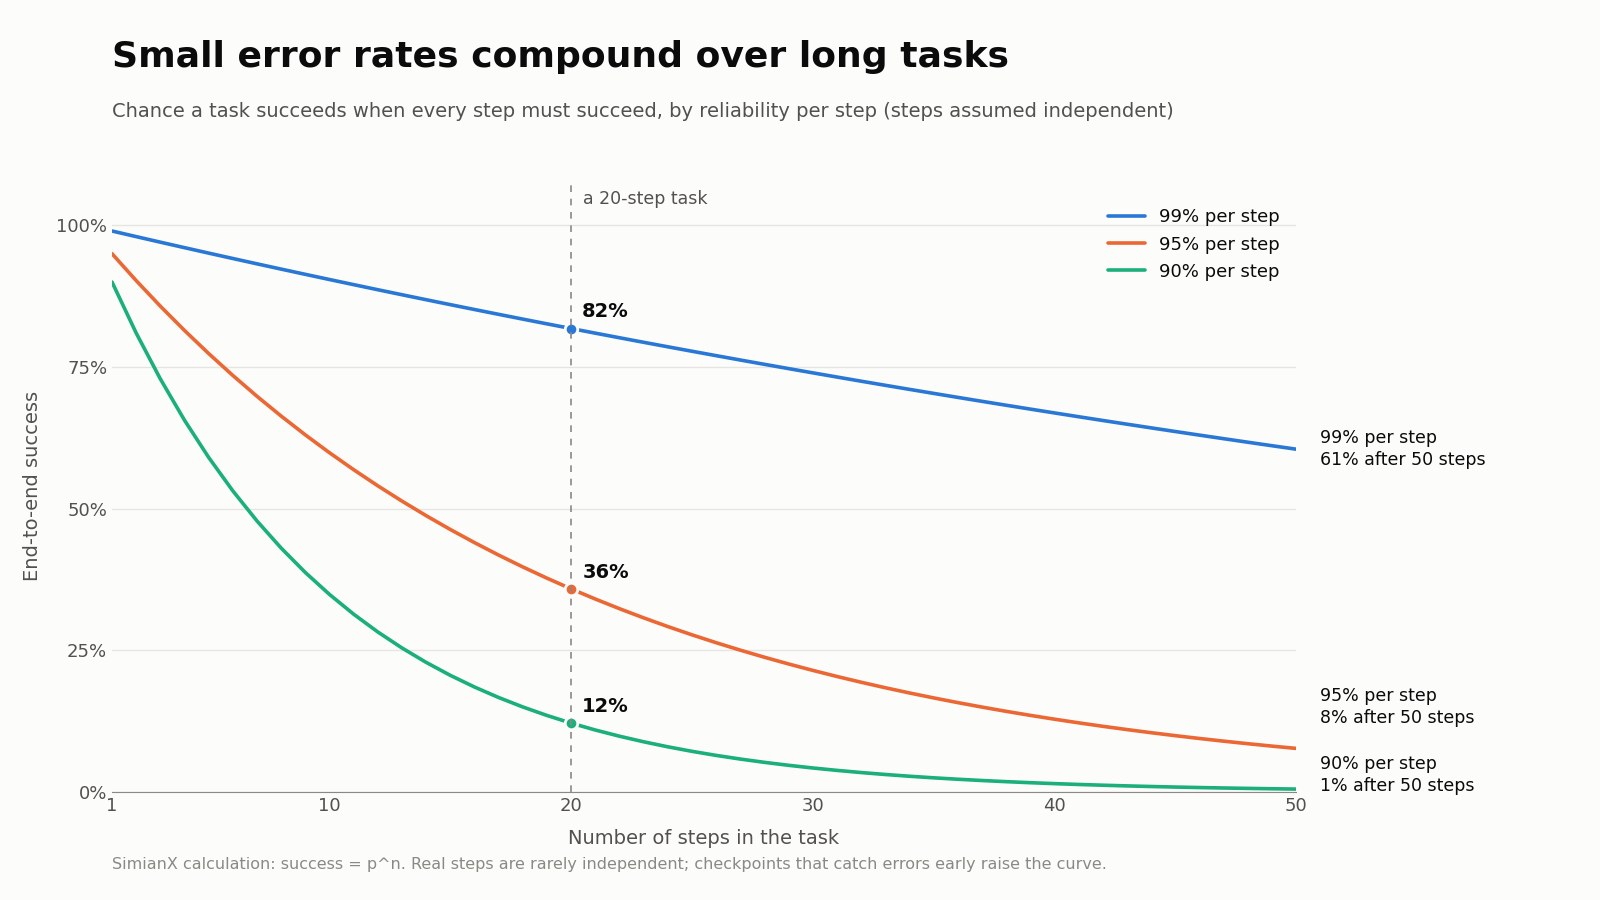
誤差の累積
長いタスクでは、小さな誤り率が掛け算で効いてきます。各ステップの成功率が95%で、ステップが互いに独立しているとすると、20ステップのタスクが成功する確率は約36%にすぎません(0.95の20乗)。1ステップあたり99%なら、同じタスクの成功率は約82%です。1つのステップでの見事な出来栄えよりも、ステップごとの信頼性のほうが重要なのはこのためであり、次のステップが誤りの上に積み上がる前にそれを捕まえるチェックポイントがエージェントに必要なのもこのためです。
ハルシネーションとツール結果の誤読
モデルは事実をでっち上げたり、ツールの結果を読み違えたり、古い数字を最新のものとして引き継いだりすることがあります。エージェントではこの問題が深刻になります。でっち上げた値が、そのまま次の行動の入力になりかねないからです。対策は仕組みで行います。言い換えではなく生データを渡すこと、モデルの計算を信じずに重要な数字はコードで確認すること、そして重要な主張には必ず出典を求めることです。
コスト
ループを1周するたびにモデルの呼び出しが1回増え、タスクが進むにつれてコンテキストも大きくなります。デモでは安く見えたタスクでも、本番環境でエージェントが再試行し、振り返り、読み直すようになると、何倍ものコストがかかることがあります。タスクごとに厳格な予算を設け、1回の呼び出しではなく完了したタスクのコストを測りましょう。
レイテンシ
エージェントは速度と引き換えに品質を得ています。チャットの返答は数秒ですが、調査エージェントは数分かかることがあり、大規模な変更に取り組むコーディングエージェントはそれよりはるかに長く動くこともあります。当社の8エージェントによるディープ分析の委員会も、1銘柄につき数分を要します。エージェントたちが調査し、討論し、投票してから、ようやく書き始めるからです。
評価
エージェントは非決定的です。同じタスクでも、ある回は成功し、次の回は失敗することがあります。tau-benchというベンチマークは、同じタスクをk回試してすべて成功する確率を表すpass^kという指標を導入し、当時の強力な関数呼び出し型エージェントでさえ、小売分野では8回すべて成功する割合が25%未満だったと報告しています。1回の見事な実行からわかることはわずかです。コーディングのSWE-benchやコンピューター操作のOSWorldといった公開ベンチマークは有用ですが、あなた自身のタスクではありません。
セキュリティと権限
ウェブページやメールを読むエージェントは、その中に隠された指示によって操られることがあります。プロンプトインジェクションと呼ばれるこの攻撃は、OWASPがまとめたLLMアプリケーションのリスク一覧で最上位に挙げられています。エージェントには必要最小限のアクセス権だけを与え、秘密情報はコンテキストに入れず、資金の移動のような取り消せない操作の前には必ず承認を求めるようにしましょう。
こうした問題はビジネス上の結果にもつながります。Gartnerは同じ2025年6月の発表で、エージェント型AIプロジェクトの40%以上が2027年末までに中止されると予測し、その理由としてコストの高騰、不明確なビジネス価値、不十分なリスク管理を挙げています。
具体例:SimianXのエージェントは売買判断をどう分担しているか
トレードはエージェントにとって厳しい試験です。データは絶え間なく届き、判断を下す時点では正解がわからず、すべての判断はいずれ市場によって採点されます。当社のシステムが仕事をどう分担しているかを紹介します。
ライブ分析:3つの専門エージェントと1つの意思決定エージェント
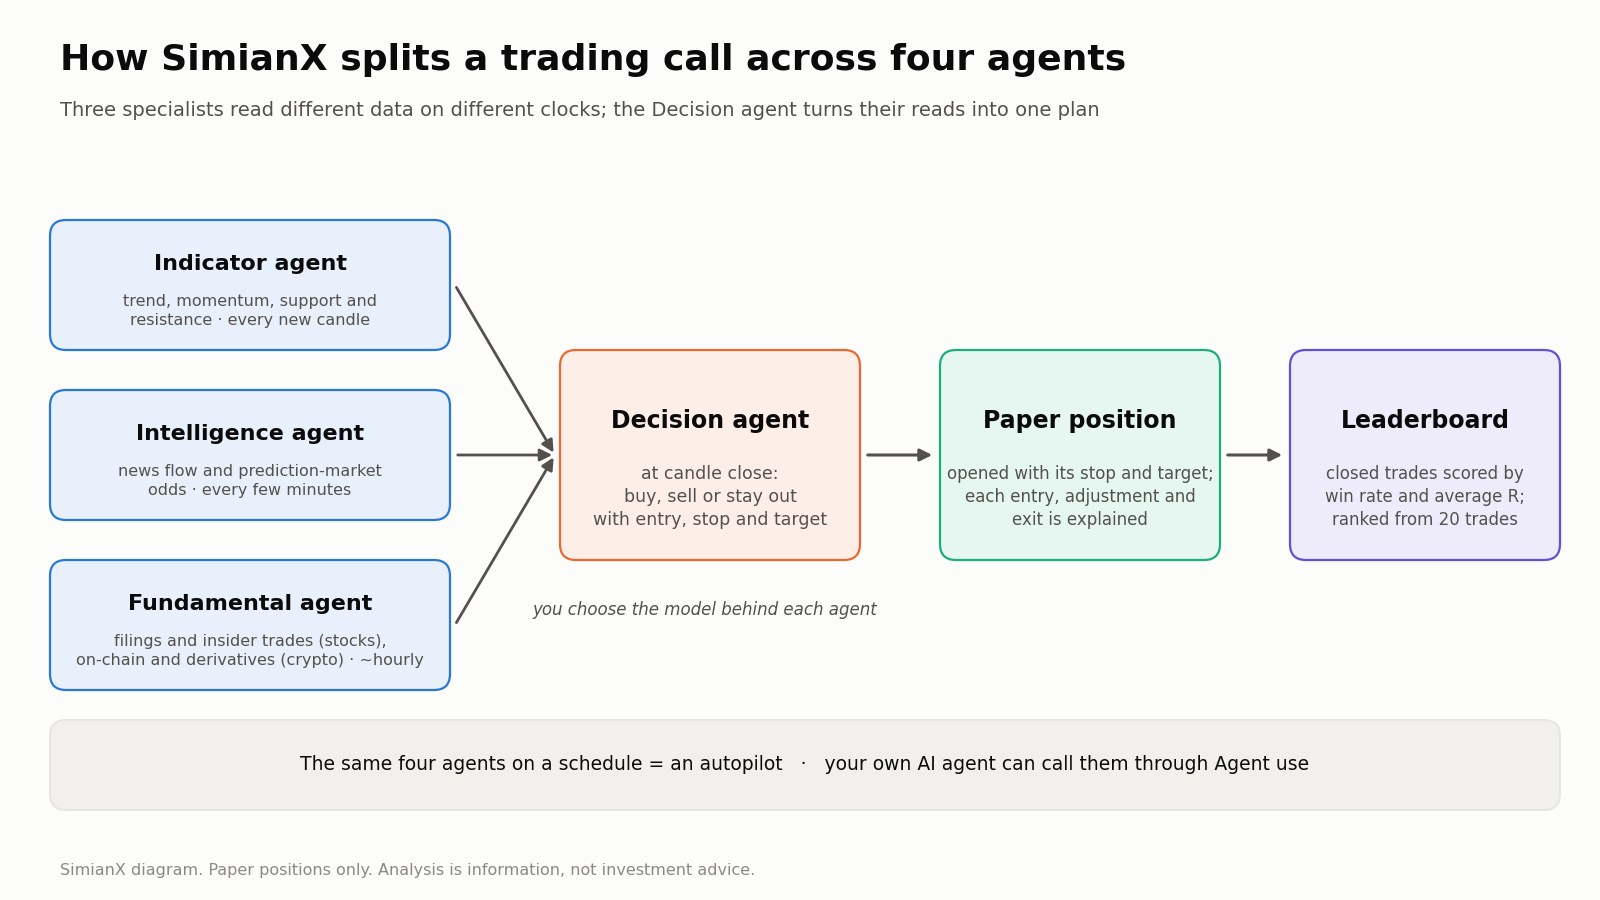
ライブ分析ルームで米国株や暗号資産の取引ペアを開き、時間足を選ぶと、4つのエージェントが動き出します。対象は13,000以上の米国株とETF、4,000以上の暗号資産の取引ペアで、1分足から利用できます。
- インジケーターエージェントはチャートを読みます。トレンド、モメンタム、サポートとレジスタンスです。新しいローソク足ができるたびに実行されます。
- インテリジェンスエージェントは、その銘柄に関するニュースの流れと、存在する場合は予測市場のオッズを読みます。数分ごとに更新されます。
- ファンダメンタルエージェントは、株式なら開示資料とインサイダー取引を、コインならオンチェーンデータとデリバティブのデータを読みます。これらはゆっくりとしか変化しないため、初期設定ではおよそ1時間ごとに更新されます。
- 意思決定エージェントは、ローソク足が確定した時点でほかの3つの見解を比較検討し、何をすべきかを示します。買い、売り、見送りのいずれかと、エントリー価格、損切り価格、目標価格です。
売買の機会が生じると、システムはその損切りと目標を設定した仮想ポジションを建て、取引の展開に合わせて、エントリー、調整、決済の一つひとつを説明します。各エージェントの裏で動くモデルは、あなたが選べます。同じ4つのエージェントは自動操縦装置としてスケジュールに沿って動かすこともでき、インテリジェンスエージェントが参照する採点済みニュースの配信は、マーケットパルスを支えているものと同じです。
なぜこのように分担するのでしょうか。3つの専門エージェントはそれぞれ異なる周期で動くため、分けておけば、変わってもいない開示資料を読み直すためにコストを払うことなく、チャートの読み取りだけをローソク足ごとに更新できます。各エージェントのコンテキストも小さく、焦点を絞った状態に保てます。そして意見の相違が目に見えるようになります。チャートが「ブレイクアウト」を示し、ニュース担当のエージェントが明日の決算発表に注意を促したとき、意思決定エージェントはその対立を平均してごまかすのではなく、正面から扱わなければなりません。
ディープ分析:8つのエージェントによる委員会
1つの銘柄やコインを、時間をかけてより深く見たいときは、ディープ分析が8つのエージェントからなる委員会を招集します。4人のアナリストが並行して調査します。ファンダメンタルズ、チャート、ニュース、そして4つ目の席は、株式ならタイミングの視点、暗号資産ならデリバティブのアナリストです。続いて強気派リサーチャーと弱気派リサーチャーが、それぞれの立場から最も説得力のある主張を組み立てます。リサーチマネージャーが最大の争点について討論を取り仕切り、メンバー全員が最終投票で自らのスタンスを改めて表明し、リスクマネージャーが検証済みの価格水準を添えて判断を書きます。刷新された委員会のウォークスルーでは、実際の1回の実行を画面ごとに追っています。
これは研究論文で示された討論のパターンを、実際のサービスに取り入れたものです。弱気派がいるのは、同意するばかりのアナリストで構成された委員会は、実のところ1つの意見を4回繰り返しているにすぎないからです。
リーダーボードは結果をどう測っているか
売買判断を下すエージェントは、推論がどれほどもっともらしく聞こえるかではなく、結果で採点されなければなりません。暗号資産リーダーボードは、こうした仮想ポジションの裏にあるAIモデルを採点しており、実際の市場価格で決済された、決済済みの取引だけが集計対象です。現在は複数のAIラボによる30を超えるモデルを対象とし、それぞれを2つの尺度で測っています。
- 勝率:決済済みの取引のうち、利益で終わったものの割合です。
- 平均R:エントリー時に取ったリスクを単位として、1取引あたりの損益を測ったものです。100で買い、損切りを98に置いた場合のリスクは1単位あたり2です。104で決済すれば+2R、損切りに完全にかかれば−1Rになります。
モデルがランキングに載るのは、現在の絞り込み条件で決済済みの取引が20件に達してからなので、運のよい数件の取引だけで首位に立つことはできません。期間、時間足、売買方向で絞り込むこともできます。2つの数字を合わせて読むことが大切です。勝率が高くRが低い場合は少数の大きな損失が隠れている可能性があり、勝率はそこそこでもRが高い場合は、勝つ回数は少なくても1回の勝ちが大きいことを意味します。リーダーボードの裏にあるモデルについては、「どのAIモデルが最強のトレーダーか?」とGPT・Gemini・Claudeの比較ガイドで比較しています。
自分のエージェントを接続する
同じシステムは外部のエージェントにも開かれています。エージェント活用ページでは、Claude Code、Codex、Cursorなどのエージェントに、SimianXのスキルとAPIキーを持たせる方法を説明しています。これにより、エージェントは任意の銘柄で4エージェントによるライブ分析を始めたり、採点済みのニュース配信を追ったり、ディープ分析を実行したりできます。あなたのエージェントには、あなたが予算を設定した専用のキーが渡されます。ウェブサイトのログイン情報が渡ることは決してなく、エージェントが管理するポジションはすべて仮想ポジションです。
リスクに関する注意:ここで説明しているのは、分析と仮想取引を生成するソフトウェアです。その内容は情報であり、投資助言ではありません。AIモデルは誤りを犯します。リーダーボードの成績は過去の取引を示すもので、将来のリターンを予測するものではありません。どのモデルや委員会であっても、市場リスクをなくすことはできません。AIの判断だけを根拠に、失っても困らない範囲を超えるお金で取引することは絶対に避けてください。
2026年のAIエージェントの種類
教科書による分類
教科書では、エージェントを判断の仕方によって分類しており、この区分は現代のシステムを理解するうえでも今なお役に立ちます。
| 種類 | 判断の仕方 | 例 |
|---|---|---|
| 単純反射エージェント | 現在の入力に対して固定の「条件・行動」ルールを適用する | サーモスタット、価格アラート |
| モデルベース反射エージェント | ルールに加え、直接観測できない部分についての内部モデルを持つ | 送信者の履歴を追跡する迷惑メールフィルター |
| 目標ベースエージェント | 定められた目標に到達する行動を探索する | 経路案内ツール |
| 効用ベースエージェント | 期待されるトレードオフが最もよい行動を選ぶ | リターンとリスクを比較するトレードエージェント |
| 学習エージェント | フィードバックから自らの振る舞いを改善する | クリックに応じて更新されるレコメンドシステム |
言語モデルを使ったエージェントは、これらの種類を組み合わせたものです。追求するものという点では目標ベースであり、選択肢を比較するときは効用ベースであり、さらにタスクの途中でも結果を振り返ることで学習します。
製品カテゴリー
実際に何をするかで分けると、2026年に使われているエージェントは大きく5つのカテゴリーに分かれます。ここで挙げる製品は例であって推奨ではなく、その機能は急速に変わります。
コーディングエージェント。AIコーディングエージェントは、コードのリポジトリを読み、ファイルを編集し、テストを実行して変更を提案します。多くの場合、提案はプルリクエストの形で行われます。例としては、AnthropicのClaude Code、OpenAIのCodex、GitHub Copilotのコーディングエージェント、Cursor、CognitionのDevinがあります。これらはよくSWE-benchで比較されます。オープンソースプロジェクトの実際の課題を解決させるベンチマークです。METRの研究によれば、最先端のエージェントが50%の信頼性で完了できるソフトウェアタスクの長さは、2019年以降およそ7か月ごとに倍増しています。
リサーチエージェント。ウェブや文書群を検索し、多くの情報源を読み、出典付きのレポートを書きます。Googleは2024年12月にGemini Deep Researchを、OpenAIは2025年2月にChatGPTでディープリサーチ(deep research)を開始しました。弱点は情報源の質です。よく書けたレポートであっても、質の低い情報源に依拠していることがあります。
ブラウザ・コンピューター操作エージェント。画面を見て、クリックし、入力することで、ブラウザやデスクトップ全体を操作します。Anthropicは2024年10月にコンピューター操作(computer use)機能を公開しました。OpenAIが2025年1月に開始したOperatorは、2025年7月にChatGPT agentへ統合され、GoogleにはProject Marinerがあります。APIを通じて動くエージェントに比べて遅く、信頼性も低いため、通常はAPIを提供していないサイトに限って使われます。
汎用エージェント。大まかな目標を受け取り、ブラウジング、コード、ファイルを組み合わせて仕上げます。2025年3月に登場したManusは、その最もよく知られた例です。Metaは2025年12月に同社の買収で合意しましたが、2026年4月に中国の国家発展改革委員会が取引の撤回を命じました。
トレード・市場分析エージェント。相場データ、ニュース、開示資料を読み、トレードプランを作成したり、ポジションを管理したりします。TradingAgents(Xiaoら、2024年)のような学術的なフレームワークは、アナリスト、リサーチャー、トレーダー、リスク管理の役割を持つトレード会社をモデル化しており、SimianXのような製品は同様の委員会をリアルタイムのデータで運用しています。市場は敵対的でノイズが多いため、公開された取引ごとの実績が最も重要になるのがこのカテゴリーです。
AIエージェントの評価方法:チェックリスト
コーディングエージェント、リサーチツール、トレードアシスタントのどれを選ぶ場合でも、役に立つエージェントとデモ止まりのものを見分ける質問は同じです。
| 質問 | 良い状態 | 危険信号 |
|---|---|---|
| 本当にエージェントか | 手順とツールを自ら選ぶ | 「エージェント」というラベルを貼っただけの固定スクリプト |
| 自分のタスクで機能するか | 自分の業務から選んだ10〜20件の実際のタスクで試している | ベンダーのデモとベンチマークのスコアしかない |
| 安定しているか | 同じタスクを何度実行しても似た結果になる | 1回だけ見事で、あとは失敗続き |
| 完了したタスクのコストはいくらか | 完了タスク1件あたりのコストが測定され、上限がある | 1回の呼び出しあたりの価格しか示されない |
| どのくらい時間がかかるか | 速度が用途に見合っている | 1行で済む答えに数分待たされる |
| 何をしたか確認できるか | 手順、ツール呼び出し、情報源の完全な記録がある | 最終的な答えだけで、経緯がわからない |
| 何に触れられるか | 最小権限、サンドボックスや仮想取引モード、取り消せない操作には承認が必要 | 広範な認証情報を持ち、承認の手順がない |
| どうやって止まるか | 予算、ステップ数の上限、明確な停止ルール | 誰かが気づくまでループし続ける |
| データはどれだけ新しいか | すべてのデータにタイムスタンプがある | 古い数字が最新のように示される |
| トレードエージェントの場合、実績はどうか | 実際の価格で決済された取引、サンプル数の明示、勝率とリスク調整後リターンの両方 | バックテストだけ、または取引件数のない勝率だけ |
よくある質問
AIエージェントとは、簡単に言うと何ですか?
AIエージェントとは、AIモデルを使って自力で目標を達成するプログラムです。状況を見て一手を決め、検索やコードなどのツールで実行し、結果を確認し、仕事が終わるか人間の判断が必要になるまでそれを繰り返します。
AIエージェントとチャットボットの違いは何ですか?
チャットボットは1回に1つのメッセージに答え、あなたの次の入力を待ちます。エージェントは多くのステップにわたって目標に向けて動き続け、どのツールを使うかを自分で選び、手順ごとに新しい指示を受けなくても、コードの修正やレポートの作成といったタスクを最後までやり遂げます。
マルチエージェントシステムとは何ですか?
マルチエージェントシステムとは、役割の異なる複数のAIエージェントが1つのタスクに取り組む仕組みです。作業を分担したり、反対の立場から討論したり、投票したりし、最後のエージェントか固定のルールが成果をまとめます。幅広いタスクでは単一のエージェントを上回ることが多い一方、コストははるかに高くなります。
AIコーディングエージェントとは何ですか?
AIコーディングエージェントは、ソフトウェアプロジェクトの中で働きます。コードを読み、ファイルを編集し、テストを実行し、変更を提案します。例としてはClaude Code、OpenAI Codex、GitHub Copilotのコーディングエージェント、Cursor、Devinがあります。
Manus AIとは何ですか?
Manusは2025年3月に登場した汎用のAIエージェントで、大まかな目標を受け取り、ブラウジング、コード、ファイルを使ってそれを仕上げます。Metaは2025年12月に同社の買収で合意しましたが、2026年4月に中国の規制当局が取引の撤回を命じました。
AIエージェントは株や暗号資産の取引ができますか?
市場を分析し、ポジションを管理することはできます。SimianXを含む一部の製品では、エージェントが損切りと目標を設定した仮想ポジションを運用できます。結果はモデルや市場によって大きく異なるため、どのトレードエージェントも決済済み取引の実績で判断し、その出力は助言ではなく情報として扱ってください。
自分のAIエージェントをライブの市場分析に接続するには?
SimianXのエージェント活用ページで、Claude Code、Codex、CursorなどのエージェントにSimianXのスキルをインストールする方法を紹介しています。あなたのエージェントには、あなたが予算を管理する専用のAPIキーが発行され、マルチエージェントによるライブ分析の開始、採点済みニュース配信の追跡、ディープ分析の実行ができるようになります。
関連記事
- AI株式分析を全面刷新:8エージェント委員会が討論し質問にも回答
- 8 AIアナリスト vs 1:精度+37%、リスク-41% 解説
- どのAIモデルが最強のトレーダー?30モデルを実損益で比較
- 30+のAIモデル×6プロバイダー:暗号資産実戦ランキング
- GPT・Gemini・ClaudeのAI株分析比較2026
- マルチエージェントAI対ChatGPT:NVDA分析2026比較
- AIオートパイロットの24/7暗号取引(2026完全ガイド)
- 米株ライブ分析:AI マルチエージェントが実時間米株対応
- Agentic AI投資:次世代市場のための入門完全ガイド
参考リンク
- Russell & Norvig — 『エージェントアプローチ 人工知能』
- Anthropic — 「効果的なエージェントの構築」(2024年12月)
- Anthropic — 「マルチエージェント型リサーチシステムの構築方法」(2025年6月)
- Yaoら — 「ReAct:言語モデルにおける推論と行動の協調」
- Shinnら — 「Reflexion:言語によるフィードバックで強化学習する言語エージェント」
- Duら — 「マルチエージェント討論による言語モデルの事実性と推論の向上」
- Cemriら — 「マルチエージェントLLMシステムはなぜ失敗するのか」
- Yaoら — 「tau-bench:現実の領域におけるツール・エージェント・ユーザー間のやり取りのベンチマーク」
- METR — 「長いタスクを完了するAIの能力の測定」
- Xiaoら — 「TradingAgents:マルチエージェントLLMによる金融トレードのフレームワーク」
- Model Context Protocol — 公式ドキュメント
- Agent2Agent(A2A)プロトコル — 公式サイト
- Gartner — エージェント型AIプロジェクトの40%以上が2027年末までに中止へ(2025年6月)
- TechCrunch — 中国がMetaによる20億ドルのManus買収を阻止(2026年4月)
- IBM — AIエージェントとは
- OWASP — 大規模言語モデルアプリケーションのトップ10リスク